
В этот раз «захотелось и перевелось» описание обоих компонентов service mesh, data plane и control plane. Это описание мне показалось самым понятным и интересным, а главное подводящим к пониманию «А нужно ли оно вообще?».
Поскольку идея «Сервисной сети(Service mesh)» становится все более популярной в течение последних двух лет(Оригинальная статья от 10 октября 2017), а число участников в пространстве возросло, я увидел соразмерный рост путаницы среди всего технического сообщества в отношении того, как сравнивать и противопоставлять разные решения.
Ситуацию лучше всего описать следующими сериями твитов, которые я написал в июле:
Путаница с сервисной сетью(service mesh) № 1: Linkerd ~ = Nginx ~ = Haproxy ~ = Envoy. Ни один из них не равен Istio. Istio — это нечто совсем другое. 1 /
Первые просто плоскости данных(data planes). Сами по себе они ничего не делают. Они должны быть настроены на что-то большее. 2 /
Istio является примером плоскости управления(control plane), которая связывает части вместе вместе. Это другой слой. /конец
В предыдущих твитах упоминается несколько разных проектов (Linkerd, NGINX, HAProxy, Envoy и Istio), но, что более важно, вводятся общие понятия плоскости данных(data plane), сервисной сети(service mesh) и плоскости управления(control plane). В этом посте я сделаю шаг назад и расскажу, что я имею в виду под терминами «плоскость данных(data plane)» и «плоскость управления(control plane)» на очень высоком уровне, а затем расскажу, как термины относятся к проектам, упомянутым в твитах.
Что такое сервисная сеть(What is a service mesh, really)?

Рисунок 1: Обзор сервисной сети(Service mesh overview)
Рисунок 1 иллюстрирует концепцию сервисной сети(service mesh) на самом базовом уровне. Есть четыре сервисных кластера (A-D). Каждый экземпляр сервиса связан с локальным прокси сервером. Весь сетевой трафик (HTTP, REST, gRPC, Redis и т. Д.) от отдельного экземпляра приложения передается через локальный прокси-сервер в соответствующие внешние сервисные кластеры. Таким образом, экземпляр приложения не знает о сети в целом и знает только о своем локальном прокси. Фактически, сеть распределенной системы была удалена от сервиса.
Плоскость данных(Data plane)
В сервисной сети(service mesh) прокси-сервер, расположенный локально для приложения, выполняет следующие задачи:
- Обнаружение сервисов(Service discovery). Какие сервисы/службы/приложения доступны для вашего приложения?
- Проверка работоспособности(Health checking). Являются ли экземпляры сервисов, возвращенные обнаружением сервисов(service discovery), работоспособными и готовы ли принимать сетевой трафик? Это может включать как активную (например, проверка ответа / healthcheck), так и пассивную (например, с использованием 3 последовательных 5xx ошибок в качестве индикации нездорового состояния сервиса) проверки работоспособности.
- Маршрутизация(Routing). Получив от сервиса REST запрос к «/foo», в какой сервисный кластер следует отправлять запрос?
- Балансировка нагрузки(Load balancing). После того как во время маршрутизации был выбран кластер сервиса, в какой экземпляр сервиса должен быть отправлен запрос? С каким таймаутом? С какими настройками обрыва цепи(circuit breaking)? Если запрос не удался, его следует повторить?
- Аутентификация и авторизация(Authentication and authorization). Для входящих запросов может ли вызывающий сервис быть криптографически опознан/авторизован с помощью mTLS или какого-либо другого механизма? Если он опознан/авторизован, разрешено ли ему вызывать запрошенную операцию(endpoint) в сервисе или должен быть возвращен неаутентифицированный ответ?
- Наблюдаемость(Observability). Для каждого запроса должны быть сгенерированы подробные статистические данные, журналы/логи и данные распределенной трассировки, чтобы операторы могли понимать распределенный поток трафика и проблемы отладки по мере их возникновения.
За все предыдущие пункты в сервисной сети(service mesh), отвечает плоскость данных(data plane). По сути, локальный для сервиса(sidecar) прокси и является плоскостью данных(data plane). Иными словами, плоскость данных(data plane) отвечает за условную трансляцию, пересылку и наблюдение за каждым сетевым пакетом, который присылается в сервис или отсылается из него.
Плоскость управления(The control plane)
Сетевая абстракция, которую обеспечивает локальный прокси в плоскости данных(data plane), является волшебной(?). Тем не менее, как прокси-сервер на самом деле узнает о маршруте «/foo» к сервису B? Как данные обнаружения сервисов(service discovery), которые заполняются прокси-запросами, могут быть использованы? Как настроены параметры балансировки нагрузки, таймаута(timeout), обрыва цепи(circuit breaking) и т.д.? Как осуществляется развертывание приложения с использованием синего/зеленого(blue/green) метода или метода постепенного перевода трафика? Кто настраивает параметры общесистемной аутентификации и авторизации?
Все вышеперечисленные пункты находятся в ведении плоскости управления(control plane) сервисной сети(service mesh). Плоскость управления(control plane) принимает набор изолированных прокси-серверов без состояния и превращает их в распределенную систему.
Я думаю, что причина, по которой многие технологи находят запутанными разделенные понятия плоскости данных(data plane) и плоскости управления(control plane), заключается в том, что для большинства людей плоскость данных знакома, в то время как плоскость управления чужеродна/непонятна. Мы уже давно работаем с физическими сетевыми маршрутизаторами и коммутаторами. Мы понимаем, что пакеты/запросы должны идти из пункта А в пункт Б, и что мы можем использовать для этого аппаратное и программное обеспечение. Новое поколение программных прокси — это просто модные версии инструментов, которые мы использовали в течение долгого времени.

Рисунок 2: Человеческая плоскость управления(Human control plane)
Однако, мы уже долгое время использовали плоскости управления(control plane), хотя большинство сетевых операторов могут не связывать эту часть системы с каким-либо технологическим компонентом. Причина этого проста:
Большинство используемых сегодня плоскостей управления(control plane) -это… мы.
На рисунке 2 показано то, что я называю «Человеческой плоскостью управления(Human control plane)». В этом типе развертывания, которое все еще встречается очень часто, человек-оператор, вероятно сварливый, создает статические конфигурации — потенциально, с помощью скриптов — и развертывает их с помощью какого-то специального процесса на всех прокси-серверах. Затем прокси начинают использовать эту конфигурацию и приступают к обработке плоскости данных(data plane) с использованием обновленных настроек.
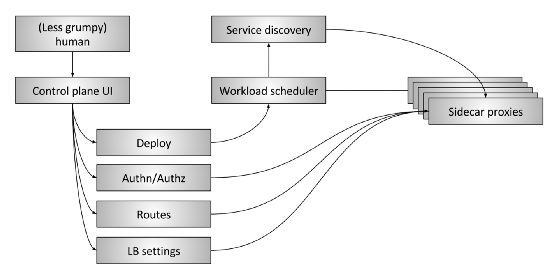
Рисунок 3: Расширенная плоскость управления сервисной сетью(Advanced service mesh control plane)
На рисунке 3 показана «расширенная» плоскость управления(control plane) сервисной сети(service mesh). Она состоит из следующих частей:
- Человек(The human): Все еще есть человек (надеюсь, менее сердитый), который принимает решения на высоком уровне в отношении всей системы в целом.
- Пользовательский интерфейс плоскости управления(Control plane UI): Человек взаимодействует с каким-либо типом пользовательского интерфейса для управления системой. Это может быть веб-портал, приложение командной строки(CLI) или какой-то другой интерфейс. С помощью пользовательского интерфейса оператор имеет доступ к таким глобальным параметрам конфигурации системы, как:
- Управление развертыванием, синий/зеленый(blue/green) и/или с постепенным перевода трафика
- Параметры аутентификации и авторизации
- Спецификации таблицы маршрутизации, например, когда приложение A запрашивает информацию о «/foo», что происходит
- Настройки балансировщика нагрузки, например, таймауты(timeouts), повторные попытки(retries), параметры обрыва цепи(circuit breaking) и т.д.
- Планировщик рабочей нагрузки(Workload scheduler): Сервисы запускаются в инфраструктуре через систему планирования/оркестрации определенного типа, например, Kubernetes или Nomad. Планировщик отвечает за загрузку службы вместе с ее локальным прокси-сервером.
- Обнаружение сервиса(Service discovery). Когда планировщик запускает и останавливает экземпляры сервиса, он сообщает о состоянии работоспособности в систему обнаружения сервиса.
- API конфигурации локального прокси-сервера (Sidecar proxy configuration APIs) : Локальные прокси-серверы динамически извлекают состояние из различных компонентов системы по модели «согласованность в конечном счёте»(eventually consistent) без участия оператора. Вся система, состоящая из всех запущенных на данный момент экземпляров сервисов и локальных прокси-серверов, в конечном итоге сходится в одну экосистему. API универсальной плоскости данных(data plane) в Envoy является одним из примеров того, как это работает на практике.
По сути, цель плоскости управления(control plane) состоит в том, чтобы установить политику, которая в конечном итоге будет принята плоскостью данных(data plane). Более совершенные плоскости управления(control plane) уберут от оператора больше деталей некоторых систем и потребуют меньше ручного управления, при условии, что они работают правильно!..
Плоскость данных и плоскость управления. Сводка(Data plane vs. control plane summary)
- Плоскость данных cервисной сети(Service mesh data plane): затрагивает каждый пакет / запрос в системе. Отвечает за обнаружение приложенией/сервисов, проверку работоспособности, маршрутизацию, распределение нагрузки, аутентификацию / авторизацию и наблюдаемость.
- Плоскость управления cервисной сети(Service mesh control plane): предоставляет политику и конфигурацию для всех работающих плоскостей данных внутри cервисной сети. Не трогает никаких пакетов / запросов в системе. Плоскость управления превращает все плоскости данных в распределенную систему.
Текущее состояние проекта(Current project landscape)
Разобравшись с объяснением выше, давайте посмотрим на текущее состояние проекта «сервисной сети(service mesh)».
- Плоскости данных(Data planes): Linkerd, NGINX, HAProxy, Envoy, Traefik
- Плоскости управления(Control planes): Istio, Nelson, SmartStack
Вместо того, чтобы проводить углубленный анализ каждого из вышеперечисленных решений, я кратко остановлюсь на некоторых моментах, которые, по моему мнению, вызывают большую часть путаницы в экосистеме прямо сейчас.
В начале 2016 года Linkerd был одним из первых прокси-серверов плоскости данных(data plane) для сервисной сети(service mesh) и проделал фантастическую работу по повышению осведомленности и увеличению внимания к модели проектирования «сервисная сеть»(service mesh). Примерно через 6 месяцев после этого Envoy присоединился к Linkerd (хотя работал в Lyft с конца 2015 года). Линкерд и Envoy — это два проекта, которые чаще всего упоминаются при обсуждении сервисных сетей(service mesh).
Istio было объявлено в мае 2017 года. Цели проекта Istio очень похожи на расширенную плоскость управления(control plane), показанную на рисунке 3. Envoy для Istio является прокси-сервером «по умолчанию». Таким образом, Istio является плоскостью управления(control plane), а Envoy — плоскостью данных(data plane). За короткое время Istio вызвало много волнений, и другие плоскости данных(data plane) начали интеграцию в качестве замены Envoy (и Linkerd, и NGINX продемонстрировали интеграцию с Istio). Тот факт, что в одной плоскости управления(control plane) можно использовать разные плоскости данных(data plane), означает, что плоскость управления(control plane) и плоскость данных(data plane) не обязательно тесно связаны. Такой API как универсальный API плоскости данных(data plane) Envoy может образовывать мост между двумя частями системы.
Nelson и SmartStack помогают дополнительно проиллюстрировать разделение плоскости управления(control plane) и плоскости данных(data plane). Nelson использует Envoy в качестве своего прокси и строит надежную плоскость управления(control plane) сервисной сетью(service mesh) на базе стека HashiCorp, т.е. Nomad и т.д. SmartStack стал, пожалуй, первым из новой волны сервисных сетей(service mesh). SmartStack формирует плоскость управления(control plane) вокруг HAProxy или NGINX, демонстрируя возможность развязки плоскости управления(control plane) сервисной сетью(service mesh) и плоскости данных(data plane).
Микросервисная архитектура с сервисной сетью(service mesh) привлекает к себе все больше внимания (правильно!), и все больше проектов и вендоров начинают работать в этом направлении. В течение следующих нескольких лет мы увидим много инноваций как в плоскостях данных(data plane), так и в плоскостях управления(control plane), а также дальнейшее смешивание различных компонентов. В конечным счете микросервисная архитектура должна стать более прозрачной и волшебной(?) для оператора.
Надеюсь, все менее и менее раздраженного.
Ключевые моменты(Key takeaways)
- Сервисная сеть(service mesh) состоит из двух разных частей: плоскости данных(data plane) и плоскости управления(control plane). Оба компонента обязательны, и без них система не будет работать.
- Все знакомы с плоскостью управления(control plane), и на данный момент плоскостью управления(control plane) можете быть вы!
- Все плоскости данных(data plane) конкурируют между собой по функциям, производительности, конфигурируемости и расширяемости.
- Все плоскости управления(control plane) конкурируют между собой по функциям, конфигурируемости, расширяемости и удобству использования.
- Одна плоскость управления(control plane) может содержать правильные абстракции и API, чтобы можно было использовать несколько плоскостей данных(data plane).
ссылка на оригинал статьи https://habr.com/ru/post/462699/
Добавить комментарий