function camelize(str) { return str.replace(/(?:^\w|[A-Z]|\b\w|\s+)/g, function(match, index) { if (+match === 0) re turn ""; // или if (/\s+/.test(match)) для пробелов return index === 0 ? match.toLowerCase() : match.toUpperCase(); }); } Этот фрагмент кода, кстати, в роли ответа на вопрос о приведении строк к «верблюжьему» стилю, собрал больше всего голосов на Stack Overflow. Но даже он не в состоянии правильно обработать, например, такую строку:
---Foo---bAr---
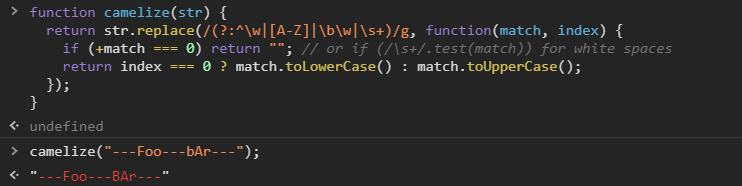
Результат обработки строки —Foo—bAr—
А как быть, если такие строки, всё же, нужно обрабатывать? Можно подправить этот пример, а можно прибегнуть к помощи специализированных библиотек. Они упрощают реализацию сложных алгоритмов и, кроме того, дают программисту инструменты, обладающие куда большей гибкостью и универсальностью, чем, скажем, вышеприведённый пример. Это вполне может означать, что для решения некоей непростой задачи понадобится вызвать всего один метод.
Поговорим о нескольких JavaScript-библиотеках, предназначенных для работы со строками.
1. String.js
Библиотека string.js, или просто S, это маленькая (менее 5 Кб в минифицированном и сжатом виде) JavaScript-библиотека, которую можно использовать в браузере и в среде Node.js. Она даёт в распоряжение программиста большой набор методов для работы со строками. Это — методы объекта string.js, в состав которых, для удобства, включены и стандартные методы строк. Объект string.js — это нечто вроде обёртки для обычных строк.
▍Установка
Для того чтобы установить библиотеку string.js, достаточно воспользоваться следующей командой:
npm i string
▍Примечательные методы
Метод between
Метод between(left, right) извлекает из строки подстроку, содержащуюся между строками left и right. Например, этот метод можно использовать для извлечения элементов, находящихся между двумя HTML-тегами:
var S = require('string'); S('<a>This is a link</a>').between('<a>', '</a>').s // 'This is a link'
Метод camelize
Метод camelize() удаляет из обрабатываемой строки пробелы, символы подчёркивания, тире, и приводит эту строку к «верблюжьему» стилю. Этот метод можно использовать для решения задачи, упомянутой в начале материала.
var S = require('string'); S('---Foo---bAr---').camelize().s; //'fooBar'
Метод humanize
Метод humanize() приводит обрабатываемую строку к виду, удобному для чтения. Если бы нечто подобное нужно было бы реализовать с нуля, то потребовалось бы написать довольно много строк кода.
var S = require('string'); S(' capitalize dash-CamelCase_underscore trim ').humanize().s //'Capitalize dash camel case underscore trim'
Метод stripPunctuation
Метод stripPunctuation() удаляет из строки знаки препинания и различные специальные символы вроде звёздочек и квадратных скобок. Если создавать подобную функцию самостоятельно — высок риск забыть о каком-нибудь символе, который она должна обрабатывать.
var S = require('string'); S('My, st[ring] *full* of %punct)').stripPunctuation().s; //My string full of punct → Здесь можно найти более подробные сведения об этой библиотеке и о реализуемых ей методах
2. Voca
JavaScript-библиотека Voca предлагает нам ценные функции, повышающие удобство работы со строками. Среди её возможностей можно отметить следующие:
- Изменение регистра символов.
- Удаление заданных символов, находящихся в начале и в конце сроки.
- Дополнение строки до заданной длины.
- Преобразование строки в строку, слова, имеющиеся в которой, разделены дефисами.
- Запись строки латиницей.
- Сборка строк по шаблонам.
- Обрезка строк до достижения ими заданной длины
- Экранирование специальных символов для HTML.
Модульный дизайн библиотеки позволяет, при необходимости, загружать не всю библиотеку, а отдельные функции. Это позволяет оптимизировать бандлы приложений, использующих эту библиотеку. Код библиотеки полностью протестирован, качественно документирован и хорошо поддерживается.
▍Установка
Для установки Voca выполните следующую команду:
npm i voca
▍Примечательные методы
Метод camelCase
Метод camelCase() преобразует переданную ему строку в строку, записанную в «верблюжьем» стиле.
var v = require('voca'); v.camelCase('foo Bar'); // => 'fooBar' v.camelCase('FooBar'); // => 'fooBar' v.camelCase('---Foo---bAr---'); // => 'fooBar'
Метод latinize
Метод latinize() возвращает результат преобразованию переданной ему строки в строку, записанную латиницей.
var v = require('voca'); v.latinise('cafe\u0301'); // or 'café' // => 'cafe' v.latinise('août décembre'); // => 'aout decembre' v.latinise('как прекрасен этот мир'); // => 'kak prekrasen etot mir'
Метод isAlphaDigit
Метод isAlphaDigit() возвращает true в том случае, если в переданной ему строке содержатся только алфавитно-цифровые символы.
var v = require('voca'); v.isAlphaDigit('year2020'); // => true v.isAlphaDigit('1448'); // => true v.isAlphaDigit('40-20'); // => false
Метод countWords
Метод countWords() возвращает количество слов, имеющихся в переданной ему строке.
var v = require('voca'); v.countWords('gravity can cross dimensions'); // => 4 v.countWords('GravityCanCrossDimensions'); // => 4 v.countWords('Gravity - can cross dimensions!'); // => 4
Метод escapeRegExp
Метод escapeRegExp() возвращает строку, основанную на переданной ему строке, в которой экранированы специальные символы.
var v = require('voca'); v.escapeRegExp('(hours)[minutes]{seconds}'); // => '\(hours\)\[minutes\]\{seconds\}' → Подробности о библиотеке Voca можно узнать здесь
3. Anchorme.js
Это — компактная и быстрая JavaScript-библиотека, предназначенная для поиска URL и адресов электронной почты в тексте и для преобразования их в рабочие гиперссылки. Вот её основные характеристики:
- Высокая чувствительность, низкий процент ложноположительных срабатываний.
- Валидация ссылок и адресов электронной почты по полному списку IANA.
- Валидация номеров портов (при их наличии).
- Валидация IP-адресов (при их наличии).
- Поддержка URL, записанных символами, отличными от символов латиницы.
▍Установка
Для установки anchorme.js выполните следующую команду:
npm i anchorme
▍Использование
import anchorme from "anchorme"; //или //var anchorme = require("anchorme").default; const input = "some text with a link.com"; const resultA = anchorme(input); //some text with a <a href="http://link.com">link.com</a> Процесс обработки строк поддаётся настройке с помощью объекта с параметрами, который можно передать библиотеке.
→ Подробности об anchorme.js можно узнать здесь
4. Underscore.string
Библиотека underscore.string — это расширение underscore.js для работы со строками, которое можно использовать и отдельно от underscore.js. На эту библиотеку повлияли идеи проектов prototype.js, right.js и underscore.js.
Эта библиотека даёт разработчику множество полезных функций, предназначенных для работы со строками. Вот некоторые из них:
- capitalize();
- clean();
- includes();
- count();
- escapeHTML();
- unescapeHTML();
- insert();
- splice();
- startsWith();
- endsWith();
- titleize();
- trim();
- truncate().
▍Установка
Вот команда, которой можно установить библиотеку:
npm i underscore.string
▍Примечательные методы
Метод numberFormat
Метод numberFormat() предназначен для форматирования чисел.
var _ = require("underscore.string"); _.numberFormat(1000, 3) // "1,000.000" _.numberFormat(123456789.123, 5, '.', ','); // "123,456,789.12300"
Метод levenshtein
Метод levenshtein() возвращает расстояние Левенштейна между двумя строками. Подробнее об алгоритме, используемом в этом методе, можно прочитать здесь.
var _ = require("underscore.string"); _.levenshtein('kitten', 'kittah'); // 2
Метод chop
Метод chop() разделяет переданную ему строку на части.
var _ = require("underscore.string"); _.chop('whitespace', 3); // ['whi','tes','pac','e'] → Вот страница, на которой можно найти подробности о библиотеке underscore.string
5. Stringz
Главная особенность библиотеки stringz заключается в том, что она умеет работать с Unicode-символами.
Если, без использования каких-либо библиотек, выполнить следующий код, то окажется, что длина строки составляет 2.
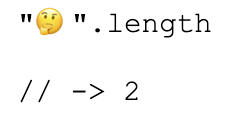
Всё дело в том, что метод JS-строк length() возвращает количество кодовых точек строки, а не количество символов. На самом деле, некоторые символы в диапазонах 010000–03FFFF и 040000–10FFFF могут использовать до 4 байт (32 бита) на кодовую точку, но это не меняет ответ: для того чтобы представить некоторые символы, нужно больше 2 байт, в результате они представлены более чем одной кодовой точкой.
→ Вот материал о проблемах обработки Unicode-символов в JavaScript.
▍Установка
Для установки данной библиотеки нужна такая команда:
npm i stringz
▍Примечательные методы
Метод limit
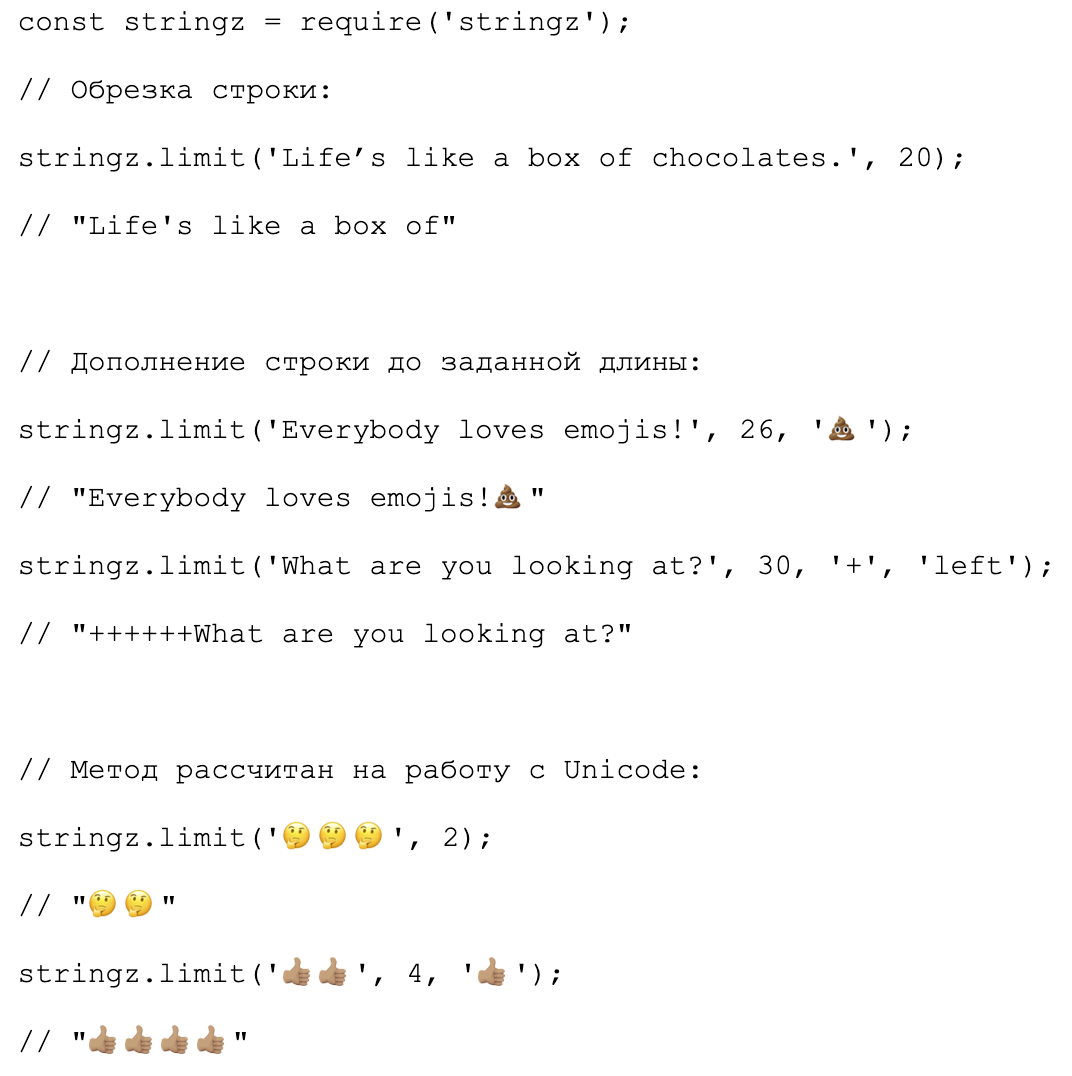
Метод limit() приводит строку к заданной длине.
Метод toArray
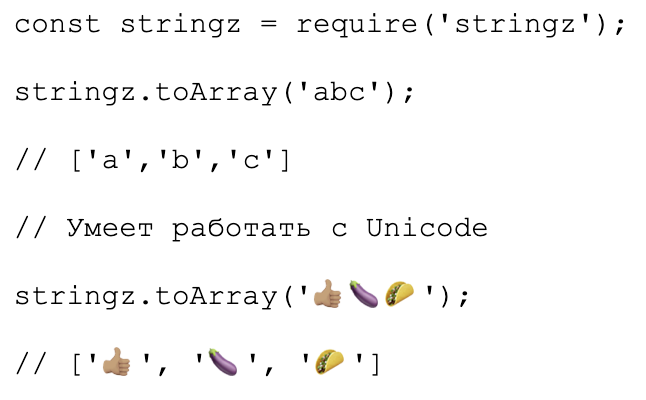
Метод toArray() преобразует строку в массив.
→ Вот страница репозитория библиотеки
А какие вспомогательные инструменты вы используете для работы со строками?
Напоминаем, что у нас продолжается конкурс прогнозов, в котором можно выиграть новенький iPhone. Еще есть время ворваться в него, и сделать максимально точный прогноз по злободневным величинам.
ссылка на оригинал статьи https://habr.com/ru/company/ruvds/blog/501632/
Добавить комментарий