- Как обойти капчу, используя распознавание звука
- Как обойти капчу: нейросеть на Tensorflow,Keras,python v числовая зашумленная капча
В этот раз поработаем над чем-то более серьезным и давно знакомым:
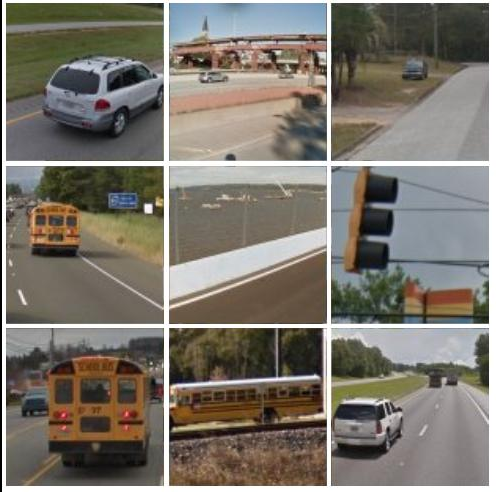
Итак задача: обойти капчу, желательно с первого раза.
Воспользуемся возможностями сверточных нейросетей, а именно vgg16.
Джентельменский набор, который используется:
- python 3.6.4
- tensorflow 2.0.0, keras 2.2.1
- opencv 4.1.2
В качестве полигона для тестов выберем какой-нибудь сайт с формой обратной связи, защищенной капчей гугл. Например, этот https://captcha.guru/ru/feedback/ (*искренне не знаю кто это такие, сайт выбран случайно).
Беглый анализ капч подобного вида показывает, что капча попадается в двух базовых вариантах:
— на 9 картинок (приведена в начале поста) и
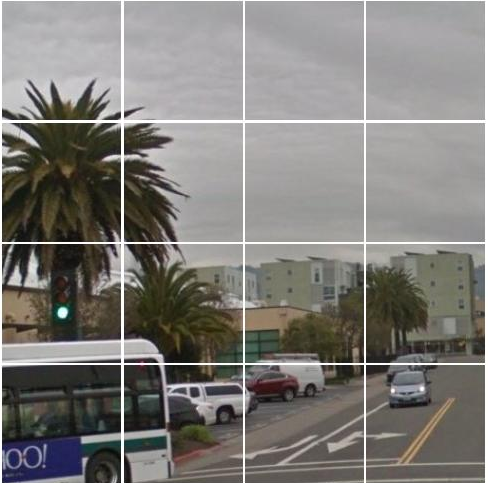
Также, статистика по капчам говорит о том, что капчи попадаются как минимум в 20-ти категориях с говорящими названиями: автобусы, гидранты и т.п.
Та же статистика говорит, что можно сэкономить силы и не обрабатывать все 20-ть и более категорий, а остановиться на наиболее часто встречающихся:

Поэтому, нейросеть была обучена только на усеченном количестве категорий, и будет работать с категориями капч, которые наиболее вероятны, остальные будет пропускать.
Общий алгоритм работы будет выглядеть так:
- зашли на сайт с капчей, нажали «Я не робот»;
- сделали скрин капчи с экрана, если она совпадает с определенными категориями объектов;
- разрезали капчу на части;
- скормили каждый кусок капчи нейросети;
- понажимали на картинки, где объект распознан нейросетью;
- обработали ошибки, и возможно, прошлись по 2-му, 3-му кругу капчи.
Итак, как говорится, ближе к коду.
Зашли на сайт с капчей, нажали «Я не робот»
Здесь воспользуемся фреймворком selenium в python.
import webbrowser,time,os,pyautogui from selenium import webdriver from selenium.webdriver.common.keys import Keys import random import os browser = webdriver.Firefox() browser.implicitly_wait(5) browser.get ('https://captcha.guru/ru/feedback/') time.sleep(5) iframe = browser.find_elements_by_tag_name('iframe')[0] browser.switch_to.frame(iframe) act = browser.find_element_by_css_selector('.recaptcha-checkbox-border') act.click() В коде видно, что капча появляется в отдельном так называемом фрейме. Это необходимо учитывать при переключениях между основным контентом и фреймами капчи.
После выполнения кода результат будет примерно следующий:

Теперь необходимо:
- получить категорию объекта капчи (здесь «мосты»);
- сохранить картинку в нужных пропорциях, если она в нужной категории объектов;
- разрезать картинку на 9 частей.
Сделали скрин капчи с экрана, если она совпадает с определенными категориями объектов
t=random.uniform(1, 4) #пауза между скачиваниями случайна browser.switch_to.default_content() iframe = browser.find_elements_by_tag_name('iframe')[3] browser.switch_to.frame(iframe) time.sleep(3) act = browser.find_element_by_xpath('/html/body/div/div/div[2]/div[1]/div[1]/div/strong') print(act.text) Здесь время t для случайной паузы, чтобы гугл, не слишком сразу определил нас как робота. Данную t мы применим позднее.
Этот код выведет категорию объекта, изображенного на капче (здесь «мосты»).
Задаем категории, с которыми будем работать, не пропуская:
a=['велосипеды','пешеходные переходы','гидрантами','автомобили','автобус'] Остальные категории отсекаются, так как они встречаются значительно реже, либо в капче 16-ть картинок вместо 9-ти.
Сделали скрин капчи с экрана, если она совпадает с определенными категориями объектов
Рассмотрим следующий фрагмент:
if act.text not in a: #обновили картинку с капчи act = browser.find_element_by_xpath('//*[@id="recaptcha-reload-button"]') act.click() time.sleep(t) browser.switch_to.default_content() iframe = browser.find_elements_by_tag_name('iframe')[3] #узнаем категорию капчи:автобусы,гидранты... browser.switch_to.frame(iframe) time.sleep(2) act = browser.find_element_by_xpath('/html/body/div/div/div[2]/div[1]/div[1]/div/strong') print(act.text) if act.text in a: #сохраняем картинку os.chdir('C:\\1\\') im=pyautogui.screenshot(imageFilename=str(0)+'.jpg',region=(509,411,495,495)) #нарезаем картинку img = Image.open('0.jpg') area1=(0,0,163,163) #спереди,сверху,справа,снизу) img1 = img.crop(area1) area2=(163,0,326,163) img2 = img.crop(area2) area3=(326,0,489,163) img3 = img.crop(area3) area4=(0,163,163,326) img4 = img.crop(area4) area5=(163,163,326,326) img5 = img.crop(area5) area6=(326,163,489,326) img6 = img.crop(area6) area7=(0,326,163,489) img7 = img.crop(area7) area8=(163,326,326,489) img8 = img.crop(area8) area9=(326,326,489,489) img9 = img.crop(area9) img1.save("1"+".png") img2.save("2"+".png") img3.save("3"+".png") img4.save("4"+".png") img5.save("5"+".png") img6.save("6"+".png") img7.save("7"+".png") img8.save("8"+".png") img9.save("9"+".png") Здесь вначале происходит проверка категории объекта. Если объект из категории «велосипеды»,«пешеходные переходы»,«гидранты»,«автомобили» либо «автобус», то программа работает далее. В противном случае, обновляет картинку капчи.
Далее картинка сохраняется по пути C:\1\vgg-net\0.jpg (в windows).
И нарезается с сохранением 9-ти файлов .png в этой же директории.
Скормили каждый кусок капчи нейросети
Понадобится предобученная модель нейросети, в которую для анализа будут поступать нарезанные картинки.
from keras.models import load_model import argparse import pickle import cv2 def prescript(file): # функция нейросети ap = argparse.ArgumentParser() ap.add_argument("-i", "--image",type=str, default=file,help="path to input image we are going to classify") ap.add_argument("-m", "--model",type=str,default="simple_nn.model",help="path to trained Keras model") ap.add_argument("-l", "--label-bin",type=str,default="simple_nn_lb.pickle",help="path to label binarizer") ap.add_argument("-w", "--width", type=int, default=32, help="target spatial dimension width") ap.add_argument("-e", "--height", type=int, default=32, help="target spatial dimension height") ap.add_argument("-f", "--flatten", type=int, default=1, help="whether or not we should flatten the image") args = vars(ap.parse_args()) image = cv2.imread(file) output = image.copy() image = cv2.resize(image, (args["width"], args["height"])) image = image.astype("float") / 255.0 if args["flatten"] > 0: image = image.flatten() image = image.reshape((1, image.shape[0])) else: image = image.reshape((1, image.shape[0], image.shape[1], image.shape[2])) model = load_model(args["model"]) lb = pickle.loads(open(args["label_bin"], "rb").read()) preds = model.predict(image) i = preds.argmax(axis=1)[0] label = lb.classes_[i] text = "{}: {:.2f}%".format(label, preds[0][i] * 100) print(text[0]) # 1-предмет есть на картинке, 0 - предмета нет global result result = text[0] Нейросеть помещена в функцию, которая отдает либо 1 (‘объект есть на картинке’) либо 0 (‘нет объекта’).
Еще одна функция, с помощью которой будем кликать по картинкам, если нейросеть вернула ‘1’ (наличие объекта):
def clicks(x,y): if result=='1': # если предмет есть на картинке, нажимаем на картинку act = browser.find_element_by_xpath('/html/body/div/div/div[2]/div[2]/div/table/tbody/tr['+str(x)+']/td['+str(y)+']') act.click() Ну и собственно, функция, которая будет вызывать 9-ть раз (картинок 9 штук) функцию нейросети и функцию «нажимания на картинки»:
def predict(): prescript("1"+".png") clicks(1,1) prescript("2"+".png") clicks(1,2) prescript("3"+".png") clicks(1,3) prescript("4"+".png") clicks(2,1) prescript("5"+".png") clicks(2,2) prescript("6"+".png") clicks(2,3) prescript("7"+".png") clicks(3,1) prescript("8"+".png") clicks(3,2) prescript("9"+".png") clicks(3,3) act = browser.find_element_by_css_selector('#recaptcha-verify-button') act.click() time.sleep(1) predict()
Обработали ошибки, и возможно, прошлись по 2-му, 3-му кругу капчи
Иногда, после даже после нажатий на «правильные» картинки капчи, предлагается заново ее пройти с фразами: «Попробуйте еще раз», «Вы слишком стары для этого» и т.п.
Поэтому добавим код для учета ситуаций:
try: act = browser.find_element_by_css_selector('.rc-imageselect-error-dynamic-more') #Посмотрите также новые изображения. captcha() # заново сохраняем картинки predict() # заново распознаем картинки except: try: act = browser.find_element_by_css_selector('.rc-imageselect-incorrect-response')#Повторите попытку. captcha() # заново сохраняем картинки predict() # заново распознаем картинки except: pass О минусах реализации:
- работает не со всеми категориями картинок (это сделано намеренно, чтобы облегчить размер модели);
- ошибается (все-таки обучающий набор был не размера imagenet, а google неохотно отдавал экземпляры для обучения);
- работает неспеша, так как последовательно обрабатывается каждая из 9-ти картинок;
- не работает с 16-сегментными картинками.
*Статья носит научно-познавательный характер, не направлена на нарушение действующего законодательства и не содержит призывы к данному нарушению.
Программы для скачивания (программа и модель) — скачать.
ссылка на оригинал статьи https://habr.com/ru/post/478578/
Добавить комментарий