Привет Хабр! Последняя статья про инструменты для профилирования php датируется аж 2018 годом. Но все перечисленные решения имеют недостатки: древний интерфейс btp (аналог pinba), оверхед xhprof и необходимость ручного запуска phpspy на stage.
Я тимлид в рекомендательном сервисе Zoon и перед моей командой стояла цель найти инструменты, которые профилируют весь код на проде 24/7 и хранят данные. Инструменты, с которыми могут работать рядовые разработчики, без доступа к проду. Инструменты, которые позволяют находить «бутылочные горлышки» за 30 секунд.
В конце 2021 года показался свет в конце туннеля, в виде системы на основе семплирующего eBFP профайлера: prodfiler.
Содержание
Обзор prodfiler
Не буду останавливаться на том, как работают eBPF профайлеры, это подробно описано тут: https://habr.com/ru/company/badoo/blog/520086/

Сразу перейдем к интеграции профайлера в существующую архитектуру, основанную на docker.
-
Зарегестрироваться в личном кабинете на сайте
-
Запустить привелегированный контейнер с eBPF профайлером и настроить его на отправку данных на удаленный сервер
-
Ждать появления данных в личном кабинете
По состоянию на ноябрь 2021 года мы не смогли получить понятное отображение трейсов для php. В личном кабинете были видны вызовы системных функций, но использовать их для поиска медленных мест было слишком трудозатратно.
Тестировали на максимально простых бенчмарках из исходников php. Либо, дело в том что проект находится в beta версии, либо требуется дополнительная настройка, либо есть проблемы с совместимостью с php 8.0+.
Были и другие причины искать альтернативу:
-
Сторонний привелегированный контейнер на всех прод машинах
-
Планы сделать проект платным после выхода из бета версии
-
Хранение данных на сторонних серверах
Обзор pyroscope
Было решено протестировать еще несколько альтернатив. На бумаге pyroscope удовлетворял всем нашим требованиям больше, чем blackfire или newrelic. Это семплирующий профайлер, у него удобный интерфейс, есть автоматический сбор данных. В качестве бонуса: это self hosted и opensource проект.
Состоит из двух компонентов — сервера и агента. Агент профилирует код и отправляет по api данные на сервер. Сервер хранит и отображает данные в виде интерактивного flamegraph или таблицы.

Схема очень похожа на prodfiler, но есть нюансы. В качестве агента можно использовать проверенный временем phpspy, а данные хранятся на нашем железе.
Алгоритм настройки из документации выглядит так:
-
Поднимаем свой docker контейнер с сервером pyroscope для хранения и отображения данных
-
Добавляем форк phpspy от разработчиков pyroscope в свои php контейнеры
-
Даем разрешение SYS_PTRACE нашим контейнерам, чтобы phpspy мог обращаться к ядру и собирать сэмплы с трейсами
-
Запускаем фоновый процесс агента, указываем какие процессы мониторить и адрес сервера для отправки данных
Мы все сделали по инструкции и оно заработало…
Шутка 🙂
Возникли проблемы с настройкой встроенного php агента, которые и стали поводом для этого поста.
Настройка phpspy
Поддержка php >=8.0
Проект использует копию phpspy, которая редко обновляется. По состоянию на ноябрь 2021 года в ней были проблемы с поддержкой php 8.0+. Названия функций не читаются.

Но у pyroscope есть простой api для приема трейсов из сторонних агентов.
Решили попробовать другую схему: собирать трейсы стандарным phpspy, конвертировать их в нужный формат и отправлять данные в api.
Это сработало и мы, наконец, увидели красивые flamegraph и таблички!


Ссылка на исходники скрипта для конвертации и отправки данных в конце.
Полнота данных
Документация у phpspy есть, но довольно минималистичная. Он умеет подключаться к работающим процессам, используя регулярное выражение или конкретный pid. Трейсы можно выводить в файл или stdout. Можно профилировать несколько процессов. Все что нужно для счастья! Кажется, что таску в jira можно закрыть за пару часов 🙂
Но опять сталкиваемся с кучей проблем:
-
По умолчанию размер трейса не может превышать 4096 байт. В нашем случае это порядка 30-40 строк. Если трейс больше, то вместо него выводится ошибка.
-
Если увеличить размер, то запись в файл становится не атомарной и трейсы из разных потоков начинают смешиваться.
-
Регулярное выражение, которое мы использовали для поиска процессов передается в pgrep. Pgrep отдает список pid, отсортированным по возрастанию. Значит профилироваться будут одни и теже старые процессы.
Причем эти баги обнаружили не сразу. Последний — только через полгода использования 🙂
Больше всего в изучении параметров помог аргумент --verbose-fields=p. Он добавляет после каждого трейса строку вида `# pid = 670`. Далее можно сохранить вывод и анализировать его вот так:
cat trace.txt | grep -E '# pid = [0-9]+' | sort | uniq -c | sort -nr
Это позволило разобраться с логикой работы аргументов --threads, --rate-hz, -P.
Аргумент -P так же полезно проверить через запуск pgrep с теми же параметрами и дополнительным флагом --list-full, для вывода полной команды, а не только pid процесса.
В итоге получилась такая команда:
/zoon/zprof/bin/phpspy --max-depth=-1 --time-limit-ms=59000 --threads=1024 --rate-hz=4 --buffer-size=65536 -P '-x "php|php[0-9].[0-9]|php-fpm|php-fpm[0-9].[0-9]" | shuf' > phpspy.trace 2> phpspy_error.log
Что означают параметры:
-
--max-depth=-1— не ограничиваем максимальное количество строк в трейсе -
--time-limit-ms=59000— время работы профайлера, он автоматически завершится через 59 сек. Мы запускаем команду по крону, раз в минуту. -
--threads=1024— один из самых важных параметров. Отвечает за количество процессов, которые будут профилироваться.
Допустим, в контейнере работает 2048 php процессов. Значит наша команда в течении минуты будет профилировать только половину. В случае завершения процесса начинает профилироваться другой. Если процессов меньше, то семплы соберутся со всех. phpspy работает не корректно, если указать больше потоков — количество сэмплов резко сокращалось. 1024 — это фактический максимум для этого параметра. -
--rate-hz=4— частота семплирования. Можно так же использовать альтернативный параметр--sleep-ns=— что бы указать количество наносекунд между семплами. Работает совместно с предыдущим параметром. Т.е. семплы снимаются с одних и тех же процессов с выбранной частотой. -
--buffer-size=65536Размер стектрейса в байтах. По умолчанию размер 4096 байт, так как это максимальный размер для атомарной записи в файл. Если трейс больше указанного лимита, то вместо трейса выводится ошибка:event_handler_fout_snprintf: Not enough space in buffer; truncatingПри числе потоков больше 1 есть вероятность “смешивания” выводов и порчи данных.
Но вместо прямой записи в файл из дочерних потоков можно просто перенаправлять поток из основного процесса в файл.
Было:/zoon/zprof/bin/phpspy --output=trace_file.txt ...Стало:
/zoon/zprof/bin/phpspy ... > trace_file.txtПри перенаправлении вывода в файл данные записываются атомарно, независимо от числа потоков и размера буфера.
-
-P '-x "php|php[0-9].[0-9]|php-fpm|php-fpm[0-9].[0-9]" | shuf'регулярное выражение для поиска всех php процессов.
Содержимое аргумента-Pвставляется в строкуpgrep %sи выполняется. Далее phpspy подключается к полученному списку pid процессов пока не достигнет лимита из параметра--threads(или не закончатся процессы).Pgrep отдает список pid, отсортированным по возрастанию. Для того, что бы выборка была репрезентативной можно перемешать вывод с помощью консольной утилиты
shuf. Хорошо, что в phpspy нет экранирования аргументов и итоговая команда выполняется, какpgrep -x "..." | shufАругмент
-xозначает, что pgrep будет отдавать pid только тех процессов, чьи имена точно соответствуют регулярному выражению. Так исключается вероятность профилирования процессов содержащих в имени php.
Нагрузка
Наша инфраструктура
Php код выполняется на двух десятках машин. 70% машин отвечают за обработку запросов (fpm), 30% машин — фоновые и периодические задачи (cli).
Каждый месяц обрабатываем запросы от 36 млн. пользователей из более чем 20 стран. В последнее время быстро растет количество посещений зарубежных сайтов.
Агент phpspy
Во время семплирования phpspy упирается в CPU.
Во время тестов, при числе потоков 1024 (количество php процессов на сервере > 2500) и частоте семплирования 4 Гц (1/250 мс) phpspy использовал до 130% CPU (чуть более одного ядра). Скорость генерации трейсов — около 6-8 Мбайт/сек.
Если число процессов на сервере ниже, то нагрузка пропорционально снижается.
Нагрузка и количество данных линейно зависят от частоты семплирования и количества профилируемых процессов.
За счет группировки перед отправкой — потребление трафика на несколько порядков ниже размера «сырых» трейсов.
Замерили и производительность адаптера, конвертирующего, группирующего и отправляющего семплы на сервер. Пиковая производительность нашего php скрипта составляет около 150 Мбайт трейсов в секунду. В наших условиях он загружен частично и поэтому утилизирует до 5% CPU. Оперативная память — до 900 Мбайт.
Сервер pyroscope
Данные отправляются на сервер pyroscope по крону (старая версия адаптера), поэтому нагрузка неравномерная. В будущем планируем перейти на более частую отправку данных. Но даже в таком «стресс» режиме потребление ресурсов скромное. Так же часть ресурсов утилизируется встроенным профайлером (pyroscope профилирует сам себя).
-
CPU: не превышает 65%, т.е. хватает одного ядра.
-
Сеть: около 50 Кбайт/с входящего трафика с одной машины. Семплы отправляются со всех контейнеров, выполняющих php код.
-
Оперативная память: от 4 до 14 Гигабайт. Памяти на машине с избытком, а в документации есть опции, говорящие о том, что очистка кешей происходит в зависимости от заполнености памяти. Поэтому при сокращении доступной памяти на сервере аппетиты pyroscope должны сократиться. Но отдельно это не тестировали.
-
Диск: 50 Гб при хранении данных за 3 последних месяца без downsampling’a


Оптимизация настроек сервера
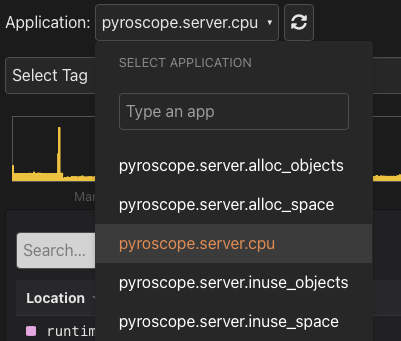
По-умолчанию, сервер pyroscope профилирует сам себя. Это удобно, что бы посмотреть примеры того, какие метрики можно собирать и как их анализировать в вэбинтерфейсе. Возможности не ограничиваются профилированием памяти или cpu. Но нет смысла делать это постоянно.
В документации не нашел, как отключить встроенный агент. Оказалось, что опция no-self-profiling есть только в исходниках, ее забыли перенести в документацию 🙂
После отключения агента нагрузка и потребление памяти в контейнере с pyroscope упали в несколько раз. Не ожидал, что прием сэмплов с десятков наших машин генерировал лишь небольшую часть нагрузки.

Наша конфигурация сейчас выглядит так:
retention: 720h # keep data for 30 days analytics-opt-out: true # disable analytics no-self-profiling: true # disable profiling of pyroscope server log-level: error auth: gitlab: enabled: true client-id: xxxxxx client-secret: xxxxxx auth-url: https://your-gitlab-server.com/oauth/authorize token-url: https://your-gitlab-server.com/oauth/token api-url: https://your-gitlab-server.com/api/v4Пример использования
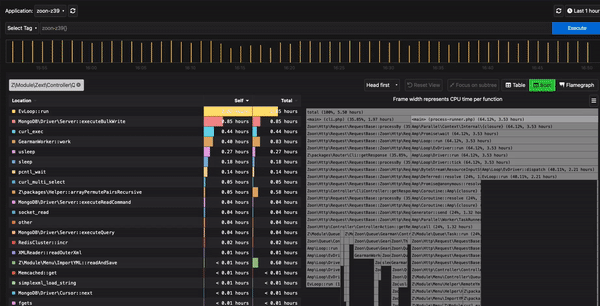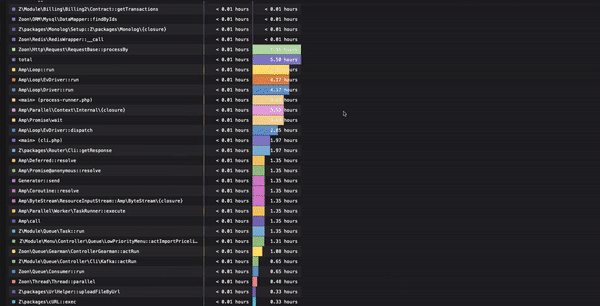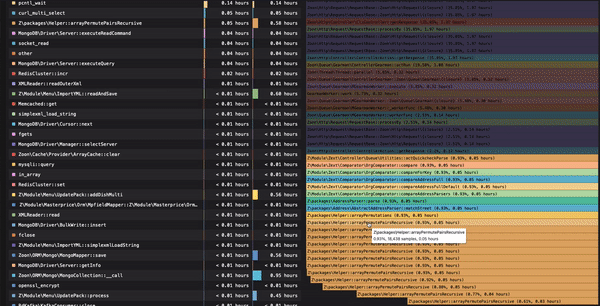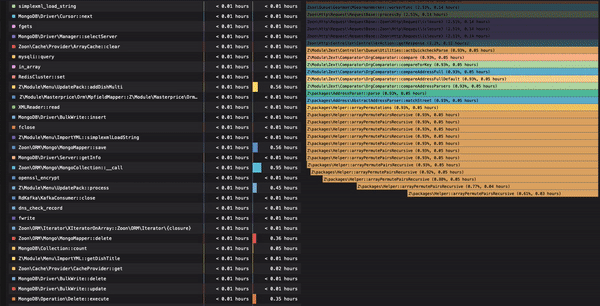
-
Находим какой нибудь cli процесс, который работает значительно дольше положенного через мониторинг в grafana или командой в контейнере:
ps aux | grep php | grep -E ' Mar[0-9][0-9]' -
Мне под руку попался воркер, который обрабатывает задачи в контроллером Utilites. Контроллер указывается в команде запуска, поэтому виден в списке процессов.
-
Открываем pyroscope, выбираем данные за последний час на интересующей нас машине.
-
Ищем поиском по странице нужный контроллер и выбираем его. После выбора элемента он так же подсвечивается на flamegraph справа.
-
Кликаем на flamegraph и разворачиваем ветку с контроллером.
-
Видим что все время тратится на рекурсивное выполнение одного и того же метода который возвращает все уникальные комбинации элементов.
-
Меняем рекурсию на более оптимальный нерекурсивный алгоритм с помощью хабра и википедии
-
Получаем ускорение в over9000 раз.
-
Заливаем новый вариант и проверяем, что время работы метода совпадает с ожиданиями.
Результаты
-
8% — получение списка городов из memcache. При этом список городов у нас обновляется редко.
-
3% — на preg_match в роутере. Да, регулярки медленные даже с JIT компиляцией. Лучше ими не злоупотреблять.
-
Очень много времени тратим на подключение к redis. Будем проверять конфигурацию и улучшать архитектуру.
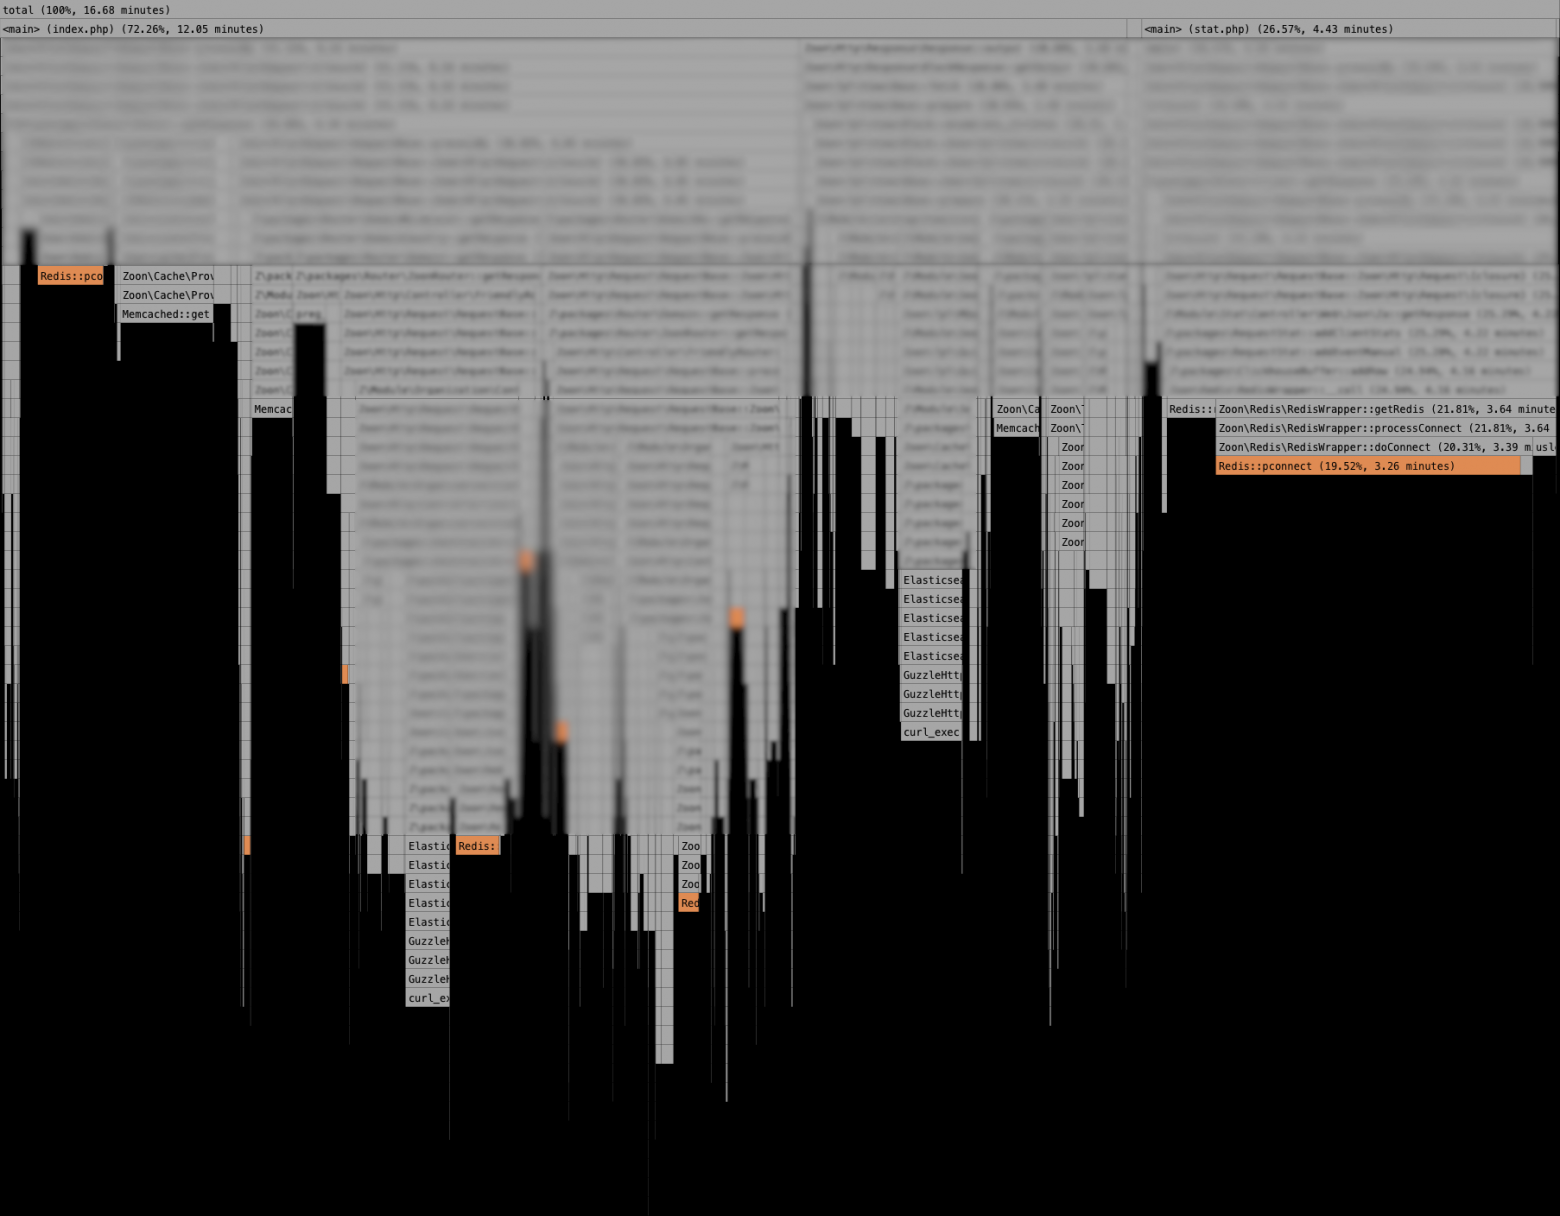
flamegraph для всех fpm процессов на одной из машин -
Время открытия каталога на 80-90% состоит из времени ответов memcached и elastic. Т.е. время выполнения php кода почти не влияет на время ответа. В первую очередь нужно оптимизировать запросы к БД.
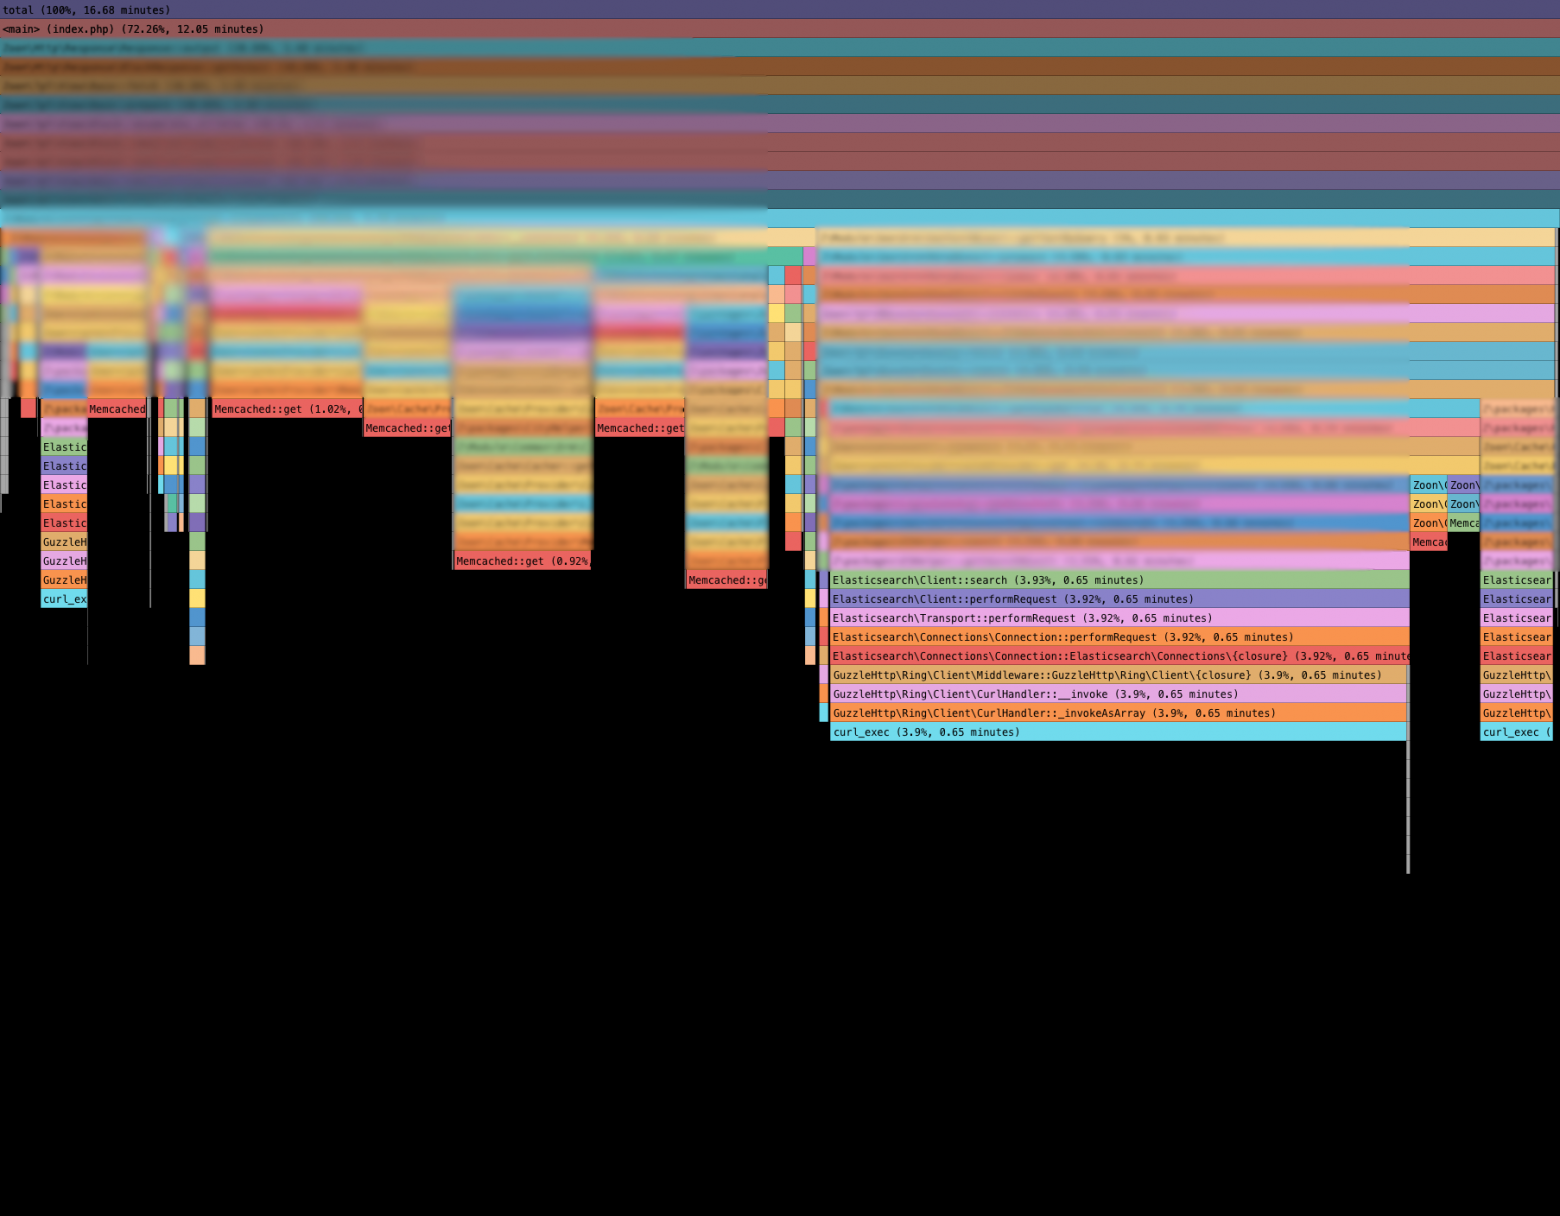
flamegraph для каталога


Планы
-
Группировать трейсы в памяти и отправлять их чаще, а не раз в 5 минут по крону. Это позволит сделать нагрузку на сеть и CPU равномерной, а так же уберет нагрузку с дисков.Сделано в последней версии нашего адаптера. -
Очень не хватает возможности профилировать отдельные страницы. Например страницу каталога или организации.
Phpspy дает возможность добавить path, cookie и даже значения переменных в виде коментариев к генерируемым трейсам. Эти данные можно использовать для группировки трейсов и простановки тегов при отправке в api pyroscope.
-
Так как мы профилируем все процессы на сервере, то иногда нужная ветка настолько тонкая, что не подсвечивается на flamegraph и на нее нельзя кликнуть. При этом flamegraph генерируется на основе json файла в котором есть все данные. Т.е. вопрос только в логике работы js.
Исходный код
Результат 6 месяцев проб и ошибок — вторая версия нашего адаптера для приема и конвертации данных из phpspy и отправки в pyroscope: https://github.com/zoonru/pyrospy
ссылка на оригинал статьи https://habr.com/ru/post/662349/
Добавить комментарий