Привет, Хабр!
Мое приключение началось с того, что я поймал очередную двухполюсную волну, похожую на всем известное расстройство. С одной стороны, маркетинг вендоров рапортует, что SIEM (Security information and event management) системы — это сердце SOC (Security Operations Center), новый век наступил и текущий уровень развития решений этого класса настолько высок и зрел, что его внедрение разом избавит всех от неприятностей. Всем станет легко собрать данные из множества источников, с минимальными затратами обнаруживать подозрения на инциденты и далее по списку. С другой стороны, эксплуатанты и внедренцы SIEM, с которыми я пересекаюсь, говорят, что везде боль, тлен, безысходность.
Так кто же на самом деле прав? Чтобы ответить себе на этот вопрос, я решил провести небольшое исследование среди специалистов по своему роду деятельности так или иначе связанных с разработкой, внедрением и эксплуатацией SIEM систем. И в этой статье я хочу поделиться с сообществом его результатами.
Кратко о том, что вас ждет дальше:
-
Сперва будут ключевые вопросы респондентам об их опыте с SIEM системами, графики, показывающие как обстоят дела в реальности, и пояснения к ним;
-
После цифр – основные мои мысли и выводы по этому поводу;
-
И на последок, конечно же, слова благодарности.
Кто эти люди?
Знакомиться с ними будем основываясь на том, как опрошенные связаны с SIEM системами: создают, внедряют или эксплуатируют, а также на том, сколько EPS (Events per Second) подают в систему. Вот так выглядят опрошенные с точки зрения графиков (все картинки кликабильны):
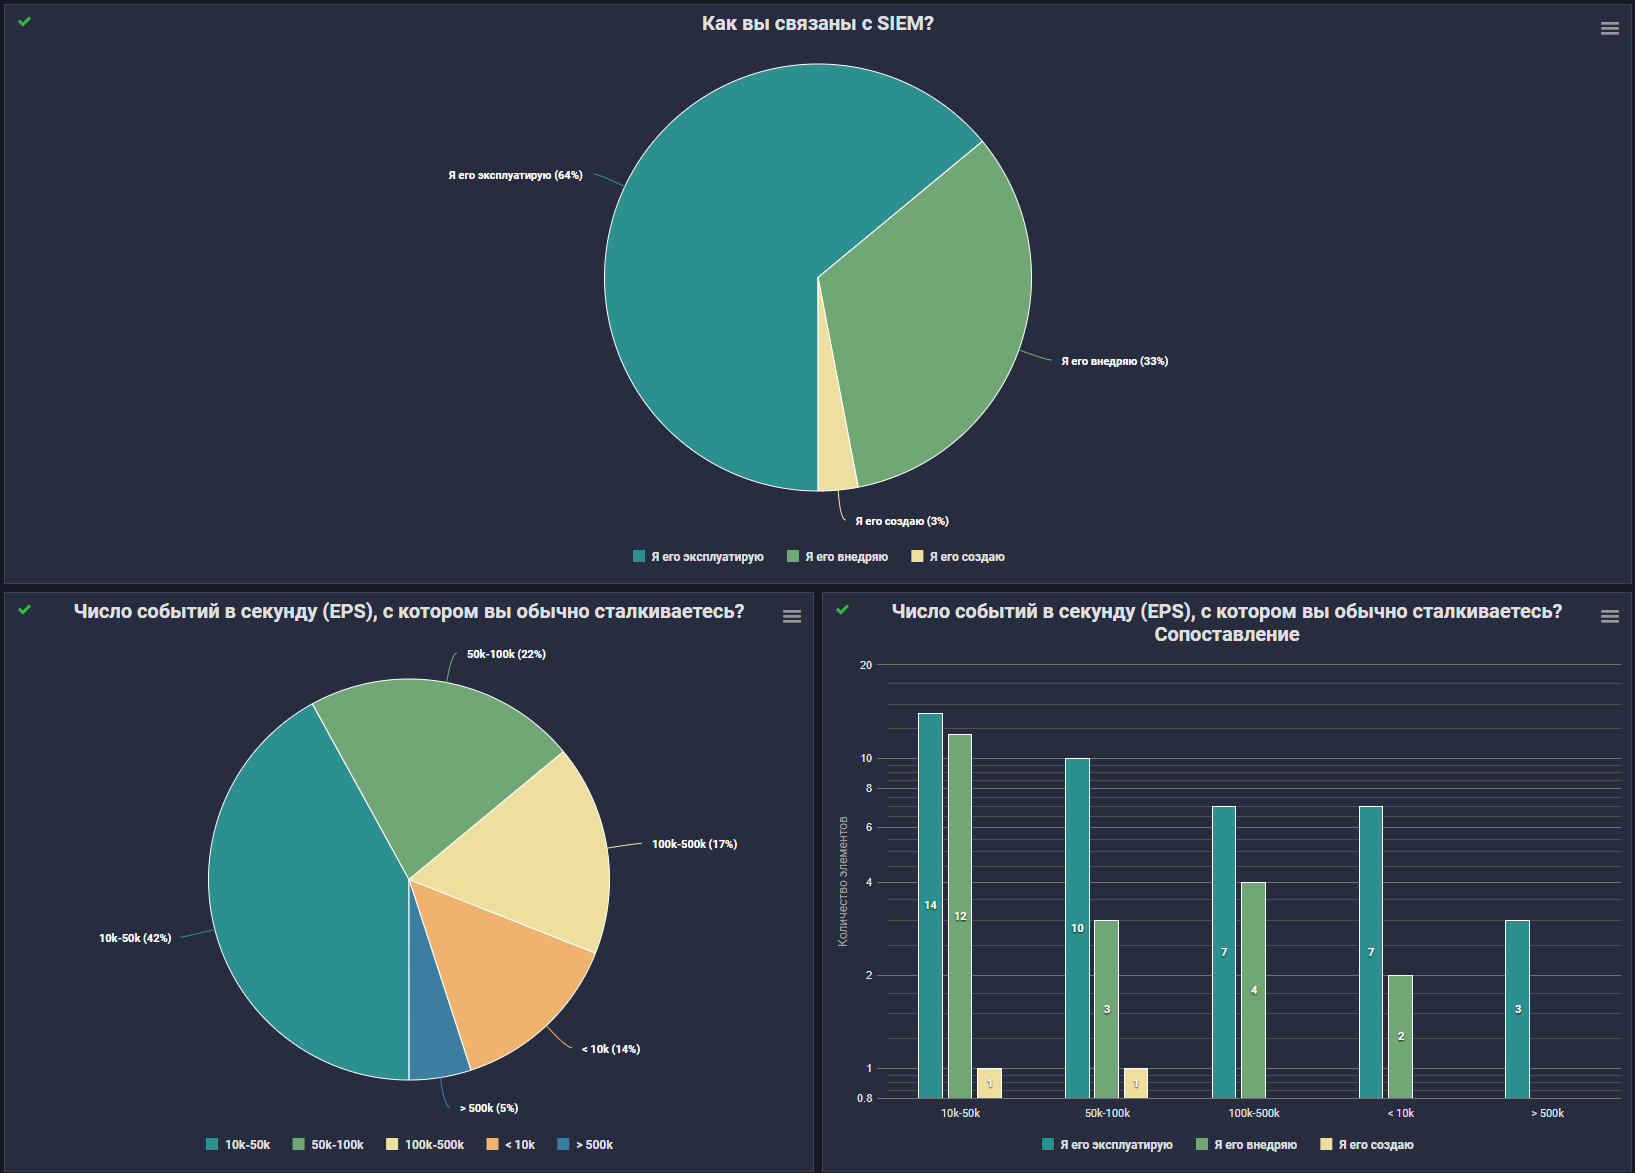
В опросе участвовали 64 респондента, из которых на долю эксплуатантов пришлось 41 человек или в процентном соотношении 64%. Внедренцев SIEM из числа откликнувшихся было 21, то есть 33% от общего числа опрошенных. А из разработчиков аж целых 2 человека. Ребят, спасибо вам огромное за ваш нелегкий труд!
Посмотрим на ситуацию EPS:
-
В основном участвующие в исследовании специалисты сталкиваются с диапазоном 10k-50k, а это 42% опрошенных;
-
При этом с диапазоном 50k-100k сталкиваются всего 22% респондентов, а вот уже с 100k-500k — 17%;
-
Остальные 19% разделились между самыми маленькими и самыми большими до 10k, что составляет 14%;
-
И только у 5% от общего числа участвующих в опросе — «мастодонтов» – более 500k EPS.
Выяснив, кто наши респонденты, предлагаю посмотреть, как они взаимодействуют с SIEM системами. Далее я постарался быть максимально лаконичным и охватил наиболее часто задаваемые вопросы, с которыми так или иначе сталкиваются все специалисты. Ответы получились весьма интересными.
Результаты опроса
Потоки событий
Первый вопрос, который меня интересовал: а какой поток из всего объема логов SIEM уходит на коррелятор?
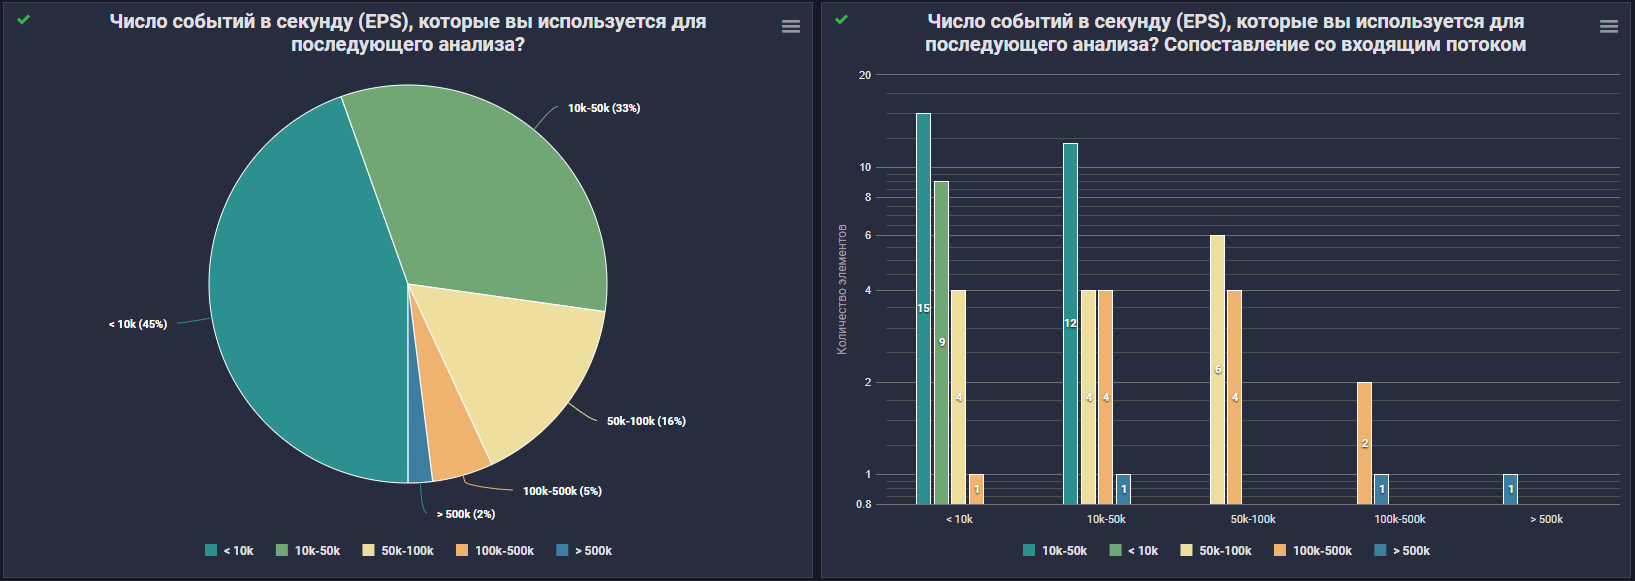
Рисунок выше наглядно нам показывает:
-
Самый популярный поток на коррелятор — до 10k EPS, то есть 45%;
-
За ним идет категория с диапазоном 10k-50k, где 33% опрошенных;
-
А вот уже по возрастанию EPS процент опрошенных падает и составляет всего 16% у диапазона 50k-100k;
-
В диапазон 100k-500k попадают 5%;
-
А в более 500k EPS на коррелятор всего 2%.
Справа на графике представлены показатели «EPS на коррелятор», сгруппированные по входящему потоку. Глядя на график соотношения входящего потока и потока на коррелятор, можно сказать, что из SIEM в полный рост делают достаточно дорогой лог менеджер. В некоторых случаях только каждое 10е событие проходит через коррелятор.
Ок, с EPSами на коррелятор все понятно, а как дела обстоят с хранением?
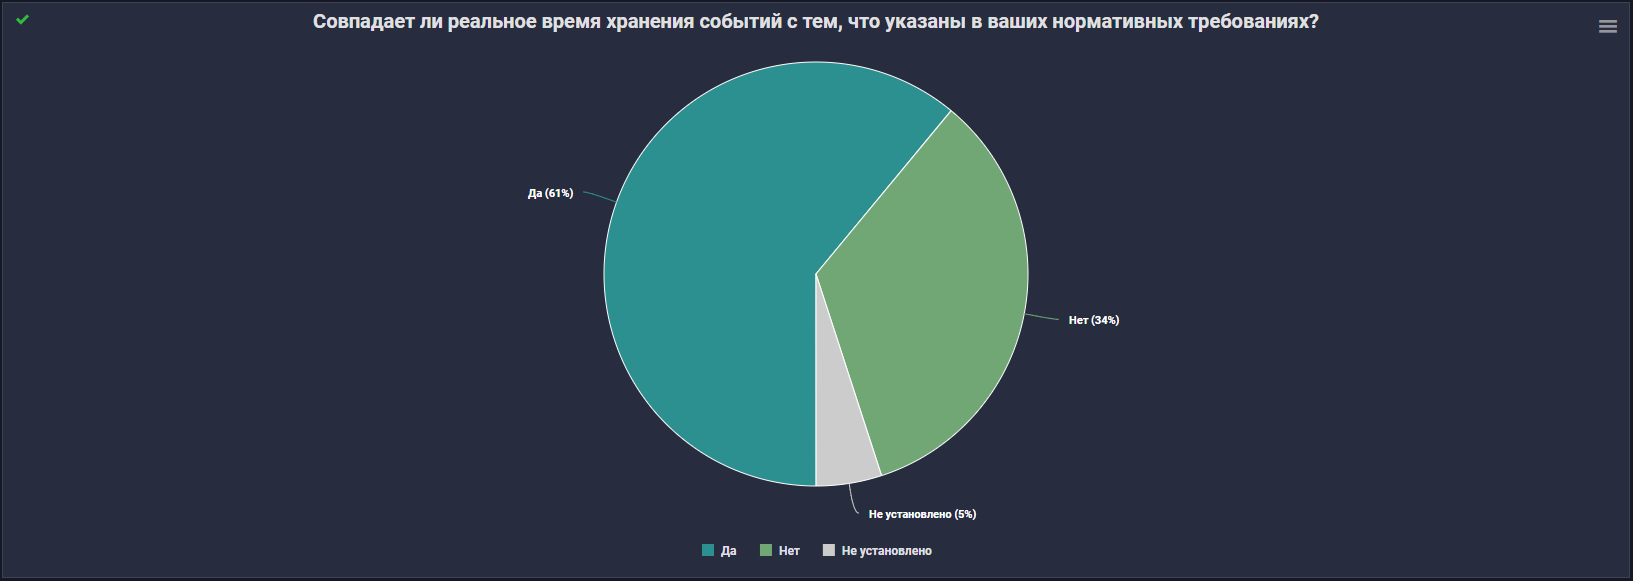
Тут я думаю комментарии излишни… Поэтому я все-таки решил пойти дальше и узнать реальную глубину хранения данных, задав соответствующий вопрос.
А сколько же реально хранятся данные?
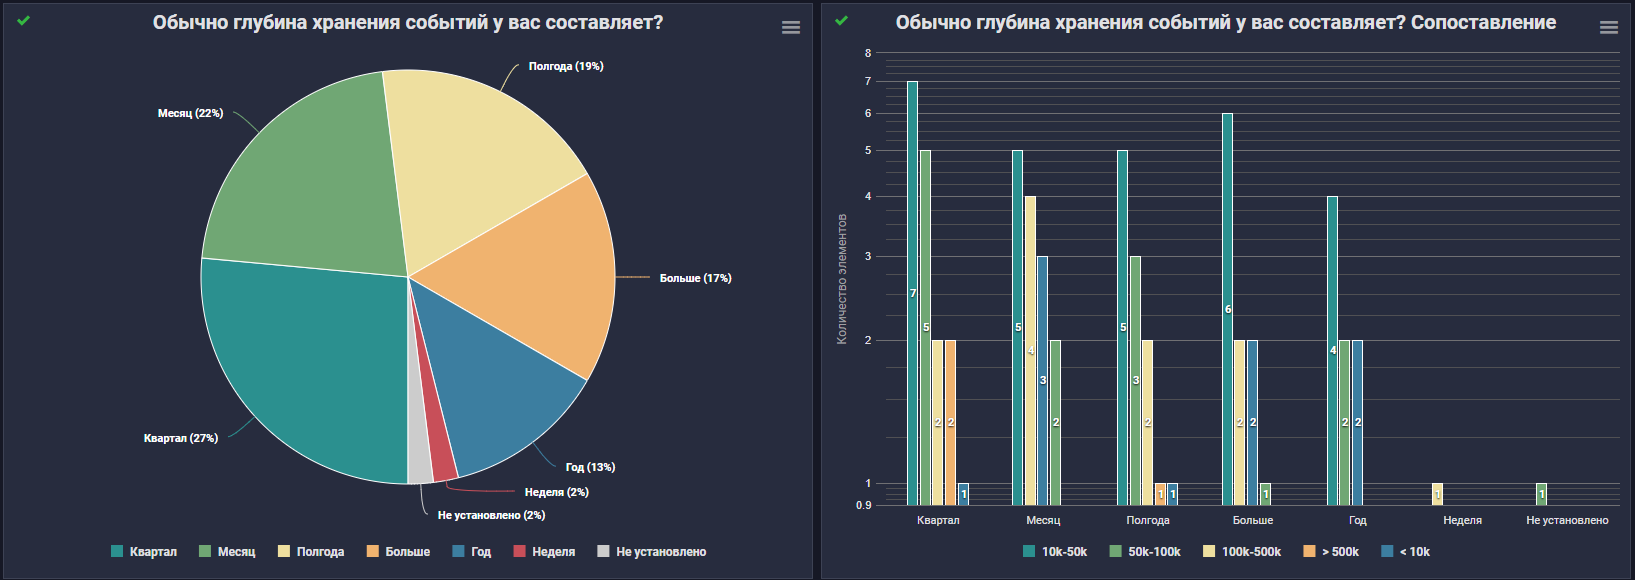
Информация на графике слева говорит нам о том, что:
-
27% опрошенных хранят данные один квартал;
-
У кого эта глубина составляет месяц — 22%;
-
Полгода обеспечивают хранение всего 19%;
-
А больше, чем один год — 17%.
Рядом гистограмма с корреляцией глубины хранения и входящего потока логов. Честно говоря, я ожидал более ярко выраженного «квартала». И несколько печалит «неделя», потому как на практике данных за неделю не всегда хватает, чтобы «размотать» ту или иную атаку.
Кроме этого, меня также волновали вопросы: умеют ли SIEM системы опрашиваемых обеспечивать централизованный сбор? И может каким-то системам тоже нужны эти логи?
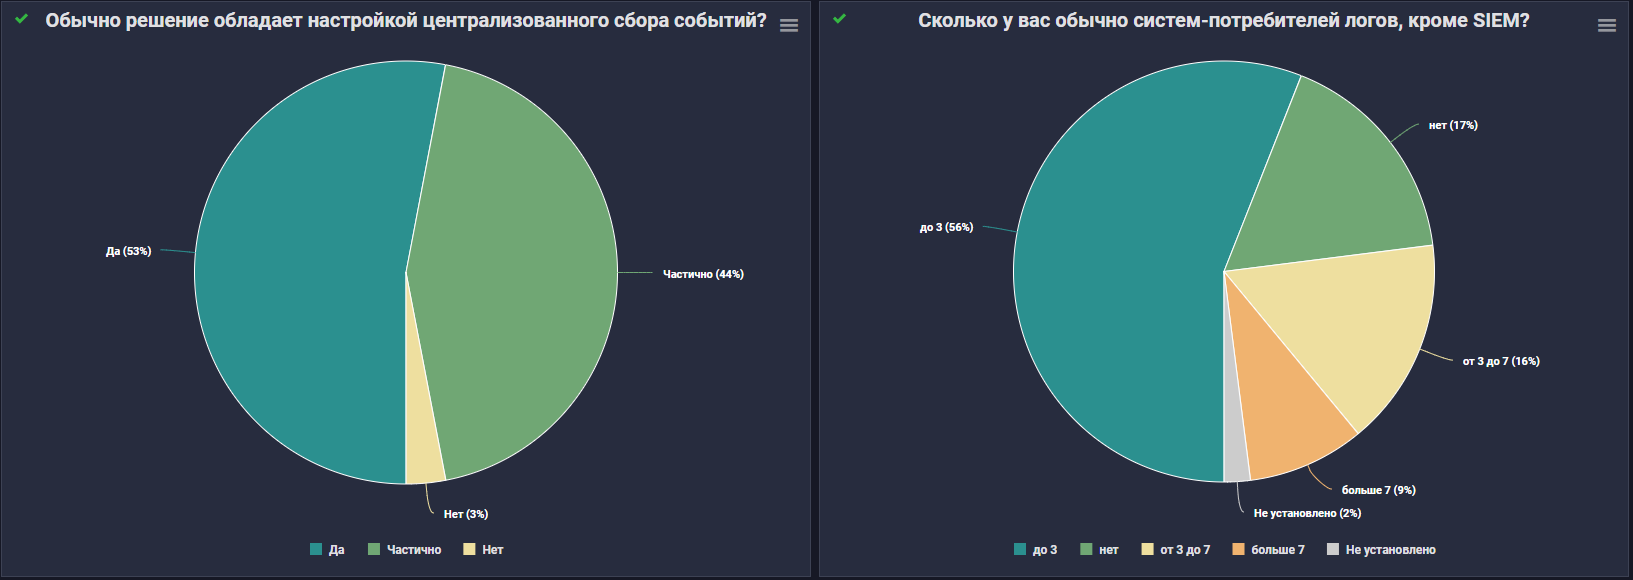
Централизованный сбор так или иначе умеют 97% решений опрошенных. В то же время систем-потребителей логов, кроме SIEM, не имеют всего 17% опрошенных. Что непрозрачно намекает о насущной необходимости выделенного LM(Log Management) решения, а может, даже и SDL(Security Data Lake).
Из более-менее объективных данных приглашаю вас окунуться в максимально субъективную историю. Дальше мне было интересно узнать, как респонденты в целом оценивают время поиска событий системе? Устраивает ли оно их?
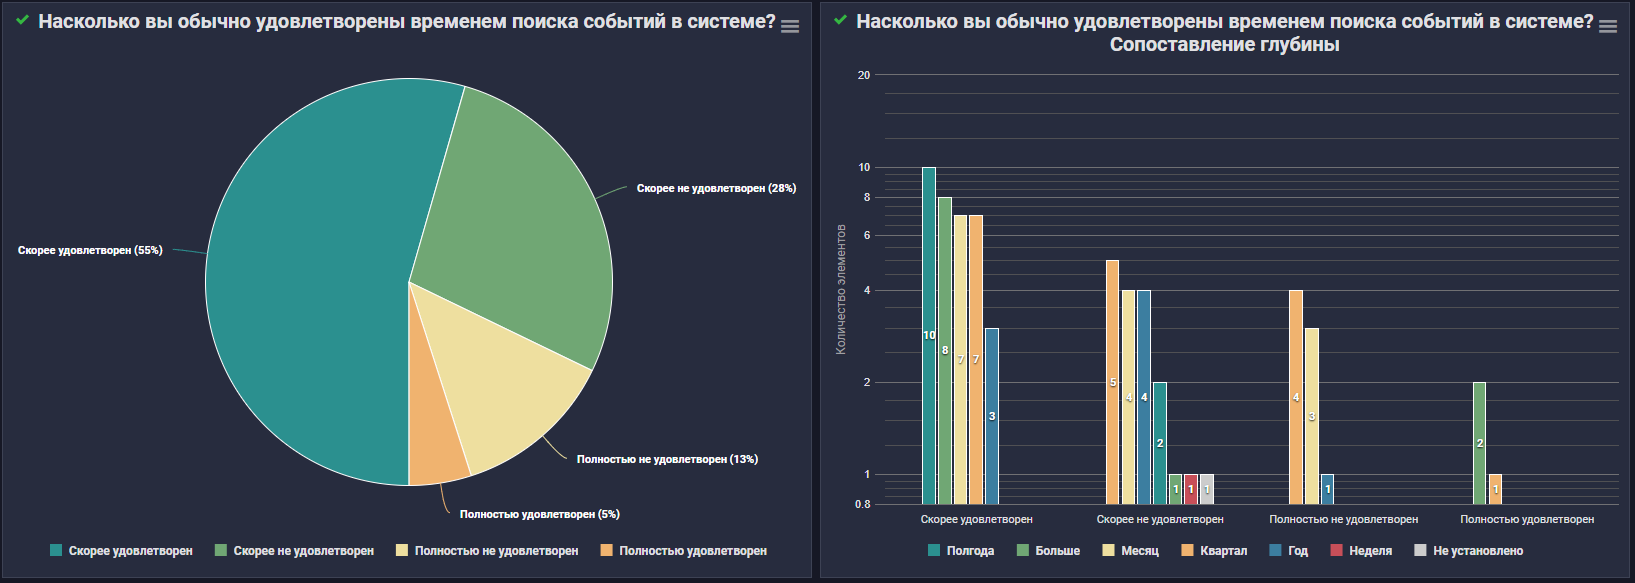
И вот, что из этого получилось на выходе:
-
Большее количество опрошенных (55%) сказали, что их все скорее устраивает;
-
При этом, как ни странно, второе место занимают те, кто, не удовлетворены скоростью поиска — 28%;
-
А тех, кто совсем не удовлетворены – целых 13%;
-
Предыдущий показатель намного выше оценки полностью довольных, которых всего составило 5%.
Справа на графике представлена корреляция глубины хранения и удовлетворенности.
А далее следует график удовлетворенности временем поиска в зависимости от входящего потока EPS.
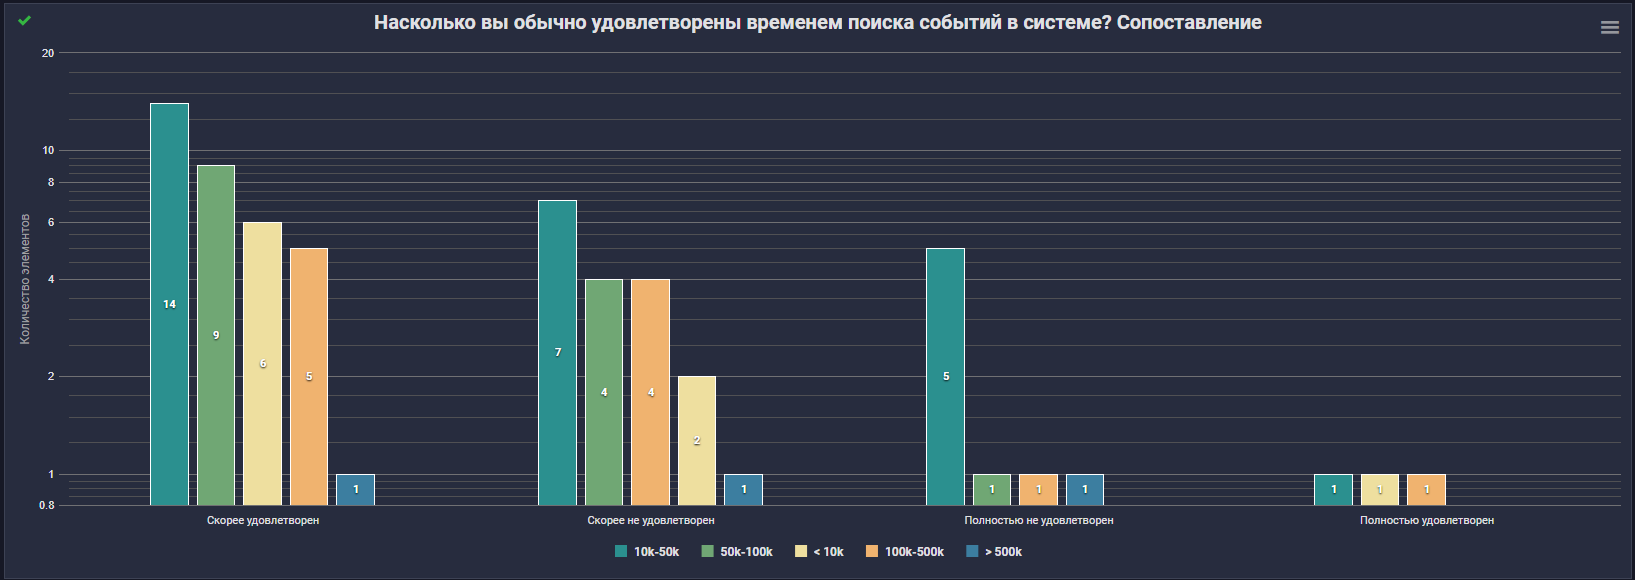
Можно долго рассуждать о причинах, но факт говорит, что времени поиска есть куда улучшаться.
Источники данных
Перейдем к следующему блоку вопросов, он будет более прикладным и связан с источниками данных, поставляемых c SIEM-системами. Первый и, пожалуй, один из ключевых вопросов, который я задал респондентам: а устраивает ли их список источников событий, поддерживаемых в SIEM?
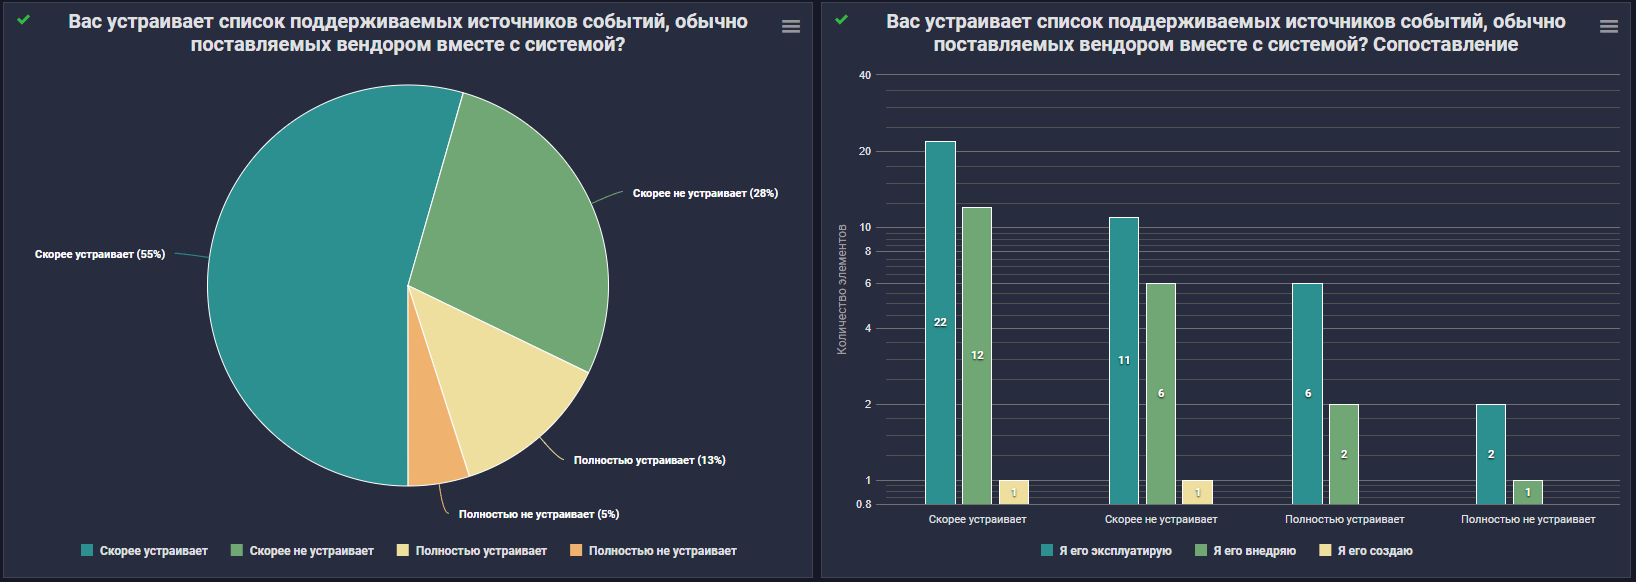
Как мы видим, всё вроде даже очень неплохо. Список поддерживаемых источников скорее (55%) или полностью устраивает (13%) — 68% респондентов. Обратная ситуация у 33%.
Как же я «обожаю» округления. С точностью до десятых там:
-
54.7% и 12.5% с положительной коннотацией;
-
28.1%, 4.7% с отрицательной.
А вот на рисунке 9, мы можем увидеть насколько часто участвующие в опросе подключают уникальные источники событий?
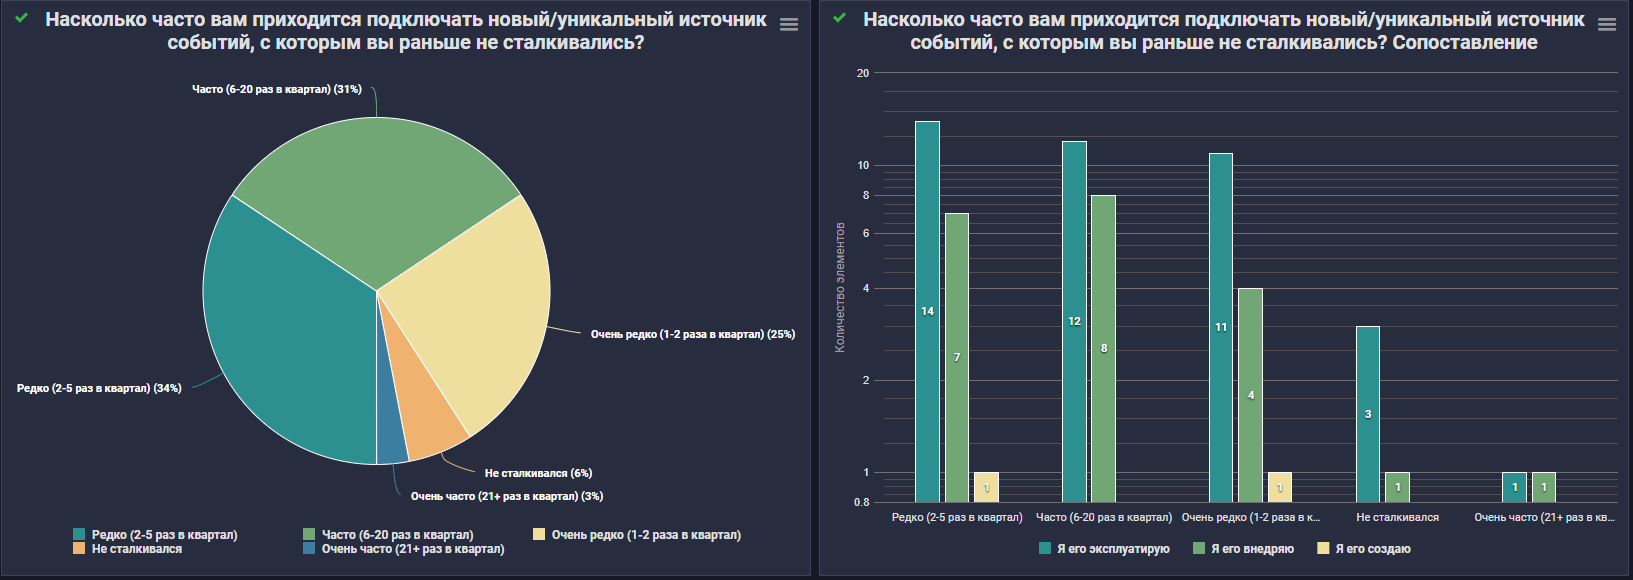
В свою очередь, с историей добавления нового/уникального источника не сталкивалось только 6% опрошенных. Для остальных новых источников скорее рутина с разной степенью повторяемости.
С источниками событий вроде понятно, но SIEM же должен уметь в корреляцию, да?
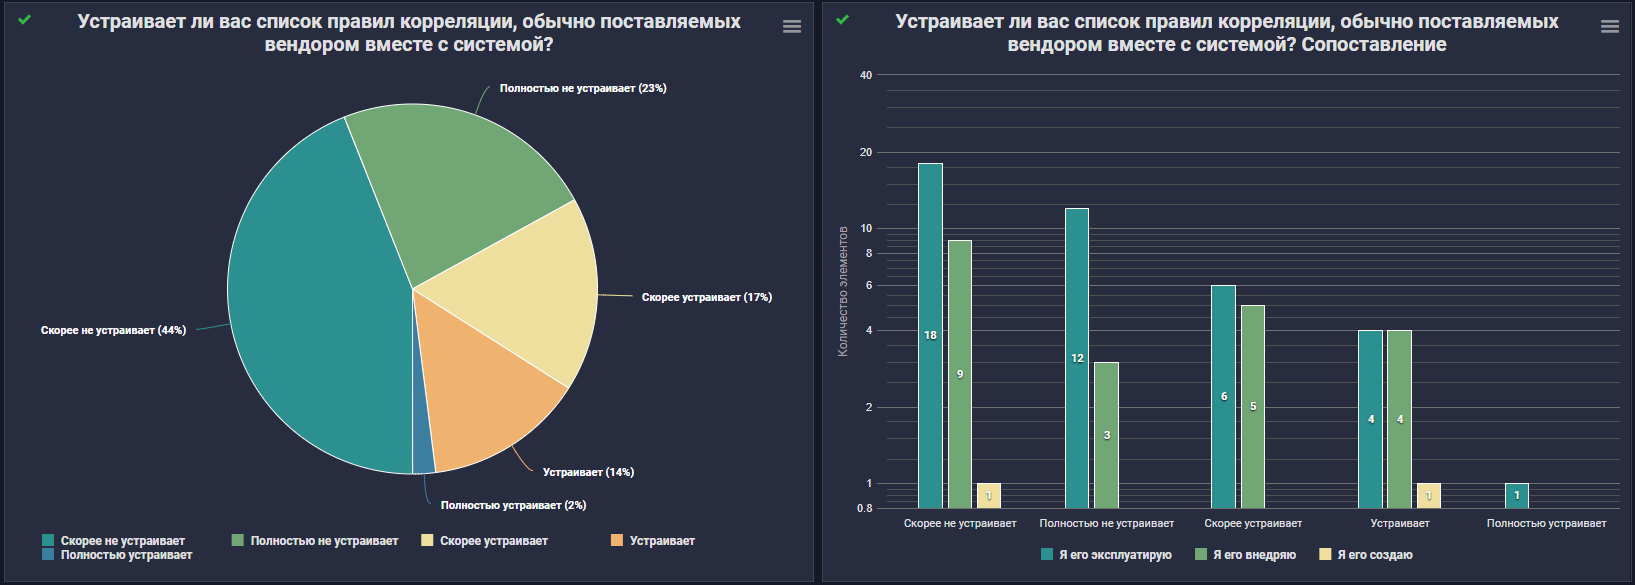
В итоге правила корреляции из коробки:
-
Скорее НЕ устраивают большинство опрошенных, а если быть точнее — 44%;
-
При этом полностью НЕ устраивает 23%;
-
В положительном ключе оценивают список правил корреляции – всего 33%.
А сейчас давайте посмотрим, как часто приходится пилить свои правила для уникальных источников?
Больше 5 раз в квартал этим занимаются больше половины, а именно 58% респондентов. Как обычно их связь на соседнем графике.

И здесь становится понятным, что новые правила под источники приходится делать часто.
Теперь предлагаю ознакомиться с привычными инструментами их создания. Поэтому следующий вопрос, который я задал респондентам, был связан с частотой разработки правил в конструкторе.

И решения извечного холивара: «»наелозить» правило мышкой VS написать код/псевдокод» так и не случилось, поскольку итоги у нас получились следующими:
-
36% используют оба способа;
-
30% чаще «елозинг»;
-
19% чаще код;
-
16% коррелятор не трогают.
Соседний график нам рассказывает кто эти люди.
Перейдем к следующему. Хорошей практикой при разработке является также версионирование и тестирование.
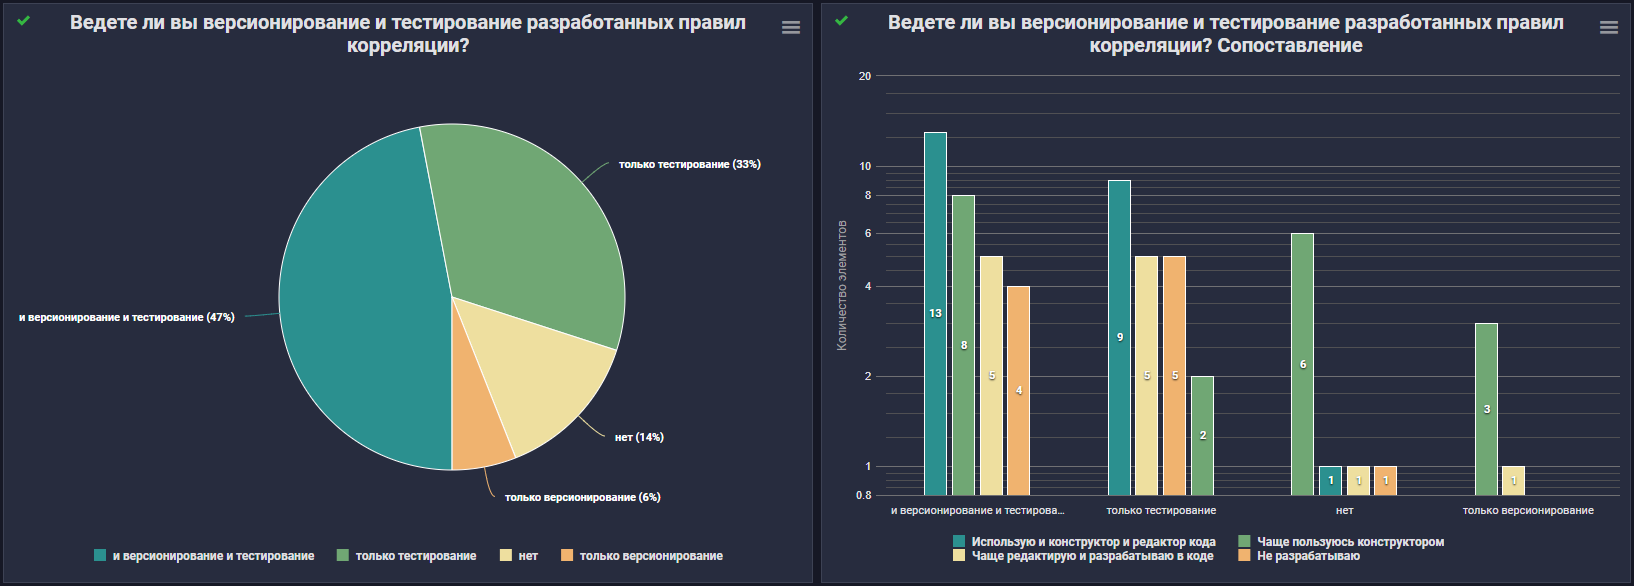
В этом вопросе, как оказалось:
-
Со мной согласны 47%, они ответили, что используют версионирование и тестирование;
-
Только тестируют это 33%;
-
При этом 14% опрошенных считают, что это всё от лукавого и правила нужно сразу деплоить в прод без всякого теста и версионирования.
На графике рядом показана корреляция с инструментами для написания правил.
И …барабанная дробь… сколько же правил у нас на корреляторе?
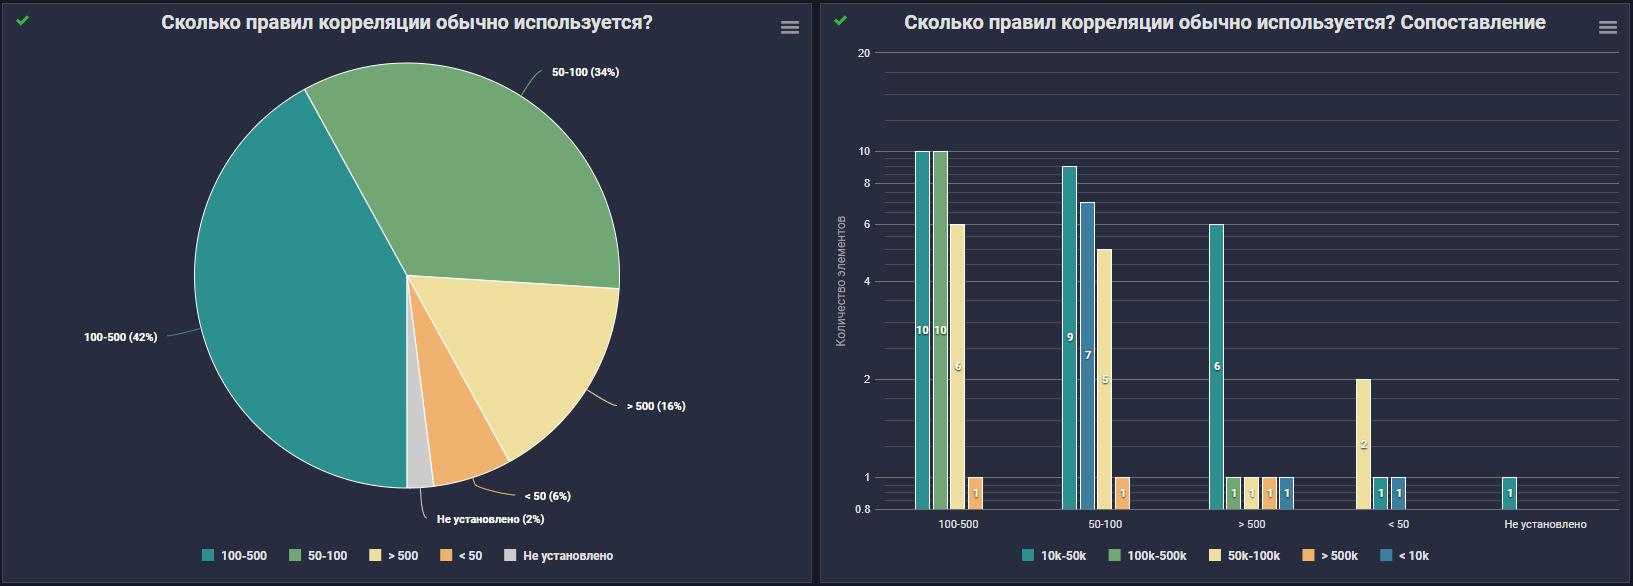
Скажу честно, результат меня весьма удивил! Что мы видим:
-
Большинство участников ответили, что количество используемых ими правил составило от 100 до 500 42%;
-
На следующем месте оказались респонденты, применяющие от 50 до 100 правил — 34%;
-
А вот более 500 – 16%;
-
Только 8% опрошенных используют либо менее 50 правил, либо не владеют такими данными.
На соседней гистограмме показана корреляция количества правил и входящего потока EPS. Коллеги, со 100+ правилами, вы герои. Поддерживать такой объем и вручную — это настоящий подвиг.
А «на сладкое» вашему вниманию еще один холивар мой заключительный вопрос: Какой подход по «нормализации» данных для вас является более предпочтительным?

И опять что-то интересное:
-
52% ответили, что «Все события могут быть нормализованы в любую модель данных, модель данных могут быть созданы, как вендором, так и самим пользователем»;
-
38% адептов «Все события нормализуются в единую модель данных (пример CEF)»;
-
и только 8% за вариант «Все события нормализуются в несколько заранее созданных вендором моделей данных, в зависимости от типа событий (Authentication, Object Access, Networks)».
Но, все-таки почему?
Да-да, выше я обещал, что вопрос про нормализацию будет последним, однако открытым остался самый главный вопрос статьи: почему везде «боль, тлен и безысходность?«
Опираясь на все полученные данные по итогам опроса, я презентую ниже подборку «болей».
Как говорил Михаил Николаевич Задорнов: «Готовы?»
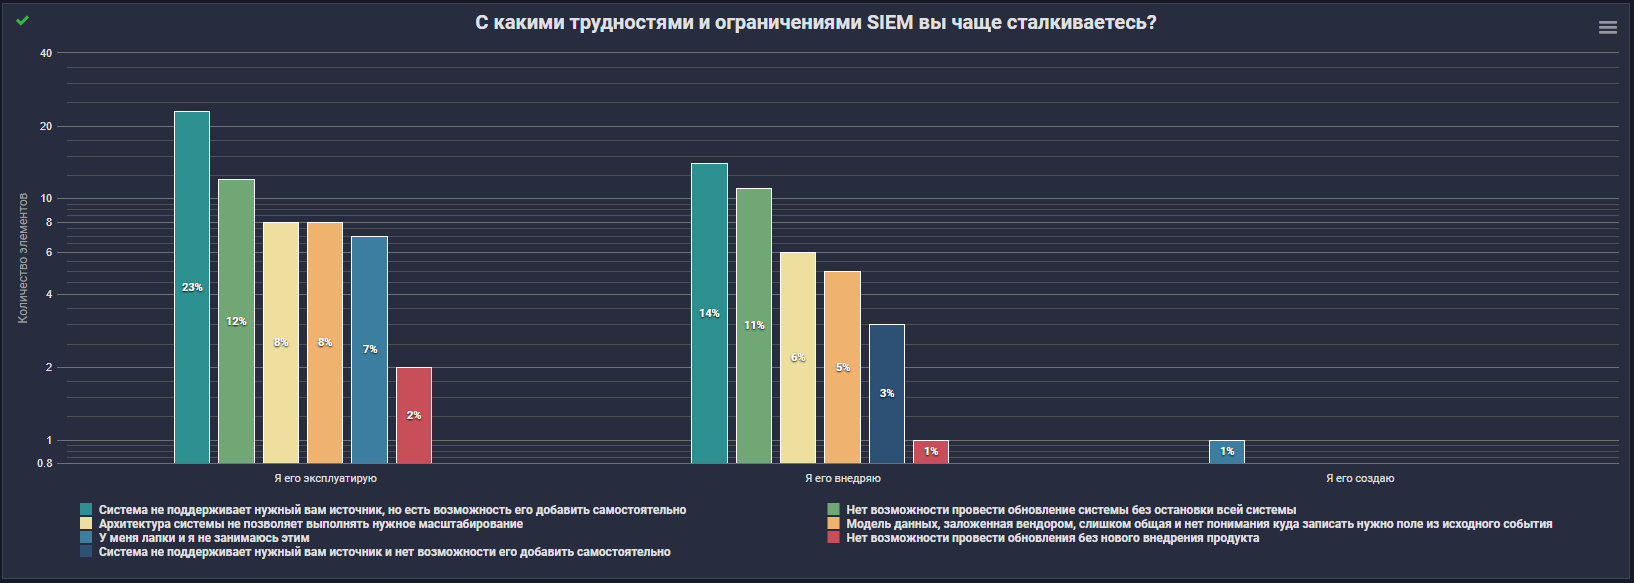
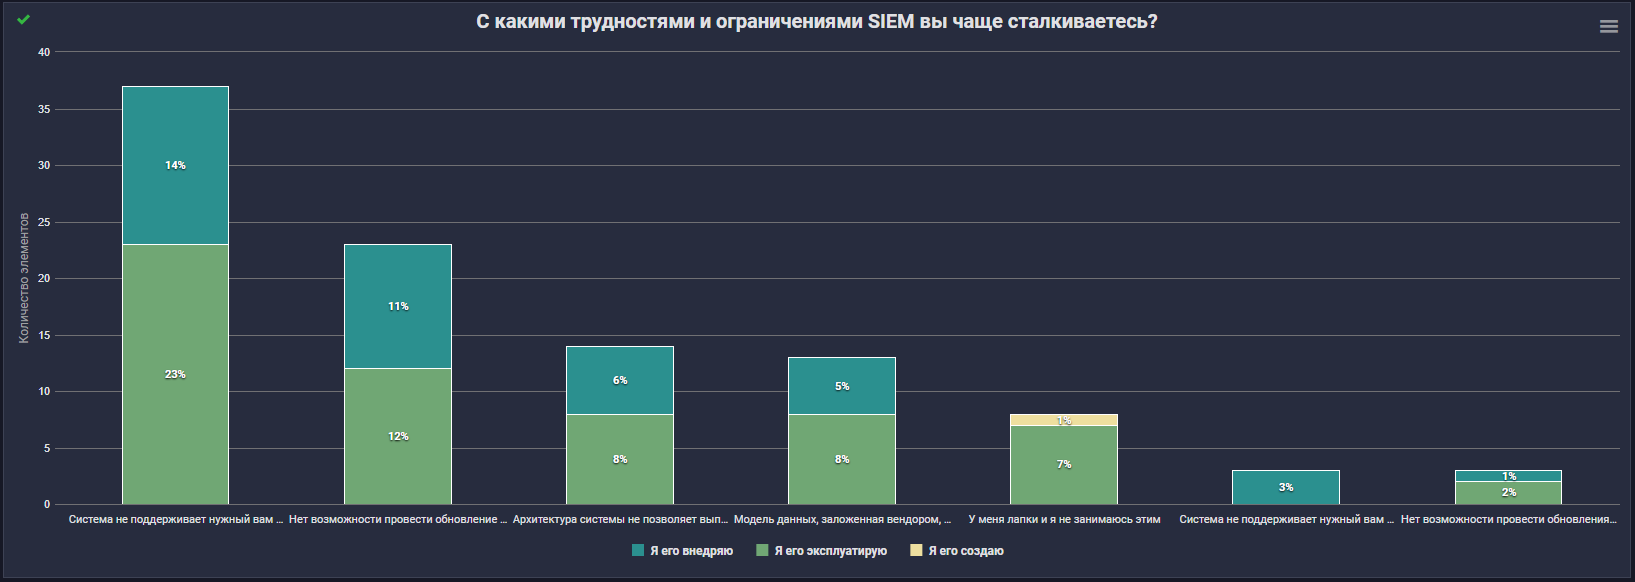
Сильнее всего у эксплуатантов болит от того, что SIEM не поддерживает нужный им источник, при этом они имеют возможность добавить его самостоятельно – так ответили 23% опрошенных. Также наиболее критичными моментами являются отсутствие возможности обновления SIEM без остановки работы всей системы (12%) и ее производительность — архитектура этого класса решений не позволяет выполнять нужное масштабирование (8%).
Перейдем к внедренцам. У них болит там же, только в несколько других пропорциях: 14%, 11% и 6% соответственно.
А у создателей болят лапки :3
Далее я попытаюсь подвести итоги всего вышенаписанного.
Во-первых, что сразу «бросилось» в глаза, так это частое использование SIEM в качестве Log Management. При этом, учитывая, что в инфраструктурах пользователей есть еще системы-потребители логов, и я подозреваю, что там ситуация с необходимостью хранить логи аналогичная. В итоге один и тот же набор данных хранится в 3+ системах одновременно (где-то тут всплакнул один Сакити Тоёда). Во многом из-за такого нерационального использования ресурсов не все опрошенные могут обеспечить необходимую глубину хранения данных в соответствии со своей же нормативкой.
Если говорить о более прикладных аспектах использования SIEM систем, то временем поиска скорее или полностью удовлетворены больше половины участников опроса. И «изкоробочные» источники также скорее устраивают более половины респондентов. Но на мой взгляд, такое «скорее» можно приравнять к тройке с плюсом по пятибалльной шкале, потому что сильнее всего болит именно отсутствие источников из коробки. При этом испытывать «боль» за квартал приходится 2-5 раз 34% и 6-20 31% опрошенных.
Перейдем к правилам обнаружения, и здесь стоит отметить, что «изкоробковые» правила корреляции большинство респондентов не устраивают, а количество боевых правил у большинства исчисляется сотнями.
Среди остальных участвующих осталось 20% смельчаков, деплоящих правила сразу в прод без тестирования. Тут можно только процитировать Максима Горького «Безумству храбрых поём мы славу».
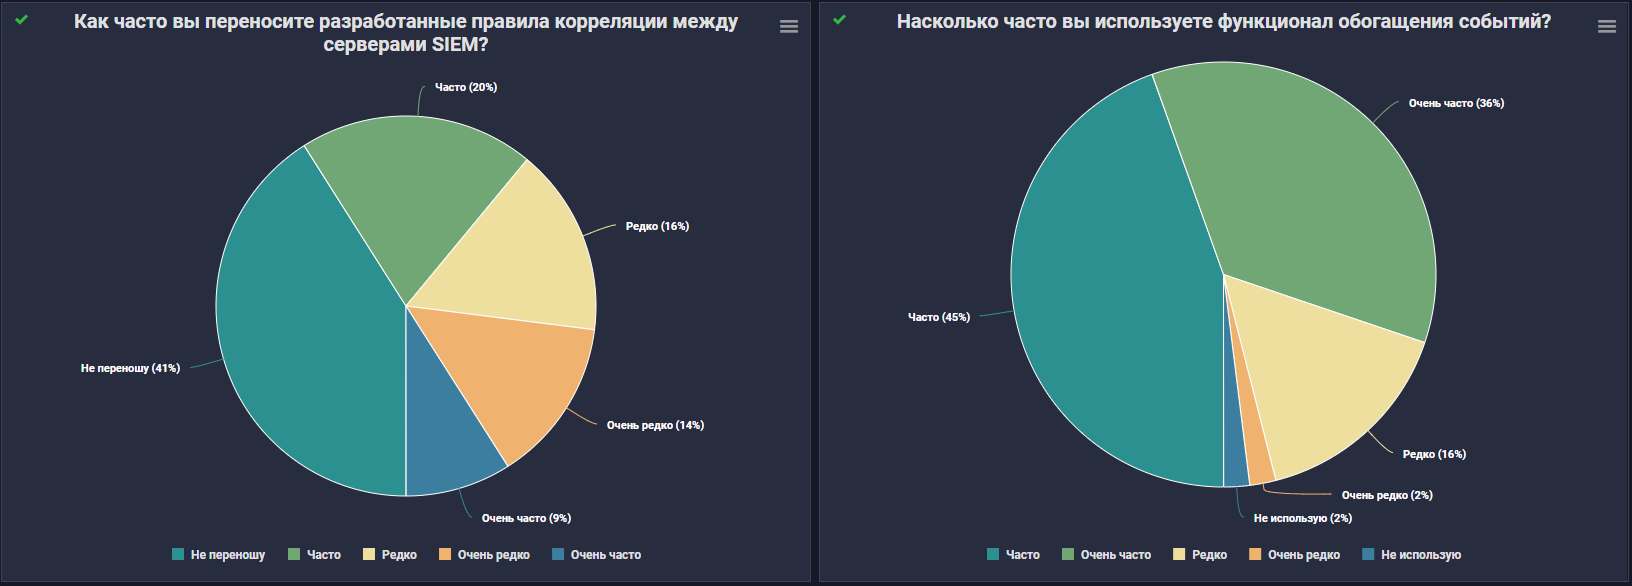
В опросе было еще несколько пунктов, которые я решил вынести за скобки, например, вопрос: Как часто вы переносите разработанные правила корреляции между серверами SIEM? Чуть больше половины так или иначе сталкивается с такой необходимостью. При этом 41% не занимается переносом вовсе.
Выше я упомянул про закономерную и понятную «боль» с источниками, а вот трудности из-за отсутствия возможности помодульного обновления SIEM для меня стали неожиданностью. Еще большее удивление вызвал высокий результат «невозможности скейлиться» с учетом повального ухода в «куберы». При этом боль, связанная с моделью данных, не вошла даже в топ-3.

Кстати, о моделях данных. Доминирующего мнения получить так и не удалось. Первые дни опроса уверенно лидировал подход единой датамодели (CEF и ей подобные), позже вперед вырвалась кастомная дата модель. Выражая свое сугубо личное мнение, скажу, что связаны такие качели в первую очередь с эксплуатационным опытом. Конечно же укладывать всё в единую модель гораздо лучше точки зрения разработки, переносимости и далее по списку. Но на другой чаше весов находится расширяющийся набор источников и задач, которые не всегда могут вписаться в единую модель. Да и в перспективе возможность кастомизации несет больше плюсов, чем минусов.
Вместо заключения
Надеюсь, эта статья помогла и вам ответить на вопрос «Так где же правда?» в этом споре маркетинга и «полей». Задавайте вопросы, пишите комментарии (((=
Напоследок расскажу про само проведение опроса.
Его я проводил своими силами прося коллег «по цеху» распространить дальше. Бывали ситуации, что распространителей опроса, едва ли не «на вилы поднимали» за инициативу, объявляя ведьмой и несли на костер. Но в основном, сообщество весьма живо откликнулось, в какой-то момент опрос уже «отвязался» от меня лично и разлетелся по профильным чатам.
Всем участникам и распространителям ОГРОМАДНЕЙШЕЕ СПАСИБО!
Вот вам котик

UPD
Статью перенес в корп блог
ссылка на оригинал статьи https://habr.com/ru/articles/757628/
Добавить комментарий