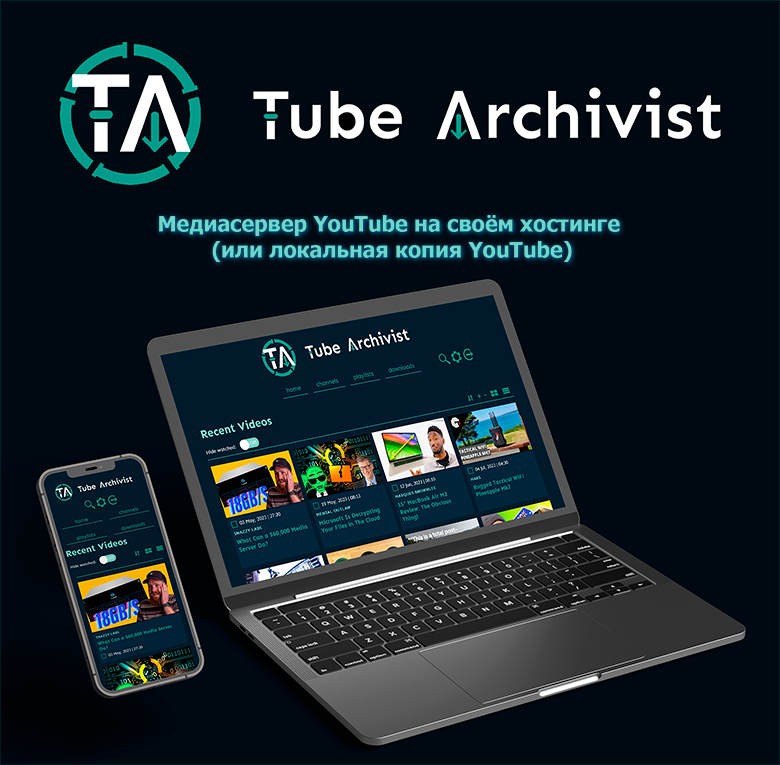
Мы уже обсуждали, как удобнее всего скачивать видео с YouTube для дальнейшего просмотра и хранения. Но если коллекция файлов становится слишком большой, то нужно их как-то организовать: по темам или тегам, по каналам, категориям, чтобы быстро найти нужный видеоролик. И желательно настроить сервер так, чтобы раздавать это видео по локальной сети или через интернет.
В итоге получается, что мы делаем нечто вроде маленькой копии YouTube, только на своём сервере. В определённом смысле это архивная копия на случай удаления видеоконтента из-за цензуры YouTube. Или на случай, если серверы YouTube станут недоступны с территории РФ из-за какого-то «технического сбоя».
Зачем это нужно
Во-первых, YouTube обильно заполнен различными трекерами и скриптами для отслеживания каждого вашего нажатия. Всё это регистрируется и сохраняется в профиль, которым Google делится с рекламодателями (точно так же отслеживаются все действия в браузере Chrome). Например, вы один раз в жизни посмотрели что-то неприглядное — и это навсегда сохранится, вам будут периодически показывать рекламу на эту тему и подсовывать видео в рекомендациях.
Во-вторых, найти что-то на YouTube труднее, чем иголку в стоге сена, потому что поиск там очень плохо реализован. Лучше самостоятельно разложить всё по полочкам и сделать нормальный полнотекстовый поиск по метаданным в собственном хранилище.
Таким образом, гораздо проще оказывается скачать всё, что нужно, с помощью yt-dlp — и работать с видеоархивом локально, в домашнем архиве. Однако со временем коллекция разрастается и становится трудно отслеживать, что просмотрено, что вышло свежего, и найти нужные видеозаписи.
Tube Archivist
Как раз для создания домашнего архива из видеороликов YouTube создана программа Tube Archivist (на базе yt-dlp).
Базовая функциональность:
- подписка на любые каналы YouTube;
- скачивание видеофайлов;
- индексация метаданных и поиск по ним;
- воспроизведение видео;
- отслеживание, какие видеофайлы в подписке вы просмотрели, а какие нет.
Минимальные системные требования — двухъядерный CPU (четыре потока), 2 ГБ оперативной памяти (для тестирования) или 4 ГБ (для работы).
В реальности чем больше памяти в системе, тем лучше, потому что для Tube Archivist (TA) обязательно требуется Docker. Сама программа разбита на три основных компонента в разных контейнерах. Соответственно, установка софта сводится по большей мере к редактированию файла docker-compose.yml:
version: '3.3' services: tubearchivist: container_name: tubearchivist restart: unless-stopped image: bbilly1/tubearchivist ports: - 8000:8000 volumes: - media:/youtube - cache:/cache environment: - ES_URL=http://archivist-es:9200 # needs protocol e.g. http and port - REDIS_HOST=archivist-redis # don't add protocol - HOST_UID=1000 - HOST_GID=1000 - TA_HOST=tubearchivist.local # set your host name - TA_USERNAME=tubearchivist # your initial TA credentials - TA_PASSWORD=verysecret # your initial TA credentials - ELASTIC_PASSWORD=verysecret # set password for Elasticsearch - TZ=America/New_York # set your time zone depends_on: - archivist-es - archivist-redis archivist-redis: image: redis/redis-stack-server container_name: archivist-redis restart: unless-stopped expose: - "6379" volumes: - redis:/data depends_on: - archivist-es archivist-es: image: bbilly1/tubearchivist-es # only for amd64, or use official es 8.9.0 container_name: archivist-es restart: unless-stopped environment: - "ELASTIC_PASSWORD=verysecret" # matching Elasticsearch password - "ES_JAVA_OPTS=-Xms512m -Xmx512m" - "xpack.security.enabled=true" - "discovery.type=single-node" - "path.repo=/usr/share/elasticsearch/data/snapshot" ulimits: memlock: soft: -1 hard: -1 volumes: - es:/usr/share/elasticsearch/data # check for permission error when using bind mount, see readme expose: - "9200" volumes: media: cache: redis: es:Здесь всего шесть обязательных полей:
TA_HOST— IP-адрес или имя хоста сервера;TA_USERNAME— первоначальное имя пользователя для авторизации в Tube Archivist;TA_PASSWORD— первоначальный пароль для авторизации в Tube Archivist;ELASTIC_PASSWORD— пароль к ElasticSearch;REDIS_HOST— имя хоста для Redis;TZ— часовой пояс для шедулера.
Всё остальное опционально.
Более детальные инструкции по установке на Unraid, Synology, Podman и True NAS см. в документации проекта.
Презентация:
▍ Расширение для браузера
Для удобного взаимодействия с сервером, а также скачивания видео с YouTube разработано расширение Tube Archivist Companion:
Расширение добавляет в интерфейс YouTube несколько управляющих элементов для скачивания видео в одно нажатие кнопки, а также для подписки на канал внутри TA.


Для работы расширения требуется инстанс с последней версией TA, потому что API подвержен изменениям.
▍ Импорт метаданных c YouTube
Кроме самого видеофайла, TA скачивает с YouTube метаданные для него. Они сохраняются локально и индексируются для быстрого полнотекстового поиска.
Кроме того, по метаданным можно организовать/сортировать свою коллекцию.
Вся работа организована через веб-интерфейс, а доступ к хранилищу возможен с удалённого компьютера через браузер. Таким образом можно посмотреть любое видео со своего сервера или предоставить ссылку для просмотра родственникам и друзьям.
Другие медиасерверы
В каком-то смысле функциональность TA пересекается с функциональностью стандартных медиасерверов, таких как Plex, Jellyfin, Kodi (XBMC) и др. В принципе, их можно использовать в связке друг с другом: TA — для скачивания видео, организации коллекции и полнотекстового поиска по ней, а Plex или другой медиасервер — непосредственно для видеотрансляции.

Kodi
Как вариант, вся коллекция ютубовских видео хранится в коллекции TA, а другой медиасервер отвечает за весь остальной контент из других источников (с торрентов, Netflix и других видеосервисов, откуда вы копируете и сохраняете видео). В этом есть определённый смысл, потому что в «локальный YouTube» тематически отличается от видеоколлекции с кинофильмами.
«Локальный YouTube» — это передачи, документальные видео и домашние видео, записанные на телефон, видеорегистратор, хедкам и др. С другой стороны, функциональный видеосервер — это в основном кинофильмы в высоком разрешении. Там уже есть функции, которые отсутствуют в TA, в том числе настройки транскодирования и битрейта, уровень допустимой нагрузки на CPU и др.
Но вообще лучше всего установить плагин Tube Archivist для интеграции с Plex. В этом случае сканер и агент Tube Archivist работают вместе с Plex, распознают все видео, включая метаданные, и добавляют их в библиотеку Plex для просмотра и трансляции стандартным способом (TA должен быть запущен во время сканирования файловой системы и обновления метаданных).
Разработчик подчёркивает, что в данный момент возможна интеграция Plex только с одним инстансом TA, поддержку нескольких библиотек добавят в будущую версию плагина, также как поддержку плейлистов.
Кроме Plex, разработана также интеграция с Jellyfin.

Папка Tube Archivist после импорта в Jellyfin
Каждый канал YouTube импортируется как сериал, а каждый год архива — как сезон сериала. Из TA импортируются названия, описания и дата видео, название и описание канала.
Примечание. Скачанный с YouTube контент хранится в папке Docker. Эта папка может вырасти до очень большого размера, потому что TA скачивает всё содержимое каналов, так что к этому следует быть готовым, то есть подготовить хранилище соответствующего размера. В реальности TA не очень приспособлен для работы на среднем ПК, это инструмент для серьёзного архивирования контента — десятки и сотни терабайт видео. Скорее можно представить, что какой-то провайдер устанавливает его на своих серверах, чтобы обеспечить «зеркало» YouTube для своих абонентов, которым недоступен оригинальный YouTube.
В частном использовании, скорее всего, для работы с TA понадобится полноценный NAS с несколькими большими HDD. Так что это не обычный плеер типа Plex, а более серьёзная штука. Стоит добавить, что Tube Archivist использует поисковый движок ElasticSearch, а его индекс автоматически закрывается от записи в read only, если занятое место на диске достигает показателя 95% (статус read only сохраняется до тех пор, пока уровень не опустится до 90%). В целом, при сильном заполнении диска TA выдаёт много разных ошибок.
Просто yt-dlp
В большинстве случаев можно заменить Tube Archivist на обычный yt-dlp. Написать простой баш-скрипт для проверки обновлений по списку каналов со скачиванием новых видеороликов, которые добавляются в библиотеку Plex или Jellyfin. Вот пример такого скрипта для скачивания пяти последних видеороликов по списку каналов. Чтобы узнать RSS какого-то канала YouTube, нужно вставить URL этого канала в RSS-ридер, потом адрес RSS добавляем в скрипт для скачивания.
#!/usr/bin/env bash if [ ! -f "/input/feeds.txt" ] then >&2 echo "Failed to open file /input/feeds.txt. Exiting." exit 1 fi if [ ! -d "/output" ] then >&2 echo "Failed to switch to directory /output. Exiting." exit 1 fi cd /output grep "^[^#;]" /input/feeds.txt | while read feed do echo "[ytdl-pvr] Downloading feed: $feed" # Grab the RSS feed from YouTube, grab the recent video URLs, and use yt-dlp to download the video # The following arguments are used to download 1080p H.264 videos with AAC audio, # such that they can be natively played on devices released within the last 10 years while still having # good quality: # --format, --remux-video, --merge-output-video # The following arguments are used to write thumbnail and metadata to be compatible with Jellyfin. # --write-thumbnail, --convert-thumbnails, --embed-thumbnail, --embed-metadata, --embed-subs # To help Jellyfin sorting videos by release date, --no-mtime is set to prevent e.g. edits to # video comments from making a video seem to be released more recently # To prevent the script failing when feeds include a future video, --datebefore now is set curl --fail-with-body -L -s "$feed" | xq -r '.feed.entry[0:5] | .[].link."@href"' | yt-dlp \ --batch-file - \ --output="%(channel)s/%(upload_date)s %(title)s [%(id)s].%(ext)s" \ --download-archive .ytdl-pvr-archive.txt \ --continue \ --no-progress \ --format 'bestvideo[vcodec^=avc1]+bestaudio[acodec^=mp4a]' \ --remux-video "mp4" \ --merge-output-format "mp4" \ --no-mtime \ --no-cache-dir \ --write-thumbnail \ --convert-thumbnails jpg \ --embed-thumbnail \ --embed-metadata \ --embed-subs \ --sub-lang en,en.* \ --datebefore now # Continue processing in case of a processing error continue done Здесь yt-dlp скачивает видеоролики в формате 1080p H.264, так что они не займут много места. Хотя в TA тоже можно выбрать формат видео по умолчанию, например, bestvideo[vcodec*=avc1]+bestaudio[acodec*=mp4a]/mp4.
Как известно, yt-dlp тоже умеет копировать метаданные. В приведённом скрипте опция --download-archive .ytdl-pvr-archive.txt проверяет список сохранённых файлов, чтобы не скачивать их повторно. Можно ещё запустить дополнительный скрипт, который будет удалять старые видеоролики, например, возрастом более месяца. Так можно автоматизировать просмотр YouTube в офлайне на обычном ПК без тяжеловесных инструментов архивирования вроде TA.
См. также докер-контейнер ytdl-sub для автоматического скачивания видео и добавления его в Plex/Jellyfin/Kodi (примерно такой же скрипт, как выше, только в контейнере).
После настройки файлов конфигурации config.yaml и subscriptions.yaml процесс запускается простой командой:
ytdl-sub sub subscriptions.yamlКонтейнеры одинаково запускаются в любой ОС, где работает Docker (Linux, RPi, Win, Mac, etc).
Telegram-канал с розыгрышами призов, новостями IT и постами о ретроиграх ?️

ссылка на оригинал статьи https://habr.com/ru/articles/760716/
Добавить комментарий