
Всем привет! Данная статья написана, чтобы помочь рядовым пользователям правильно использовать ChatGPT. В ней раскрываются тонкости устройства больших языковых моделей. А если вы разбираетесь в том, как всё работает, то не тратьте время и листайте ленту дальше!
Написал я эту статью потому, что сам делал ошибки и не понимал, что не так, получая неудовлетворительный результат. Главным образом, я хочу рассказать, что такое размер контекста, на что он влияет и как с этим жить.
Что такое ChatGPT?
Постараюсь ответить кратко:
GPT — Generative Pre-trained Transformer, являющийся большой лингвистической моделью.
Chat — означает, что модель затюнили для работы в виде общения диалогом.
Получается, что ChatGPT — это большая лингвистическая модель на базе архитектуры трансформера, натренированная для общения в формате диалога.
Трансформер – это современная архитектура нейронной сети, специально разработанная для обработки последовательностей данных, таких как текст. Она использует механизм внимания, позволяя сети «сосредотачиваться» на разных частях данных в зависимости от контекста. Это делает трансформер особенно эффективным для таких задач, как перевод текста или генерация контента. В отличие от предыдущих подходов, трансформер может одновременно рассматривать всю последовательность данных, а не пошагово, что делает его быстрым и точным.
Версий GPT несколько, отличаются они техническими характеристиками, а архитектура трансформера позволяет легко масштабировать сетку.
Одни из самых важных характеристик – это размер модели и длина входной последовательности.
Размер модели: Определяется количеством нейронов или «параметров». Большие модели обычно могут захватить больше информации, но требуют больше ресурсов для обучения и инференции. Если очень грубо, то можно провести аналогию между количеством параметров ИНС и количеством синнапсов в мозге человека.
В открытых источниках я нашел следующие цифры, характеризующие разные модели GPT:
GPT-1 — 117 млн параметров
GPT-2 — 1,5 млрд. параметров
GPT-3 — 175 млрд. параметров
GPT-3.5 — 355 млрд. параметров
GPT-4 — 1.7 трлн. параметров
Для сравнения: человеческий мозг — 100 трлн. параметров.
Сравнивать мозг и нейронку только по одной характеристике не очень-то корректно, но это так, просто интересно 😉
Но это ещё не всё. Помимо связей есть ещё очень важная характеристика — это размер входных данных, он же контекст. Контекст — это такая штука, в которую мы можем поместить некие данные, на которых нейронку не обучали, а после задать вопрос. И сетка моментально «дообучится» на этих данных и правильно (будем надеяться) ответит на вопрос. Такой процесс называется Few (или Zero) Shot Learning — это свойство, позволяющее мгновенно обучаться на примерах, оно характерно для больших лингвистических моделей, обученных на огромных объёмах данных. Так вот, чем больше контекст, тем удобнее нам общаться с нейронкой, тем дольше она помнит историю нашего общения.
Длина последовательности связана с памятью и вычислительными ресурсами. Обработка очень длинных последовательностей требует больше памяти.
В стандартной архитектуре трансформера, каждый элемент последовательности «видит» каждый другой элемент, что приводит к квадратичному росту вычислительных требований по мере увеличения длины последовательности.
Описание проблемы
Зная, что ChatGPT помнит, о чём мы говорили в рамках активной сессии, я безуспешно пытаюсь добиться от него правильного ответа.
Размер контекста меняется от версии к версии, и даже у одной версии могут быть различные размеры входных данных. На примере текущей GPT-4 давайте считать, что размер контекста равен 4000 токенам.
Что такое токен? Для простоты понимания: токен — это слово или часть слова, которая обычно часто встречается в естественном языке. Например, короткие слова — это скорее всего токены целиком: «кот», «дом», «пальто». Если в слове присутствуют приставки, суффиксы и окончания, то скорее всего они будут разбиты на отдельные токены: стат-ь-я, при-влек-а-тельн-ый (но это не точно!).
Отсюда можно сделать вывод, что максимально нейронка «помнит» 4 тысячи коротких слов, а в реальности это будет порядка одной тысячи среднестатистических слов. Я сильно упрощаю, потому что число токенов может сильно варьироваться в зависимости от конкретного текста, используемого языка и, конечно, от токенайзера.
Работа ChatGPT организована следующим образом:
Когда вы задаёте вопрос чату, он добавляется в лог разговора, а когда сетка отвечает, в лог также добавляется её ответ. Потом ещё один ваш вопрос, ещё ответ и так далее. Лог содержит всю вашу переписку, и каждый раз на сервер отправляется вся история вашего диалога.

И тут я, такой простой, зная, что весь наш разговор при каждом новом сообщении отправляется на сервер, а значит, и уходит в нейронку, начинаю писать чату кучу правил и вводных данных. А потом задаю вопрос, и он мне не может правильно ответить.
Пример: мне надо задокументировать методы в контроллерах и поля в DTO-шках. У меня есть правила документации. Я отправляю чату правила, а потом прошу его сделать работу и отправляю программный код.
В итоге я имею отличное описание контроллеров и DTO-шек, но почему-то не все правила соблюдены.
Как вы уже догадались, виной этому служит ограничение размера контекста. Безусловно, на сервер уходит всё: и правила, и код. Но при обработке входных данных нейронкой учитываются только последние 4000 токенов. И это может быть только небольшой последний кусок правил. Если отправленный код был размером близким к 4000 токенам, то правила могут не учитываться вовсе. А при отправке следующего контроллера сетка забудет, что вообще были какие-то правила.

Раньше я заблуждался. Я знал о том, что вся история хранится и отправляется сетке. И я считал, что размер входных данных (размер контекста) ограничивает только один текущий запрос. Но, как оказалось, наш электронный друг имеет очень короткую память, аки гуппи. И несмотря на то, что каждый раз сетке уходит вся наша переписка, учитывается только та её часть, которая помещается в контекст, с конца. Начало обрезается.
Как с этим жить?
Вот несколько правил, которые помогут вам правильно и эффективно общаться с ChatGPT:
-
Краткость — сестра таланта. Старайтесь формулировать вопросы чётко и без лишних деталей. Лучше всего описывать задачу в рамках одного запроса.
-
Избегайте фраз, таких как “продолжи” или “давай ещё”. Они работают корректно только когда ваш диалог короче размера контекста.
-
Помните: при вашем следующем запросе в нейронную сеть отправляется не только ваш последний вопрос, но и ответ на него. Если ответ слишком длинный, есть вероятность, что сеть забудет ваш первоначальный запрос. Просите чат отвечать максимально кратко! Это также поможет сохранить контекст для будущих запросов.
-
Если для ответа на вопрос вам нужно проанализировать большой объём данных, разбейте его на части и делайте выдержки из каждой из них. Например, можно просить: “Напиши краткое содержание этой статьи, сохраняя основной смысл”. После этого соедините полученные выдержки в одно целое, чтобы получить сжатое изложение.
-
При работе с кодом отправляйте его текущую версию при каждом новом запросе. Это уменьшит количество ошибок в ответах чата.
-
Попробуйте другие модели. Как пример, недавно Мета выкатила в открытый доступ свою модель Llama2, затюненую на помощь в написании кода. Так вот, на вход она принимает до 100к токенов. Не плохо, да? Да и развернуть эту модель можно локально, тем самым получив бенефит в виде приватности.
-
Одно из самых эффективных правил — если вы можете использовать английский язык, то используйте его. Вот наглядный пример, насколько меньше токенов в английской версии одной и той же фразы:
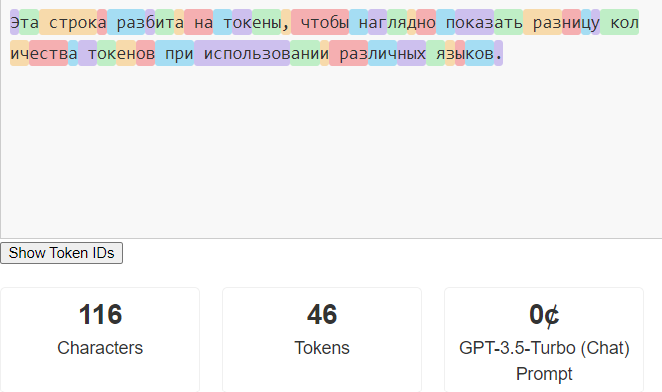
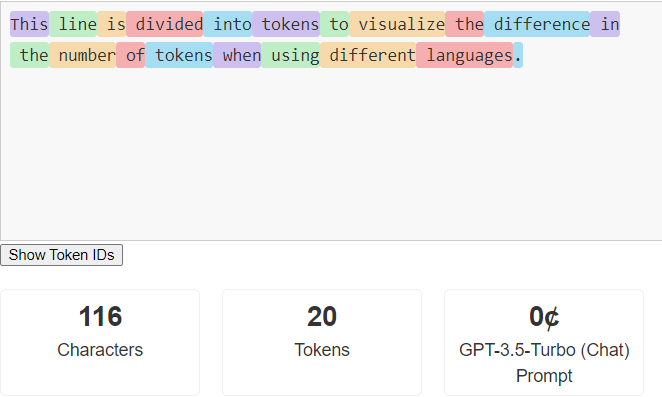
Даже на таком простом примере понятно, что используя английский, мы имеем выигрыш в контексте примерно в два раза.
Заключение
Надеюсь, мой опыт поможет кому-то лучше понять, как работает ChatGPT и его друзья. Я сам когда-то столкнулся с этими трудностями, и мне было бы полезно знать об этом заранее. Просто следуйте правилам и сможете намного эффективнее использовать возможности лингвистических моделей.
Если говорить о проблеме в целом, то я оптимист и считаю, что нам стоит немного подождать. Сейчас мы можем использовать до 4000 токенов. В корпоративной версии OpenAI обещают увеличить это число до 8000 токенов. К тому же на странице с ценами на использование API указано, что будут доступны модели с 32К токенов. Вспомним, что всего несколько лет назад GPT-1 была ограничена 500 токенами, и это тогда казалось впечатляющим.
И еще… вы когда-нибудь думали о том, насколько быстро развиваются технологии? Сегодня у нас есть искусственный интеллект, который может общаться почти как человек. Интересно, как далеко мы зайдем в этом направлении? Может, когда-нибудь искусственный интеллект будет способен не только разговаривать, но и чувствовать, и…
А пока что держите в голове – это всего лишь машина, и иногда ей нужна наша помощь, чтобы понять, что мы от неё хотим.
ссылка на оригинал статьи https://habr.com/ru/articles/760974/
Добавить комментарий