В предыдущих постах про рерайтер и суммаризатор мы рассказывали о том, как решали некоторые популярные генеративные задачи с помощью отдельных моделей, и какие возможности дают сервисы на их основе. Однако технологии не стоят на месте. Недавно доступ в GigaChat стал открытым для всех. В этом посте мы решили исследовать его способности и рассказать вам, как GigaChat справляется с рядом задач в сравнении со «старыми» подходами, ответив на вопросы:
— Может ли модель переписать текст, сохранив его смысл?
— Насколько хорошо GigaChat суммаризирует тексты?
— Умеет ли он стилизовать текст, упрощать, или, например, заменять англицизмы?
Спойлер: оказалось, что GigaChat в формате zero-shot часто обходит классические подходы, использующиеся в наших исходных сервисах, генерируя качественные, осмысленные и грамматически корректные тексты. Так что, кажется, есть все основания полагать, что очень скоро мы все перейдём на GigaChat 😉
Как использовать GigaChat?
В предыдущих сериях наши команды выложили в открытый доступ претрейн-модель, лежащую в основе GigaChat. На её основе можно обучить различные адаптеры на ваших специализированных данных (например, LoRA) или сделать дообучение (файнтюнинг) на инструктивном сете, если у вас есть мощности и большое количество данных. Мы проанализировали возможности такой конфигурации (претрейн + LoRA) на разных генеративных задачах, а также протестировали GigaChat (чекпоинт версии v.1.17.0, то есть обученную на инструкциях SFT-версию модели) в zero-/few-shot сеттинге. Данные подходы мы сравнили с ChatGPT, а также с предложенными ранее «более классическими» решениями этих задач. Но сперва давайте поговорим про тестируемые задачи, сеты и метрики.
На каких задачах тестируем?
Парафраз текста
Одна из самых традиционных seq2seq задач — парафраз или рерайт текста, когда мы хотим переписать текст другими словами, сохранив его смысл. Для этих целей мы уже разрабатывали генеративный прототип рерайтера на основе ruT5-large, который решает задачи рерайтинга на уровне как текста целиком, так и отдельного предложения. Сеты обучения и теста мы взяли для корректного сравнения такие же, как в посте: около 7000 обучающих примеров и золотой тест — данные из различных доменов. В качестве автоматических метрик для обучения используем классические CHRF++, BLEU, Rouge-L, BERTScore, LaBSE.
Суммаризация текста
В посте про суммаризатор год назад мы рассказывали, как решали одну из самых востребованных генеративных задач с помощью разных классических моделей (ruT5, mBART, ruGPT). Тогда по разным метрикам мы выбрали модель ruT5-large и на основе неё сделали сервис с API для разработчиков. Сейчас для экспериментов с адаптером мы использовали два вида данных: 1) инструкции с разными текстовыми затравками (промптами) (≈12 тысяч примеров), 2) датасет ПРО-версии суммаризатора, описанный в предыдущих сериях (≈4 тысячи чистых примеров из разных доменов). Для корректного сравнения с предыдущими нашими прототипами в экспериментах ниже использовался аналогичный тестовый сет.
Стилевой трансфер
Перефразирование англицизмов
Замена англицизмов в текстах — актуальная задача на сегодняшний день. В данном случае речь идёт о практическом кейсе обработки текста, посвящённого специфической теме и переполненного англицизмами, которые затрудняют его понимание. Например, когда мы пытаемся объяснить далеким от IT родственникам, что «радуемся, что выбили СОТу на лидерборде и закрыли тем самым таску за три дня до конца спринта» =)
Здесь не рассматривается использование общепринятых заимствованных слов типа «компьютер»,«термометр» и т. д.
Для оценки этой задачи мы взяли новый датасет Англицизмов, который содержит 1007 + 77 (обучение + тест) примеров с современными англицизмами.
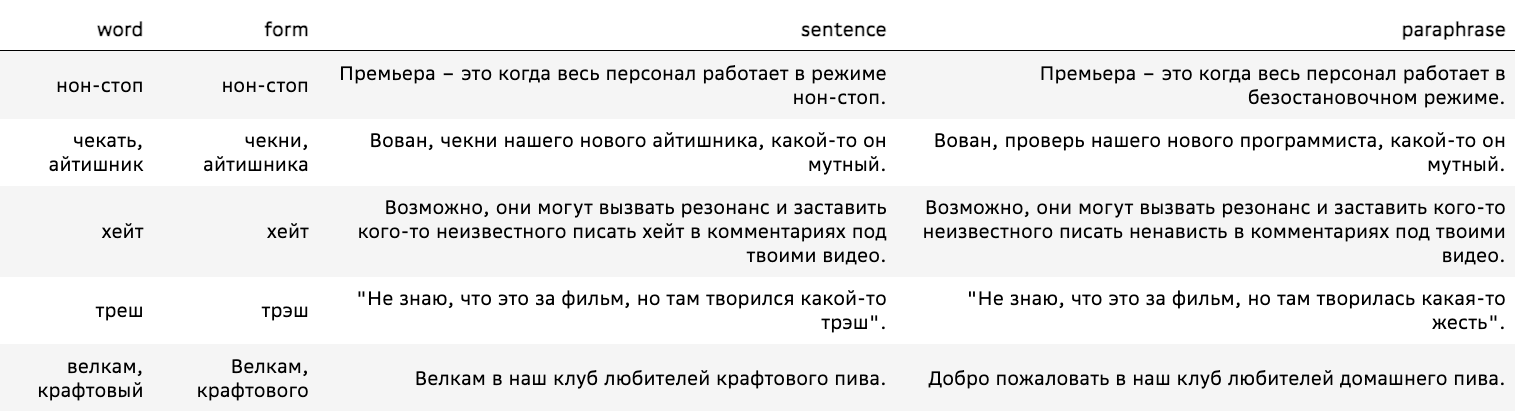
В данном случае задача — переписать текст без использования англицизмов с сохранением исходного смысла.
Замечание: безусловно, при замене англицизма мы можем потерять некоторый оттенок смысла, который ни один его синоним или синонимическая группа слов не сможет передать. Речь идёт о сохранении общего смысла предложения и отсутствии искажения фактов.
Основные метрики качества использовались те же, что и для задачи парафраза. Дополнительно мы считали success_em — долю предложений, в которых были заменены все англицизмы (если в предложении 2 англицизма, считается только полная замена обоих), — и success_elimination_perc — долю удаленных англицизмов.
Задача симплификации
Как отдельный подтип задачи переноса стиля можно также выделить упрощение/усложнение текстов. Задача симплификации — упрощение текста с сохранением смысла — широко известна и в сообществе была представлена на конференции Диалог. На проведенном в ее рамках соревновании были представлены бейзлайны и стандартные датасеты, которыми мы и воспользовались при сравнении с GigaChat, соревнуясь по метрике SARI.
Эксперименты. Что в результате получилось?
Zero-shot
На текущий момент у большинства пользователей уже появился GigaChat. Проще всего использовать его в формате zero-shot, подавая на вход промпт с заданием. Мы провели внутреннее тестирование этой модели (версия v.1.17.0) на задачах, описанных выше, в zero-shot с различными промптами. Ниже выходы генерации, а числовые метрики будут дальше в таблицах.
Примеры для замены англицизмов:
промпт «Перепиши этот текст без англицизмов»
Задачи, которые повторяются постоянно и не требуют креатива, должны выполняться чётко в соответствии с определёнными правилами.
⇒ Задачи, которые возникают постоянно и не требуют творческого подхода, должны выполняться согласно определенным правилам.
Для частного детектива смена имиджа до неузнаваемости – это порой половина успеха в расследовании.
⇒ Для частного детектива изменение внешности до неузнаваемости — это зачастую половина успеха в расследовании.
Примеры для задачи рерайтинга:
промпт «Перепиши текст»
На выставке представлены работы фотографов из Японии, Франции, Италии, ЮАР, США, Грузии и России.
⇒ На выставке можно увидеть фотографии, созданные фотографами из разных стран мира, включая Японию, Францию, Италию, Южную Африку, США, Грузию и Россию.
Вероятно, число не выживших в землетрясении на Гаити составит несколько тысяч человек, а всего от стихии пострадали десятки тысяч, информирует РИА Новости. Предположительные оценки результатов разгула стихии поступили от Геологической службы США (USGS).
⇒ По предварительной оценке Геологической службы США (USGS), количество погибших в результате землетрясения на Гаити может составить несколько тысяч человек, а всего от стихии пострадали десятки тысяч людей.
Пример для упрощения текста:
промпт: «Упрости текст»14 апреля 2003 году архиепископом Новосибирским и Бердским Тихоном пострижен в монашество с наречением имени Феодор в честь праведного Феодора Томского.
⇒ 14 апреля 2003 года архиепископ Новосибирский и Бердский Тихон принял постриг в монахи с именем Феодор в честь святого Феодора Томского.
Пример суммаризации небольшого текста:
промпт «Сократи текст до одного предложения»
Так вот, запись этой песни и голос Веги были настолько чистыми, что их использовали для усовершенствования алгоритма сжатия MP3. Один из разработчиков формата MP3 брал эту песню для тестирования своего алгоритма, слушая ее снова и снова, и все лучше настраивал алгоритм для более точной передачи голоса Веги. Можно даже сказать, что в некоторой степени алгоритм MP3 специально настроен на песню «Tom»s Diner»
⇒ Запись этой песни и голос Веги использовались для улучшения алгоритма сжатия MP3.
GigaChat очень неплохо справляется с задачами, особенно перефразирования и изменения стиля. Однако было замечено, что качество сильно зависит от поданной на вход инструкции (как и у большинства генеративных моделей). Это может быть и преимуществом: GigaChat не требует дообучения и может сократить текст до любого объёма в зависимости от содержания промпта. Ещё одной проблемой таких моделей является склонность к повторению, избежать этого можно либо настройкой штрафов на инференсе, либо подбором правильного промпта. Отсюда ключевой совет пользователям: с промптом нужно плотно работать, от него существенно зависит качество решения задачи.
LoRA
Не у всех есть возможность собрать сложный инструктивный сет и, тем более, обучить на большом объёме данных модель. Но и большой необходимости в этом нет, можно взять открытый претрейн ruGPT-3.5-13B и дообучить на своих данных один или несколько легковесных адаптеров (почитать про различные варианты адаптеров и их сравнение можно, например, в статье). Мы экспериментировали с наиболее популярным адаптером LoRA в связке с библиотекой PEFT для загрузки, квантизации и обучения модели.
Под описанные задачи мы подбирали параметры обучения адаптера, ранги, и слои, определяли степень влияния на них разных объёмов данных.
Таблица ниже показывает зависимость качества решения задачи переписывания англицизмов при фиксированном наборе слоев для разных рангов разложения в LoRA (в библиотеке PEFT, параметр r в документации PEFT):
|
rank |
success |
success |
labse |
rouge-l |
BLEU |
bertscore |
chrf++ |
|
16 |
0.40 |
0.44 |
0.97 |
91.98 |
84.24 |
0.97 |
91.15 |
|
8 |
0.40 |
0.44 |
0.97 |
91.57 |
83.40 |
0.97 |
90.78 |
|
4 |
0.40 |
0.44 |
0.97 |
91.21 |
83.19 |
0.97 |
90.73 |
|
2 |
0.42 |
0.46 |
0.97 |
91.51 |
83.33 |
0.97 |
90.85 |
|
GigaChat |
0.22 |
0.23 |
0.84 |
73.93 |
68.86 |
0.90 |
76.63 |
Результаты сходятся с оценками, которые представили авторы датасета Англицизмов. Заметно, что GigaChat более склонен к переписыванию входа, тогда как обученная нами LoRA вне зависимости от используемого ранга старается сохранить содержимое текста.
В задаче симплификации мы также попробовали оценить влияние рангов:
|
rank |
dataset |
SARI |
bertscore |
|
16 |
public |
42.71 |
0.981 |
|
16 |
private |
42.22 |
0.979 |
|
4 |
public |
42.69 |
0.98 |
|
4 |
private |
42.17 |
0.98 |
|
GigaChat (zero-shot) |
public |
42.45 |
0.80 |
|
GigaChat (zero-shot) |
private |
42.48 |
0.80 |
Несмотря на то, что в этой задаче значительно больше обучающих данных, чем в экспериментах выше, влияние выбора ранга остаётся небольшим. При этом zero-shot на чекпоинте GigaChat показывает результаты лучше и по метрикам, и по визуальной оценке примеров.
Для рерайтинга мы в дополнение к рангу разложения оценили влияние выбора раскладываемых матриц в блоках self-attention (в PEFT можно указать в параметре target_modules, подробнее в документации):
-
r=8, LoRA_alpha=32, LoRA_dropout=0.1, target_modules=['c_attn', ‘c_proj’, ‘c_fc’] -
r=32, LoRA_alpha=64, LoRA_dropout=0.1, target_modules=['c_attn']
|
|
chrf++ |
bleu |
rouge-l |
labse |
bertscore |
|
LoRA_1 |
36.2 |
2.4 |
24 |
83 |
78 |
|
LoRA_2 |
34.2 |
2.3 |
23 |
81 |
77 |
|
GigaChat |
40.4 |
11.3 |
29 |
84 |
78 |
Мы перепробовали множество комбинаций, лучше всего получается, когда обучающих параметров 0.20%.
Задача суммаризации самая сложная из перечисленных, количество данных при этом небольшое. Поверх претрейна мы дообучили на двух сетах данных LoRA адаптеры.
обучение на данных суммаризатора ПРО
|
rouge-1 |
rouge-2 |
rouge-l |
bertscore |
meteor |
labsescore |
chrf++ |
|
0.122499 |
0.007525 |
0.111596 |
0.679537 |
0.144014 |
0.658467 |
23.507288 |
обучение на инструктивных данных
|
rouge-1 |
rouge-2 |
rouge-l |
bertscore |
meteor |
labsescore |
chrf++ |
|
0.079839 |
0.003796 |
0.075093 |
0.652626 |
0.090881 |
0.552206 |
18.094983 |
Для данной задачи оптимальное число параметров обучения варьировалось в пределах 0,14–0,29%. По метрикам видно, что выигрывает адаптер, обученный без инструкций на чистых данных суммаризатора ПРО.
Выводы по LoRA:
— В зависимости от задачи и объёма данных нужно подбирать ранг и число обучаемых параметров. Для небольшого количества примеров и простых задач ранг не сильно влияет, однако с ростом размера обучающего датасета (>5000), ранг лучше повышать. Для сопоставимого качества на конкретной задаче с SFT рекомендуется от 10000 примеров для LoRA.
— Если сравнить результаты GigaChat + LoRA c zero-shot SFT GigaChat, то адаптеры проигрывают, но для задач с небольшой вариативностью и строгим форматом заданий это неплохой вариант с минимум затрат на обучение.
Сравнение с другими моделями
Конечно, мы не могли пройти мимо ChatGPT и не сделать сравнительные замеры для моделей от OpenAI, а также для других открытых решений по каждой из задач.
Результаты суммаризации
|
model |
rouge-1 |
rouge-2 |
rouge-l |
bertscore |
meteor |
labsescore |
chrf++ |
|
0.171 |
0.039 |
0.152 |
0.688 |
0.139 |
0.632 |
21.822 |
|
|
cointegrated/rut5-base-absum |
0.101 |
0.022 |
0.093 |
0.668 |
0.067 |
0.525 |
11.128 |
|
UrukHan/t5-russian-summarization |
0.094 |
0.011 |
0.085 |
0.611 |
0.067 |
0.467 |
11.299 |
|
csebuetnlp/mT5_multilingual_XLSum |
0.066 |
0.010 |
0.061 |
0.620 |
0.037 |
0.416 |
8.181 |
|
summarizer FREE |
0.163 |
0.030 |
0.150 |
0.694 |
0.154 |
0.650 |
24.174 |
|
summarizer PRO |
0.256 |
0.087 |
0.240 |
0.738 |
0.290 |
0.786 |
38.521 |
|
GigaChat (zero-shot) |
0.187 |
0.038 |
0.175 |
0.714 |
0.218 |
0.727 |
31.911 |
Мы автоматически оценили открытые бейзлайны и решения для русского языка.
Модели OpenAI, представленные в таблице ниже, справляются с задачей весьма неплохо. Но, как и в случае с GigaChat-ом, для хорошего результата нужно долго экспериментировать с инструкцией.
|
model |
rouge-1 |
rouge-2 |
rouge-l |
bertscore |
meteor |
labsescore |
chrf |
|
gpt_4 |
0.208 |
0.053 |
0.195 |
0.721 |
0.214 |
0.752 |
33.023 |
|
textdavinci003 |
0.204 |
0.050 |
0.193 |
0.721 |
0.215 |
0.748 |
32.913 |
|
gpt3turbo |
0.215 |
0.055 |
0.202 |
0.725 |
0.218 |
0.753 |
33.213 |
Результаты рерайтинга
|
модель/ |
chrf++ |
bleu |
rouge-l |
bertscore |
labse |
|
gpt_4 |
49.6 |
16.0 |
0.397 |
0.814 |
0.898 |
|
textdavinci003 |
49.9 |
15.2 |
0.385 |
0.815 |
0.897 |
|
gpt3turbo |
51.2 |
16.8 |
0.399 |
0.82 |
0.90 |
|
человек |
53.6 |
20.9 |
0.44 |
0.83 |
0.91 |
|
рерайтер про |
72.5 |
53.4 |
0.74 |
0.91 |
0.94 |
|
GigaChat |
40.4 |
11.3 |
0.29 |
0.84 |
0.78 |
Можно заметить по n-граммным метрикам, что ChatGPT генерирует примеры намного разнообразнее, чем базовое решение, при этом сохраняя смысл на высоком уровне, что очень близко к человеческим оценкам. По оценкам GigaChat заметно, что примеры ещё более разнообразны, часто он дописывает что-то ещё, смысл при этом очень близок к оригиналу.
Результаты англицизмов

Из результатов видно, что несмотря на чувствительность к промптам, ChatGPT и GPT-4 пока ещё лучше справляются с задачей переписывания англицизмов, однако это часто происходит за счет большего изменения предложения, о чём свидетельствуют более низкие значения нечетких метрик.
Результаты симплификации
Мы сравнялись с результатами моделей OpenAI, решений участников соревнования RuSimpleSentEval, классических подходов на основе дообучения модели ruT5-large и управляемой генерации текста с помощью алгоритма ParaGedi, представленными на конференции Диалог в этом году.
|
Модель |
SARI (public) |
SARI (private) |
|
Golden Test |
66,106 |
66,106 |
|
FT ruT5-large |
41,819 |
41,643 |
|
#1 RusimpleSentEval |
40,501 |
39,68 |
|
GigaChat (zero-shot) |
42,14 |
42,14 |
|
gpt3turbo |
42,38 |
43,34 |
|
gpt4 |
43,19 |
43,36 |
В случае задачи симплификации GigaChat хорошо работает в zero-shot, и сгенерированные им предложения по большей части действительно являются корректными упрощенными парафразами исходного предложения. Значение целевой метрики SARI превосходит значения top-3 результатов RuSimpleSentEval и результаты на основе рерайтера и GeDi.
В заключении
Мы протестировали GigaChat на разных генеративных задачах, и во всех экспериментах можно выделить общий тренд: GigaChat — это универсальный инструмент, который позволяет единообразно решать множество разных генеративных задач. Он работает на уровне, сравнимом с целевыми моделями, обученными решать одну проблему, а на простых задачах даже превосходит их. Решения, созданные на базе моделей предыдущего поколения становятся хорошим бейзлайном и стартовой точкой, если у вас меньше ресурсов и нет возможности использовать большие модели. Что касается LoRA, этот подход нужно использовать с умом, аккуратно подбирая гиперпараметры в зависимости от объёма и характеристик обучающих данных.
Мы активно движемся к уровню ChatGPT и надеемся в следующих версиях модели GigaChat порадовать вас ещё более высоким качеством. Кстати, GigaChat с сегодняшнего дня также доступен всем желающим прямо в Telegram-боте — достаточно просто открыть, нажать «Начать» и вступить в диалог. Заходите попробовать 🙂
Ссылки:
-
Модель претрейна ai-forever/ruGPT-3.5-13B на Hugging Face
-
Хабр cтатья про претрейн GigaChat
-
Официальный аккаунт в Телеграме GigaChat
#lms #языковые модели #NLP #рерайтинг #стайл-трансфер #суммаризатор
Команда разработчиков: SberDevices, AGI NLP
@mashkka_t, @Colindonolwe, @arorlov, @DanAsOne, @averkij, и co.
ссылка на оригинал статьи https://habr.com/ru/articles/761120/
Добавить комментарий