
Громоподобный шаг научно-технического прогресса слышен издалека: сквозь года до нас доносится эхо шагов из будущего. Шрамы ран, полученных в предыдущие промышленные революции, априорные, переданные через учебники и опыт предков, болезненно сжимаются под воздействием этого эха. Как и всё великое, дела человечества пугающе красивы.
Наверное, поэтому все мы стали в той или иной мере, но скажем честно, опасаться ИИ заранее. А пока фантазировали, он зашёл не совсем оттуда, откуда его ждали.
В 2004, когда выпускали фильм «[1], [2], [3], etc), уже пишут код, прямо сейчас.
Нейросети уже даже угрожают чьим-то рабочим местам. Несколько недель назад мой близкий друг рассказал о делах в его фирме. Причём, они ведут достаточно классический бизнес, сильно далёкий от ИИ или ИТ. У них радикально сократили штат дизайнеров, а в ближайшее время собираются заменить почти всех, оставив небольшое количество уже скорее промт-инженеров.
Если вы использовали любую из современных генеративных моделей: Kandinsky 3.0, StableDiffusion SDXL, DALL-E 3, Imagen, Midjourney, Adobe Firefly или другие, то вы хорошо понимаете о чём речь, какого высокого качества они достигли, как их только не применяют.
Для иллюстрации масштабов:

Дальше только больше, кто-то даже считает, что программисты — списанный материал, а кто-то намекает, что и весь интеллектуальный слой человечества. И хотя эти тезисы пока ближе к спекуляциям, удивляет, как быстро мы преодолели путь между фантазиями и реальностью.
Но этот текст не про будущее и не про гадание на кофейной гуще, какое оно будет. Он про то, как реагируют на угрозу люди. Ведь было бы странно думать, что все с этим просто смирились. Конечно, люди прекрасно понимают происходящее и стараются что-то предпринять. Немного об этом я и расскажу.
Итак, художники одними из первых приняли удар и им есть о чём беспокоиться. Мало того, что теперь любой человек может совершенно спокойно, без какого-либо существенного навыка, генерировать изображения такого качества, что хоть конкурсы выигрывай. Так теперь ещё и личный стиль, выработанный долгими годами, в условиях жёсткой конкуренции, могут просто увести в пару кликов. Например, существует проект Scenario, позволяющий загрузить свой собственный трейнсет и на его основе генерировать изображения с конкретным стилем.
Получается сложная правовая, моральная и этическая ситуация, которую пытаются разрулить с очень разных сторон. От добавления специального тегов (вроде do-not-scrape/train) в robots.txt до судебных исков. Фундаментально, однако, это всё малоэффективно, по двум причинам. Во-первых, огромный перевес денежных средств и инвестиций, очевидно, сейчас скорее на стороне меча, нежели щита. Во-вторых, если крупные компании вынуждены реагировать, иначе их затаскают по судам, то мириады стартапов просто кладут на это цифровой болт. Они закрываются-то быстрее, чем юрист успеет документы заполнить.
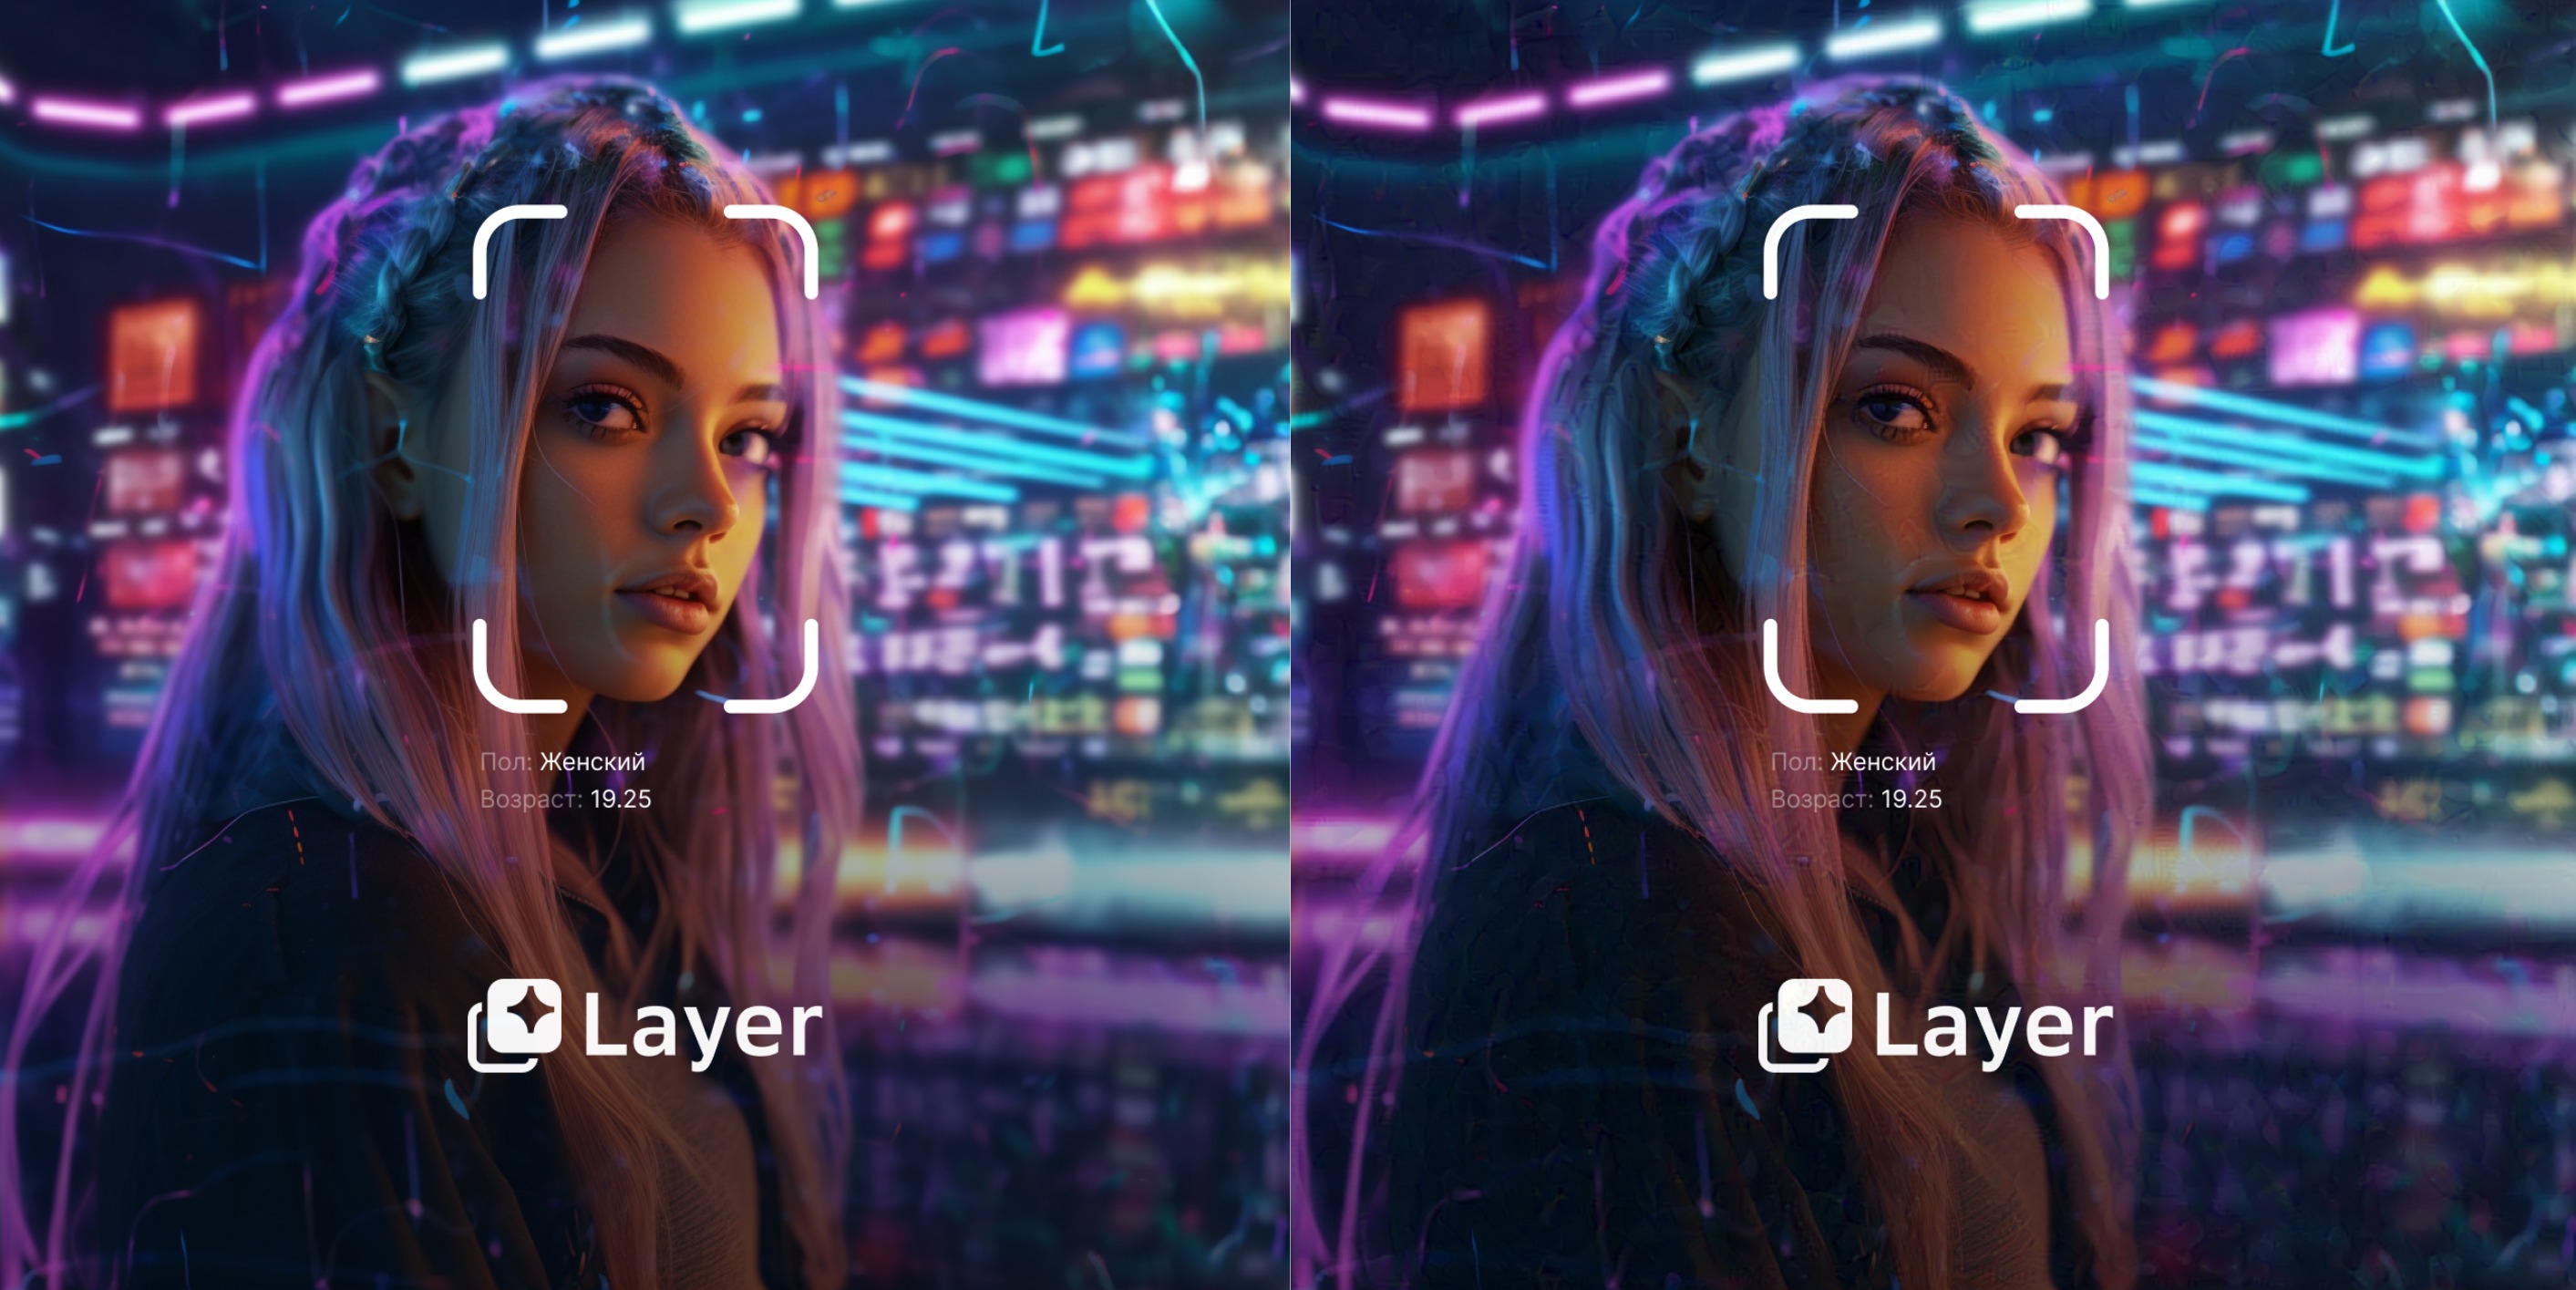
Поскольку административные инструменты пока не очень эффективны, да никому пока особо и не понятно, как их применять и надо ли вообще, в дело вступила наука. В целом, за долгие года развития области накоплено достаточно понимания, как можно атаковать системы машинного обучения, поэтому не удивительно, что со временем появились утилиты, предназначенные для защиты авторских работ на основе этого понимания.
Разберём два таких свежих инструмента: Glaze и Nightshade, по их соответствующим научным публикациям ([1], [2]). Интересны эти работы по нескольким причинам: во-первых, это достаточно сильные и свежие работы, во-вторых, они демонстрируют относительно неожиданный вектор развития мысли защищающейся стороны.
Работа Glaze очень интересна статистикой, которую 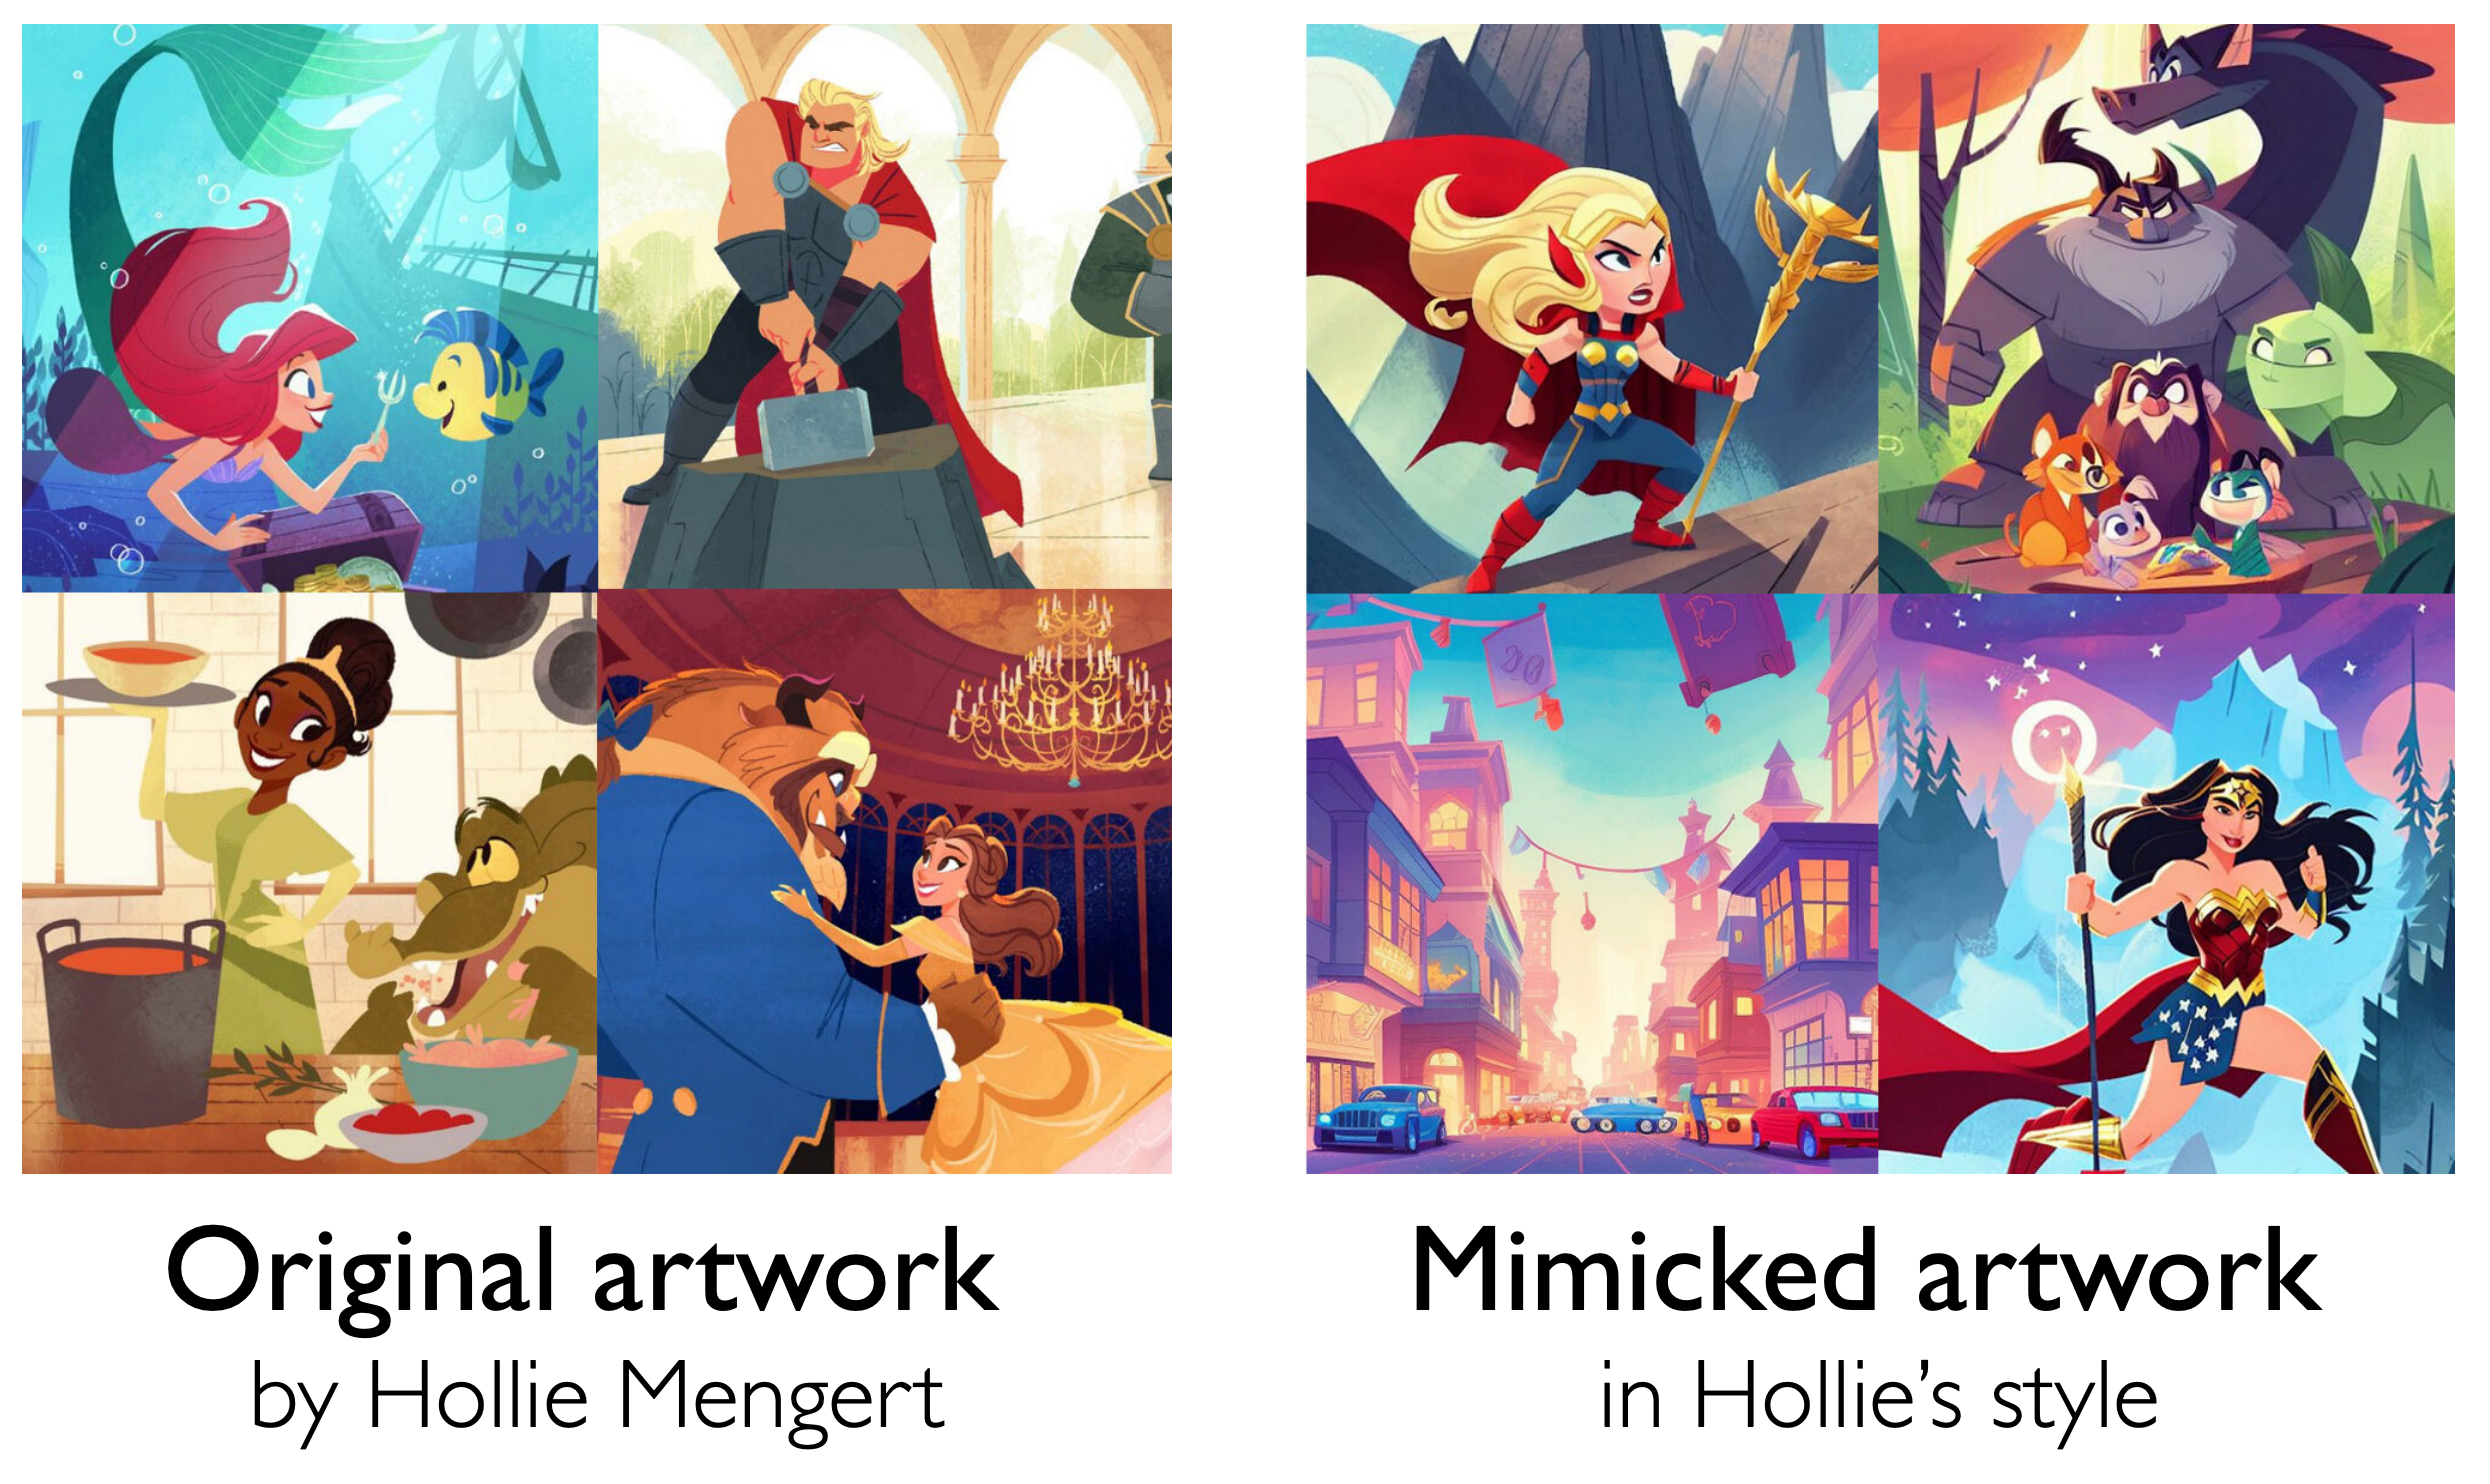
Ну, в общем, мотивация работ более, чем ясна. Как же работают разработанные методы защиты?
Я предполагаю, что большинство читателей в курсе такого направления в ML, как Adversarial Attacks (далее АА).
Они довольно на слуху, поскольку взломать систему, работающую в проде для злоумышленника наиболее интересно, например, если речь идёт о распознавании лиц и пр. Однако, есть и другой вид угроз, уже этапа тренировки — Data Poisoning. Само понятие применяется не только в ML и в целом, из названия понятно о чём речь: различными способами и в зависимости от целей, данные изменяются таким образом, что как минимум становятся бесполезны, как максимум ломают модель при обучении.
Признаюсь, я начинал читать эти две работы со скепсисом, поскольку подобные методы в более исследованных, не генеративных, задачах работают ограниченно и чтобы достичь серьёзного урона, нужно отравить очень значительную часть трейнсета. Авторы, также, начинают с обсуждения этих фактов.
Например, для задачи классификации для выведения модели из строя может понадобиться отравить от 20% всех данных. Кроме того, ранее считалось, что диффузионные модели даже более устойчивы к подобным воздействиям, например, для бекдор атак может понадобиться отравить половину трейнсета. Казалось бы, с учётом размеров датасетов, на которых такие модели тренируются, Data Poisoning не выглядит выигрышной для атакующего стратегией: речь будет идти о просто огромных объёмах испорченных сэмплов. Но авторы этих двух работ показывают, что это ошибочно.
В общем, Glaze действует достаточно прямолинейно и в стиле AA: изображения модифицируются так, что выглядеть, как оригинальные или с небольшими искажениями, но чтобы при этом в пространстве признаков, с которым работает генератор, смещение было максимальным и в заданную сторону. Метод не зависит от специфики пространства признаков конкретной модели, и, как показывают авторы, потенциально работоспособен на любой архитектуре: Художникам, таким образом, предлагается изображения перед публикацией в интернете защитить и прогнать через Glaze. Я попробовал запустить его на Macbook Pro M1, и на самых Впрочем, судя по данным из статьи, авторы работ считают приемлемой за защиту ценой и куда большие искажения. Nightshade технически интереснее, Авторы приводят статистику: в огромном и популярном датасете LAION-Aesthetic (600кк пар) слово «лицо» встречается с частотой 0.13%, семантически лицо фигурирует с частотой 0.85%. Тоже самое и с другими концептами: если взять топ-10 слов, которые вводят для генерации в Midjourney, то их частота в LAION-Aesthetic в среднем будет 0.07%.
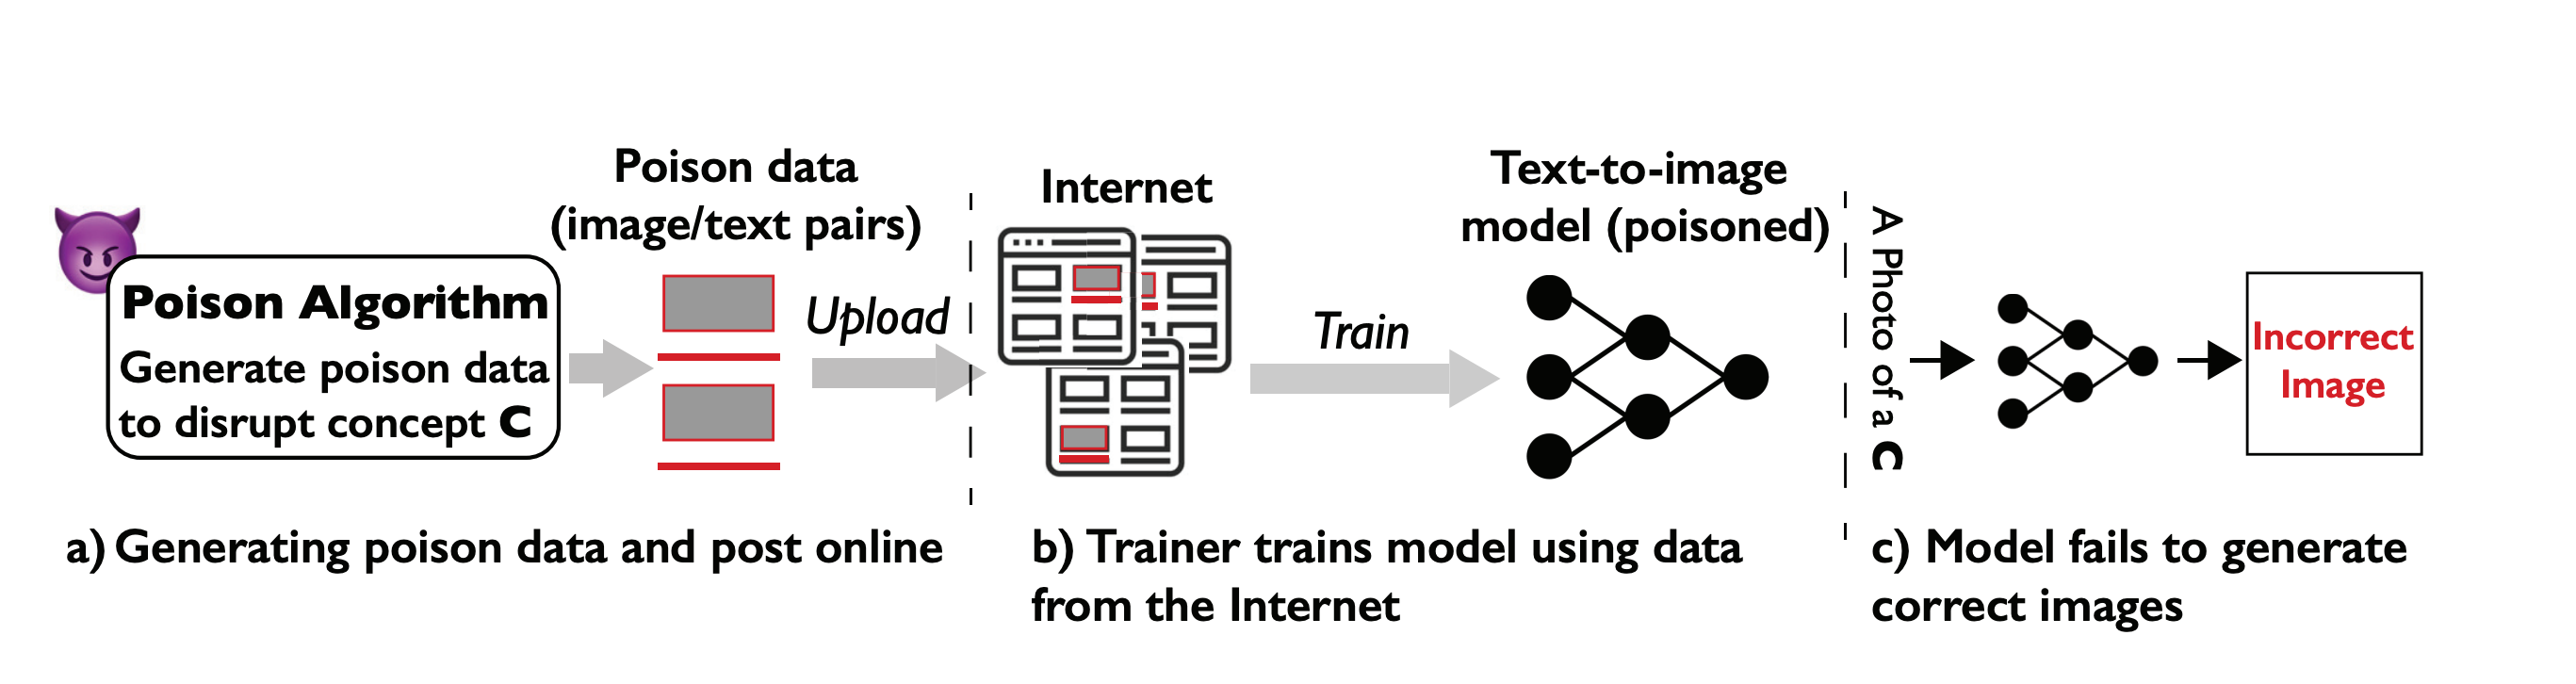
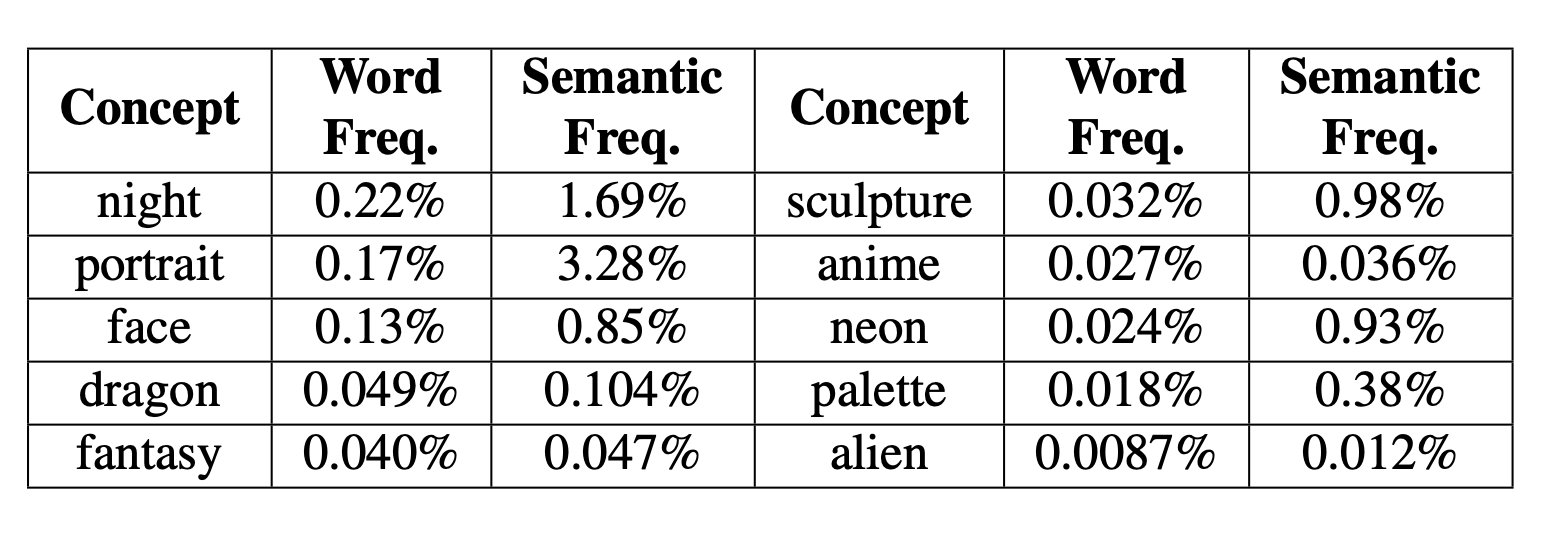
Как вы понимаете, при такой плотности отравить один конкретный концепт очень легко. Чем авторы и занимаются. Детали подхода описывать не буду для краткости (очень рекомендую оригиналы, они интересные), но высокоуровнево всё достаточно похоже: генерируется опорное изображение, берётся реальное настоящее и сдвигается так, чтобы выглядело как оригинал, но реально тащило сеть к концепту из опорного изображения.
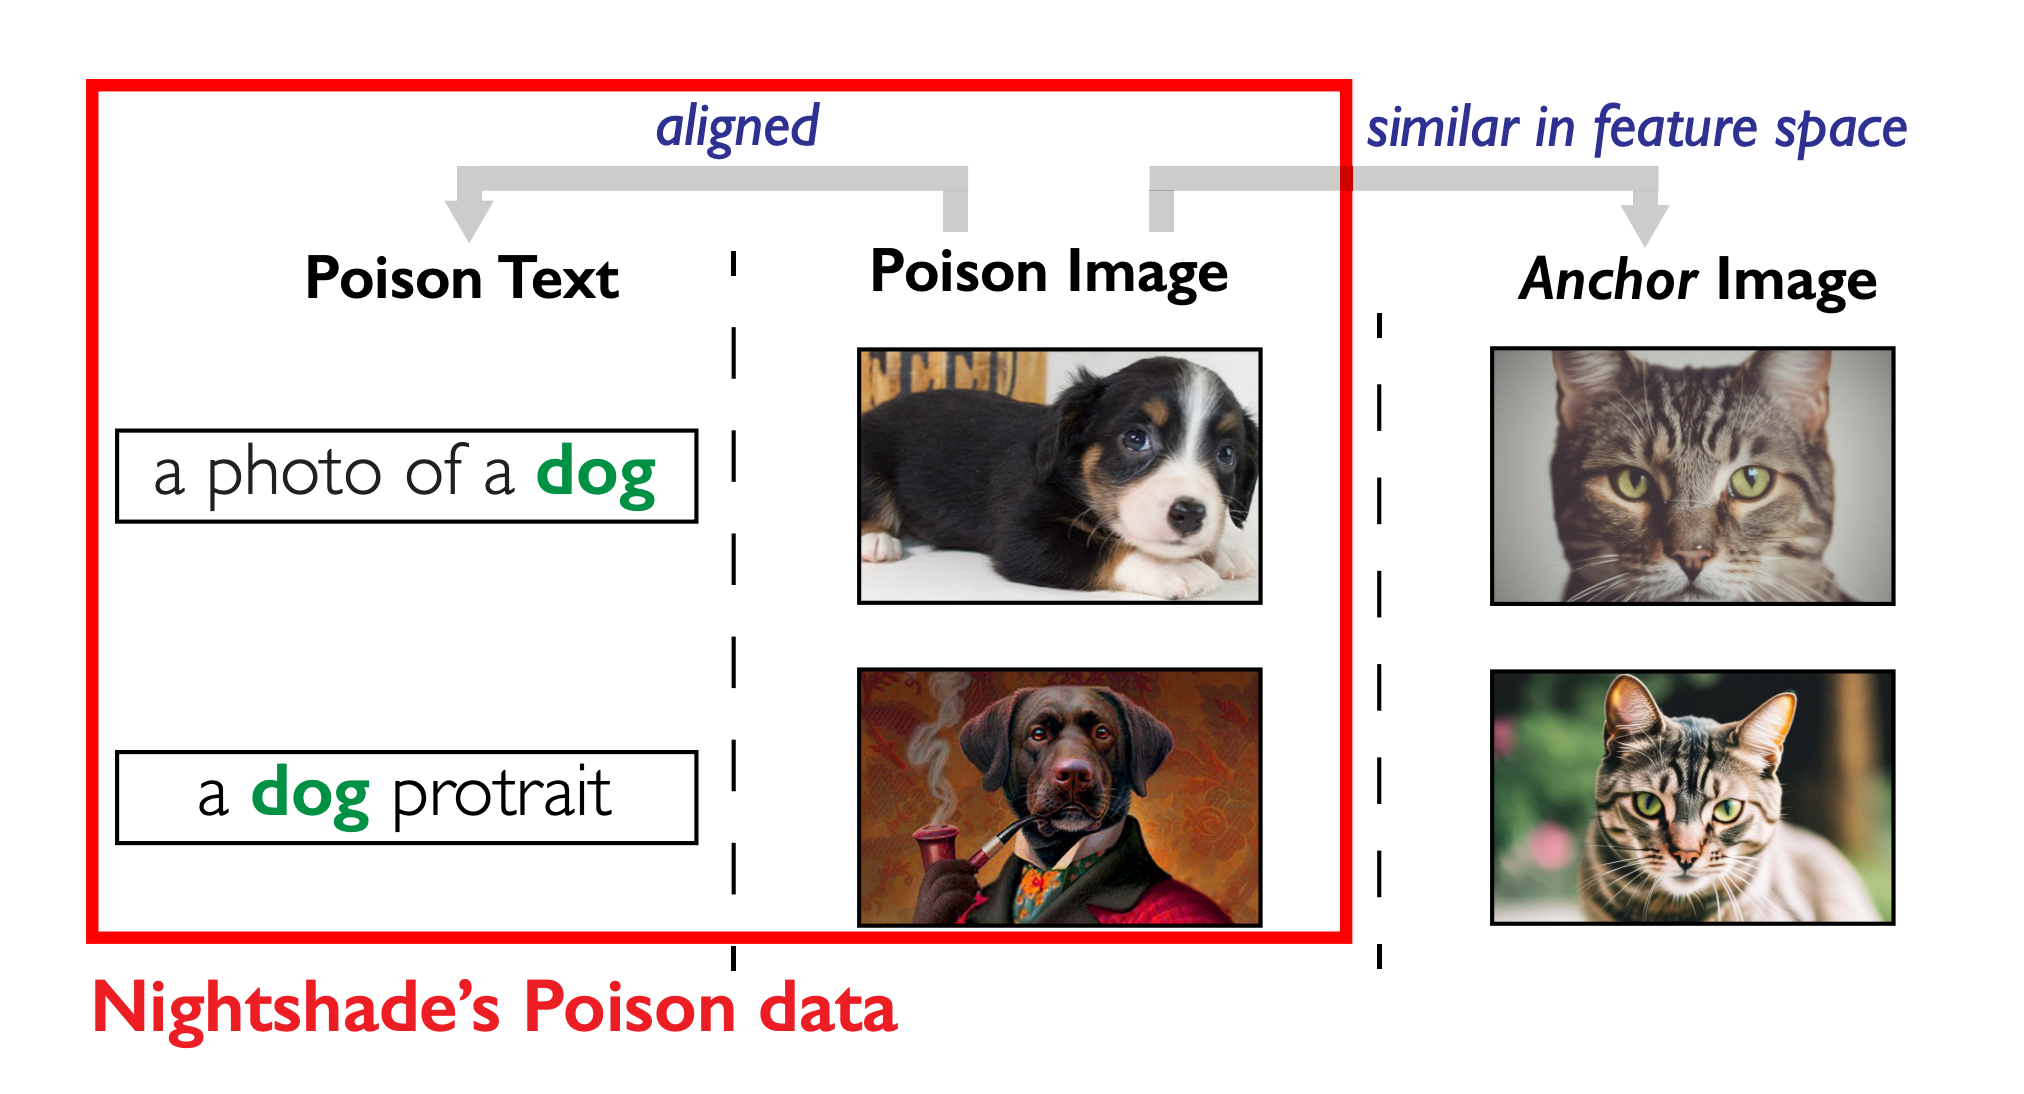
И, наконец, кульминация: самый поразительный факт всей работы. Чтобы отравить насмерть конкретный концепт, например, «собака», да ещё и так, что с эффектом «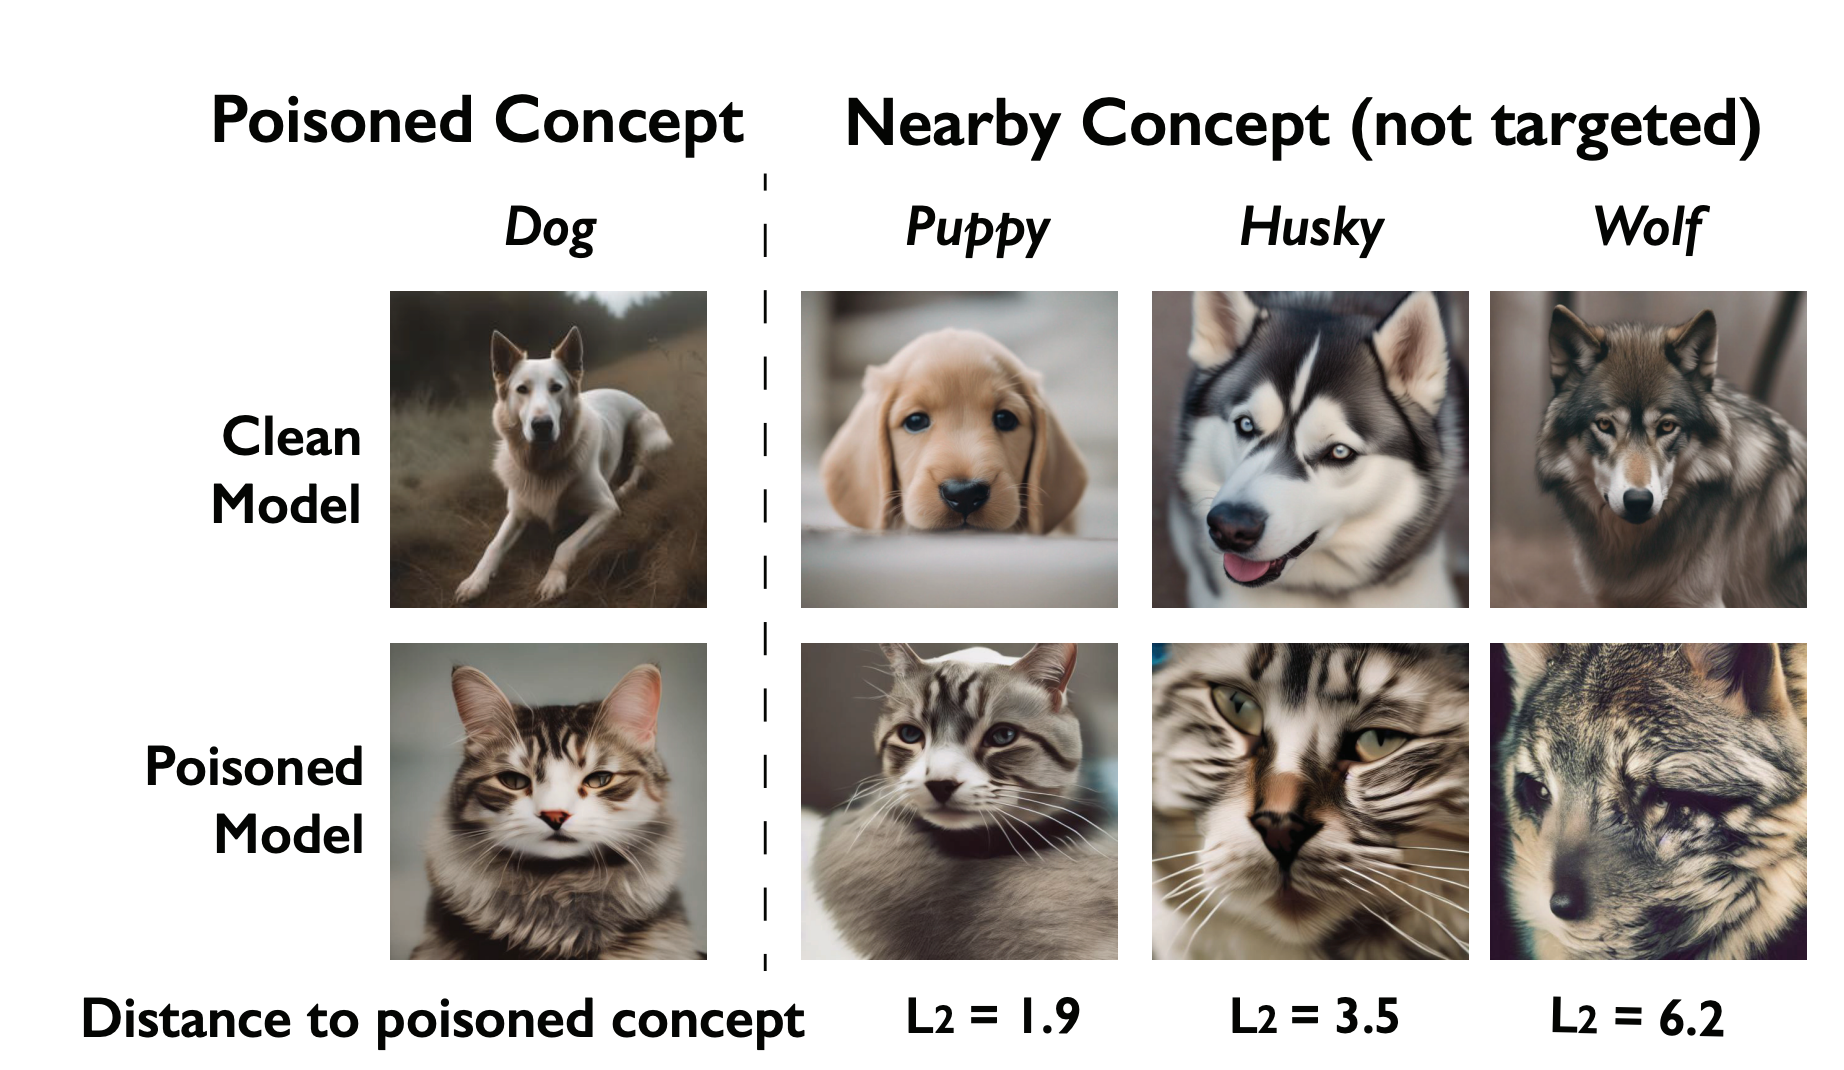
При этом, чтобы сделать результаты малополезными, может быть достаточно вообще всего от 25 сэмплов. На 50 плохеет невооружённым взглядом:
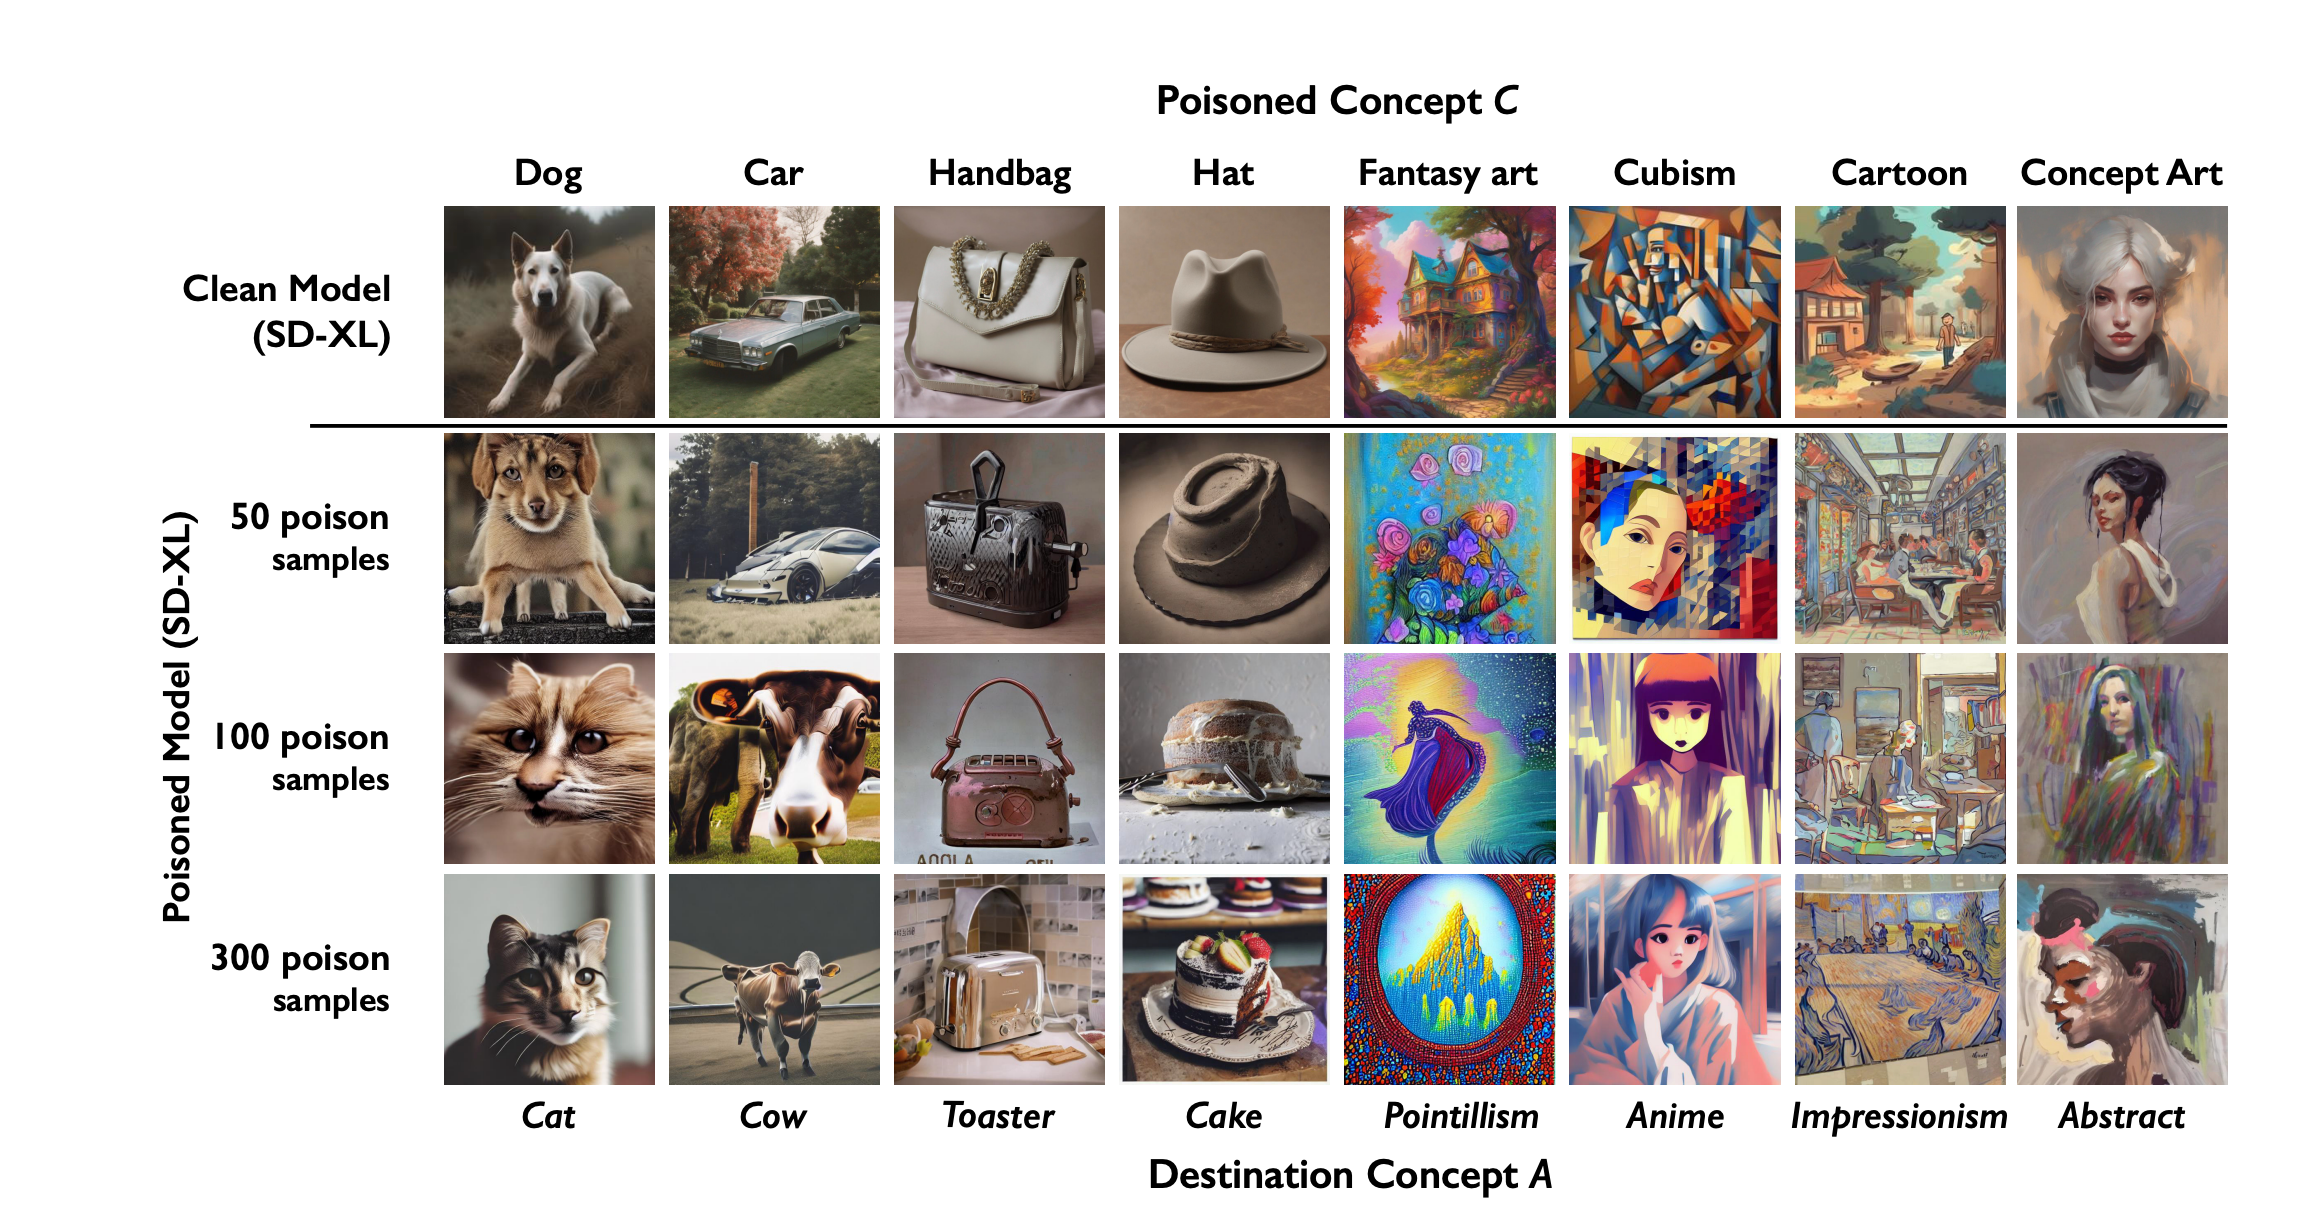
Обратите внимание, что эксперименты выполнялись в т.ч. на StableDiffusion SDXL — свежей и очень сильной модели.
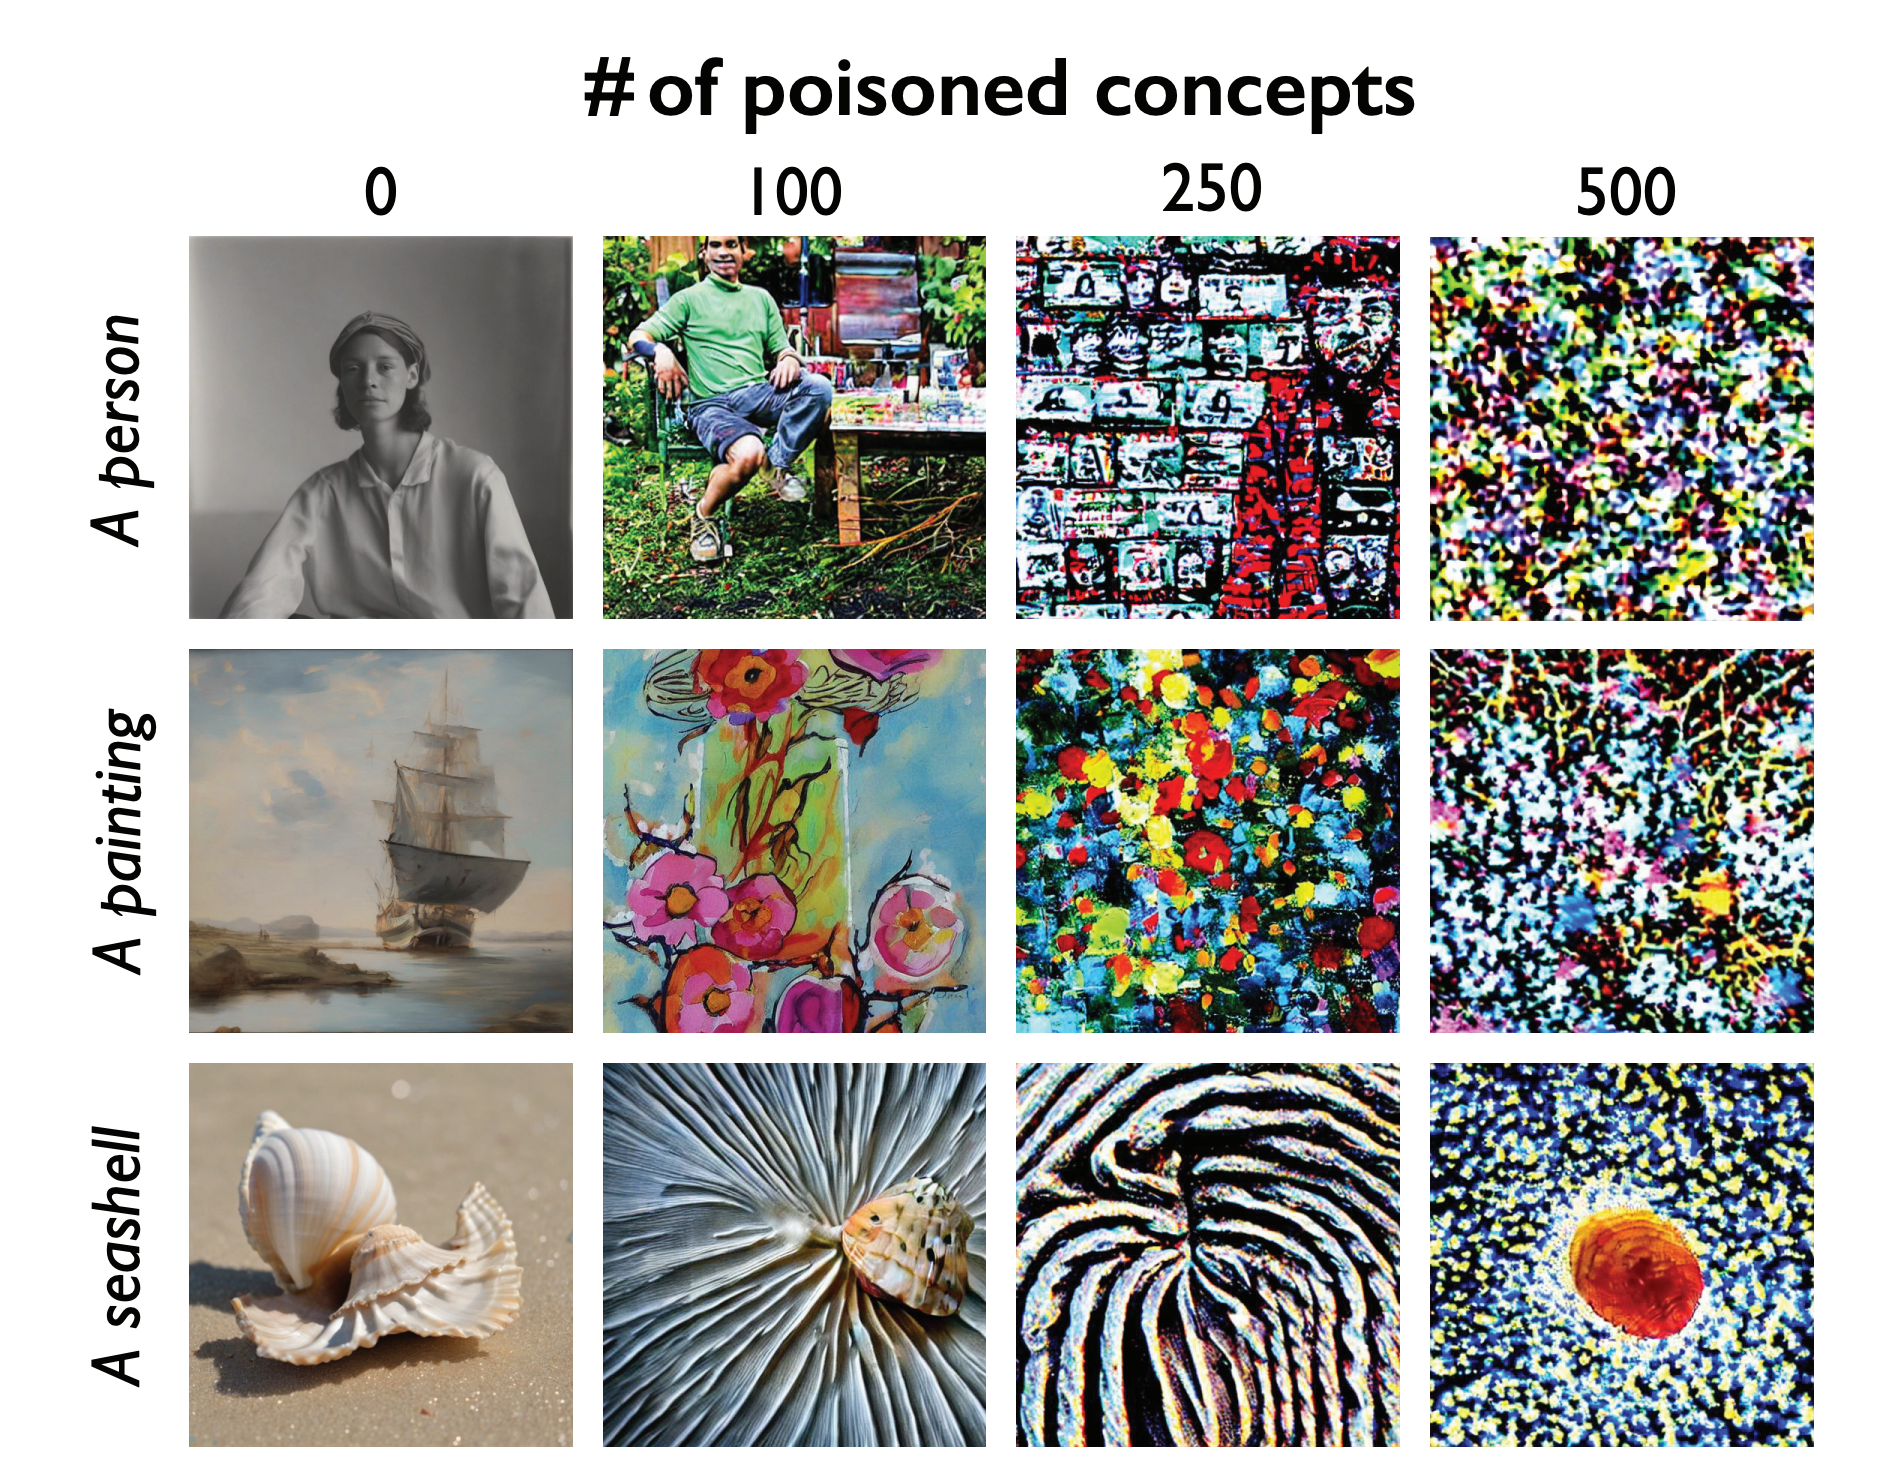
И даже более, чтобы сломать не только конкретные концепты, а вообще всю модель, достаточно разломать совсем немного концептов:
Кратко скажу, что все методы противодействия таким отравленным примерам, которые могут придти в голову навскидку, не помогают. Авторы Nightshade исследовали основные: фильтрация или даже полное пересоздание текстовых пар через image-text alignment модели (такие, как наш Телеграм-канал.
ссылка на оригинал статьи https://habr.com/ru/articles/785088/
Добавить комментарий