
Всем привет, меня зовут Захаров Антон, и я DevOps-инженер в компании Bimeister! Весь свой опыт я получил в этой компании, за 5 лет прошел путь от эникея до того, кем я работаю сейчас (большое спасибо коллегам!). Я расскажу, как на базе своих серверов и внутренних ресурсов мы создаем персональные стенды для разработки и тестирования нашего приложения.
Ноябрь 2018 года: нас 20 человек, бэк-офис, три команды разработчиков, три собственных сервера и желание сделать работу коллег удобной. Один сервер под бэк-офис, два остальных отдали нам. Мы только-только переехали в gitlab (был bitbucket и jenkins) и начали настраивать наш ci/cd.
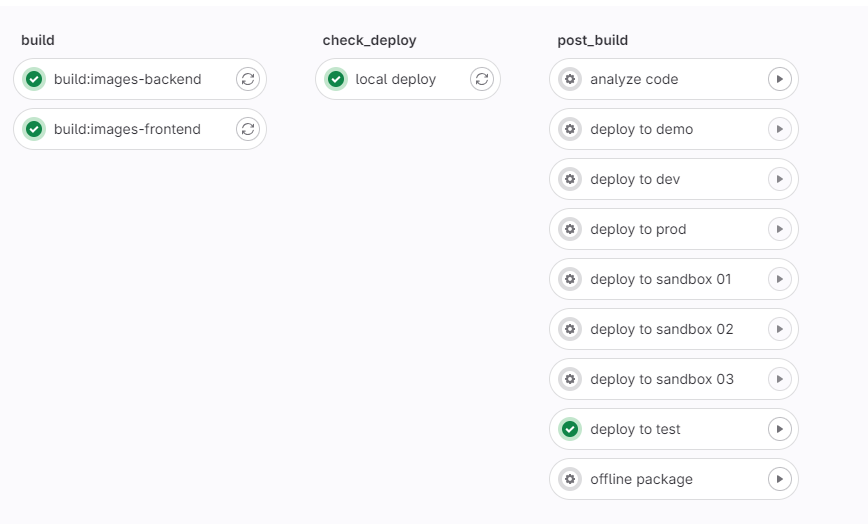
Вот так он выглядел вначале. Билд, создание docker-compose.yml для локального деплоя и деплой нашего приложения на стенды с докером.
Каждый такой стенд с докером — виртуальная машина, на которую любой разработчик или тестировщик может зайти и посмотреть логи, что-то изменить:
-
dev — для программистов,
-
test — для QA,
-
prod — на тот момент это деплой стабильной ветки,
-
demo — для демонстраций заказчикам,
-
sandbox — песочницы или персональные стенды, общие стенды. Кто успел, тот и использует, про них сегодня и пойдет речь.
Отдавать приложение еще никому не надо, идет разработка. Основной проект лежит в монорепозитории.
Октябрь 2020: добавились новые люди, микросервисы и еще пару персональных стендов, их уже пять.
Апрель 2021: прибавился еще сервер, обновили старые, и вот у нас уже 13 персональных стендов. Стоит сказать, что не многие могут позволить себе развернуть локально наше приложение, оно уже достаточно объемное. Да и удобнее, когда ты нажимаешь кнопку и у тебя все готово. Около 30 различных контейнеров в одном приложении.
Ноябрь 2021: 19 sb стендов. Одна виртуалка на 24 GB RAM, 8 CPU, 300 GB disk.
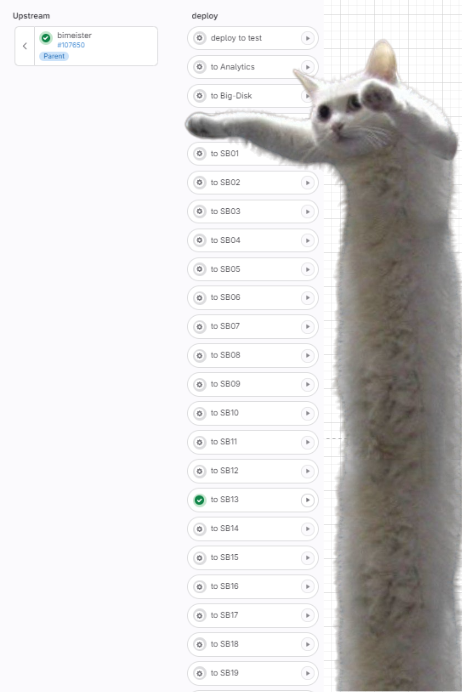
В рабочем чате творится вакханалия «Я занял такой-то стенд, а кто мне все сломал?! Это же был мой стенд». Сделали бота, через который сотрудники бронировали персональный стенд и отмечали, если стенд больше не использовали.
Все это время мы думали об использовании kubernetes. Даже были манифесты, позволяющие развернуть приложение в нем, но рук не хватало, и откладывали это все до подходящего момента. Момент наступил, когда расширилась команда DevOps.
Февраль 2022: подняли кластер kubernetes, написали helm chart и создали первые персональные стенды в кубере — ksb, каждый такой стенд — это отдельный неймспейс.
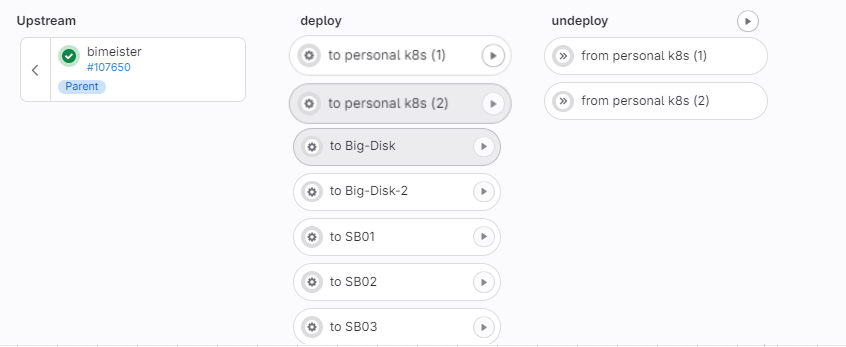
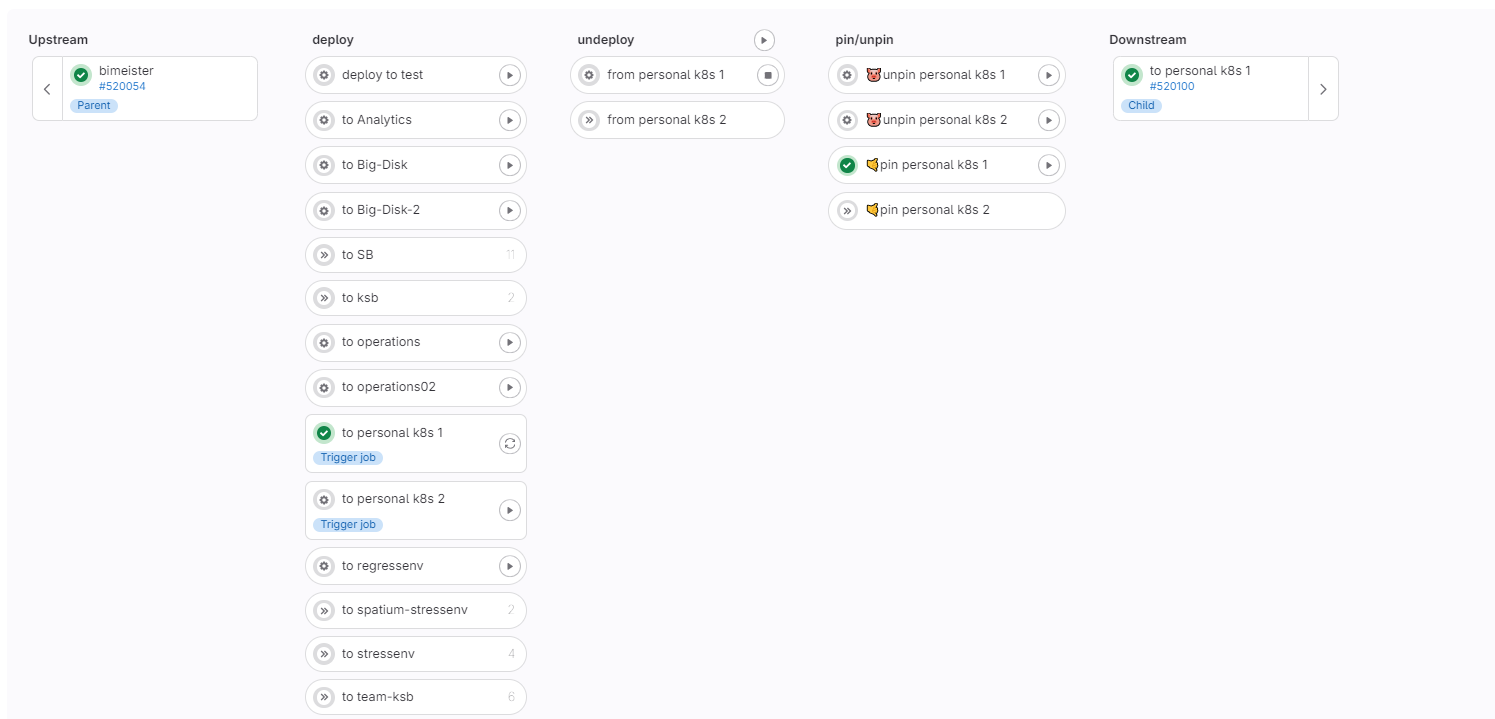
to personal k8s — установить
from personal k8s — удалить
Задумка была такая: если кому-то надо что-то протестировать, он в своей ветке нажимает деплой, разворачивается неймспейс с именем того, кто нажал (ksb-firstname-lastname) все это тестируется самим разработчиком, отдается в QA или вливается в главную ветку. После, стенд удаляется или берется следующая задача. Дали возможность иметь одновременно два личных персональных стенда.
Адрес, по которому доступен стенд : https://$ENV_NAME.dev.example.io
ENV_NAME="ksb-$(echo ${GITLAB_USER_LOGIN::45} | sed -r 's/\./-/g;s/\-$//')-$ENV_NUM"В итоге получается ksb-anton-zakharov-1.dev.example.io — деплой на первый стенд,
ksb-anton-zakharov-2.dev.example.io — на второй.
Количество стендов ограничено. Перед началом подсчитываются уже развернутые, и если превышено определенное значение, возникает ошибка «извините, приходите попозже».
ST_KUBE_ENV_NUM=$(kubectl get ns --no-headers -o custom-columns=":metadata.name" | grep -c "^ksb" ) || ST_KUBE_ENV_NUM=0 ; ENV_EXISTS=$(kubectl get ns --no-headers -o custom-columns=":metadata.name" | grep -c -x "$ENV_NAME") || ENV_EXISTS=0 ; echo -e "${TXT_CYAN}Number of deployed kubernetes environments now is ${ST_KUBE_ENV_NUM}${TXT_CLEAR}" ; if ([ "$ST_KUBE_ENV_NUM" -ge "$MAX_KUBE_ENV_NUM" ] && [ "$ENV_EXISTS" -eq 0 ]); then echo -e "${TXT_RED}The number of kubernetes environments exceeded ($MAX_KUBE_ENV_NUM is maximum)!${TXT_CLEAR}" && exit 1; fi ;Чтобы удалять неиспользуемые стенды, срок их жизни ограничили на сутки с момента деплоя. Срок отслеживает гитлаб с помощью функции auto_stop:
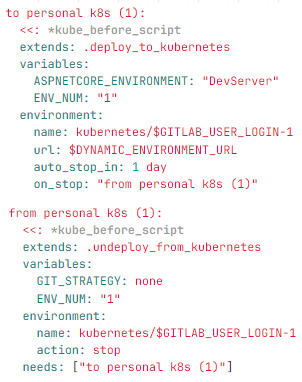
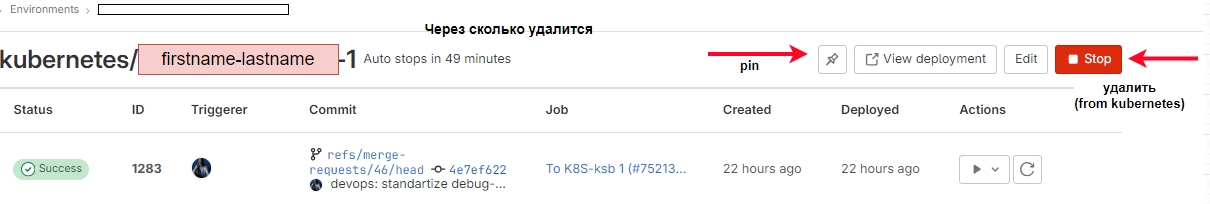
Если на стенд накатывали обновление, время сбрасывалось и отсчет начинался заново.
Со стендом можно работать:
-
pin — остановить auto_stop,
-
view deployment — перейти по ссылке на сайт приложения,
-
stop — запустить undeploy.
Стенды с docker-ом остались, их стало меньше, а высвобожденные ресурсы добавились в кластер.
Так мы и жили почти полтора года, поддерживали работу кластера, деплой персональных стендов, параллельно делали другие задачи. Количество стендов росло, добавились новые кластеры:
-
dev — основной кластер с персональными стендами,
-
regress — для проведения регрессионного тестирования,
-
stress — для нагрузочного тестирования и др.,
-
тестовый кластер — можем ломать его, как хотим.
Несколько раз наш dev кластер умирал безвозвратно из-за отключения электричества, в основном. Думали держать резервный мастер в облаке, но затрат на это больше, проще подготовить скрипты, чтобы быстро поднять кластер с нуля.
Ноябрь 2023: персональных стендов в k8s — 60 штук. «МАЛО! — говорят люди, — нам не хватает!»

Декабрь 2023: вот к чему мы пришли.
Нам купили еще оборудование, и мы смогли увеличить ресурсы наших кластеров.
Монорепозиторий изрядно похудел, сейчас это больше сборочный проект для всех остальных модулей.
Наш итоговый pipeline (во время создания релиза добавляется еще один stage):
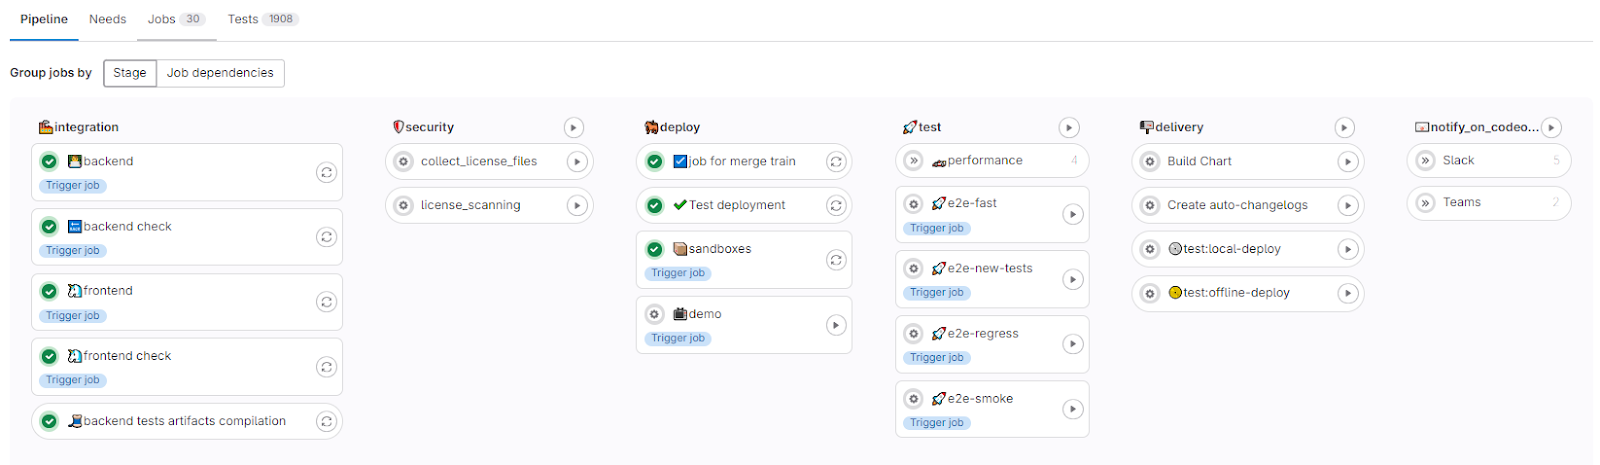
Заходим в sandboxes:
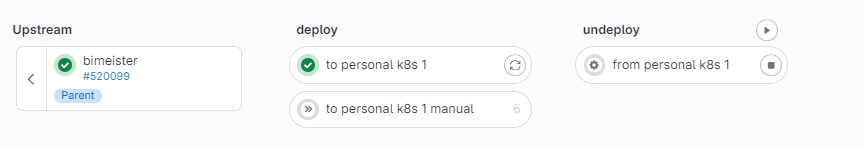
Еще глубже в to personal ksb 1, to personal k8s 1 manual — это возможность задеплоить различные наборы модулей приложения
Еще глубже, лог успешной джобы:
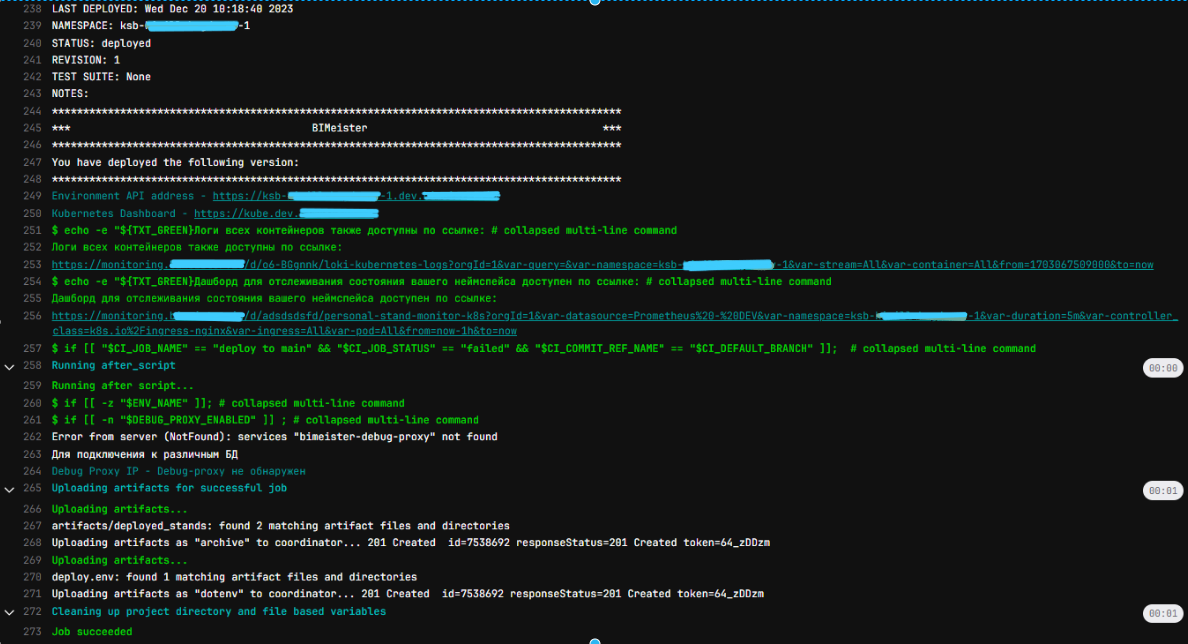
В конце джобы нам доступен адрес стенда, ссылка на kube-dashboard, мониторинг вместе с логами.
Отдельно про мониторинг и логирование можете почитать в нашей статье:
Оптимизация DevOps: Как персональные стенды и Grafana улучшают разработку и мониторинг
Debug-proxy запускается при необходимости (поэтому not found), это tcp-proxy. На одном external-ip со своими портами доступны те сервисы, которые необходимы, — так разработчики и QA могут подключиться к подам своих персоналок с локальных машин. Минус — заканчиваются внешние ip).
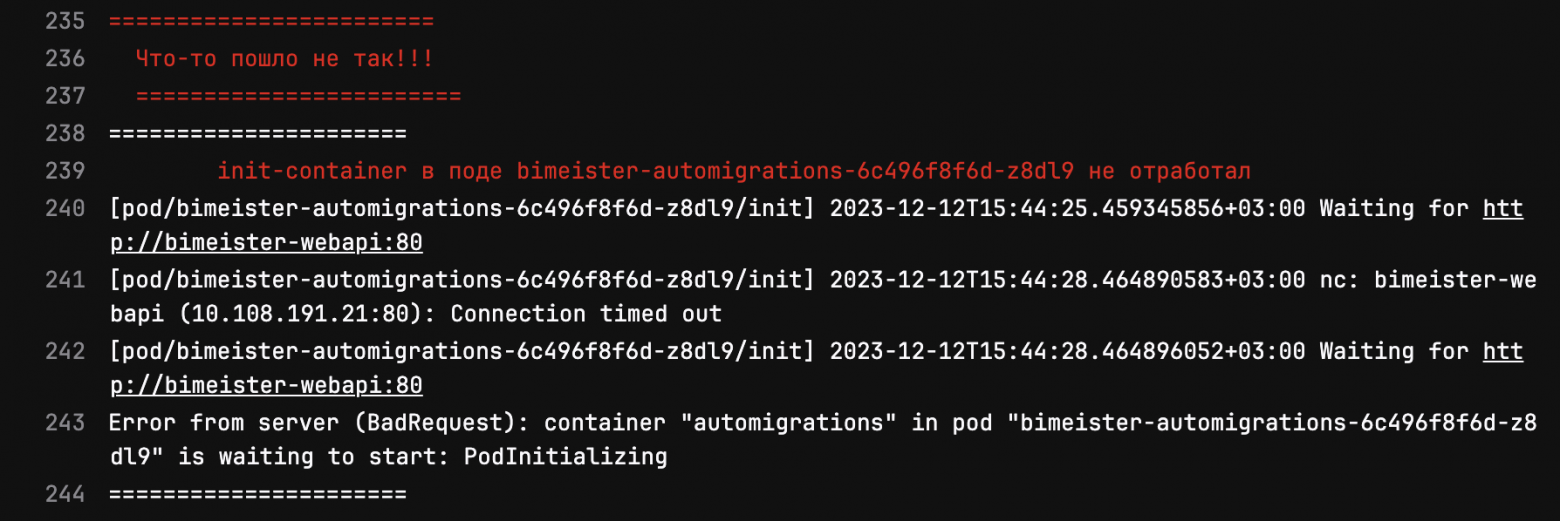
Очень много проблем возникает во время деплоя: инфра, ошибки приложения, автомиграции, невезение. Чтобы хоть как-то их выявить и показать в джобе, мы выполняем:
helm upgrade --install ${RELEASE_NAME} "${CHART_FOLDER}/" \ --namespace "$ENV_NAME" \ -f ${CHART_FOLDER}/values.yaml ${PRODUCT_NAME:+-f ${CHART_FOLDER}/}${PRODUCT_NAME}${PRODUCT_NAME:+-values.yaml} $ADDITIONAL_ENV_VALUES \ --set image.tag="${REWRITE_CONTAINER_VERSION:-$CONTAINER_VERSION}" \ --set global.ingress.enabled="true" \ --set global.ingress.hosts[0]="$ENV_URL" \ --set global.image.pullPolicy="$HELM_IMAGE_PULL_POLICY" \ --set debug_proxy.enabled=true \ --wait \ --timeout ${TIMEOUT}m ${HELM_EXTRA_FLAGS} \ && mkdir -p "${DEPLOYED_STANDS_FOLDER}" \ && echo ${DYNAMIC_ENVIRONMENT_URL} > "${DEPLOYED_STANDS_FOLDER}/$ENV_NAME" \ && echo -e "${TXT_CYAN}Environment API address - https://$ENV_URL${TXT_CLEAR}" \ && echo -e "${TXT_CYAN}Kubernetes Dashboard - $KUBE_DASH_URL${TXT_CLEAR}" \ ) || ( \ export JOB_EXIT_CODE="$?" \ && echo -e "${TXT_RED}======================== Что-то пошло не так!!! ========================${TXT_CLEAR}" \ && export RELEASE_NAME=${RELEASE_NAME} \ && export ENV_NAME=${ENV_NAME} \ && export TIMEOUT=${TIMEOUT} \ && ./kubectl_show_error.sh \ && echo -e "${TXT_RED}Helm завершился с ошибкой.${TXT_CLEAR}" \ && echo -e "${TXT_GREEN}Логи всех контейнеров также доступны по ссылке: ${TXT_CYAN}https://monitoring.example.io/d/o6-BGgnnk/loki-kubernetes-logs?orgId=1&var-query=&var-namespace=${ENV_NAME}&var-stream=All&var-container=All&from=${TIME_IN_UTC_MILLISECONDS_HELM_STARTED_AT}&to=now${TXT_CLEAR}" \ где kubectl_show_error.sh:
#!/bin/sh export RELEASE_NAME=${RELEASE_NAME:-"bimeister"} export ENV_NAME=${ENV_NAME:-"bimeister"} export TAIL=${TAIL:-20} export TIMEOUT=$(( ${TIMEOUT:-20} + 5 )) PROBLEM_PODS="$(kubectl get pods -n $ENV_NAME -o jsonpath='{range .items[*]}{.status.containerStatuses[*].ready} {.metadata.name} {end}' | grep "false" | rev |cut -d ' ' -f1 | rev )" for POD in $PROBLEM_PODS do JS=$(kubectl get pod -n $ENV_NAME $POD -o json) # init-container не отработал. Находим его, выводим последние 3 строки лога if [[ "true" == "$(echo $JS | jq '.status.initContainerStatuses[].state | any(paths; .[] == "running")' | grep true | head -n1)" ]] ; then echo -e "====================== ${TXT_RED}init-container в поде ${TXT_GREED}${POD}${TXT_RED} не отработал${TXT_CLEAR}" ; kubectl logs -n $ENV_NAME $POD --timestamps=true --prefix=true --all-containers=true --tail=3 ; # CrahLoopBackOff elif [[ "" != "$(echo $JS | jq '.status.containerStatuses[] | select(.state.waiting.reason == "CrashLoopBackOff")')" ]] ; then echo -e "===================== ${TXT_RED}Под ${TXT_GREED}${POD}${TXT_RED} не может корректно стартовать. Количество рестартов: ${TXT_GREED}$(echo $JS | jq '.status.containerStatuses[].restartCount')${TXT_RED} Лог последней попытки: ${TXT_CLEAR}" ; kubectl logs -n $ENV_NAME $POD --timestamps=true --prefix=true --since=${TIMEOUT}m ; # imagePullBackOff elif [[ "true" == "$(echo $JS | jq '.status.containerStatuses[].state | any(paths; .[-1] == "waiting")')" ]] ; then echo -e "====================== ${TXT_RED}Возможно не найден образ в поде ${TXT_GREED}${POD}${TXT_RED} или под не может быть назначен ни на одну ноду. Подробности ниже:${TXT_CLEAR}" ; echo $JS | jq '.status.containerStatuses[].state.waiting' ; echo -e "${TXT_RED}Лог последней попытки:${TXT_CLEAR}" ; kubectl logs -n $ENV_NAME $POD --timestamps=true --prefix=true --since=${TIMEOUT}m ; # контейнер unready elif [[ "false" == "$(echo $JS | jq '.status.containerStatuses[].ready')" ]] ; then echo -e "====================== ${TXT_RED}Под ${TXT_GREED}${POD}${TXT_RED} не имеет статус ready. Проверка healthcheck'a не проходит. Количество рестартов: ${TXT_GREED}$(echo $JS | jq '.status.containerStatuses[].restartCount')${TXT_RED} Лог последней попытки: ${TXT_CLEAR}" ; kubectl logs -n $ENV_NAME $POD --timestamps=true --prefix=true --since=${TIMEOUT}m ; # Проблемы с контейнером (выводим логи) else echo -e "====================== ${TXT_RED}Проблемы в поде ${TXT_GREED}${POD}${TXT_RED} неочевидны. Ниже его статусы и лог: ${TXT_CLEAR}" echo $JS | jq '.status.conditions' ; kubectl logs -n $ENV_NAME $POD --timestamps=true --prefix=true --since=${TIMEOUT}m ; fi done echo -e "${TXT_CYAN}Список незапущенных подов:${TXT_CLEAR}" kubectl get pods $PROBLEM_PODS -n $ENV_NAME -o=custom-columns=POD_NAME:.metadata.name,STATUS:.status.phase,INIT_CONTAINERS:.spec.initContainers[*].nameВывод ошибки примерно такой:
Dashboard — стандартный куберовский, авторизация через AD + keycloak.
Доступ к кластеру k8s такой же. Если выходит новый сотрудник, мы добавляем его в группу в AD, он получает возможность деплоить и пользоваться дашбордом, или скачать kubeconfig, работать с kubectl и различными приложениями для k8s (lens, k9s, и т.д).
Гитлабовская система auto_stop и запинивания сбоила, неймспейсы в неподходящий момент удалялись. Пришлось заменить на собственную:
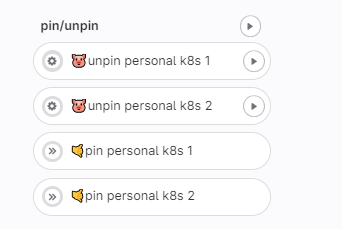
При первом деплое или обновлении в неймспейс по умолчанию добавляется лейбл с датой создания или обновления. Джоба pin добавляет дополнительный лейбл bimeister/stand.pinned=true, unpin удаляет его.
На мастере по крону запускается скрипт, который проверяет эти лейблы. Если стенд живет больше суток и у него нет лейбла bimeister/stand.pinned=true, запускается удаление. Если bimeister/stand.pinned=true, он не удалится до момента, пока не снимешь этот лейбл, или не удалишь неймспейс вручную. После авто удаления приходит письмо «извини, но стенда больше нет». Если запиненый стенд живет 5 дней, приходит письмо с предупреждением «а ты точно его используешь или может пора его уничтожить?»
#!/bin/bash email_on_namespace_deletion(){ LABELS=$(kubectl get ns $1 -o json | jq -r '.metadata.labels' | grep 'bimeister/' | sed 's/"//g' | sed 's/,//g' | sed ':a;N;$!ba;s/\n/\\n/g') curl --header "Content-Type: application/json" --request POST --data "{\"namespace\":\"$1\",\"whoami\":\"Скрипт авто очистки незапиненых неймспейсов delete_not_pinned_namespace.sh\", \"additional_info\": \"Время удалени я: $(date)\", \"labels\":\"$LABELS\"}" https://devops-api.dev.example.io/namespace_deleted } # Define the current time and the time threshold (24 hours ago) THRESHHOLD_TO_DELETE_IN_DAYS=${THRESHHOLD_TO_DELETE_IN_DAYS:-1} THRESHHOLD_TO_DELETE_IN_SECONDS=$(( 27 * 3600 * $THRESHHOLD_TO_DELETE_IN_DAYS )) current_time=$(date +%s) threshold_time=$((current_time - "$THRESHHOLD_TO_DELETE_IN_SECONDS")) # 86400 seconds in a day echo $THRESHHOLD_TO_DELETE_IN_SECONDS # List all namespaces and iterate through them for namespace in $(kubectl get ns -l bimeister/stand.updated.time -o jsonpath='{.items[*].metadata.name}' | tr ' ' '\n' | grep -E 'ksb-[a-z]+-[a-z]+' | sort) do # Get the stand.started_time label value started_time_label=$(kubectl get ns "$namespace" -o jsonpath='{.metadata.labels.bimeister\/stand\.updated\.time}') # Convert label time to Unix timestamp # Convert YYYY-MM-DDTHH-MM to YYYY-MM-DD HH:MM formatted_time_label="${started_time_label:0:10} ${started_time_label:11:2}:${started_time_label:14:2}" # Use 'date' to convert to Unix timestamp label_time=$(date -d "$formatted_time_label" +%s) # Check if stand.pinned label exists pinned_label=$(kubectl get ns "$namespace" -o jsonpath='{.metadata.labels.bimeister\/stand\.pinned}') # If label time is older than the threshold and pinned label is not true, delete the namespace if [[ $label_time -le $threshold_time ]] && [[ $pinned_label != "true" ]]; then echo label_time=$label_time threshold_time=$threshold_time echo "Deleting namespace: $namespace" email_on_namespace_deletion $namespace kubectl delete ns $namespace fi done https://devops-api.dev.example.io — самописное api на питоне.
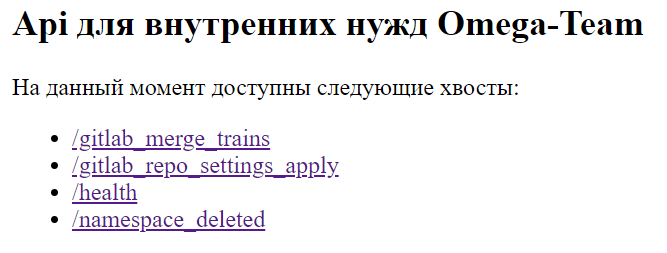
Еще из плюшек:
-
Написали статью с решением основных проблем при деплое, чтобы люди сами выяснили, почему упало, и попробовали решить. Подумываем над созданием умного бота для поиска проблем.
-
pg_admin развернут в дефолтном неймспейсе. Любой может к нему подключиться и пользоваться, указав в настройках имя сервиса с базой из своего неймспейса.
-
Скоро реализуем создание бекапов и перенос данных из одного неймспейса в другой.
-
Инструкции для локальной установки kubernetes (k3s, deckhouse, использование telepresence). Напишем статью, как это все разворачивать и использовать.
Минусы использования персональных стендов:
-
ресурсы для поддержки стендов, обслуживание машин и кластеров,
-
время на обучение сотрудников и поиск проблем при деплое,
-
стресс на этапе создания и тестирования работы тестового кластера. Очень много вопросов от сотрудников: не работает то-то, как сделать то-то.
За несколько лет мы пришли к тому, что у нас уже ~200 человек в компании, кому может понадобиться персональный стенд. Для них у нас есть ~20 стендов с докером и 130 в kubernetes.
Разрабатывать и тестировать стало проще и быстрее, отдавать во внедрение — спокойнее. На этом мы не останавливаемся и продолжаем делать работу нашего RND комфортнее, о чем узнаете в следующих статьях.
ссылка на оригинал статьи https://habr.com/ru/articles/788234/
Добавить комментарий