Статья из моего телеграм канала о программировании.
Генераторы коллекций — короткий(относительно цикла for) способ создавать коллекции на основе других коллекций.
Эти генераторы позволяют нам:
-
Кратко и просто создавать коллекции(при несложной логике).
-
Экономить время(генераторы более эффективны, чем цикл for).
-
Подходит для адептов функционального программирования, так как происходит именно генерация новой коллекции, а не изменение существующей.
Сразу хочу упомянуть одну важную вещь — не стоит «прятать» важные бизнес правила в сложные генераторы коллекций:
-
Не все могут быстро понимать, что же происходит в генераторе. Не все умеют хорошо писать генераторы коллекций. Раньше, выполняя задачки на сайтах по типу CodeWars, я тоже думал «Как круто, что можно много всего запихнуть в одну строку», и даже стремился к этому. Сейчас я так не считаю.
-
При усложнении бизнес логики велик шанс, что человек вносящий изменения будет стараться сохранить выражение генератор, а не отдать предпочтение переписыванию всего на этапы через for для того, что бы сделать код более явным. В следствие чего выражение генератор может стать ещё сложнее, либо логика может обосноваться рядом в лучшем случае с этим выражением(начнёт расплываться по коду, то что должно выполняться вместе)
# Функциональное выражение генератор взятое из боевого кода, # которое и по сей день кажется мне идеальным примером, # когда бизнес логика замешана с попыткой сделать код проще(меньше). # Попытка, как по мне, неудачна :) discounts = ( load_result.map(self._collect_discounts) .rescue(lambda ex: Success([None] * len(self._products))) .unwrap() )Давайте же перейдём к примерам:
-
Кратко и просто создавать коллекции.
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10] "Создание списка через стандартный цикл for" numbers_squares = [] for number in numbers: numbers_squares.append(number ** 2) "Создание списка с помощью генератора списков" numbers_squares_ = [number ** 2 for number in numbers] print(numbers_squares) # -> [1, 4, 9, 16, 25, 36, 49, 64, 81, 100] print(numbers_squares_) # -> [1, 4, 9, 16, 25, 36, 49, 64, 81, 100]И правда, компактно. А что, если логика будет посложнее?
students = { 1: { "age": 27, "first_name": "Mark", "last_name": "Loginov", "subject_average_score": { "history": 4.5, "mathematics": 3.4, }, }, 2: { "age": 32, "first_name": "Igor", "last_name": "Petrov", "subject_average_score": { "history": 4.2, "literature": 5, }, }, } students_ = { id: { "full_name": f"{student_data['first_name']} {student_data['last_name']}", "subject": [ subject for subject in student_data["subject_average_score"].keys() ], } for id, student_data in students.items() } print(students_) { 1: {'full_name': 'Mark Loginov', 'subject': ['history', 'mathematics']}, 2: {'full_name': 'Igor Petrov', 'subject': ['history', 'literature']}, } # Имея информацию о студентах, мы можем сделать выжимку и сжать данные до # размера: что это за студент, и какие уроки он посещает.numbers = [ [[1, 2, 3], [4, 5, 6], [7, 8, 9]], [[10, 11, 12], [13, 14, 15], [16, 17, 18], [19, 20, 21]], [[22, 23, 24], [25, 26, 27]], ] numbers_split = [ number for numbers_level_two in numbers for numbers_level_three in numbers_level_two for number in numbers_level_three ] print(numbers_split) # -> [1, 2, 3, 4, 5, 6, 7, 8, ..., 27] # Если нам известна вложенность нашей структуры, то мы можем сделать # из неё линейную последовательность.peoples = [ {"name": "", "age": 29}, {"name": "Igor", "age": 27}, {"name": "Petr", "age": 31}, {"name": "Liza", "age": 20}, ] filtered_peoples_names = [ people["name"] if people.get("name") else "Unknown Person" for people in peoples if people["age"] < 30 ] print(filtered_peoples_names) # -> ['Unknown Person', 'Igor', 'Liza'] # Также обратите внимание, что if в конце служит для фильтрации данных, # а if, else в начале для возможности выбора конечного действия над # выбранным объектом. В этом примере мы убрали из конечной выборки всех # кому менее 30 лет. Тех, у кого не было внесено имя, установили # его в "Unknown Person".Допустим, мы разобрались с базовым синтаксисом генератора списков, но что же там насчёт скорости?
def for_() -> list[int]: numbers_squares = [] for i in range(100): numbers_squares.append(i) return numbers_squares def list_comprehension() -> list[int]: return [i for i in range(100)] # python 3.10 print(min(timeit.repeat(list_comprehension, number=100000))) # -> ~0.1477 print(min(timeit.repeat(for_, number=100000))) # -> ~0.2755 # python 3.12 print(min(timeit.repeat(list_comprehension, number=100000))) # ~0.0841 print(min(timeit.repeat(for_, number=100000))) # ~0.1155Обратите внимание какая разница в скорости у генерации списка относительно цикла:
-
python 3.10 ~87%
-
python 3.12 ~37%
Если у вас возник вопрос, почему так сильно сократилась разница в скорости между версиями python? В python 3.12 сильно увеличилась производительность относительно python 3.10 в подобных случаях:
-
list_comprehension ~75%
-
for ~139%
Увеличим объём генерируемых данных в 10 раз и снова проведём замеры:
-
python 3.10 ~40%
-
python 3.12 ~18%
-
list_comprehension ~82%
-
for ~116%
За счёт чего же появляется прирост в скорости?
-
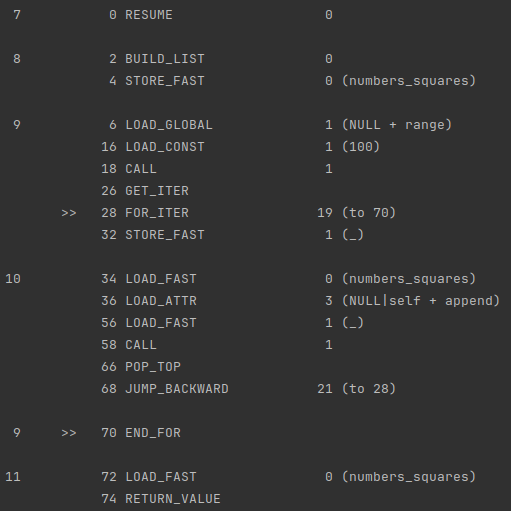
Используя цикл нам, приходится на каждой итерации делать __getattribute__ и call метода append.
-
Создаваемый в цикле список заранее, не знает какое кол-во объектов в нём будет. Поэтому при большом наборе данных, он будет многократно «выниматься» из оперативной памяти, аллоцировать новый увеличенный объём и «вставляться» в новое место. Это достаточно затратная операция, занимающая O(n) времени.
Если вас интересует более глубокий разбор, что же происходит «под капотом», то предлагаю запустить в своём интерпретаторе код подобный этому:
import dis def for_() -> list[int]: numbers_squares = [] for _ in range(100): numbers_squares.append(_) return numbers_squares def list_comprehension() -> list[int]: return [_ for _ in range(100)] print(dis.dis(for_)) print(dis.dis(list_comprehension))Вы получите разобранный машинный код на языке assembler(код отражает действия процессора):
В завершение хочется упомянуть, что кроме генераторов списков, есть так же:
-
Генератор множества
-
Генератор словарей
-
Генератор генераторов 🙂
Работают они все по тому же принципу и тем же правилам.
print({number for number in [1, 2, 1]}) # -> {1, 2} print({name: value for name, value in zip(["one", "two"], [1, 2])}) # -> {'one': 1, 'two': 2} print((x for x in range(10))) # -> <generator object <genexpr> at xxx>
ссылка на оригинал статьи https://habr.com/ru/articles/807389/
Добавить комментарий