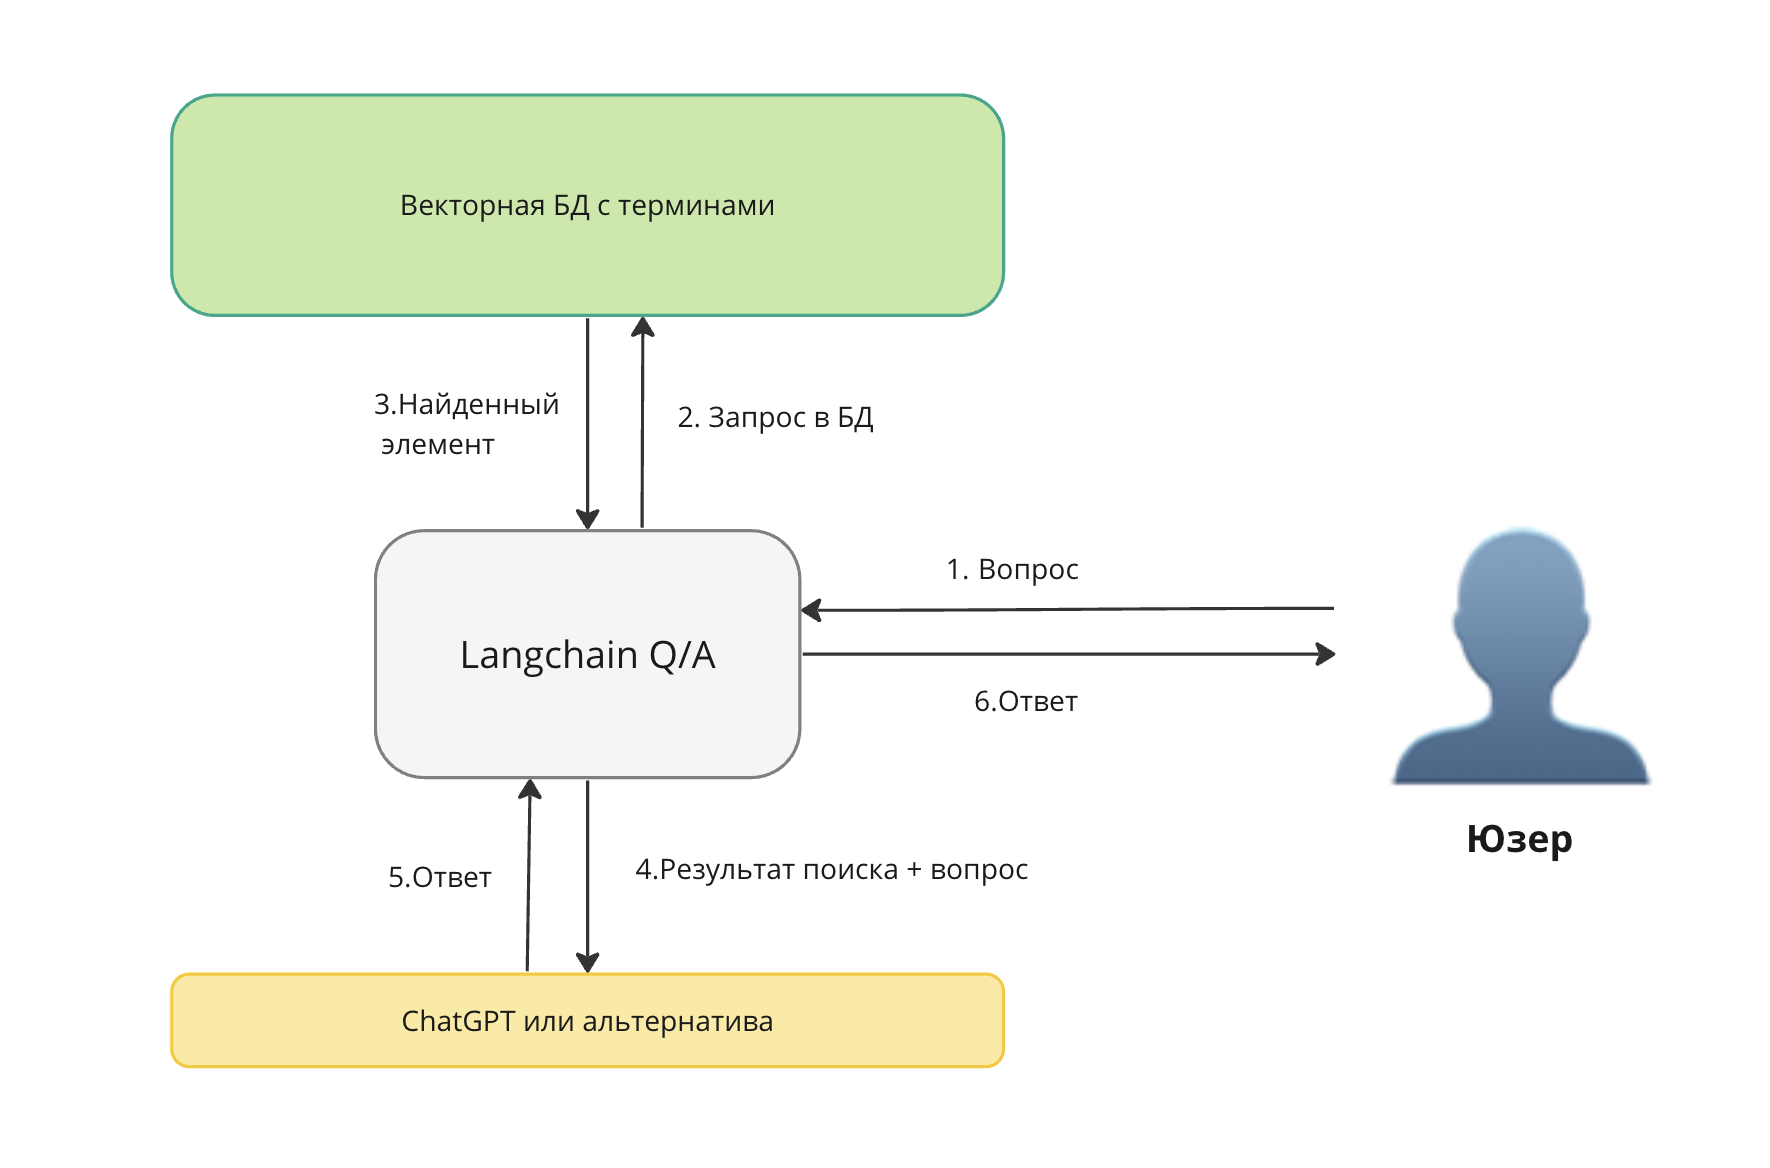
Решил я собрать «по-быстрому» локальный RAG(retrieval augmentation generation), который будет находить термины из словаря Ожегова. Изучив просторы интернета, понял. Все сводится к рецепту (упрощенная интерпретация):
-
Берем нужный нам текст и нарезаем на куски
-
С помощью «эмбеддера» превращаем в эмбеддинги
-
Грузим в векторную БД
-
Цепляем ChatGPT или альтернативу с помощью Langchain
-
Пишем промпт
-
Радуемся
В случае с толковым словарем Ожегова, может быть 2 типа вопросов:
-
По содержимому или значению найти термин
-
Найти термин, что он обозначает
Радовался я не долго. Через время начал понимать, что он путается в терминах во втором типе вопросов. Прошу один термин, а получаю совсем другой. Давайте разбираться почему.
На схеме выше видно. Для ответа используется «результат поиска + вопрос» — нужно проверить, запрос и ответ из БД. Так как мы сами грузим датасет и знаем какой ответ должен быть, то мы можем автоматически проверить, правильно ли нам возвращает векторная БД ответ по нашему запросу.
Готовим данные
Берем нужный нам текст и нарезаем на куски.
import re import pandas as pd with open("ozhegov.txt", mode="r", encoding="UTF-8") as file: text_lines = file.readlines() def return_first_match(pattern, text): result = re.findall(pattern,text) result = result[0] if result else "" return result data = [] for line in text_lines: title = return_first_match(r"^[а-яА-Я]{2,}(?=,)", line) text = return_first_match(r"\.\s([А-Я]+.*)\n", line) if(len(title) > 3): data.append( { "title": title, "text" : text }) dataset = pd.DataFrame(data) dataset.to_csv('ozhegov_dataset.csv') dataset.head()|
title |
text |
|
|---|---|---|
|
0 |
АБАЖУР |
Колпак для лампы, светильника. Зеленый а. 11 п… |
|
1 |
АБАЗИНСКИЙ |
Относящийся к абазинам, к их языку, национальн… |
|
2 |
АБАЗИНЫ |
Народ, живущий в Карачаево-Черкесии и в Адыгее… |
|
3 |
АББАТ |
Настоятель мужского католического монастыря. 2… |
|
4 |
АББАТСТВО |
Католический монастырь. |
Для нашего эксперимента не будем использовать весь датасет, а возьмем только 1000 случайных штук.
#бывают пустые в моем датасете dataset = dataset[dataset['title'].str.len() > 0] dataset = dataset[dataset['text'].str.len() > 0] dataset = dataset.sample(n=1000) dataset.astype({"text": str, "title": str}) dataset.info(show_counts=True) dataset.head()<class 'pandas.core.frame.DataFrame'> Index: 1000 entries, 28934 to 16721 Data columns (total 3 columns): # Column Non-Null Count Dtype --- ------ -------------- ----- 0 Unnamed: 0 1000 non-null int64 1 title 1000 non-null object 2 text 1000 non-null object dtypes: int64(1), object(2) memory usage: 31.2+ KB|
Unnamed: 0 |
title |
text |
|---|---|---|
|
28934 |
УТОЛЩЕНИЕ |
Утолщенное место на чем-н. У. ствола. У. сосуда. |
|
30193 |
ЧЕРНОСОТЕНЕЦ |
В России в нач. 20 в.: член шовинистической ор… |
|
14378 |
НЕПРЕОБОРИМЫЙ |
Такой, что невозможно побороть. Непреоборимая … |
|
27420 |
ТЕРМИЧЕСКИЙ |
Относящийся к применению тепловой энергии в те… |
|
27021 |
СХЕМАТИЗИРОВАТЬ |
Представить (-влять) в виде схемы (во 2 знач.)… |
Превращаем в эмбеддинги
«Эмбеддер» долго не выбирал, воспользовался Рейтинг русскоязычных энкодеров предложений
Про сами векторные БД и как они работают, какие есть — рассказывать не буду. По этому поводу уже написаны статьи. Буду использовать Chroma (топ-1 из этой статьи).
Для чистоты эксперимента, решил взять топ-5 моделей и 3 разные функции расстояния доступные в Chroma
models = [ "intfloat/multilingual-e5-large", "sentence-transformers/paraphrase-multilingual-mpnet-base-v2", "symanto/sn-xlm-roberta-base-snli-mnli-anli-xnli", "cointegrated/LaBSE-en-ru", "sentence-transformers/LaBSE" ] distances = [ "l2", "ip", "cosine" ]Готовим Chroma
Ставим нужные pip пакеты
%pip install -U sentence-transformers ipywidgets chromadb chardet charset-normalizerБывает ошибка с установкой, в самой ошибке есть решение
HINT: This error might have occurred since this system does not have Windows Long Path support enabled. You can find information on how to enable this at https://pip.pypa.io/warnings/enable-long-paths
https://learn.microsoft.com/en-us/windows/win32/fileio/maximum-file-path-limitation?tabs=powershell#enable-long-paths-in-windows-10-version-1607-and-later
Запустим Chroma в Docker
docker pull chromadb/chroma docker run -p 8000:8000 chromadb/chromaФункции для работы с Chroma
Определяем необходимые функции для создания и удаления коллекций. А также функцию для поиска, в которой мы забираем запись минимальной дистанцией + добавляем данных по индексу из датасета. Индексы в БД равны индексам в датасете.
from chromadb.utils import embedding_functions import chromadb chroma_client = chromadb.HttpClient(host="localhost", port=8000) def create_collection(model_name, distance): chroma_client = chromadb.HttpClient(host="localhost", port=8000) sentence_transformer_ef = embedding_functions.SentenceTransformerEmbeddingFunction(model_name=model_name) #в этом эксперименте не будем использовать, нам нужно найти термин #text_collection = chroma_client.create_collection(name='text', embedding_function=sentence_transformer_ef) title_collection = chroma_client.create_collection(name="title", embedding_function=sentence_transformer_ef, metadata={"hnsw:space": distance}) ids = list(map(str, dataset.index.values.tolist())) #text_collection.add(ids = ids, documents=dataset["text"].tolist()) title_collection.add(ids = ids, documents=dataset["title"].tolist()) return title_collection def delete_collection(): chroma_client.delete_collection("title") def query_collection(collection, query, max_results, dataframe, model_name, distance): results = collection.query(query_texts=query, n_results=max_results, include=['distances']) #print(results) df = pd.DataFrame({ 'id':results['ids'][0], 'score':list(map(float,results['distances'][0])), 'query': query, 'title': dataframe[dataframe.index.isin(list(map(int,results['ids'][0])))]['title'], 'content': dataframe[dataframe.index.isin(list(map(int,results['ids'][0])))]['text'], 'model_name': model_name, 'distance': distance }) # Забираем с минимальной дистанцией, значит он ближе и больше похож df = df[df.score == df.score.min()] df['is_found'] = df.apply(lambda row: row.query == row.title, axis=1) return df Формируем тестовый датасет и стартуем
Формируем тестовый датасет из случайных 100 штук из датасета загруженного в Chroma.
test_dataset = dataset.sample(n=100) test_dataset.head() test_results = pd.DataFrame()Запускаем и собираем результаты для каждой модели с разной функцией расстояния.
for model in models: for distance in distances: print(f"{model} - {distance}") try: delete_collection() except Exception as ex: print(f"delete_collection error: {ex}") collection = create_collection(model, distance) for title in test_dataset["title"].tolist(): test_results = test_results._append(query_collection( collection=collection, query=title, max_results=5, dataframe=dataset, model_name=model, distance=distance)) print(f"{len(test_results)}") test_results.to_csv("results_ozhegov2.csv") test_results.head()|
id |
score |
query |
title |
content |
model_name |
distance |
is_found |
|
|---|---|---|---|---|---|---|---|---|
|
10363 |
10363 |
1.315708e-12 |
КОРНИШОНЫ |
КОРНИШОНЫ |
Мелкие недозрелые огурцы, предназначенные для … |
intfloat/multilingual-e5-large |
l2 |
True |
|
8566 |
8566 |
7.252605e-13 |
ИММИГРАНТ |
ИММИГРАНТ |
Человек, к-рый иммигрировал куда-н. II ж. имми… |
intfloat/multilingual-e5-large |
l2 |
True |
|
12175 |
17352 |
1.157366e-12 |
ПЕНСИЯ |
МЕНСТРУАЦИЯ |
Ежемесячные выделения крови из матки женщины (… |
intfloat/multilingual-e5-large |
l2 |
False |
|
18297 |
11029 |
7.939077e-13 |
КУТАТЬ |
ПЛУТАТЬ |
Ходить не зная дороги, блуждать. П. по лесу. |
intfloat/multilingual-e5-large |
l2 |
False |
|
14052 |
5394 |
1.371903e-12 |
ДЕКАДА |
НЕДЕЛЯ |
Единица исчисления времени, равная семи дням, … |
intfloat/multilingual-e5-large |
l2 |
False |
Смотрим результаты
Теперь посчитаем количество найденных (правильных результатов)
finally_result = pd.DataFrame() for model in models: for distance in distances: df = test_results.loc[test_results['model_name'].str.contains(model) == True] df = df.loc[df['distance'].str.contains(distance) == True] finally_result = finally_result._append(pd.DataFrame({ 'founded': [len(df[df['is_found'] == True])], 'model_name': [model], 'distance': [distance] })) finally_result.head(15)|
founded |
model_name |
distance |
|---|---|---|
|
24 |
intfloat/multilingual-e5-large |
l2 |
|
24 |
intfloat/multilingual-e5-large |
ip |
|
24 |
intfloat/multilingual-e5-large |
cosine |
|
17 |
sentence-transformers/paraphrase-multilingual-… |
l2 |
|
0 |
sentence-transformers/paraphrase-multilingual-… |
ip |
|
19 |
sentence-transformers/paraphrase-multilingual-… |
cosine |
|
23 |
symanto/sn-xlm-roberta-base-snli-mnli-anli-xnli |
l2 |
|
25 |
symanto/sn-xlm-roberta-base-snli-mnli-anli-xnli |
ip |
|
21 |
symanto/sn-xlm-roberta-base-snli-mnli-anli-xnli |
cosine |
|
14 |
cointegrated/LaBSE-en-ru |
l2 |
|
14 |
cointegrated/LaBSE-en-ru |
ip |
|
14 |
cointegrated/LaBSE-en-ru |
cosine |
|
14 |
sentence-transformers/LaBSE |
l2 |
|
14 |
sentence-transformers/LaBSE |
ip |
|
14 |
sentence-transformers/LaBSE |
cosine |
Заключение
Собрать «по-быстрому» локальный RAG для работы с терминами пока не удалось и выдать готовый рецепт.
Текущие ~25% — сложно назвать хорошей точностью.
Какие я вижу варианты решения проблемы с точностью:
-
Использовать гибридный поиск c BM25, не все векторные БД его поддерживают
-
Прикрутить в качестве второго ретривера Postgres + BM25 и искать сразу в двух — звучит так себе + дублировать информацию…
-
Тюнить модель, но это уже далеко не «по-быстрому»
-
Поработать с текстом (лемматизация, нормализация и т.п.) — сильно сомневаюсь, что поможет.
Во второй части попробую использовать гибридный поиск
P.S. Буду ждать в комментариях какой вариант еще попробовать, чтобы можно было «по-быстрому» и локально развернуть.
ссылка на оригинал статьи https://habr.com/ru/articles/807957/
Добавить комментарий