На данный момент я работаю с весьма развесистыми проектами (один из них состоит из почти 120 градл модулей) и уже достаточно давно разные факторы подталкивали меня написать статью о том, как я организую свои проекты: стажеры и коллеги, чтение различных статей и книг. Понятное дело, что не существует серебряной пули, но я надеюсь, что эта статья поможет кому-то в понимании, как можно организовывать проекты. Добро пожаловать в комментарии для обмена опытом 🙂
Статью планируется разделить от большего к меньшему — от организации всего проекта до организации UI экранов. Все проекты я создаю с помощью gradle и, соответственно, в рамках статьи слово «модуль» будет обозначать gradle модуль.
Дисклеймер об оригинальности
В этой статье будет много очевидных (казалось бы) вещей — общие части приложения должны быть в общих модулях и прочее такое. Тем не менее, такие вещи важно проговаривать во избежание недопонимания подхода.
Дисклеймер о библиотеках
В своих проектах я, как правило, работаю со своим семейством библиотек:
-
MicroUtils для почти всего, от корутин до репозиториев
-
Krontab для отложенных и периодических задач
-
KSLog для логгирования
-
KTgBotAPI для работы с телеграм ботами
-
Navigation для собственно UI навигации
Это сделано потому, что популярные библиотеки имеют ряд недостатков, часто критичных на моих проектах. Например, если в библиотеке есть баг, который мешает, иногда можно годами ждать его исправления (особенно если он некритичен для большей части пользователей). Аналогично, если нужна какая-то фича в библиотеке — ситуация примерно как с багом, можно хоть PR запилить, он может проваляться в бэклоге неизвестно сколько.
Тем не менее, все эти инструменты базируются на таких понятных и надёжных решениях, как ktor, kotlinx serialization, koin и многих других.
Организация проекта
Проект обычно разделяется на три большие папки: features, client, server. Бывают ситуации, когда нужно разделить типы клиентов и/или типы серверов, и тогда имеет смысл в папках client/server создавать соответствующие подмодули. Пример на диаграмме ниже:
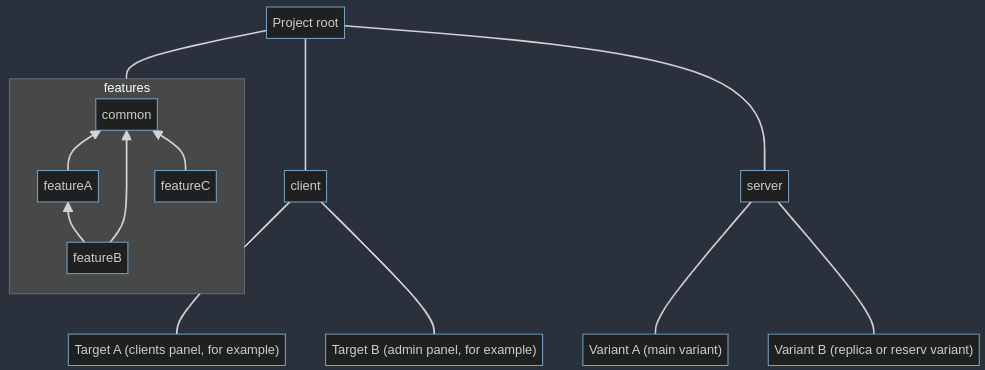
Таким образом, клиенты и серверы никак не зависят друг от друга и могут иметь любой собственный код и способы запуска.
Фичи (модули в папке features) всегда зависят от common и тех фич, которые логически им нужны. В таком случае они не будут зависеть (даже косвенно) от тех частей приложения, которые им не нужны.
В итоге получается, что каждый модуль самостоятелен и располагается в логичном месте, не имея привязок к другим модулям, которые ему не нужны. Это же в итоге помогает IDE понимать, что именно в данном модуле может быть доступно.
Организация фичи
Фича состоит из простых модулей: common, client и server
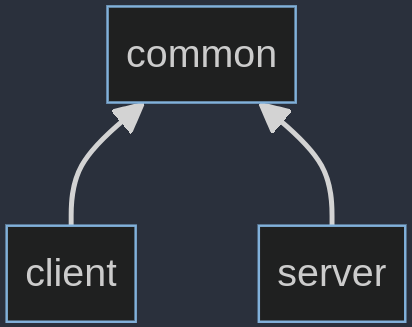
common модуль отвечает за общий код: модели (например, пользователь, токен авторизации и т.д.), базовые инструменты (математика работы с локациями, стандартные преобразования типов). То есть если что-то в рамках фичи будет использоваться и на сервере, и на клиенте, либо не зависит от расположения (та же математика) — оно идёт в common.
client и server зависят от common и, соответственно, отвечают за свои части: репозитории, алгоритмы, UI (в случае клиента), конфигурации запуска.
Поскольку я работаю в основном с KMP, каждый модуль может опционально иметь платформенные или общие сорссеты, контент которых составляется примерно по тем же принципам, что и данное разделение модулей.
Организация UI
В работе мы используем классический MVVM по нескольким причинам:
-
Он очень хорошо расширяется
-
С ним легко следовать общим принципам программирования (общее не зависит от частного и наоборот)
-
Каждый элемент легко объясним с точки зрения его присутствия в цепочке
-
Идеально ложится на большинство UI фреймворков и на сырую работу с UI (тем же html)
Принцип при этом очень простой — View отрисовывает, ViewModel отвечает за выдачу текущего состояния и логику UI части, Model — источник данных.
С точки зрения UI, абсолютно не важно, что находится за Model, поэтому переезды между библиотеками, смена логики какого-то кэширования и прочие не связанные с UI штуки не особо влияют на UI часть как таковую.
Организация DI
В своих проектах мы используем связку Koin + MicroUtils/Startup. Суть очень простая: каждый модуль имеет набор плагинов, каждый из которых может быть тем или иным образом подключен в клиентах и серверах. При этом, как правило, используется следующая диаграмма плагинов:
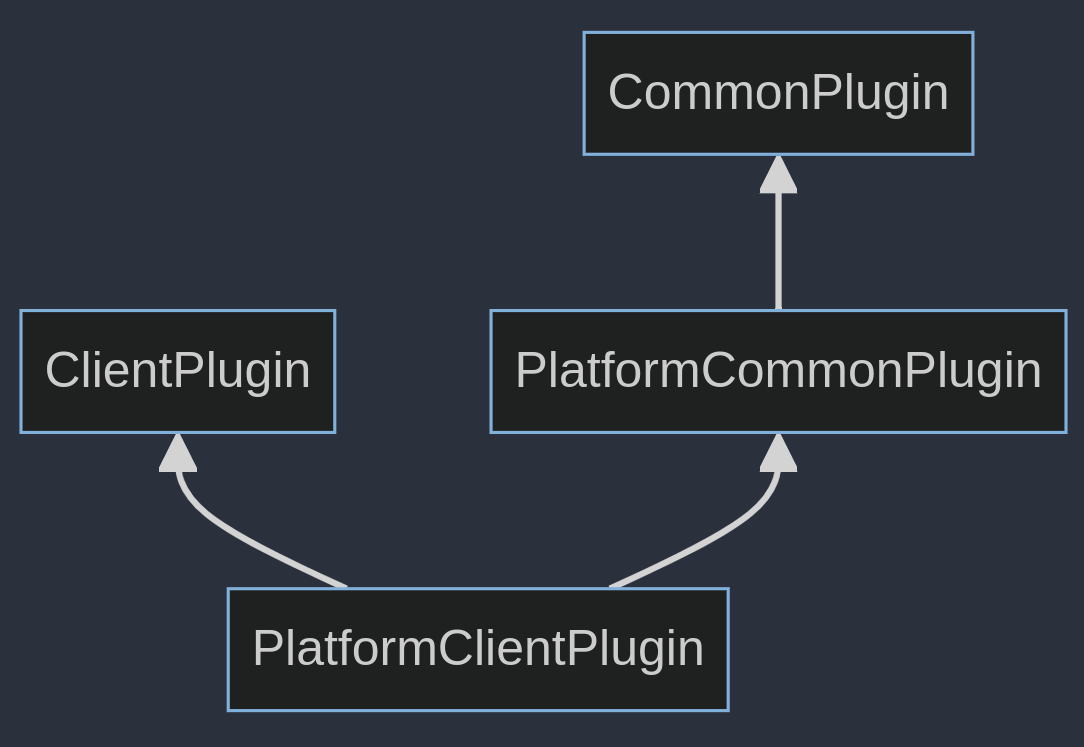
В данной диаграмме Platform соответственно заменяется на, например, JVM/JS/etc., а Client можно заменить на Server для серверных модулей.
При старте сервера, в конфигурации указывается список модулей, которые мы включаем в сервер. Метод старомодный, но работает на 100%, плюс теоретически этот подход легко улучшается с помощью написания соответствующего KSP плагина. Таким же образом работает Client
В плагинах мы имеем две части:
-
Часть инициализации
Koinмодуля — здесь определяются репозитории,ViewModel,Model, фабрикиViewи т.д. -
Часть старта приложения — здесь запускаются серверные и клиентские сервисы, такие как сервисов автоматизации авторизации на клиентах и сборки мусора на сервере
Подведение итогов, или плюсы/минусы этого безобразия
В двух словах, получается следующая структура:
-
Есть фичи. В фичах есть общая фича и все остальные, от неё зависящие. Каждая фича делится на common, server и client
-
Есть клиенты. Модули конечных клиентов зависят от
clientмодулей фичей, но каждый клиент зависит только от тех модулей, которые ему нужны -
Есть серверы. Модули конечных серверов зависят от
serverмодулей фичей, но каждый сервер зависит только от тех модулей, которые ему нужны -
Для DI используем Koin + MicroUtils/startup
-
В UI используем
MVVM.ViewModelиModelрегистрируются вCommonPlugincommonмодуля,Viewрегистрируется и встраивается в UI из модулей на платформах
А теперь пришла пора плюсов и минусов, и начнём мы с минусов:
-
Иногда, особенно в сложных проектах, получается крайне ветвистая структура модулей, что мешает быстро ориентироваться в проекте
-
Много бойлерплейта. Спасает плагин для идеи SegmentGenerator
-
Сложности конфигурирования из-за весьма топорных способов запуска проекта/модуля
А теперь к плюсам:
-
Я еще ни разу не встречал штуку, которую было бы сложно внедрять в проект на такой архитектуре
-
Всегда понятно, где и что нужно искать
-
Обычно не возникает вопросов, что куда нужно положить
-
Благодаря общему следованию принципу
частное зависит от общего, крайне редко возникают какие-то циклические зависимости и прочие схожие проблемы
В следующих статьях я постараюсь рассмотреть всё описанное на примерах
ссылка на оригинал статьи https://habr.com/ru/articles/809287/
Добавить комментарий