Что нового
В прошлой статье я писал о запуске Alpaca на Эльбрусе. На момент написания той статьи оптимизации под Эльбрус не проводились. Однако теперь, благодаря стараниям @troosh можем протестировать Эльбрус уже с оптимизациями. ВНИМАНИЕ! Проект llama.cpp обновляется очень часто, и многое меняется. На данный момент это самая актуальная версия llama.cpp под Эльбрус. Эльбрус 16С поддерживает аппаратную виртуализацию, мне как раз выдали доступ к «виртуалке». Благодарность @shigorin
И сразу тесты
В прошлой статье я уже описал что делал. Поэтому тут я сразу начну с тестов.
Тест проводился следующей командой. Данная команда запрашивает рандомную шутку и подсчитывает время выполнения запроса.
for a in {1..8};do printf "%s;" $a;./main -t $a -m ./models/ggml-alpaca-7b-q4.bin -s 42 -p "Random joke:" -n 32 2>&1 |grep "llama_print_timings: eval time" | cut -d "(" -f 2 | grep -o -e "[0-9\.]*" ;done|
Ryzen 7 5800H |
Эльбрус-16С |
Эльбрус-8СВ |
|
707,81 |
903,02 |
1094,07 |
|
370,47 |
472,6 |
571,45 |
|
258,1 |
330,39 |
398,84 |
|
199,1 |
256,79 |
310,96 |
|
163,97 |
213,01 |
260,76 |
|
140,87 |
184,04 |
226,59 |
|
127,37 |
163,37 |
207,54 |
|
126,05 |
148,54 |
193,7 |
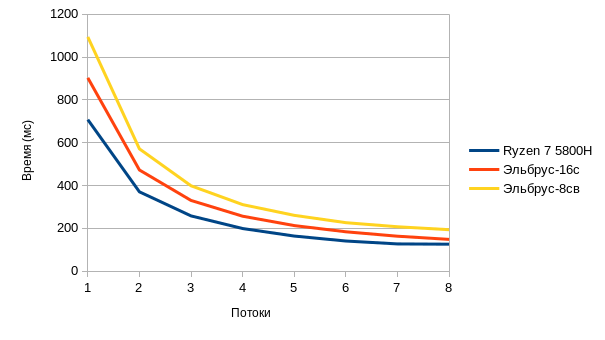
Тесты с оптимизацией и без.
|
Потоки |
Ryzen 7 5800H |
Эльбрус-16С (Оптимизировано) |
Эльбрус-8СВ (Оптимизировано) |
Эльбрус-8СВ 1550MHz |
Эльбрус-16С 2000MHz |
|
1 |
707,81 |
903,02 |
1094,07 |
2542,64 |
2389,05 |
|
2 |
370,47 |
472,6 |
571,45 |
1279,05 |
1225,16 |
|
3 |
258,1 |
330,39 |
398,84 |
915,73 |
823,2 |
|
4 |
199,1 |
256,79 |
310,96 |
710,14 |
638,5 |
|
5 |
163,97 |
213,01 |
260,76 |
575,53 |
513,72 |
|
6 |
140,87 |
184,04 |
226,59 |
487,12 |
438,66 |
|
7 |
127,37 |
163,37 |
207,54 |
419,23 |
380,11 |
|
8 |
126,05 |
148,54 |
193,7 |
375,21 |
342,84 |
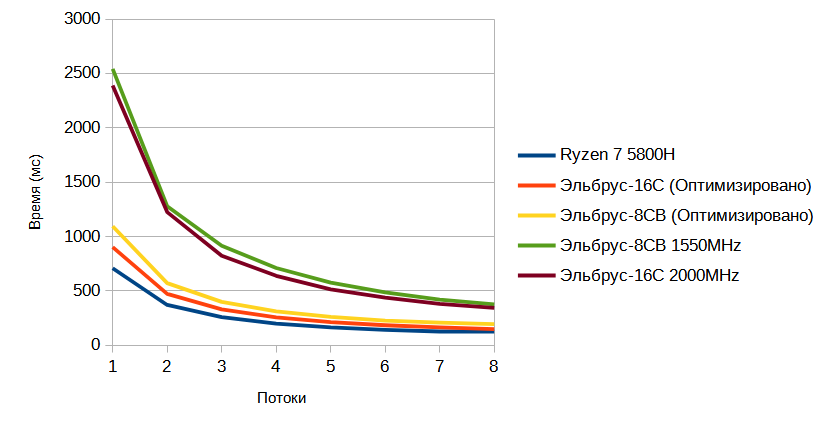
Бенчмарк
Тесты были сделаны при помощи benchmark-q4_0-matmult. Собиралось через команду: make benchmark
|
|
1 поток |
FLOPS_per_u_Second |
|
Ryzen 7 5800H |
3200МГц |
40205.95 |
|
Эльбрус-16С |
2000МГц |
22183.21 |
|
Эльбрус-8СВ |
1550МГц |
17452.88 |
И многопоточный тест
|
|
8 потоков |
FLOPS_per_u_Second |
|
Ryzen 7 5800H |
3200МГц |
255353.06 |
|
Эльбрус-16С |
2000МГц |
161953.14 |
|
Эльбрус-8СВ |
1550МГц |
129111.80 |
До оптимизации результаты были следующими:
|
|
1 поток |
FLOPS_per_u_Second |
|
Ryzen 7 5800H |
3200МГц |
40205.95 |
|
Эльбрус 16С |
2000МГц |
10761.69 |
|
Эльбрус 8СВ |
1550МГц |
7202.17 |
|
|
8 потоков |
FLOPS_per_u_Second |
|
Ryzen 7 5800H |
3200МГц |
255353.06 |
|
Эльбрус 16С |
2000МГц |
82397.41 |
|
Эльбрус 8СВ |
1550МГц |
55424.05 |
Что было сделано
Был оптимизирован код ggml.c под Эльбрус и конкретно под модель Q4_0. Немного пояснений от @troosh. В данной статье тесты проводились на модели Q4_0. При оптимизации использовались интринсики Эльбруса.
Попытался оптимизировать работу в формате Q4_0 для e2k процессоров с 5-й и выше версией системы команд (для тех которые с 128-ми битными регистрами), выкладываю сюда: https://github.com/E2Kports/llama.cpp
Именно в этом формате проверят умножение матриц бенчмарк. А вот используемая в статье модель сконвертирована под Q4_1, на ней ускорения ждать не стоит. Нужно брать модели в Q4_0, либо подождать пока доработаю и этот формат.
А вообще, проект llama.cpp ну очень уж быстро меняется — пришлось пару раз под новые правки подстраиваться…
Ну и небольшой пример кода
#if defined(__e2k__) && __iset__ >= 5 static inline __v2di __attribute__((__always_inline__)) e2k_dot_4_0_8_0_quants(__v2di bx, __v2di by0, __v2di by1) { const __v2di lowMask = __builtin_e2k_qppackdl(0x0f0f0f0f0f0f0f0fLL, 0x0f0f0f0f0f0f0f0fLL); const __v2di bais = __builtin_e2k_qppackdl(0x0808080808080808LL, 0x0808080808080808LL); const __v2di ones = __builtin_e2k_qppackdl(0x0001000100010001LL, 0x0001000100010001LL); // Unpack nibbles into individual bytes __v2di bx0 = __builtin_e2k_qpand( bx, lowMask ); // {HLhl} -> {oLol} __v2di bx1 = __builtin_e2k_qpsrlh( bx, 4 ); // {HLhl} -> {oHLh} bx1 = __builtin_e2k_qpand( bx1, lowMask ); // -> {oHoh} // The output vectors contains 32 bytes, each one in [ 0 .. 15 ] interval // Reorder bytes in "y" block to order in bx0,bx1 __v2di lo = __builtin_e2k_qppermb(by1, by0, __builtin_e2k_qppackdl(0x1e1c1a1816141210LL, 0x0e0c0a0806040200LL)); __v2di hi = __builtin_e2k_qppermb(by1, by0, __builtin_e2k_qppackdl(0x1f1d1b1917151311LL, 0x0f0d0b0907050301LL)); #if __iset__ >= 7 // Move each one in [ -8 .. +7 ] interval: bx0 = __builtin_e2k_qpsubb(bx0, bais); bx1 = __builtin_e2k_qpsubb(bx1, bais); __v2di xy_int32 = __builtin_e2k_qpidotsbwss(bx0, lo, __builtin_e2k_qppackdl(0, 0)); xy_int32 = __builtin_e2k_qpidotsbwss(bx1, hi, xy_int32); #else // Get absolute values of "x" vectors: __v2di ax0 = __builtin_e2k_qppermb(bx0 /* not used */, __builtin_e2k_qppackdl(0x0706050403020100LL, 0x0102030405060708LL), bx0); __v2di ax1 = __builtin_e2k_qppermb(bx1 /* not used */, __builtin_e2k_qppackdl(0x0706050403020100LL, 0x0102030405060708LL), bx1); // Move each one in [ -8 .. +7 ] interval: bx0 = __builtin_e2k_qpsubb(bx0, bais); bx1 = __builtin_e2k_qpsubb(bx1, bais); // Sign the values of the y vectors __v2di sy0 = __builtin_e2k_qpsignb(lo, bx0); __v2di sy1 = __builtin_e2k_qpsignb(hi, bx1); // Perform multiplication and create 16-bit values __v2di dot0 = __builtin_e2k_qpmaddubsh(sy0, ax0); __v2di dot1 = __builtin_e2k_qpmaddubsh(sy1, ax1); // Reduce to 8 int16_t (overflow not possible: 8 bit * 4 bit => 12 bit) __v2di dot = __builtin_e2k_qpaddh(dot0, dot1); // Reduce to 4 int32_t by integer horizontal sums __v2di xy_int32 = __builtin_e2k_qpmaddh(ones, dot); #endif // Convert vector of 4 int32_t to 4 floats return __builtin_e2k_qpistofs(xy_int32); }Из интересного, в данном коде предусматривается работа с Эльбрус V7.
Заключение
На данный момент это лучшие из возможных результаты, в дальнейшем можно сделать оптимизации для модели Q4_1.
Благодаря оптимизациям под архитектуру VLIW можно добиться довольно хороших результатов. С учетом того что Ryzen 7 5800H произведен по техпроцессу 7нм и имеет частоту 3200МГц с ускорением до 4400МГц. А Эльбрус 16с произведен по 16нм техпроцессу и имеет 2000МГц (У 8СВ вообще 1550МГц) результаты вполне неплохие.
ссылка на оригинал статьи https://habr.com/ru/articles/732508/
Добавить комментарий