Распознавание речи — штука довольно прикольная и не очень полезная. С одной стороны голосовой интерфейс для общения с роботами в фантастике является обычным, наверное, годов с 60-х, а с другой стороны — в наше время голосовой интерфейс не продвинулся сильно дальше «Алиса, а какая у нас погода на завтра?«. Для того, чтобы самому составить мнение о текущих возможностях систем распознования речи, я попробовал использовать сервис Deepgram в браузерном приложении. Команда сервиса в ноябре прошлого года привлекла дополнительное финансирование в размере $47 млн. и с оптимизмом смотрит в будущее. Сервис хорош тем, что распознаёт русский язык (не все STT-сервисы это делают), даёт приличный кредит для тестирования возможностей (из 150 промо-денег я израсходовал меньше 0.50 «на поиграться»), не требует серверной части (всё работает из браузера). Готовая демка — тут, детали — под катом.

Deepgram SDK
В основном Deepgram API работает через классические POST-запросы, поэтому использовать его можно хоть через curl:
curl --request POST \ --url 'https://api.deepgram.com/v1/listen' \ --header 'Authorization: Token <YOUR_DEEPGRAM_API_KEY>' \ --header 'content-type: application/json' \ --data '{"url":"string"}'
Но для распознавание речи «на-лету» придётся открывать веб-сокет с сервисом.
Для облегчения взаимодействия с API Deepgram выпустил набор SDK, из которых для браузерного приложения самым полезным представляется Node.js SDK. На самом деле из всего пакета нам понадобится только один файл:
$ npm install @deepgram/sdk $ cp ./node_modules/@deepgram/sdk/dist/browser/index.js ./js/lib/deepgram.browser.sdk.mjs
Всё, что нужно для работы браузера с Deepgram API, находится в этом файле (12.7 кБ). Теперь можно использовать SDK из кода нашего приложения:
import {Deepgram} from './lib/deepgram.browser.sdk.mjs'; const deepgram = new Deepgram(DEEPGRAM_API_KEY);
Авторизация
Для авторизации сервис, не сильно заморачиваясь, использует токен авторизации — DEEPGRAM_API_KEY. Создать токен можно после регистрации в Deepgram (здесь стояла бы реферальная ссылка, если бы у парней была реферальная программа). При регистрации выдаётся $150 для тестов, что хватает примерно на «12,000 free minutes«.
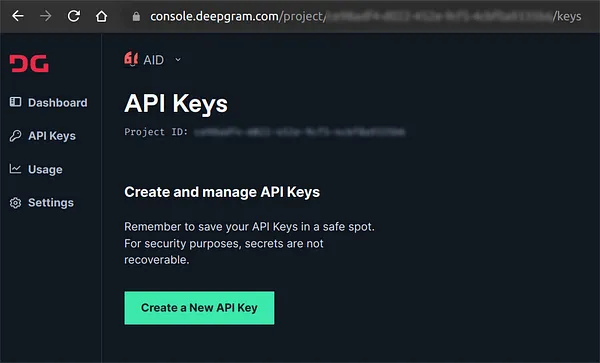
API key выглядит примерно так:
e075dbd73029f939a7a6ba644359f10ebde624b4
Распознавание «на лету»
Для распознавания речи «на лету» нужно выполнить следующую последовательность действий:
- Открыть веб-сокет в Deepgram-сервис и передать ему конфигурационные параметры (как минимум, язык для распознавания).
- Запустить в браузере Media Recorder для записи звука речи.
- Отправлять записываемую речь блоками через сокет в Deepgram.
- Получать и обрабатывать результат распознавания речи.
Вот код для открытия сокета:
import {Deepgram} from './lib/deepgram.browser.sdk.mjs'; const deepgram = new Deepgram(API_KEY); const deepgramSocket = deepgram.transcription.live({language: LANG}); deepgramSocket.addEventListener('open', onSocketOpen); deepgramSocket.addEventListener('message', onSocketMessage);
Код для запуска записи голоса:
navigator.mediaDevices .getUserMedia({audio: true}) .then((stream) => { const mediaRecorder = new MediaRecorder(stream, { mimeType: 'audio/webm', }); mediaRecorder.start(DEF_TIME_SLICE); });
Параметр DEF_TIME_SLICE задаёт время (в миллисекундах), через которое блоки с записью голоса будут отправляться в Deepgram. Я поставил 250 мс (4 блока в секунду), но мне кажется, что такое дробление сказывается на качестве распознавания. Чем больше блок, тем точнее распознаётся текст, но тем больше задержка от начала разговора и до первых результатов распознавания.
Передача блоков в Deepgram:
mediaRecorder.addEventListener('dataavailable', async (event) => { if (event.data.size > 0 && deepgramSocket.readyState === 1) { deepgramSocket.send(event.data); } });
Получение результата:
function onSocketMessage(message) { const received = JSON.parse(message.data); console.log(received); }
Непосредственно распознанный текст находится в:
data.channel.alternatives[0].transcript
Структура результата
Вот типовой ответ от сервиса с результатами распознавания:
{ "channel_index": [0,1], "duration": 2.16, "start": 0, "is_final": true, "speech_final": true, "channel": { "alternatives": [ { "transcript": "This is demo.", "confidence": 0.9929168, "words": [ { "word": "this", "start": 1.2143519, "end": 1.3736111, "confidence": 0.99766505, "punctuated_word": "This" }, { "word": "is", "start": 1.3736111, "end": 1.6523148, "confidence": 0.9929168, "punctuated_word": "is" }, { "word": "demo", "start": 1.6523148, "end": 1.9310185, "confidence": 0.56145895, "punctuated_word": "demo." } ] } ] }, "metadata": { "request_id": "dca09eea-e392-4282-909d-f545f44724fe", "model_info": { "name": "general", "version": "2022-01-18.1", "arch": "vega" }, "model_uuid": "c12089d0-0766-4ca0-9511-98fd2e443ebd" } }
Так как сервис распознаёт речь «на лету», то возможны ошибки распознавания, которые сервис исправляет в последующих ответах. Поэтому в ответе указывается к какому временному промежутку относится данный ответ (атрибуты start и duration), а также «уверенность распознавания» (атрибут confidence). В задачу разработчика, который применяет Deepgram-сервис, входит сопоставление ответов в единый связный текст на основании значенией этих атрибутов. В демке сопоставление отсутствует, текст выводится в том виде, в котором он приходит от сервиса.
Заключение
API Deepgram позволяет веб-разработчикам интегрировать возможности распознавания речи и транскрипции непосредственно в код на стороне браузера. Используя SDK, можно отправлять аудиофайлы или живую речь в API Deepgram для расшифровки и получать обратно текстовое представление речи. Использование услуги относительно не дорого. Deepgram предлагает ряд планов, в том числе бесплатный план, который позволяет обрабатывать аудио до 2 часов в месяц. Платные планы начинаются с 1 доллара за час обработки звука.
В общем, то, о чём писали фантасты в 60-х, оно уже вот тут есть. Причем довольно давно. Распознавание речи можно засунуть в любое веб приложение. Более того, оно есть в каждом современном мобильном телефоне (все эти Сири, Алисы, «ОК, Гугл»). Тем не менее, голосовое взаимодействие с «роботами» всё ещё скорее является экзотикой, чем привычкой. Наверное, у него всё ещё впереди. Ну а пока….
«Алиса, поставь шум дождя, пожалуйста!«
ссылка на оригинал статьи https://habr.com/ru/articles/721668/
Добавить комментарий