Лучшие нейросети для анализа данных 2026 года: разбираем проверенные ИИ для работы с таблицами Excel, сложными PDF-документами, видео и текстом без потери контекста.
Сводить вручную тысячи строк в таблицах Excel или ночами вычитывать 300-страничные отчеты — сомнительное удовольствие. Аналитика превращается в бесконечную рутину, когда из-за одной опечатки рушится сложная математическая модель. Современный анализ данных с помощью ИИ избавляет от этой боли, беря на себя ручную рутину, сверку показателей и математические вычисления. Модели мгновенно вытаскивают факты из файлов любого формата, строят дашборды и показывают аномалии.
Однако не любой чат-бот одинаково полезен. Чтобы выполнение анализа данных радовало точными выкладками, а не галлюцинациями в три часа ночи, важно понимать специализацию конкретных инструментов. Обычный разговорный бот легко запутается в огромной финансовой ведомости. В этом обзоре разберем, какой ии лучше для анализа конкретных бизнес-задач, и как провести полный анализ данных без потери времени.
6 универсальных ИИ для анализа данных
⚡ Claude Sonnet 5 — Эталонный ИИ для обработки текстов, сложной логики и многостраничных отчетов.
📊 ChatGPT 5.6 Sol — Скоростной аналитический движок с песочницей Python для мгновенной обработки выгрузок Excel и визуализации.
🧠 Claude Opus 5 — Мощный флагман от Anthropic для глубинных исследований, аудита и поиска скрытых взаимосвязей.
🚀 Gemini 3.6 Flash — Мультимодальный молниеносный инструмент от Google для разбора видео, аудиозаписей и графических отчетов.
🤖 Claude Fable 5 — Автономный агентский ИИ для многодневных комплексных проектов с функцией самопроверки расчетов.
📂 Kimi K 2.6 — Производительный сервис с огромным контекстным окном для экспресс-сводки по гигабайтным файловым архивам.
—-
Сравнительный анализ лучших ИИ для работы с данными
Выбор подходящей нейросети напрямую зависит от формата исходных файлов и глубины требуемых вычислений. Для работы с таблицами Excel и написания кода вычислений оптимален ChatGPT 5.6 Sol с встроенным Python-интерпретатором, тогда как разбор видеозаписей и графических отчетов эффективнее поручить мультимодальному Gemini 3.6 Flash. Для глубокого юридического аудита, синтеза многотомных архивов и автономных исследований незаменимы модели семейств Claude и Kimi K 2.6 с окном контекста до 2 млн токенов. Ниже представлена сводная таблица параметров, которая поможет быстро подобрать инструмент под конкретный аналитический стек.
|
Нейросеть |
Главная специализация |
Объем контекста |
Поддерживаемые форматы |
Скорость работы |
Защита от ошибок и ключевая фича |
Рекомендуемый бизнес-кейс |
|
Claude Sonnet 5 |
Анализ текста, отчетов и сложных логических связей |
200K – 1M токенов |
TXT, PDF, DOCX, код |
Высокая (~60–80 токенов/сек) |
Строгое соблюдение структуры, генерация в JSON/Markdown, цитирование источников |
Юридический аудит договоров, составление резюме маркетинговых исследований |
|
ChatGPT 5.6 Sol |
Обработка таблиц Excel, выгрузок CSV и математика |
128K+ токенов |
XLSX, CSV, TSV, скриншоты таблиц |
Очень высокая (песочница Python) |
Выполнение расчетов в изолированном коде, исключающее математические фантазии |
Расчет финансовых моделей, очистка баз от аномалий, построение графиков |
|
Claude Opus 5 |
Глубокая стратегическая аналитика и аудит документов |
1 000 000 токенов |
PDF, DOCX, CSV, TXT |
Средняя (углубленные рассуждения) |
Высший уровень понимания причинно-следственных связей без утери деталей на 100+ страницах |
Комплексный анализ финансовой отчетности, научный синтез и сводки для топ-менеджмента |
|
Gemini 3.6 Flash |
Мультимодальный анализ видео, аудио, схем и сканов |
До 2 000 000 токенов |
MP4, MP3, PNG, JPG, PDF, CSV |
Максимальная (ультрабыстрая) |
Нативное «зрение» и «слух», привязка выжимки к таймкодам медиафайлов |
Разбор видеовебинаров, расшифровка созвонов, анализ инфографики и чеков |
|
Claude Fable 5 |
Автономные многоэтапные исследования (Агентский ИИ) |
1 000 000 токенов |
PDF, базы данных, текст, код |
Умеренная (циклы самопроверки) |
Самостоятельная валидация гипотез, перепроверка кода и исправление ошибок до ответа |
Сквозные исследования рынка под ключ, автономный аудит реестров данных |
|
Kimi K 2.6 |
Парсинг гигантских архивов файлов и библиотек |
До 2 000 000 токенов |
PDF, DOCX, XLSX, EPUB, сканы |
Высокая |
Удержание сверхдлинного контекста без проседания внимания в середине файла |
Извлечение сущностей из корпоративных архивов, мгновенный скан книг и регламентов |
—-
Claude Sonnet 5 — точный анализ текста и отчетов
Claude Sonnet 5 сочетает высокую точность рассуждений с высокой скоростью обработки текстовых массивов. Сервис отлично справляется с распутыванием сложной терминологии и пониманием контекста в длинных документах. Это практичный выбор, если нужно превратить 200 страниц хаотичного текста в структурированный документ.
-
Сквозной анализ сложных юридических договоров и выявление скрытых финансово-правовых рисков для бизнеса.
-
Обработка объемных маркетинговых исследований и составление структурированного резюме по ключевым метрикам.
-
Сравнение нескольких текстовых документов с выделением фактических расхождений и редких логических противоречий.
-
Экспресс-подготовка емких аналитических записок на основе массивных первичных отчетов.
Модель легко держит в памяти от 200 000 до 1 000 000 токенов контекста без потери фокуса на деталях. Это означает способность единовременно удержать в уме целый массив корпоративных отчетов, гарантируя, что финальный анализ текста через ии не упустит ни одного мелкого примечания со страницы 150.
Возможности Claude Sonnet 5 для анализа данных
-
Интеллектуальный анализ текста с помощью ии и вычленение главных фактов.
-
Пошаговая нейросеть для анализа документов с автопоиском противоречий.
-
Автоматическая генерация сжатых аннотаций и выжимок из файлов.
-
Преобразование неструктурированных заметок в опрятный формат Markdown или JSON.
-
Эффективный ии для анализа текста при подготовке маркетинговых отчетов.
Сервис принимает обычный текст, файлы TXT, PDF, DOCX и сниппеты кода. Работает очень бодро: средняя скорость генерации составляет около 60–80 токенов в секунду. Вымышленные факты встречаются крайне редко благодаря строгой архитектуре модели. Для полной защиты от ошибок достаточно попросить алгоритм цитировать фрагменты исходного текста при кастомной сборке вывода.
Запустить Claude Sonnet 5 для анализа текста и отчетов
—-
ChatGPT 5.6 Sol — экспресс-обработка таблиц и Excel
ChatGPT 5.6 Sol оптимизирован для математических задач и работы со структурированными числовыми данными. Встроенная среда выполнения кода позволяет боту писать скрипты на Python прямо в процессе диалога. Это избавляет от ситуаций, когда Excel отваливается на 100-й тысяче строк.
-
Глубокий анализ таблиц Excel и сложных массивов данных формата CSV с построением визуализаций.
-
Автоматическая очистка баз данных от дубликатов, пропусков и аномальных значений в выгрузках.
-
Быстрый расчет сложных финансовых показателей, регрессионных моделей и визуализация трендов.
-
Автоматическая генерация интерактивных графиков и диаграмм для презентаций на основе табличных файлов.
Благодаря большой емкости контекстного окна модель с легкостью обрабатывает многомегабайтные книги Excel. Данные не пропадают из памяти при выполнении последовательных математических операций, что критически важно для построения сквозных воронок продаж.
Возможности ChatGPT 5.6 Sol для анализа данных
-
Автоматический ии для анализа excel с генерацией формул и функций.
-
Высокоточный ии для анализа таблиц excel любой степени вложенности.
-
Генерация интерактивных графиков, гистограмм и тепловых карт по затребованным критериям.
-
Мгновенное объединение нескольких разрозненных таблиц по общему ключу.
-
Специализированная нейросеть для анализа таблиц с функцией поиска статистических аномалий.
-
Расширенная ии для аналитика данных обработка со сведением ключевых показателей в сводный отчет.
Модель работает со всеми видами таблиц XLSX, CSV, TSV, а также принимает скриншоты отчетов. Расчеты занимают буквально секунды, так как обработка вычислений происходит в песочнице через Python. Чтобы исключить математический галлюцинаторный синдром, заставляйте систему выводить исходный код расчетов в отчете.
Попробовать ChatGPT 5.6 Sol для анализа таблиц
—-
Claude Opus 5 — глубокая аналитика сложных документов
Claude Opus 5 занимает лидирующие позиции по уровню интеллекта среди моделей Anthropic. Алгоритм создан для задач, где требуются не просто поверхностные выжимки, а глубокие стратегические рассуждения. Если вам нужен полный анализ данных с разбором скрытых причинно-следственных связей, этот сервис справится отлично.
-
Комплексный анализ документов финансового планирования и аудиторских отчетов международных компаний.
-
Синтез научных публикаций с выведением обоснованных гипотез и систематизацией эмпирических выкладок.
-
Выявление глубоких скрытых корреляций в многостраничных текстовых выгрузках и законодательных актах.
-
Формирование многоуровневых аналитических отчетов для руководства на основе десятков разнородных источников.
Контекстный лимит в 1 000 000 токенов разрешает загружать целые библиотеки технической документации. Модель безупречно сохраняет логическую нить, благодаря чему при перекрестном сопоставлении ста страниц информации не теряется ни одна ключевая деталь.
Возможности Claude Opus 5 для анализа данных
-
Многоуровневый ии анализ ситуации в условиях неопределенности и фрагментарных данных.
-
Качественный ии для анализа рынка с глубокой сегментацией конкурентов и трендов.
-
Надежная нейросеть для анализа информации из массивных корпоративных баз.
-
Пошаговая выжимка смыслов из сложных юридических и академических отчетов.
-
Автоматическая сборка аналитических сводок с высокой информационной плотностью.
Алгоритм отлично принимает тексты, файлы PDF, DOCX и таблицы в формате CSV. Из-за глубины рассуждений скорость работы чуть ниже, чем у младших версий, но качество ответа компенсирует ожидание. Чтобы предотвратить фантазии бота, используйте жесткий ролевой промпт с требованием опираться только на загруженные факты.
Открыть Claude Opus 5 для аналитики документов
—-
Gemini 3.6 Flash — мультимодальный анализ видео и медиа
Gemini 3.6 Flash от Google выделяется впечатляющей скоростью и нативной мультимодальностью. Инструмент способен смотреть видео, распознавать схемы на графиках и одновременно вычитывать тысячи страниц текста. В режиме реального времени он выдает краткую суть без задержек.
-
Быстрый анализ видеозаписей вебинаров, фокус-групп и видеопрезентаций для выжимания ключевой сути.
-
Обработка графических отчетов, инфографики и сканированных рукописных документов без потери качества.
-
Экспресс-сверка визуальных данных с текстовыми спецификациями и длинными техническими регламентами.
-
Мгновенный поиск фрагментов по таймкодам в длинных видеофайлах и аудиозаписях созвонов.
Огромное контекстное окно даёт возможность скармливать сервису многочасовые видеозаписи или целые папки с PDF-отчетами. Модель вытягивает данные без потери точности как с первой, так и с последней минуты загруженного файла.
Возможности Gemini 3.6 Flash для анализа данных
-
Скоростной ии для анализа видео с таймкодами и разбором ключевых тезисов.
-
Точная нейросеть для анализа видео и аудиоматериалов любой длительности.
-
Высокоточный ии для анализа изображений, схем, диаграмм и отсканированных чеков.
-
Продвинутый анализ видео с помощью ии для автоматического создания протоколов встреч.
-
Эффективная нейросеть для анализа изображений с функциями распознавания текста (OCR).
Инструмент работает с файлами MP4, MP3, PNG, JPG, PDF и CSV. Модель показывает высокую скорость генерации. Для исключения ошибок с таймкодами видео просите бота дополнительно приводить контекст фразы, сказанной спикером в ролике.
Провести анализ видео и медиафайлов через Gemini 3.6 Flash
—-
Claude Fable 5 — автономный ИИ для исследований
Claude Fable 5 — автономный исследовательский агент от Anthropic, созданный для многоэтапной аналитики. Алгоритм умеет сам планировать шаги, проверять собственные гипотезы и исправлять ошибки в расчетах до выдачи финального ответа. Это цифровой аналитик для решения нестандартных задач.
-
Проведение автономных многоэтапных маркетинговых исследований рынка с автоматической проверкой гипотез.
-
Сквозной аудит больших реестров данных с генерацией итоговых экспертных заключений и отчетов.
-
Самостоятельная сборка и структурирование разрозненных фрагментов информации из десятков файлов.
-
Автоматическая разработка системных выводов и аналитических отчетов под ключ с минимальным контролем.
Контекст в 1 000 000 токенов в сочетании со встроенной функцией самопроверки исключает риск потери данных в длительных сессиях. Бот помнит историю промежуточных шагов и не сбивается с курса при сложных рассуждениях.
Возможности Claude Fable 5 для анализа данных
-
Мощная нейросеть для аналитика данных с авто-валидацией промежуточных результатов.
-
Глубокий ии аналитика данных с автоматическим форматированием финальных итогов.
-
Умный ии для вывода из текста на основе многофакторного анализа.
-
Профессиональная нейросеть для генерации вывода по сложным массивам информации.
-
Эффективный ии для написания выводов и рекомендаций для топ-менеджмента.
Принимает все текстовые форматы, коды программ, базы данных и PDF-файлы. Работает размеренно, так как совершает внутренние циклы проверки перед ответом. Чтобы избежать отказа от выполнения сложных задач, ставьте предельно конкретные рамки и указывайте конечный ожидаемый результат.
Claude Fable 5 для сложного анализа данных
—-
Kimi K 2.6 — экспресс-разбор гигантских архивов файлов
Kimi K 2.6 от компании Moonshot AI — один из лидеров по работе с гигантскими объемами текстовой и табличной информации. Сервис спроектирован для мгновенной обработки целых архивов документов без проседания по качеству. Он станет спасением, когда нужно разобрать сотни файлов за один заход.
-
Обработка гигантских библиотек отчетов, корпоративных регламентов и многотомной технической документации.
-
Извлечение структурированных сущностей из огромных файловых архивов и многостраничных табличных массивов.
-
Оперативный анализ текстов большого объема с формированием сжатых выжимных конспектов.
-
Поиск точных фактов и цифр в толще разнородной документации без предварительного форматирования.
Гигантское окно контекста до 2 000 000 токенов позволяет загрузить целый архив компании. Инструмент удерживает детали по всему массиву, находя связи между первыми и последними страницами загруженных документов.
Возможности Kimi K 2.6 для анализа данных
-
Скоростная нейросеть для анализа файлов любого объема и формата.
-
Универсальный ии для анализа файлов для выжимки фрагментов и ключевых фактов.
-
Комплексный ии для анализа информации в многоязычных файловых библиотеках.
-
Структурирование хаотичных текстовых сканов и отчетов в аккуратные таблицы.
-
Генерация емких сводок по огромным текстовым выгрузкам без потери деталей.
Поддерживает загрузку PDF, DOCX, TXT, XLSX, EPUB и сканов файлов. Ответы генерируются с высокой скоростью. Чтобы защититься от смешения данных при анализе нескольких файлов, четко указывайте имя нужного документа в промпте.
Kimi K 2.6 для работы с файлами и большими текстами
—-
Gemini 3.1 Pro — мультимодальный анализ текстов и отчетов
Gemini 3.1 Pro — флагманская модель от Google с глубоким аналитическим мышлением и окном контекста до 1-2 миллионов токенов. Сервис мгновенно обрабатывает сотни страниц документации, фрагменты кода и сканы. Это сильный инструмент для тех, кто хочет ускорить подготовку отчетов без долгой ручной сортировки.
-
Сквозной анализ сложных финансовых отчетов и выявление расхождений в данных за несколько лет.
-
Обработка длинных научных и бизнес-документов с моментальной генерацией сжатых смысловых выжимок.
-
Сопоставление множественных источников информации и подготовка итоговой аналитической записки.
-
Поиск скрытых логических противоречий в длинных договорах, спецификациях и регламентах.
Модель способна проглатывать целиком массивы объемом более 1 000 000 токенов, что эквивалентно тысяче страниц текста. При таком объеме информации сохраняется точная логика, и алгоритм не теряет факты, расположенные в самом начале или серединной части файла.
Возможности Gemini 3.1 Pro для анализа данных
-
Мощный ии для анализа текста и многостраничных отчетов.
-
Точная нейросеть для анализа документов с поддержкой сложной структуры.
-
Качественный анализ текста с помощью ии для составления выжимок и рефератов.
-
Эффективный ии для анализа информации в разнородных файловых библиотеках.
-
Сквозной анализ текста через ии с выделением ключей и метрик.
Принимает текстовые файлы, PDF, HTML, таблицы и фрагменты программного кода. Скорость ответа держится на высоком уровне, выдавая результаты за считанные секунды. Чтобы минимизировать риск ошибок при разборе цифр, запрашивайте выведение прямой цитаты или ссылки на страницу исходника.
Тестировать Gemini 3.1 Pro для аналитики
—-
Tableau AI — корпоративная визуализация и BI-аналитика
Tableau AI интегрально встроен в экосистему Salesforce, предлагая функции Tableau Pulse и Einstein Trust Layer. Платформа превращает сложнейшие корпоративные базы в наглядные интерактивные дашборды. Это стандарт для крупных предприятий, где визуализация напрямую влияет на принятие стратегических решений.
-
Автоматическое построение интерактивных витрин данных и дашбордов для топ-менеджмента компании.
-
Преобразование текстовых вопросов пользователей в готовые визуальные графики и диаграммы.
-
Непрерывный мониторинг ключевых показателей бизнеса с автоматической отправкой алертов в мессенджеры.
-
Прогнозирование трендов продаж и выявление отклонений в корпоративных базах данных.
Сервис опирается на распределенные семантические модели корпоративного уровня, обрабатывая миллиарды строк информации из хранилищ Snowflake или BigQuery. Контекст держится на уровне корпоративной архитектуры данных, избегая усечения массивов при анализе.
Возможности Tableau AI для анализа данных
-
Автоматизированный ии аналитика данных для корпоративного сегмента.
-
Продвинутый ии для анализа рынка и продаж с динамической визуализацией.
-
Мощная нейросеть для аналитики показателей на интерактивных дашбордах.
-
Использование безналогового слоя безопасности Einstein для защиты конфиденциальных отчетов.
-
Генерация текстовых пояснений к графикам с помощью встроенного агента.
Работает с подключаемыми СУБД, SQL-базами, облачными хранилищами и файлами Excel/CSV. Ответы генеративного агента формируются оперативно, однако первичная подготовка связей требует времени. Исключение галлюцинаций достигается благодаря жесткой привязке к проверенной структуре семантической модели.
Изучить возможности Tableau AI на официальном сайте
—-
Find Anomaly — прозрачная аналитика для маркетологов и БД
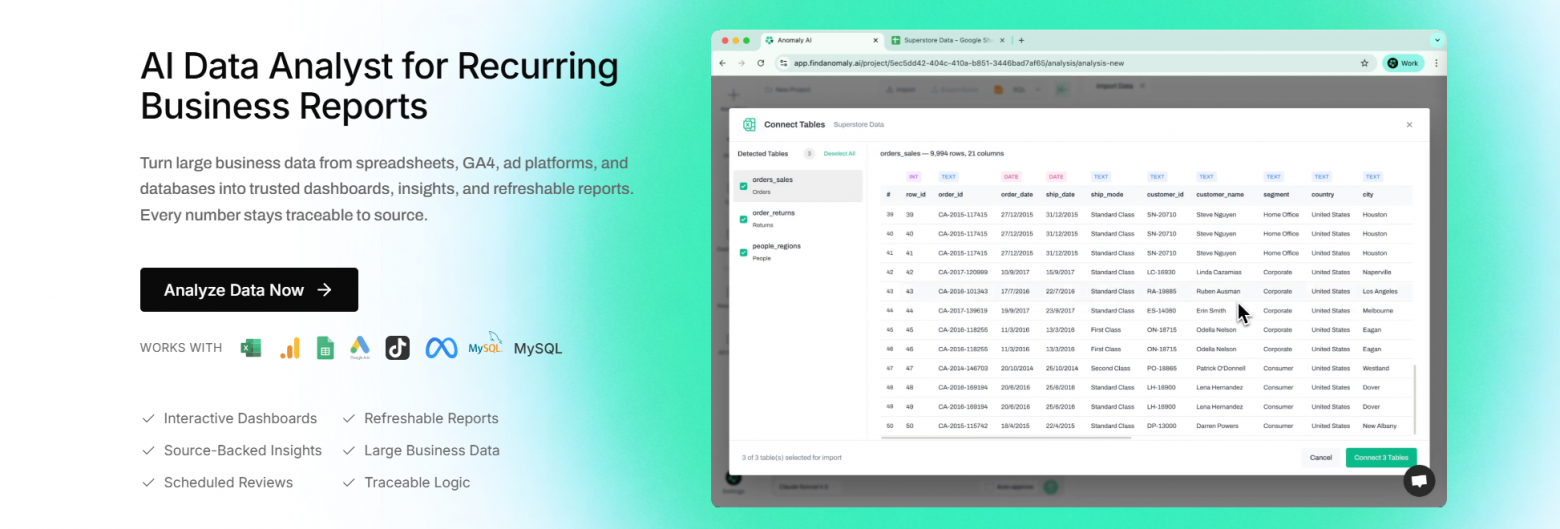
Find Anomaly (Anomaly AI) позиционируется как рабочее место ИИ-аналитика с полной прозрачностью логики. Сервис умеет работать с выгрузками Excel, Google Analytics 4 (GA4), рекламными кабинетами и SQL-базами. Главная фича — возможность в любой момент проверить код и формулы, стоящие за каждым графиком.
-
Анализ рекламных кампаний и сквозной аналитики из GA4 с пошаговой проверкой формул.
-
Автоматическая сборка готовых презентаций в PowerPoint и отчетов в PDF из сырых выгрузок.
-
Быстрый поиск аномалий и просадок в конверсиях с помощью прозрачных SQL-запросов.
-
Настройка регулярных отчетов с авто-отправкой по расписанию для клиентов и команды.
Инструмент обрабатывает таблицы и базы объемом в миллионы строк, используя подключения к BigQuery или Snowflake. Модель держит структуру проекта и связку показателей в активном контексте, что предупреждает логические расхождения при построении итоговых отчетов.
Возможности Find Anomaly для анализа данных
-
Наглядный ии для анализа таблиц excel и баз данных без черных ящиков.
-
Специализированная нейросеть для анализа таблиц и конверсий веб-аналитики.
-
Генерация интерактивных дашбордов и выгрузка отчетов в PowerPoint и PDF.
-
Сквозной ии анализ ситуации с автоматическим выявлением аномальных отклонений.
-
Проверка прозрачности расчетов и выведенных логических формул.
Принимает XLSX, CSV, выгрузки GA4, MySQL, Snowflake и BigQuery. Анализ проходит за секунды, а главное преимущество — отсутствие эффекта черного ящика. Потеря точности исключена, так как пользователь может кликнуть на любую цифру и увидеть чистый SQL/Python код расчетов.
Find Anomaly для прозрачной аналитики данных
—-
Domo — облачная BI-платформа с ИИ-ассистентом
Domo представляет собой облачную экосистему для бизнес-аналитики с встроенным набором функций Domo.AI. Платформа специализируется на объединении сотен разрозненных источников информации в единую управленческую панель. Инструмент ориентирован на оперативную аналитику для топ-менеджеров и операционных команд.
-
Интеграция сотен разрозненных бизнес-источников в единый автоматизированный дашборд.
-
Генерация мобильных отчетов и алертов по изменению показателей в режиме реального времени.
-
Создание управляемых пайплайнов данных с автоматической очисткой и трансформацией.
-
Формирование управленческой отчетности для директоров с возможностью уточняющих диалогов.
Благодаря облачной инфраструктуре Domo легко переваривает огромные массивы данных enterprise-уровня. Контекст сохраняется в течение всей жизни бизнес-модели, обеспечивая бесшовную синхронизацию между мобильным приложением и десктопной аналитикой.
Возможности Domo для анализа данных
-
Автоматизированный полный анализ данных для крупных корпоративных платформ.
-
Мощный ии для аналитика данных с функциями предиктивной аналитики.
-
Построение интерактивных виджетов и графиков с помощью текстовых запросов.
-
Использование сквозных контролей доступа и безопасности бизнес-информации.
-
Автоматическая рассылка сводок и аномальных показателей руководству.
Поддерживает свыше 1000 готовых коннекторов к ERP, CRM, SQL-базам и рекламным сервисам. Обработка запросов происходит почти мгновенно за счет облачных мощностей. Встроенные протоколы валидации исключают выдуманные цифры, связывая выводы с первоисточниками.
Перейти на официальный сайт Domo
—-
ThoughtSpot — поисковая и агентская аналитика данных
ThoughtSpot меняет подход к BI, предлагая концепцию Search-Driven Analytics на базе диалогового агента Spotter. Пользователю не нужно рисовать схемы вручную — достаточно ввести вопрос в строку поиска обычным языком. Сервис сам сгенерирует SQL-запрос, построит график и даст текстовую расшифровку.
-
Поисковая аналитика по корпоративным базам данных на естественном человеческом языке.
-
Автоматическое выявление скрытых факторов и причин изменения бизнес-метрик.
-
Создание динамических интерактивных Liveboards из результатов обычных поисковых запросов.
-
Интеграция поисковой аналитики в сторонние веб-сервисы и мобильные приложения.
Сервис подключается напрямую к облачным хранилищам данных и оперирует контекстом в миллиарды записей. За счет прямого исполнения запросов в источнике точность аналитических выкладок остается максимальной независимо от объема базы.
Возможности ThoughtSpot для анализа данных
-
Продвинутый ии для анализа информации с использованием естественного языка.
-
Поисковая нейросеть для аналитики продаж и финансовых показателей компании.
-
Мощный ии для анализа рынка с глубокой детализацией до конкретной транзакции.
-
Автоматическое построение графиков через инструмент SpotIQ без программирования.
-
Высокая точность трансляции текста в SQL-код для хранилищ BigQuery и Snowflake.
Принимает подключения к Snowflake, Databricks, Redshift, Google BigQuery и файлам Excel. Скорость формирования ответа составляет 2–5 секунд. Встроенная модель проверки естественного языка защищает от неверного толкования терминов, показывая пользователю точный логический SQL-запрос.
Оценить поисковую аналитику ThoughtSpot
—-
DataRobot — автоматическое машинное обучение и AutoML
DataRobot представляет собой корпоративную платформу для проектирования, обучения и развертывания моделей машинного обучения. Сервис автоматизирует работу дата-сайентистов, позволяя за считанные минуты строить предиктивные модели по сырым данным. Это решение для компаний, желающих внедрить ML-прогнозирование без наема штата разработчиков.
-
Автоматическое построение и сравнение десятков предиктивных ML-моделей на основе сырых данных.
-
Прогнозирование оттока клиентов, спроса на товары и финансовой надежности контрагентов.
-
Мониторинг качества развернутых моделей машинного обучения и выявление деградации данных.
-
Автоматический инжиниринг признаков и подготовка данных к обучению.
DataRobot работает с гигантскими массивами данных объемом в сотни гигабайт. Система сохраняет метаданные всех проведенных экспериментов, обеспечивая полную воспроизводимость результатов и прозрачность каждой метрики.
Возможности DataRobot для анализа данных
-
Автоматизированный полный анализ данных с использованием продвинутого AutoML.
-
Высокоточный ии для анализа таблиц и строковых баз с целью прогнозирования.
-
Профессиональная нейросеть для аналитика данных с функцией пояснения решений.
-
Мониторинг и управление жизненным циклом моделей в рамках MLOps и LLMOps.
-
Автоматическое выявление аномалий и факторов риска в реальном времени.
Сервис принимает структурированные таблицы CSV, Parquet, выгрузки из SQL и HDFS. Обучение моделей занимает от пары минут до получаса в зависимости от размера датасета. Модель устраняет галлюцинации благодаря опоре на строгие статистические алгоритмы и машинное обучение вместо чистой генерации текста.
Узнать больше о возможностях AutoML платформы DataRobot
—-
Julius AI — диалоговый Python-аналитик для файлов
Julius AI — популярный сервисный бот, выступающий в роли персонального дата-аналитика. Пользователь загружает файл, а ИИ пишет и выполняет Python или R код в изоляции, выдавая готовые графики, статистику и выводы. В режиме vibe-analytics инструмент решает задачи любой сложности за пару сообщений.
-
Быстрый экспресс-анализ файлов Excel и CSV с созданием визуализаций любой сложности.
-
Проведение статистических тестов, регрессионного анализа и гипотез на датасетах.
-
Автоматическая очистка таблиц от пустых значений, дубликатов и некорректных форматов.
-
Сборка презентаций и слайдов с диаграммами по итогам проведенного исследования.
Платформа поддерживает обработку датасетов размером до 32 ГБ, а изолированные контейнеры держат контекст диалога на протяжении всей сессии. Вы можете делать десятки уточняющих запросов, не опасаясь, что бот забудет начальные условия.
Возможности Julius AI для анализа данных
-
Удобный ии для анализа таблиц excel с помощью текстовых команд.
-
Эффективная нейросеть для анализа таблиц и статистических данных.
-
Автоматическое построение более 40 видов кастомных графиков и диаграмм.
-
Наглядный ии для вывода из текста и числовых рядов с пояснениями.
-
Запуск Python и R кода в безопасном контейнере для математической точности.
Принимает файлы CSV, XLSX, Google Sheets, PDF и изображения таблиц. Выполнение кода занимает 5–15 секунд. Ошибки в расчетах исключены, так как математика считается интерпретатором Python, а пользователь в любой момент может развернуть блок и проверить исполняемый код.
Попробовать Julius AI для быстрого анализа таблиц
—-
Power BI — корпоративный стандарт BI с Copilot
Microsoft Power BI — признанный мировым рынком лидер в области корпоративной аналитики. В сочетании с Copilot платформа позволяет писать сложные формулы DAX, собирать дашборды из текстовых описаний и генерировать текстовые пояснения. Отличный выбор для бизнеса, уже работающего в экосистеме Microsoft 365.
-
Построение сложных корпоративных отчетов и сквозной аналитики из десятков источников.
-
Автоматическая генерация формул DAX и мер с помощью интегрированного Copilot.
-
Подготовка быстрых текстовых выжимок и ключевых итогов для управленческих отчетов.
-
Публикация интерактивных дашбордов с разграничением прав доступа для отделов.
Power BI оперирует корпоративными моделями данных любого масштаба, интегрируясь с Microsoft Fabric. Модель контекста фиксируется на уровне семантического слоя, сохраняя связи между таблицами и справочниками без потери качества.
Возможности Power BI для анализа данных
-
Глубокий ии для аналитики данных в рамках экосистемы Microsoft.
-
Пошаговая нейросеть для анализа таблиц и автоматической генерации DAX.
-
Мощный ии для анализа excel файлов с простой интеграцией.
-
Автоматическое создание текстовых резюме и отчетов к существующим дашбордам.
-
Генерация витрин данных через разговорный интерфейс Copilot.
Принимает подключения к SQL, Excel, Azure, Salesforce, SAP и веб-источникам. Скорость генерации ответов и построения отчетов мгновенная. Галлюцинации исключены за счет жесткой логики DAX и предварительно настроенных связей в модели данных.
Изучить возможности Power BI с Copilot
—-
Databricks — дата-лейкхаус и агенты Mosaic AI
Databricks — мощнейшая платформа для дата-инженеров, ML-специалистов и аналитиков крупных организаций. Технологическая основа Lakehouse в сочетании с диалоговым агентом Databricks Genie позволяет проводить аналитику прямо над петабайтами данных в Delta Lake с помощью простых текстовых запросов.
-
Выполнение аналитики над гигантскими массивами данных формата Delta Lake через разговорный ИИ.
-
Разработка, обучение и развертывание кастомных моделей ИИ и больших языковых моделей.
-
Автоматизация сложных пайплайнов обработки данных и их валидация в реальном времени.
-
Организация командной работы над ноутбуками с данными для дата-сайентистов.
Платформа спроектирована для работы с петабайтами информации без ограничений по объему. Контекст фиксируется на уровне единого каталога Unity Catalog, обеспечивая сквозную прослеживаемость данных и строгий контроль доступа.
Возможности Databricks для анализа данных
-
Мощный полный анализ данных на уровне петабайтных хранилищ.
-
Диалоговый агент Genie как продвинутый ии для аналитика данных.
-
Качественная нейросеть для аналитики инфраструктуры и построения ML-моделей.
-
Центр управления моделями Mosaic AI для безопасной интеграции LLM.
-
Автоматическая генерация оптимизированного SQL-кода под специфику Spark.
Работает с дата-лейками, Parquet, Delta Lake, SQL и потоковыми данными. Скорость вычислений высочайшая благодаря распределенным кластерам Spark. Точность обеспечивается обращением ИИ к структурированному семантическому слою и реальному выполнению SQL-запросов.
—-
AnalyzeData — отчеты из CSV и Excel с доказанной точностью
AnalyzeData фокусируется на создании клиентских отчетов и полной доказанности результатов. К каждому сгенерированному числу или графику сервис прикрепляет исполненный код Python. Инструмент идеален, когда нужно быстро отдать заказчику или руководителю безупречно оформленный PDF-отчет.
-
Превращение сырых выгрузок CSV и Excel в оформленные клиентские отчеты за минуты.
-
Создание брендированных отчетов с возможностью моментальной публикации по закрытой ссылке.
-
Экспресс-анализ файлов с локальной обработкой данных прямо в браузере пользователя.
-
Проверка происхождения каждой цифры и графика в отчете с демонстрацией Python-кода.
Сервис обрабатывает таблицы до 50 000 строк прямо в браузере, сохраняя приватность файлов. Контекст сессии держит структуру датасета и историю запросов, избавляя от повторных загрузок файла.
Возможности AnalyzeData для анализа данных
-
Удобная нейросеть для анализа файлов формата CSV, Excel, JSON и TSV.
-
Безопасный ии для анализа файлов с локальным парсингом на стороне клиента.
-
Автоматическая генерация отчетов журнального качества и выгрузка в PDF.
-
Выверенная нейросеть для генерации вывода с привязкой к исполненному коду.
-
Быстрый ии для написания выводов и текстовых пояснений к графикам.
Принимает CSV, XLSX, JSON, TSV. Работает мгновенно, так как первичный разбор идет на клиенте, а расчеты выполняются чистым Python-кодом. Риск ошибок сведен к нулю: на любой блок в отчете можно нажать и увидеть исходный математический код.
Создать клиентский отчет из CSV на AnalyzeData
—-
Практическое руководство по анализу данных с помощью ИИ: от сырых файлов до верифицированных отчетов
Использование нейросетей в аналитике давно вышло за рамки простых текстовых запросов вроде «сделай резюме таблицы». Современные языковые модели (LLM) со встроенными интерпретаторами кода (Python-песочницами) способны выполнять полноценный эксплораторный анализ (EDA), выявлять аномалии, строить статистические модели и писать SQL-запросы. Однако главный барьер на пути к точному результату — галлюцинации и неверная интерпретация контекста. Если модель просто «угадывает» следующее слово при расчете финансовых показателей, вы получите недостоверные цифры.
Чтобы превратить нейросеть в надежного дата-аналитика, необходимо соблюдать три дисциплины: правильную подготовку входных данных, точный промпт-инжиниринг и жесткий аудит вычисленных результатов.
1. Подготовка и передача входных данных
Точность работы нейросети на 70% зависит от того, в каком виде вы передаете информацию. Модели отлично считывают плоские структуры, но ломаются на сложных «человеческих» отчетах с объединенными ячейками и цветовым кодированием.
Оптимальные форматы файлов
Передавать данные лучше всего в текстовых или машинночитаемых форматах. Идеальный выбор — .csv, .jsonl, .parquet или чистый .txt с разделителями (TSV). Если вы загружаете традиционный файл Excel (.xlsx), предварительно очистите его от графического оформления.
-
Уберите объединенные ячейки: Алгоритмы парсинга разворачивают их в сетку с кучей пропусков (NaN), из-за чего модель теряет привязку строк к заголовкам.
-
Удалите итоговые строки: Строки «Итого», «Всего» или промежуточные суммы внутри таблицы нейросеть может посчитать за рядовые значения и удвоить конечные показатели при агрегации.
-
Приведите даты и числа к единому стандарту: Преобразуйте форматы типа $1,234.50 или 01/02/2026 в чистые числа (1234.5) и стандарт ISO (2026-02-01).
-
Используйте единый заголовок: Шапка таблицы должна занимать строго одну строку без подзаголовков. Именования колонок лучше писать на латинице или понятным кириллическим текстом без спецсимволов (например, revenue_usd или выручка_руб).
Сравнение форматов данных для загрузки в ИИ
|
Формат |
Эффективность расхода токенов |
Скорость обработки |
Риск ошибок парсинга |
Рекомендуемый сценарий |
|
.csv / .tsv |
Высокая |
Мгновенно |
Низкий |
Универсальный стандарт для плоских таблиц до 500 тыс. строк. |
|
.parquet |
Максимальная |
Высокая |
Минимальный |
Массивы больших объемов, сжатые структурированные данные. |
|
.json / .jsonl |
Средняя |
Средняя |
Низкий |
Иерархические структуры, выгрузки из API и логов. |
|
.xlsx |
Низкая |
Зависит от среды |
Высокий |
Небольшие книги без сложного форматирования и макросов. |
|
.pdf (сканы) |
Очень низкая |
Медленно |
Очень высокий |
Извлечение текста через OCR перед подачей в аналитический скрипт. |
Анонимизация и безопасность (PII)
Перед загрузкой файлов в публичные облачные ИИ обязательной процедурой является деанонимизация коммерческой и персональной информации (PII):
-
Замените ФИО клиентов, email-адреса и телефоны на хэши или уникальные идентификаторы (например, client_10492).
-
Масштабируйте чувствительные финансовые показатели (умножьте на случайный коэффициент), если вам важна динамика и пропорции, а не абсолютные суммы.
-
Запретите обучение на ваших данных в настройках приватности используемой платформы.
2. Промпт-инжиниринг для аналитики данных
Промпт для аналитики — это не просто вопрос, а техническое задание (ТЗ). Главное правило: заставляйте нейросеть писать и исполнять код (Python, SQL, R), а не рассчитывать показатели в уме через вероятности токенов.
Структура профессионального промпта (Фреймворк RTCO)
Любой качественный аналитический промпт содержит 4 элемента:
-
Role (Роль): Кем выступает ИИ (например, «Senior Data Analyst в e-commerce»).
-
Task (Задача): Что именно нужно сделать с понятным описанием конечного результата.
-
Context & Schema (Контекст и схема): Описание структуры файла, значение каждого столбца, особенности бизнеса.
-
Output Constraints (Ограничения и формат): В каком виде выдать ответ (таблица, код Python, сжатый чек-лист с метриками).
Правило пошаговых рассуждений (Chain-of-Thought)
Не просите нейросеть выдавать итоговый вывод сразу. Разбейте выполнение задачи на логические шаги в самом промпте. Это снижает вероятность логического сбоя на 60–80%.
Сравнение слабых и профессиональных промптов
|
Неэффективный промпт |
Профессиональный промпт (Production-Grade) |
Почему второй вариант работает лучше |
|
«Посмотри таблицу и скажи, почему упали продажи в марте?» |
Роль: Senior E-commerce Analyst. Контекст: В файле sales_q1.csv данные по ежедневным заказам. Колонки: date, order_id, category, revenue_rub, churn_flag. Задача: 1. Напиши Python-скрипт с библиотекой pandas для очистки данных от дублей. 2. Посчитай помесячную выручку и средний чек по категориям. 3. Найди категории с наибольшим падением в марте относительно февраля. Ограничения: Не угадывай цифры. Выполни код, покажи вывод скрипта и сформулируй 3 гипотезы на основе полученной статистики. |
Исключает текстовые фантазии. Принудительно запускает вычисления через код, задает четкий порядок от очистки к выводам. |
|
«Сделай красивый график по этим данным и опиши тренды.» |
На основе датасета сформируй график распределения выручки по дням недели (Seaborn/Plotly). Проверь данные на наличие выбросов (метод IQR). Если выбросы есть — очисти перед построением. Выведи график и укажи точные медианные значения для каждого дня. |
Указывает конкретные математические методы фильтрации (IQR) и библиотеки, гарантируя корректную масштабную сетку. |
3. Верификация и аудит ответов ИИ
Языковые модели ошибаются даже при исполнении Python-кода. Ошибки возникают из-за неверной трактовки типов данных (например, когда число считывается как строка), неправильного соединения таблиц (JOIN) или пропуска нулевых значений (NULL).
Алгоритм «Санити-чека» (Sanity Check)
При получении ответа от нейросети всегда проводите базовую проверку результатов по следующей схеме:
-
Проверьте исходный Python/SQL код: Откройте сгенерированный блок кода. Убедитесь, что ИИ не применил функции, искажающие выборку (например, dropna() без предупреждения, выбросившая половину датасета).
-
Сверьте контрольные суммы (Control Totals): Сложите сумму исходного столбца до обработки и после. Если общее число строк или итоговая выручка «поплыли» без явного указания отфильтровать данные — результат недостоверен.
-
Проверьте типы данных: Убедитесь, что модели не пришлось суммировать строковые значения или конкатенировать даты как обычные числа.
-
Запросите матрицу пропущенных значений: Попросите выдать вывод команды df.info() или df.isnull().sum(), чтобы понять, сколько данных было проигнорировано.
Типичные ошибки ИИ при анализе данных и способы их устранения
|
Вид ошибки |
Причина возникновения |
Как обнаружить |
Как исправить промптом |
|
Призрачные цифры (Галлюцинация значений) |
Модель выдала ответ из текстовой памяти, не выполнив написанный код. |
В ответе есть итоговые цифры, но нет блока с выполнением кода Python/SQL. |
«Покажи консольный вывод (stdout) выполнения Python-скрипта. Не пиши выводы, пока не запустишь код.» |
|
Проблема фильтрации NULL |
Автоматический отброс строк с пустой информацией при подсчете средних показателей. |
Итоговое количество записей (count) в агрегации меньше общего числа строк в файле. |
«Заполни пропуски средним/медианой перед расчетом или явно укажи количество NaN в отчете.» |
|
Дублирование при JOIN |
Неправильно выбранный ключ при объединении двух таблиц (связь «многие ко многим»). |
Итоговая сумма показателей превышает сумму в исходных файлах. |
«Перед объединением таблиц сделай дедупликацию по ключу user_id и выведи количество строк до и после merge.» |
|
Ошибки округления и масштаба |
Использование стандартных float-типов без учета плавающей запятой в финансовых операциях. |
Несовпадение копеек или копеечные расхождения в балансовых отчетах. |
«Для финансовых вычислений используй модуль decimal или округляй значения строго на этапе финального вывода.» |
4. Рекомендуемый регламент работы с ИИ в аналитике
Чтобы минимизировать риски и выстроить воспроизводимый процесс, придерживайтесь следующего регламента:
Этап 1. Подготовка: Очистите файл от оформления, анонимизируйте конфиденциальные данные, сохраните в CSV или Parquet.
Этап 2. Эксплораторный анализ (EDA): Загрузите файл и попросите ИИ вывести общие метрики датасета: количество строк, тип столбцов, процент пропусков, минимальные и максимальные значения. Это позволит вам и нейросети «увидеть» один и тот же массив данных.
Этап 3. Локальные вычисления через код: Формулируйте гипотезы последовательно. Попросите ИИ написать Python-скрипт для проверки каждой конкретной гипотезы. Всегда разворачивайте блок кода и проверяйте логику pandas-методов.
Этап 4. Визуализация и кросс-проверка: Просите строить графики с явным отображением точных значений (data labels). Сверяйте крайние точки и пики на графике с сырой таблицей.
Этап 5. Финализация отчета: На основе верифицированных консольных выводов просите нейросеть сформировать итоговую аналитическую записку с рекомендациями, явно разграничивая жесткие факты из кода и абстрактные интерпретации моделей.
Реклама. ООО «ДИДЖИТАЛ ГЕНИУС». ИНН 7813681158
ссылка на оригинал статьи https://habr.com/ru/articles/1066950/