Прежде чем сравнивать цифры бенчмарков, стоит понять главное: это не сравнение моделей одного поколения. GPT-5.6 Sol вышел в широкий доступ 9 июля 2026 года, а Gemini 3.1 Pro — ещё 19 февраля 2026-го, то есть между релизами разрыв примерно в пять месяцев разработки, что в индустрии, где модели обновляются буквально каждый месяц, является значительной дистанцией. Настоящий одноранговый конкурент Sol у Google — Gemini 3.5 Pro — на момент подготовки этого материала всё ещё не вышел в общий доступ, а значит прямое сравнение новейшей модели одной компании с предыдущим поколением флагмана другой компании требует отдельной оговорки, прежде чем делать какие-либо выводы о том, чья архитектура фундаментально сильнее. Разбираем, что это означает на практике, в чём каждая модель реально сильнее и почему выводы этого сравнения стоит воспринимать как снимок текущей ситуации на рынке, а не окончательный вердикт, высеченный в камне.

Почему это сравнение не совсем «равных весовых категорий»
Формально сопоставлять GPT-5.6 Sol и Gemini 3.1 Pro напрямую — не вполне честно по отношению к Google, и об этом стоит сказать прямо, а не прятать за красивыми цифрами бенчмарков. Sol — самая свежая модель линейки OpenAI на сегодняшний день, тогда как 3.1 Pro у Google уже не флагман последнего поколения: архитектурная переработка сдвинула релиз настоящего однорангового конкурента, Gemini 3.5 Pro, ориентировочно на середину июля 2026 года, но по независимым источникам он до сих пор не общедоступен на момент публикации этого материала.
Разрыв в пять месяцев разработки в индустрии, где модели обновляются каждые несколько недель, — это существенная разница, которая может сама по себе объяснять значительную часть преимущества Sol в конкретных категориях бенчмарков. Представьте похожую ситуацию в любой другой быстро развивающейся технической области: сравнивать последнюю версию продукта одной компании с версией конкурента пятимесячной давности — не значит получить нечестный результат в буквальном смысле, но точно значит, что итоговое сравнение отражает не столько разницу в архитектурных подходах, сколько разницу во времени, которое каждая команда успела потратить на доработку своей модели.
Честная рамка для этого сравнения — воспринимать его как срез текущей доступной ситуации: что можно реально попробовать и использовать прямо сейчас, а не как окончательное заявление о том, чья архитектура принципиально лучше. Когда Gemini 3.5 Pro выйдет в публичный доступ, многие из приведённых ниже цифр в пользу Sol вполне могут измениться, а часть текущего разрыва в бенчмарках может попросту сократиться или вовсе исчезнуть. Это не повод игнорировать текущие результаты — они отражают реальное положение дел на сегодняшний день, — но повод не делать из них долгосрочных выводов о фундаментальном превосходстве одной компании над другой.
GPT-5.6 Sol: что нового
GPT-5.6 Sol стал общедоступным 9 июля 2026 года, до этого существовал в статусе preview для ограниченного круга пользователей. Модель получила публичный API, интеграцию в ChatGPT, инструмент Codex для работы с кодом и поддержку GitHub Copilot. Линейка GPT-5.6 при этом устроена как три уровня под разные задачи: Sol — флагманская версия с максимальными возможностями, Terra — баланс цены и качества примерно на уровне предыдущего поколения GPT-5.5, но вдвое дешевле, и Luna — самая быстрая и доступная версия для лёгких задач.
Контекстное окно Sol составляет 1 050 000 токенов — то есть модель способна удерживать в рамках одного диалога или анализируемого документа огромный объём информации одновременно, от объёмных технических спецификаций до целых кодовых репозиториев с десятками файлов. На практике такое окно контекста означает, что можно загрузить в модель весь проект целиком и работать с ним как с единым связным контекстом, а не разбивать на разрозненные фрагменты и терять связи между частями кода при таком разбиении. Дата отсечения обучающих данных — 16 февраля 2026 года, что заметно свежее, чем у Gemini 3.1 Pro, а значит модель потенциально лучше осведомлена о более недавних событиях, технологиях, библиотеках и фреймворках, появившихся уже после начала 2026 года.
Отдельного внимания заслуживают режимы Max и Ultra reasoning — расширенные режимы рассуждения для наиболее сложных задач, требующих многошагового анализа и способности удерживать в фокусе внимания длинную цепочку логических выводов, а не просто быстро выдавать первый правдоподобный ответ. Модель также получила многоуровневую защиту в области кибербезопасности и биологии — дополнительные ограничения, призванные снизить риск использования модели для потенциально опасных задач в этих чувствительных областях, что становится всё более значимым фактором по мере роста возможностей подобных моделей. Ещё одна практическая деталь — предсказуемое кэширование промптов с явными точками разрыва кэша, что позволяет разработчикам точнее контролировать расходы при повторяющихся частях запроса, экономя на повторной обработке одного и того же неизменного контекста.
По бенчмаркам Sol демонстрирует уверенное лидерство в нескольких конкретных категориях: в тесте Terminal-Bench, оценивающем работу с агентными и терминальными задачами, модель показывает 88.8% против 68.5% у Gemini 3.1 Pro — разрыв весьма существенный. По общему индексу интеллекта от Artificial Analysis Sol набирает 57–59 баллов против 48 у конкурента. Модель также лидирует в ряде других тестов, включая BrowseComp, MMMU-Pro и MRCR.
Gemini 3.1 Pro: что нового
Gemini 3.1 Pro вышел 19 февраля 2026 года как улучшенная версия класса Gemini 3 Pro, с усиленным рассуждением, более уверенной работой с кодом и агентными сценариями для сложной мультимодальной работы — то есть задач, где одновременно нужно обрабатывать текст, изображения, аудио или видео в рамках одного запроса, без необходимости переключаться между разными специализированными инструментами для каждого типа данных. Дата отсечения обучающих данных модели, по одному из источников, — 31 января 2025 года, что заметно старше, чем у GPT-5.6 Sol, и потенциально означает, что модель хуже осведомлена о недавних событиях, продуктах или технологических изменениях за последний год — эту цифру стоит перепроверить при желании привести её как окончательный точный факт, поскольку источник единичный и не был перепроверен вторым независимым трекером.
По бенчмаркам Gemini 3.1 Pro тоже показывает уверенное лидерство, но в других категориях, чем Sol, что довольно логично, учитывая исторический фокус Google на мультимодальных сценариях и интеграции с собственной экосистемой сервисов. В веб-разработке, по данным WebDev Arena, модель набирает 1 487 очков рейтинга Elo и занимает лидирующую позицию среди сравниваемых моделей. В LiveCodeBench Pro результат тоже впечатляющий — 2 439 очков Elo, снова лидерство, причём с заметным отрывом от ближайших конкурентов по этому конкретному тесту. Модель сильна в общих знаниях (тест MMLU) и в абстрактном рассуждении (ARC-AGI-2), а также нативно работает с аудио и видео на входе без необходимости в дополнительных инструментах преобразования формата — то есть можно напрямую загрузить видеофайл или аудиозапись и получить содержательный анализ без предварительной конвертации в текст силами стороннего сервиса.
Отдельно стоит выделить практический параметр, важный не только для абстрактных бенчмарков, но и для повседневного использования, — скорость генерации. По данным Artificial Analysis, Gemini 3.1 Pro генерирует около 123 токенов в секунду, что заметно быстрее, чем у Sol. Для задач, где важна скорость ответа в реальном времени — например, интерактивные приложения, живой диалог с пользователем или обработка потокового ввода, — это может оказаться решающим фактором даже при прочих равных возможностях по качеству самого ответа.
Бенчмарки: кто в чём сильнее
Если свести картину воедино без визуальной таблицы, распределение сильных сторон получается довольно чётким по категориям задач. В агентном и терминальном коде, а также в задачах, требующих сложного многошагового рассуждения, уверенно лидирует GPT-5.6 Sol — разрыв в Terminal-Bench и общем индексе интеллекта достаточно значительный, чтобы не списывать его на погрешность измерения или случайное расхождение отдельных тестовых прогонов. В веб-разработке, общих знаниях и абстрактном рассуждении лидирует Gemini 3.1 Pro, а вдобавок модель заметно быстрее генерирует ответ, что практически ощутимо в реальном использовании, а не только в лабораторных тестах, оторванных от повседневной практики.
Стоит отдельно отметить, что эти две группы категорий — агентный код против веб-разработки и мультимодальности — во многом соответствуют разным сценариям применения, а не просто абстрактным «сильным сторонам» без практического контекста. Если ваша основная задача — автоматизация работы с командной строкой, сложные скрипты, многошаговые агентные цепочки действий, разрыв в пользу Sol может оказаться решающим при выборе. Если же вы чаще работаете с фронтендом, интерфейсами, обработкой медиафайлов или задачами, где критична скорость отклика, преимущество Gemini 3.1 Pro в соответствующих бенчмарках может оказаться более значимым для вашего конкретного случая, чем общий разрыв в абстрактном индексе интеллекта.
С ценой ситуация менее однозначная и прямо противоречивая между независимыми источниками. Один источник указывает, что Gemini 3.1 Pro примерно вдвое дешевле GPT-5.6 Sol в пересчёте на токен — около $5 против $13 за миллион токенов при смешанном расчёте между вводом и выводом. Другой независимый источник, напротив, называет Sol немного дешевле по цене вывода — $10 против $12 у Gemini при одинаковой цене входа в $2 и цене кэша в $0.20. Раз источники прямо противоречат друг другу, честнее не утверждать однозначно, какая модель дешевле в общем случае, а понимать, что итоговая цена сильно зависит от конкретного типа задачи: если ваш сценарий предполагает много входного текста относительно небольшого объёма генерации, расклад может быть одним, а если наоборот — генерируется много текста на относительно короткий запрос — совершенно другим. Практический совет здесь простой: перед выбором модели для конкретного проекта с большим объёмом запросов стоит прикинуть примерное соотношение входных и выходных токенов на вашей реальной задаче и сравнить итоговую стоимость по обеим ценовым моделям, а не полагаться на общее впечатление «дешевле» или «дороже» без конкретных расчётов. Точные официальные тарифы стоит сверять непосредственно на страницах OpenAI и Google перед принятием решения, так как цены API меняются быстро, а независимые трекеры цен не всегда успевают синхронизироваться с последними изменениями.
Важная оговорка про надёжность бенчмарков
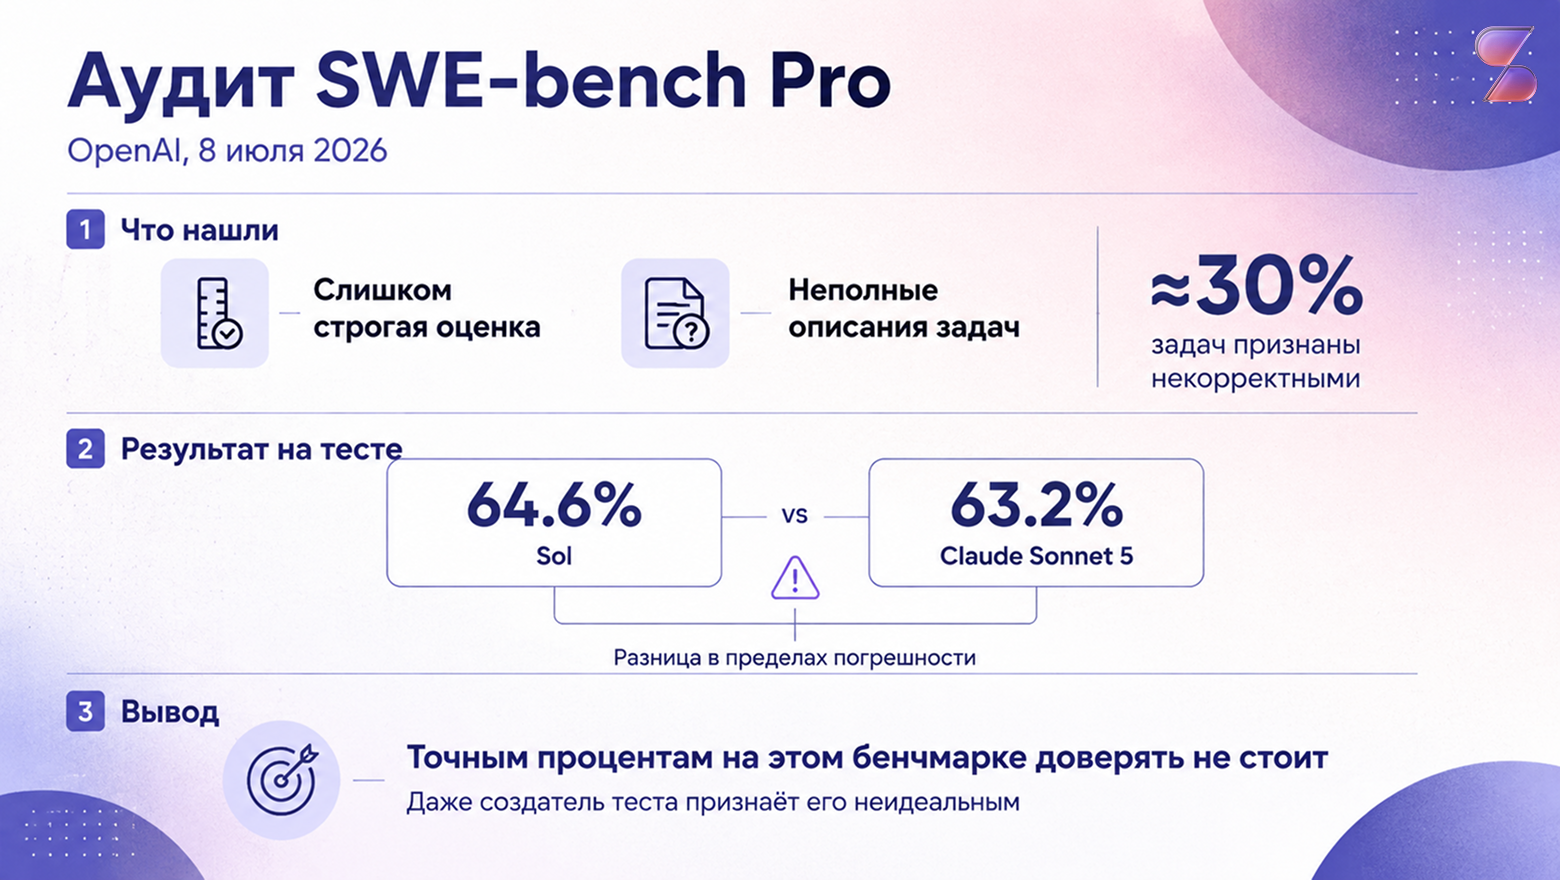
Стоит отдельно остановиться на истории с признанием OpenAI недостатков собственного бенчмарка SWE-bench Pro, потому что это редкий и показательный случай для всей индустрии. Компания сама опубликовала аудит, по которому около 30% задач в этом тесте оказались некорректными по разным причинам — от чрезмерно строгих критериев оценки до неполных описаний самой задачи, которые допускают неоднозначную интерпретацию условия. Это не значит, что все бенчмарки в принципе бесполезны, но означает, что слепо доверять одной конкретной цифре из одного конкретного теста — рискованная практика, особенно если эта цифра становится единственным аргументом в пользу выбора той или иной модели для важного проекта.
Разумнее смотреть на совокупность нескольких независимых бенчмарков сразу, обращать внимание на то, кто именно проводил тестирование — сам разработчик модели или независимая третья сторона без коммерческой заинтересованности в результате, — и относиться с здоровым скепсисом к любому единичному результату, который выглядит слишком однозначным или слишком выгодным для одной из сравниваемых сторон. Полезная практическая привычка — искать не одну цифру, а несколько независимых оценок одного и того же параметра, и обращать особое внимание на случаи, когда разные источники расходятся между собой: как в примере с ценой выше, расхождение само по себе является полезным сигналом о том, что ситуация сложнее, чем один простой ответ.
Пример работы с обеими моделями
Раз тема достаточно техническая, приведём пример базовой структуры запроса к API каждой из моделей:
json
{
«model»: «gpt-5.6-sol»,
«messages»: [{«role»: «user», «content»: «Refactor this function for readability and explain the trade-offs»}]
}
json
{
«model»: «gemini-3.1-pro»,
«contents»: [{«role»: «user», «parts»: [{«text»: «Analyze this UI mockup and suggest accessibility improvements»}]}]
}
Обратите внимание на разницу в структуре запроса между двумя API — это стоит учитывать при разработке, если планируется использовать обе модели в одном проекте или переключаться между ними в зависимости от типа задачи.
Кому что выбрать
Если задача — агентный код, работа с терминалом и командной строкой, сложные многошаговые технические сценарии, где важна глубина рассуждения, — более уверенным выбором выглядит GPT-5.6 Sol, судя по разрыву в соответствующих бенчмарках. Если же в приоритете мультимодальные задачи с аудио и видео, веб-разработка, или требуется более быстрая генерация ответа при работе с большими объёмами данных, — Gemini 3.1 Pro показывает себя увереннее. Стоит также учитывать более широкий практический контекст: если ваш проект предполагает работу с быстро меняющимися технологиями или новыми библиотеками, более свежая дата отсечения обучающих данных у Sol может дать дополнительное преимущество независимо от результатов формальных бенчмарков.
Для тех, кто не готов выбирать одну модель раз и навсегда и хочет иметь возможность сравнивать результат на конкретной задаче, практичнее получить доступ сразу к обеим моделям через единый интерфейс, не тратя время на отдельную регистрацию и настройку оплаты для каждого сервиса по отдельности.
У SpeShu.AI есть аналоговые модели: SpeShu Claude, SpeShu Gemini, SpeShu ChatGPT. Они не уступают официальным моделям и при этом работают без VPN, оплачиваются картой банков РФ и стоят дешевле.
Частые вопросы
Почему это сравнение называют не совсем справедливым?
Потому что GPT-5.6 Sol и Gemini 3.1 Pro относятся к разным поколениям разработки: между их релизами разрыв примерно в пять месяцев, а настоящий одноранговый конкурент Sol у Google — Gemini 3.5 Pro — на момент публикации ещё не вышел в общий доступ. Часть преимущества Sol в бенчмарках может объясняться именно этим разрывом, а не принципиальным превосходством архитектуры.
В каких задачах GPT-5.6 Sol уверенно сильнее?
В агентном и терминальном коде, судя по результатам Terminal-Bench, а также в общем индексе интеллекта Artificial Analysis и ряде других тестов вроде BrowseComp, MMMU-Pro и MRCR. Модель также предлагает более свежую дату отсечения обучающих данных и более широкое контекстное окно.
В каких задачах Gemini 3.1 Pro уверенно сильнее?
В веб-разработке, где модель лидирует по WebDev Arena и LiveCodeBench Pro, в общих знаниях и абстрактном рассуждении, а также в нативной работе с аудио и видео на входе. Модель заметно быстрее генерирует ответ — около 123 токенов в секунду по независимым замерам.
Стоит ли доверять бенчмарку SWE-bench Pro после признания OpenAI о его недостатках?
Стоит относиться к нему с осторожностью, но не игнорировать полностью. Сама компания признала, что около 30% задач в этом тесте некорректны, поэтому конкретные проценты на этом бенчмарке лучше рассматривать как ориентировочные, а не абсолютно точные, и сопоставлять их с результатами других независимых тестов.
Заключение
Однозначного победителя в этом сравнении нет: GPT-5.6 Sol уверенно доминирует в агентном коде и сложном рассуждении, а Gemini 3.1 Pro берёт своё мультимодальностью, скоростью и — в части сценариев — более выгодной ценой. Правильный выбор зависит от конкретной задачи, которую вы решаете, а не от одной обобщённой цифры в рейтинге, тем более с учётом разрыва в поколениях между этими двумя моделями и не самой безупречной репутации отдельных бенчмарков, на основе которых строятся подобные сравнения. Возможно, самый честный вывод из всего материала — не искать единственно правильный ответ на вопрос «какая нейросеть лучше», а протестировать обе модели на собственной реальной задаче и сделать вывод по фактическому результату, а не по чужим цифрам в таблице. При пополнении баланса на SpeShu.AI промокод HABRSPESHUAI даёт +15% к сумме пополнения.
ссылка на оригинал статьи https://habr.com/ru/articles/1079182/