Правильный вопрос звучит не «что лучше: K-Means или Random Forest?». Правильный вопрос: что известно об ответах заранее, какое бизнес-действие изменится благодаря модели и как доказать, что оно изменилось в нужную сторону.
Содержание
Разные вопросы, разные задачи
Классификацию и кластеризацию принято описывать как «обучение с учителем» и «обучение без учителя». Это верно, но не исчерпывает разницы. Важнее то, на какой вопрос отвечает каждая из них.
Классификация отвечает: «К какому из известных классов относится объект?» Обучающая выборка содержит примеры с готовыми метками. Модель учится предсказывать метку для новых объектов: определять, является ли транзакция мошеннической, по историческим операциям с подтверждёнными ответами. Или предсказывать, к какой категории относится химическое соединение по его структурным характеристикам.
Кластеризация отвечает: «Какие группы похожих объектов существуют в данных?» Готовых меток нет. Алгоритм группирует объекты по выбранному критерию сходства, обнаруживая неизвестные ранее типы поведения покупателей или аномальные паттерны в сетевом трафике.
Разница принципиальная. Классификатор оптимизирует ошибку предсказания известных меток: например, log loss. Алгоритм кластеризации оптимизирует совсем другое: внутрикластерную дисперсию, плотность, связность или иной критерий структуры данных. Поэтому кластер — это не обязательно естественная категория объекта. Он может быть результатом выбранной метрики, представления данных и настроек алгоритма.
Отсюда следует важная вещь, которую легко пропустить: отсутствие разметки — не автоматическое требование применять кластеризацию. Иногда правильный следующий шаг: собрать качественные метки, построить поиск похожих объектов, использовать правила или решать задачу как обнаружение аномалий. Кластеризация оправдана, когда есть основания полагать, что в данных существует полезная структура — и её можно применить в реальном решении.
Как работает классификация: антифрод-система банка
Классическая постановка: определить, является ли транзакция мошеннической. Для каждой операции собираются признаки:
-
сумма и валюта;
-
время и география;
-
тип устройства;
-
история операций клиента;
-
частота платежей за последние N минут.
Архитектура прямолинейна: исторические транзакции с метками «мошенничество / норма» → подготовка данных (очистка, кодирование, разбиение train/validation/test) → обучение классификатора — Logistic Regression, CatBoost, градиентный бустинг → inference с оценкой риска, порогом и решением.
На уровне математики модель оценивает условную вероятность класса:
$$P(y = c \mid x)$$
Затем система выбирает действие по порогу. И это не одно и то же. Вероятность 0.7 не означает, что транзакцию нужно автоматически отклонить: решение зависит от стоимости ложного срабатывания и пропущенного мошенничества.
Здесь и возникает первая ловушка. При дисбалансе классов, когда мошеннических транзакций всего 1%, модель, предсказывающая всегда «норма», даёт 99% accuracy — и не обнаруживает ни одного инцидента. Оптимизировать только accuracy бессмысленно. Нужны precision, recall, F1, PR-AUC, ROC-AUC, калибровка вероятностей и бизнес-метрики. Выбор зависит от цены ошибок и частоты положительного класса.
Как работает кластеризация: сегментация без учителя
Другой сценарий: у интернет-магазина нет готовой разметки покупателей. Есть история покупок, частота заказов, средний чек, возвраты и интервалы между покупками.
K-Means решает задачу итеративно: минимизирует сумму квадратов расстояний от объектов до центроидов:
J=i=1nxi-ci2
Цикл: выбрать начальные центроиды, назначить каждую точку ближайшему, пересчитать центроиды как средние значения, повторять до сходимости. Алгоритм прост и масштабируется на многие практические задачи. Но у него есть ограничения: он предполагает «шарообразную» геометрию кластеров, чувствителен к масштабу признаков и выбросам, требует задать число кластеров k заранее.
Разные алгоритмы решают разные задачи:
|
Алгоритм |
Когда рассматривать |
Основное ограничение |
|
K-Means |
Много объектов, числовые признаки, нужна сегментация на k групп |
Плохо подходит для кластеров сложной формы |
|
DBSCAN |
Плотные области произвольной формы, поиск шума |
Сложно подобрать параметры при неодинаковой плотности |
|
HDBSCAN |
Разная плотность групп, неизвестное число кластеров |
Чувствителен к представлению данных и настройкам |
|
Agglomerative |
Иерархические отношения и исследование структуры |
Ограничения на больших выборках |
|
Gaussian Mixture |
Кластеры как вероятностные распределения, мягкое назначение |
Предположения о распределениях могут не соответствовать данным |
Выбор алгоритма должен учитывать геометрию данных и цель анализа — не только показатель по silhouette.
Кластер — это не готовая категория
Допустим, K-Means разделил покупателей на четыре группы. Нельзя автоматически назвать их «лояльные», «премиальные», «экономные» и «склонные к оттоку». Это потребует отдельного шага: изучить профили кластеров, проверить устойчивость разбиения и сопоставить его с бизнес-показателями.
Удобная практика профилирования:
-
рассчитать размеры кластеров и распределения признаков;
-
сравнить средний чек, retention, частоту покупок и возвраты;
-
проверить, сохраняются ли группы на другой временной выборке;
-
выяснить, применима ли сегментация для конкретного бизнес-действия;
-
проверить результат на эксперименте, если сегменты нужны для изменения продукта или маркетинга.
Метрика silhouette помогает оценить геометрическую разделимость групп, но не доказывает их бизнес-ценность. Высокий silhouette не гарантирует, что группы полезны для маркетинга или операционных решений.
Когда методы работают вместе
Кластеризация и классификация — не конкуренты. Их часто комбинируют в одном пайплайне.
Сценарий: команда провела кластеризацию, изучила результаты, убедилась, что сегменты полезны. Теперь нужно назначать новым покупателям один из сегментов быстро и согласованно. Перезапускать K-Means для каждого нового пользователя неудобно. Решение: обучить классификатор на размеченных результатах кластеризации.
Важно понимать ограничение. Классификатор учится воспроизводить решение исходного алгоритма в выбранном представлении данных, а не обнаруживать «истинные» типы покупателей. Ошибки кластеризации превращаются в ошибки обучающих меток. Границы сегментов могут устареть при изменении поведения клиентов.
Архитектура должна предусматривать мониторинг распределения признаков, отслеживание изменения размеров сегментов и периодическую переоценку их актуальности.
Рынок 2026: компетенции Middle и Senior
Требования к ML-специалистам нельзя описать одной строкой. Вакансии Data Scientist, ML Engineer и аналитика данных всё чаще пересекаются: задачи кластеризации и классификации решаются на стыке инженерии, статистики и понимания бизнес-контекста.
Для Middle-специалиста важно:
-
самостоятельно готовить данные и строить baseline;
-
выбирать метрики под конкретную бизнес-задачу;
-
настраивать валидацию и сравнивать модели;
-
объяснять, почему выбран алгоритм и какие у него ограничения;
-
воспроизводить эксперимент и передавать модель в интеграцию.
Senior добавляет другой уровень ответственности:
-
определяет постановку задачи и критерии успеха до выбора алгоритма;
-
учитывает стоимость ошибок, data drift, ограничения данных и эксплуатации;
-
проектирует мониторинг качества и процедуру переобучения;
-
защищает решение на уровне продукта, рисков и стоимости владения.
Что точно устаревает — не K-Means или Logistic Regression, а подход. Плохой подход выглядит так:
-
оценивать качество только на обучающей выборке;
-
считать accuracy достаточной при дисбалансе классов;
-
выбирать число кластеров только по одному графику;
-
передавать модель в прод без воспроизводимого препроцессинга;
-
не проверять, соответствует ли offline-метрика реальной бизнес-цели.
Простые модели — Logistic Regression, K-Means — остаются важными baseline для табличных данных. Они могут выигрывать по стоимости, интерпретируемости и времени внедрения. Игнорировать их ради нейросети «потому что так современнее» — это тоже плохой подход.
Практический кейс: маркетплейс, сегменты и подозрительные заказы
Рассмотрим условный маркетплейс с двумя задачами:
-
Разделить покупателей на группы для персонализации — разметки нет.
-
Определять, какие заказы отправить на дополнительную проверку — история с метками есть.
Данные частично пересекаются, а методы и критерии успеха — разные. Хороший пример того, что выбор начинается с вопроса о задаче, а не об алгоритме.
Пайплайн сегментации
-
Сырые данные: история покупок, средний чек, частота, возвраты.
-
Feature engineering: временны́е окна, агрегаты, масштабирование, обработка пропусков.
-
Кластеризация: K-Means как baseline, выбор альтернатив по структуре данных.
-
Профилирование: сравнение поведения кластеров, проверка устойчивости, бизнес-интерпретация.
Код: базовая кластеризация и классификация
Пример ниже иллюстрирует общий подход. Используется синтетический датасет — результаты не описывают реальных покупателей.
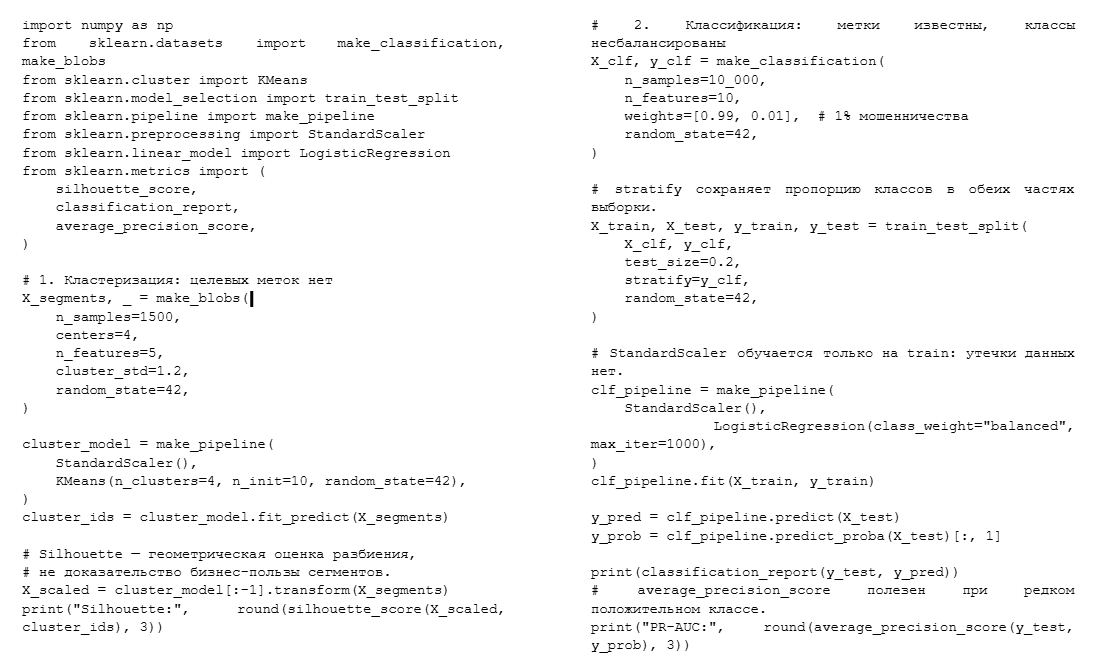
Что важно здесь:
-
KMeans не использует истинные классы при построении сегментов.
-
StandardScaler внутри Pipeline обучается только на train: статистика тестовой выборки в обучение не попадает.
-
stratify=y сохраняет пропорцию классов при разбиении.
-
class_weight=»balanced» помогает учесть дисбаланс, но не отменяет необходимость анализа порогов и бизнес-метрик.
-
Для временных транзакций случайный train_test_split может быть недостаточен: нужна временная валидация.
Как оценить бизнес-результат
Для сегментации: сравнить конверсию контрольной и экспериментальной групп, оценить доверительный интервал эффекта персонализации.
Для антифрода: доля обнаруженного мошенничества, доля ложных блокировок, стоимость ручной проверки, потери от пропущенных инцидентов.
Обнаружение закономерности в данных не доказывает, что действие на её основе улучшает продукт. Это отдельный вопрос, требующий отдельной проверки.
Четыре ошибки, которые ломают результат
Ошибка 1: data leakage при валидации. Разработчик стандартизирует весь датасет, а затем делит на train и test. Средние значения и стандартные отклонения тестовых данных попадают в процесс подготовки обучения: модель косвенно получает сведения о тестовой выборке. Аналогичная проблема: при прогнозировании оттока в признаки попадает информация, доступная только после ухода клиента.
Как исправить: сначала разделить данные, затем обучать преобразования только на train. Для временных данных — учитывать хронологию.
Ошибка 2: неподходящая метрика расстояния. В K-Means возраст клиента, средний чек и число заказов могут иметь совершенно разные масштабы. Если признаки не нормализовать, численно крупный признак доминирует в евклидовом расстоянии. Но стандартное масштабирование не универсально: оно не исправляет плохое представление категориальных признаков и чувствительно к выбросам.
Как исправить: исследовать распределения и выбросы, выбирать масштабирование с учётом природы данных, проверять, как изменение представления меняет состав и смысл кластеров.
Ошибка 3: принять один график silhouette за истину. Метод локтя и silhouette помогают выбрать параметры, но не являются оракулом. На реальных данных нет гарантии, что оптимум математической метрики совпадёт с полезной сегментацией. Silhouette не одинаково хорошо подходит для всех форм и плотностей кластеров.
Как исправить: сравнивать несколько значений k, использовать несколько метрик и обязательно интерпретировать результаты вместе с владельцем бизнес-задачи.
Ошибка 4: выбрать классификатор по accuracy при дисбалансе классов. При 1% мошеннических транзакций модель, всегда предсказывающая «норма», даёт 99% accuracy — и не обнаруживает ни одного инцидента. Нужны метрики, учитывающие редкий класс: precision, recall, F1, PR-AUC. При этом порог выбирается не ради лучшего F1: он должен соответствовать допустимому количеству ложных блокировок, пропущенных инцидентов и затрат на ручную проверку.
Где закрыть пробел в навыках
После технического разбора логично задаться вопросом: что мешает применить всё это прямо сейчас? Чаще всего — не незнание алгоритмов, а пробелы в инженерной практике: воспроизводимость экспериментов, корректная валидация, работа с дисбалансом, перевод offline-метрик в бизнес-результат.
ML Engineering: от ноутбука к воспроизводимому пайплайну
После разбора архитектуры сегментации и антифрода возникает закономерный вопрос: как не потерять эксперимент при передаче в прод? Программа «Инженер машинного обучения» (karpov courses, 7 месяцев, 119 000 ₽ по каталогу) охватывает Python, SQL, машинное обучение, MLOps, глубокое обучение и A/B-тестирование.
Логичный следующий шаг для специалиста, который умеет строить модели, но хочет научиться их сопровождать. Ограничение: широкая программа не гарантирует углублённого изучения конкретных алгоритмов кластеризации. Перед выбором стоит проверить учебный план и объём практических заданий.
Посмотреть программу в каталоге Хабр Курсов
Продвинутые методы ML: за пределами K-Means
Если алгоритмы известны на базовом уровне, но не хватает систематизации, курс «Продвинутые методы машинного обучения» (Stepik, 2 месяца, 3 510 ₽) охватывает машинное обучение, Python и глубокое обучение. Компактный вход в более сложные методы без необходимости выбирать многомесячную программу.
Ограничение: детальный перечень модулей по сравнению алгоритмов кластеризации в доступном описании не установлен. Стоит проверить содержание перед записью, особенно если требуется именно практика по DBSCAN или оценке кластеров.
Найти курс в каталоге Хабр Курсов
Data Science системно: для тех, кто закрывает базовый пробел
Если не хватает основы: статистики, подготовки данных и правильной оценки моделей, — программа «Специалист по Data Science, расширенный» (Яндекс Практикум, 17 месяцев, 212 500 ₽) охватывает Python, SQL, Pandas, NumPy, математическую статистику, классическое ML, PyTorch, Spark, Airflow и MLflow.
Подходит тем, кому нужно последовательно закрыть пробелы, а не изучить одну тему. Продолжительный и дорогой формат может быть избыточен для практикующего специалиста с конкретным пробелом. Важно убедиться, что объём практики соответствует ожиданиям.
Найти курс в каталоге Хабр Курсов
FAQ
Если меток нет, нужно обязательно применять кластеризацию?
Нет. Отсутствие разметки не означает, что в данных существуют полезные кластеры. Иногда правильный следующий шаг: собрать разметку, использовать правила или решать задачу как обнаружение аномалий. Кластеризация оправдана, когда есть основания полагать, что структура в данных существует и её можно применить в конкретном решении.
Можно ли комбинировать кластеризацию и классификацию в одном пайплайне?
Да. Кластеризация помогает исследовать неизвестную структуру и выделить сегменты. Классификатор затем воспроизводимо назначает новым объектам известные сегменты. Важно понимать: классификатор учится воспроизводить решение исходного алгоритма в конкретном представлении данных, а не обнаруживать «истинные» категории. Ошибки кластеризации становятся ошибками обучающих меток.
Как объяснить выбор метода бизнес-стороне?
Через вопрос о действии: что изменится в продукте или процессе благодаря модели? Если ответ — «предсказывать известный результат для новых объектов», речь о классификации. Если ответ — «понять, какие группы пользователей или событий существуют», речь о кластеризации. Дальше уже начинается выбор алгоритма.
ссылка на оригинал статьи https://habr.com/ru/articles/1093080/