Посетитель открыл карточку товара. О его прошлых визитах мы ничего не знаем, в текущем визите покупок ещё не записано. Что предложить рядом с карточкой: популярные товары, похожие на этот или те, к которым после него переходили другие посетители?
Я собрала такую систему на данных Coveo: сначала она находит до 300 товаров-кандидатов: по истории действий других посетителей, описаниям, изображениям, поиску и популярности. Затем LightGBM расставляет их по порядку и выбирает до 20 рекомендаций. Модель обучена, качество измерено, рекомендации можно получить через локальный HTTP API.
Репозиторий проекта: RecSys-Coveo.
Когда выдаю рекомендации и что считаю целью
Для проекта я взяла Coveo SIGIR eCOM 2021, Public Data Release 1.0.0. В выгрузке записаны просмотры товаров, действия с корзиной, покупки и поисковые запросы. Эти действия объединены в сессии — отдельные визиты в магазин. У записей одного визита общий обезличенный идентификатор; после перерыва более 30 минут Coveo начинает новую сессию. Товары тоже обезличены: вместо обычных идентификаторов у них хеши. Дальше я буду называть их SKU.
Рекомендации выдаю после первого просмотра товара с корректным SKU. Но в данных несколько действий могут иметь одну и ту же отметку времени с точностью до миллисекунды. Тогда нельзя сказать, что произошло раньше: просмотр, поиск или покупка. Поэтому сначала учитываю все записи с этим временем. Если к этому моменту в сессии ещё не записана покупка, формирую список из не более 20 товаров. За сессию оцениваю только одну такую выдачу.
В цель включаю все товары, покупки которых зарегистрированы строго после запроса, в следующие 24 часа той же сессии. Если записи сессии заканчиваются раньше, поиск покупок заканчивается на последней записи. Сама сессия от этого не становится суточной: её границы уже заданы в выгрузке. Повторные записи покупки одного товара учитываю один раз. Сессии отбираю заранее, независимо от того, появится ли в них покупка.
Например, посетитель открыл рюкзак, получил рекомендации, а затем в той же сессии купил рюкзак и чехол от дождя. В цель попадут оба товара. Если хотя бы один из них был в первой двадцатке, засчитываю попадание. Просмотренные товары тоже можно рекомендовать — в том числе сам рюкзак.
Важное ограничение: мы не знаем, все ли покупки попали в выгрузку. Если записи о покупке нет, я не могу считать это доказательством, что человек ничего не купил. Цель такой сессии остаётся неизвестной. Поэтому качество считаю среди сессий с зарегистрированной целью. Даже у них в данных могут быть записаны не все покупки.
Покупки после запроса использую как метки для обучения и оценки. При расчёте самих рекомендаций система их не видит.
Что можно узнать из одного просмотра
Один просмотр уже даёт точку отсчёта: человек заинтересовался конкретным товаром. От него можно искать похожие товары и те, которые после него выбирали другие посетители. Если к моменту рекомендации известен поисковый запрос, он помогает уточнить интерес.
Из других сессий я беру общую историю действий с товарами: что смотрели вместе, к чему переходили, что добавляли в корзину и покупали. Узнавать одного человека между визитами для этого не требуется.
«Сессионная» здесь означает, что мы опираемся на действия текущего визита. Выбор модели — отдельное решение. В этой версии я использую граф товаров, несколько источников кандидатов и деревья решений для ранжирования.
Как граф связывает товары
Вершина графа — товар. Направленное ребро показывает, что после просмотра одного товара человек совершил действие с другим: посмотрел его, добавил в корзину или купил. Эти три вида связей храню отдельно.
Граф строю по более раннему, отдельному периоду. Будущие действия сессии, для которой выдаю рекомендации, в него не попадают. После первого просмотра можно пройти по исходящим рёбрам и получить товары, которые встречались позже в других сессиях. Длинная история нового посетителя для этого не нужна.
Между событиями с одинаковым временем направленных рёбер нет: порядок строк в CSV не говорит, что человек сделал раньше. Вклад одной сессии в одно ребро ограничиваю единицей. Действия, близкие по времени, получают больший вес; слишком далёкие друг от друга не связываю.
Редкие связи отбрасываю и ограничиваю число соседей. Если суммарный вес связей от товара мал, дополнительно ослабляю их. Иначе единственный оставшийся сосед после нормировки получил бы вес один — даже если данных о связи совсем мало. Вес показывает силу связи, но не вероятность следующего действия или покупки.
Для каждого кандидата из графа видно, от какого просмотренного товара и по какому виду связи он найден. Это ещё не объясняет причину: товары могли встречаться рядом из-за устройства магазина или прежних рекомендаций. В моей системе граф даёт соседей и признаки для ранжирования. Графовую нейросеть я не обучаю.
Как из 300 кандидатов выбрать 20 товаров
У редко встречавшегося товара может быть мало соседей. Поэтому я добавила ещё два источника кандидатов: сходство описаний и сходство изображений. Готовые векторы есть в наборе Coveo. Я использую их как есть, без обучения моделей, которые переводят текст и изображения в векторы.
В набор также входят просмотренные товары, товары, чьи описания близки к последнему известному поисковому запросу, и исторически популярные товары. Для каждого источника задаю квоту — сколько кандидатов он может предложить. Повторы объединяю, сохраняя сведения обо всех источниках товара. Свободные места заполняю популярными товарами. Получается до 300 различных SKU.
Каждый кандидат должен входить в исторический каталог. Если у товара есть вектор, но его нет в каталоге, предложить его нельзя. Кроме того, метаданные опубликованы одним снимком: неизвестно, были ли они доступны на каждую дату эксперимента. Поэтому я отдельно обучила и проверила вариант без метаданных.
Граф и метаданные дают разные основания предложить товар, поэтому их вклад можно проверять отдельно. В работе DIMO, SIGIR 2024 тоже исследуют разделение сигналов совместной встречаемости и содержательных признаков. Su и соавторы, 2025 используют переходы между товарами при обучении многомодальных представлений с помощью больших языковых моделей. Эти методы я не реализовывала и со своей системой не сравнивала.
Для каждой пары «запрос — товар» рассчитываю признаки: связи с просмотренными товарами, сходство, популярность и источники кандидата. По этим признакам LightGBM учится ставить выше товары, покупки которых зарегистрированы после запроса. Он учитывает сочетания признаков, а не просто складывает баллы разных источников. Итоговый балл задаёт порядок товаров; вероятностью покупки он не является.
-
Берём действия сессии, известные к моменту запроса.
-
Граф, описания, изображения, поиск, история и популярность дают до 300 различных кандидатов.
-
Признаки пары «запрос — товар» и LightGBM определяют порядок кандидатов.
-
В ответ попадают до 20 рекомендаций.
Если целевой товар не попал в кандидаты, ранжировщик уже не сможет его вернуть. Поэтому на одних и тех же сессиях с зарегистрированной целью:
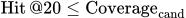
Hit@20 — доля сессий, в которых хотя бы один целевой товар попал в первые 20 рекомендаций. Покрытие кандидатов — доля сессий, в которых хотя бы один целевой товар есть в наборе, из которого получен ответ. Если основной расчёт не успел завершиться и система вернула резерв, беру кандидатов резерва. Незавершённый основной набор не учитываю.
Когда рекомендация не попала в цель, сначала проверяю: был ли нужный товар в каталоге и попал ли он в кандидаты? Если да, смотрю, куда его поставил ранжировщик. Так можно понять, на каком шаге потерялось попадание.
Что получилось на отложенных данных
Для графа, каталога и статистик я использовала 50 000 сессий исторического периода  . Для обучения ранжировщика — другие 50 000 сессий, из более позднего периода
 . В каталог вошли 14 314 SKU. Данные разделены по времени, каждая сессия целиком относится к одному периоду. Будущие покупки не участвуют в расчёте кандидатов и признаков.
В отложенном периоде  подготовлено 60 000 сессий. У 748 из них есть зарегистрированная цель. Именно по этим 748 сессиям считаю Hit@20:
|
Метод |
Попадания |
Hit@20 |
|---|---|---|
|
Граф, метаданные и LightGBM |
441/748 |
58,96% |
|
Последние просмотренные товары с дополнением популярными (R) |
325/748 |
43,45% |
R — обозначение простого метода сравнения, а не Recall. Он возвращает последние просмотренные товары и дополняет список популярными. Обученного ранжировщика у него нет. Такой способ может попасть в цель, предложив товар, который посетитель уже смотрел и позже купил.
У остальных 59 252 сессий цель неизвестна, поэтому в Hit@20 они не входят. А сессии с зарегистрированной целью вне каталога остаются в знаменателе. Так метрика учитывает и покупки товаров, которые система вообще не могла предложить.
На этом наборе разница составила 15,51 процентного пункта. Но статистическое превосходство я не заявляю: не удалось достаточно обосновать предположения о временной зависимости, чтобы получить пригодный доверительный интервал. Статус статистического вывода — insufficient.
Результат относится к историческому периоду . Влияние рекомендаций на покупки в A/B-эксперименте не проверялось. Как система сработает на сегодняшнем ассортименте, тоже пока неизвестно.
Как запустить проект
В репозитории есть весь путь: подготовка данных, построение исторического пакета, расчёт признаков, обучение, оценка и локальный сервис. Состояние сессии и признаки рассчитываются одним и тем же кодом при обучении и выдаче рекомендаций.
Для API проверены четыре сценария: обычный запрос, повтор без пересчёта, резервный ответ при вычислительном тайм-ауте и отказ без рекомендаций, когда состояние сессии неполно.
В инструкции запуска есть команды и пример ответа. Я установила собранный пакет в отдельное окружение и проверила весь процесс на небольшой реальной выборке: от трёх исходных CSV до модели и отчёта на  . Файлы прежних запусков для этого не понадобились.
Этот прогон проверил инструкцию на малом объёме; полный результат на в нём не воспроизводился. Данные и обученная модель в Git не распространяются. API проверен локально, испытаний под рабочей нагрузкой пока не было.
В следующей статье разберу вопрос, который изменил постановку задачи: как считать качество, если отсутствие записи о покупке ещё не означает, что покупки не было?
ссылка на оригинал статьи https://habr.com/ru/articles/1095354/