При подготовке данных Coveo для сессионной рекомендательной системы мне пришлось разобраться, как учить и проверять модель, если неизвестно, все ли покупки попали в выгрузку.
Для итоговой оценки на Coveo я подготовила 60 000 сессий. Но Hit@20 посчитала только по 748: в них есть зарегистрированная покупка после запроса. Модель дала 441 попадание — 58,96%.
Что произошло с остальными 59 252 сессиями? Я не записала их в промахи. Если строки purchase нет, это ещё не значит, что посетитель ничего не купил.
В первой статье я описала сессионную рекомендательную систему на Coveo: граф и другие источники находят товары-кандидаты, а LightGBM выбирает до 20 рекомендаций. Модель уже обучена, качество измерено, есть локальный HTTP API.
Репозиторий проекта: RecSys-Coveo.
Почему пришлось изменить задачу
Я использую Coveo SIGIR eCOM 2021, Public Data Release 1.0.0. В наборе три CSV: действия посетителей, поисковые запросы и признаки товаров. Авторы предупреждают, что регистрация событий в браузере может быть неполной. Даже порядок строк в файле не гарантирует порядок действий: последовательность приходится восстанавливать по идентификатору сессии и времени события.
Изначально я хотела различать покупку и её отсутствие. Для этого нужно знать, что все покупки попали в выгрузку. При проверке Coveo такого подтверждения не нашлось.
Поэтому я ограничила цель товарами из последующих зарегистрированных покупок. Пустая цель получила статус «неизвестна». Обучающие сравнения и Hit@20 теперь опираются на сессии, в которых цель есть.
Сессии без цели остались в выборке. Система всё равно должна отвечать на их запросы: в момент рекомендации она не знает, появится ли потом запись о покупке.
При подготовке я читаю все опубликованные строки выбранной сессии — действия и поиск. Потеря строк в моём коде была бы ошибкой подготовки. Но чтение всех строк не доказывает, что все покупки зарегистрированы. Даже если одна покупка записана, сведения о других могут отсутствовать.
Что модель знает в момент запроса
Сессии уже выделены в Coveo: у действий одного визита общий обезличенный идентификатор. По описанию данных, перерыв более 30 минут начинает новую сессию. Идентификаторы товаров тоже обезличены; дальше называю их SKU.
Для рекомендации беру первый просмотр товара с корректным SKU. Если несколько событий имеют одну отметку времени, учитываю их вместе: нельзя определить, какое произошло раньше. Если после этого в сессии ещё нет записи о покупке, формирую одну выдачу. Если покупка уже записана, запрос не допускается. Более поздние выдачи этой сессии в эксперимент не входят.
Вот условный пример. Буквы обозначают товары. В таблице время округлено до минут для читаемости; в расчёте использую исходные отметки с точностью до миллисекунды.
|
Время |
Что записано |
Как используется |
|---|---|---|
|
09:59 |
Поиск |
Доступен модели |
|
10:00 |
Просмотр A |
Доступен модели |
|
После блока 10:00 |
Выдача рекомендаций |
Момент запроса |
|
10:04 |
Просмотр B |
Ещё неизвестен в момент запроса |
|
10:10 |
Покупка B |
Входит в цель |
|
10:15 |
Покупка C |
Входит в цель |

Модель видит поиск и просмотр A. Просмотр B случился позже, поэтому добавлять его в признаки нельзя — даже если при подготовке мы уже прочитали всю сессию. Покупки B и C дают цель  для сессии
 . Для попадания в метрике достаточно угадать хотя бы один из этих товаров. Повторная запись покупки B размер цели не увеличит.
Покупки ищу строго после запроса, в пределах следующих 24 часов той же сессии. Если опубликованные записи заканчиваются раньше, окно цели заканчивается на последней записи.
Обозначу момент запроса через  , горизонт через
 часа, а время последней опубликованной записи поведения или поиска — через
 . Тогда правая граница окна:
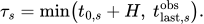
В цель входят все различные SKU зарегистрированных покупок той же сессии при  .
В примере окно заканчивается в 10:15, если это последняя опубликованная запись. О возможных покупках позднее она ничего не сообщает. Сама сессия не становится суточной: 24 часа — предел поиска цели, а границы визита уже заданы в Coveo.
Сначала выбираю сессии, потом смотрю покупки
Данные я заранее разделила на непересекающиеся отрезки времени — периоды для построения исторического пакета, обучения и проверки качества. Их границы, размеры выборок и правило отбора закрепила до анализа покупок. Сессии упорядочиваются по хешу ID с фиксированным начальным значением; из этого порядка берётся заданное число целых сессий. Для каждой читаются все строки поведения и поиска.
Если сессий не хватило, я не добираю их специально по наличию покупки. Будущая покупка также не влияет на момент запроса.
Исторический период  нужен для каталога, графа и статистик. Следующий период,
 , — для обучения ранжировщика. Если оставить в только сессии с покупками, из истории исчезнут просмотры и действия с корзиной всех остальных посетителей. Изменятся и популярность, и связи между товарами. Поэтому исторический пакет строю по всем сохранённым сессиям .
Запрос допускаю к расчёту, только если от момента рекомендации до конца соответствующего периода остаётся больше 24 часов 30 минут: сутки для поиска целевых покупок в той же сессии и ещё полчаса запаса. Так окно цели не захватывает следующий период.
Правило действует и для коротких сессий, чьи записи заканчиваются раньше суток. Для периода  проверяю:
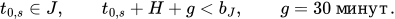
Здесь  и
 — начало и конец периода. Для дополнительно требуется
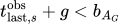 . Если последнее событие слишком позднее, исключаю всю сессию — независимо от того, был это просмотр, поиск или покупка.
Эти правила одинаковы для сессий с покупкой и без неё. Запас защищает границы периодов, но не доказывает полноту записей. В признаки запроса входят только события, известные к его моменту, и исторические справочники.
Откуда тогда берутся нулевые метки
В подготовленных 50 000 сессий периода зарегистрированная цель есть у 625. По этим запросам обучаю ранжировщик. Сначала фиксируется вся выборка, затем по последующим записям определяется, какие запросы дают обучающие сравнения. При отборе кандидатов и расчёте признаков эта информация недоступна.
У каждого такого запроса свой набор кандидатов. Товар получает метку 1, если его SKU входит в цель, и 0 — если не входит.
Вернёмся к примеру: в цель попали B и C, а отбор предложил A, B и X. У этих кандидатов будут метки 0, 1 и 0. Парное обучение требует поставить B выше A и X. Товара C в наборе нет, хотя он тоже входит в цель.
Ноль у A и X означает только одно: этих SKU нет в зарегистрированной цели. Посетитель мог вообще не увидеть X, а сведения о покупке могли не попасть в данные. Для обучения я принимаю допущение: кандидат с зарегистрированной покупкой должен стоять выше остальных кандидатов.
Это обучение по неявной обратной связи. На данные продолжают влиять прежние показы и популярность товаров. Балл LightGBM задаёт порядок рекомендаций; вероятность покупки из него я не получаю.
Не каждая из 625 сессий даёт обучающие пары: нужен хотя бы один кандидат с меткой 1 и один с меткой 0. Если отбор вернул только A и X, обе метки равны нулю — такой запрос не даёт обучающих пар. Добавить B или C специально ради обучения означало бы подсказать системе будущую покупку.
При оценке такая сессия всё равно остаётся в выборке. Отбор пропустил цель, и этот промах должен попасть в результат.
Почему в знаменателе 748, а не 60 000
В итоговом периоде  каждая из 748 сессий с зарегистрированной целью даёт одно наблюдение: попал ли хотя бы один целевой SKU в первые 20 рекомендаций. Несколько покупок, повторные записи или несколько угаданных товаров не увеличивают вклад сессии.
У основной модели 441 такое попадание:
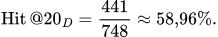
Если поделить те же 441 попадание на все 60 000 сессий, получится 0,735%. Это другой показатель: доля всех подготовленных сессий с зарегистрированным попаданием. Он зависит ещё и от того, как часто в данных появляется цель. Hit@20 показывает, как часто рекомендации совпали с целью среди сессий, где она записана. Ни один из этих процентов не устанавливает конверсию посетителей.
Все методы сравниваю на одних и тех же 748 сессиях. Купленный товар остаётся в цели, даже если его нет в каталоге или среди кандидатов. Если системе недоступны все целевые товары, сессию всё равно учитываю в знаменателе.
Оцениваю именно доставленный ответ. Если основной расчёт заменён резервным списком, проверяю попадание резерва. Если допустимый ответ не доставлен в срок, результат считается пустым и даёт промах.
Сессии без цели использую для проверки времени расчёта и отказов.
Что эти проценты позволяют утверждать
Регистрация событий и прежние показы могли повлиять на то, какие сессии получили цель. Доверительный интервал сам по себе это смещение не исправит.
Отдельный вопрос — как оценить статистическую погрешность Hit@20. Сессии, происходящие близко по времени, могут быть связаны общими условиями: временем суток, акциями или изменениями ассортимента. Тысяча сессий за один вечер не обязательно даёт столько же независимой информации, сколько тысяча сессий за несколько недель.
Для учёта этой связи я предусмотрела расчёт доверительного интервала по временным блокам. Но предварительная выборка охватывала менее недели допустимых моментов рекомендации, и в ней был заметен суточный цикл. Этого оказалось недостаточно, чтобы обосновать выбранную длину блока — шесть часов. Поэтому надёжность интервала не подтверждена, а статус статистического вывода — insufficient. Это не ошибка в расчёте Hit@20 и не следствие неполноты записей о покупках.
Различия с другими методами описывают результат на выбранном периоде; статистическое превосходство я не заявляю. Показов моей системы в выгрузке нет, A/B-эксперимент не проводился. Совпадение рекомендации с исторической покупкой не измеряет прирост продаж.
Как это проверяется в коде
Правила закреплены тестами. Покупка с той же отметкой времени, что и первый просмотр, не допускает запрос. Покупка точно на правой границе окна входит в цель, а следующая отметка за границей — уже нет. Повтор SKU не увеличивает цель. Отдельно проверяется, что сессия с целью вне каталога остаётся в знаменателе Hit@20.
Команды есть в инструкции воспроизведения. Я установила собранный пакет в отдельное окружение и проверила весь путь на небольшой реальной выборке: от трёх исходных CSV до модели и отчёта. Результаты прежних запусков для этого не понадобились.
Этот прогон проверил инструкцию, но не повторял полный расчёт на . API проверен локально; испытаний под рабочей нагрузкой пока не было.
В следующей статье покажу, как получается сама выдача: от графа и метаданных до признаков и LightGBM.
ссылка на оригинал статьи https://habr.com/ru/articles/1095468/