Доброго времени суток, коллеги.
Продолжаю небольшой цикл о том, что происходит между человеческим разрешением и реальным действием AI-агента в системе.
В первой статье — «Нажали Approve на одно действие, а workflow попытался выполнить другое: разбор n8n + MCP + Bitrix24» — я разбирал разрыв между тем, что человек одобрил, и тем, что workflow фактически попытался выполнить.
Во второй — «ИИ-агенту запретили запись в CRM. Но CRM всё равно изменилась» — мы смотрели на другую границу: права модели и фактические возможности всей системы не одно и то же.
На этот раз давайте разберём ещё один способ, которым система может выйти за пределы заданных человеком границ.
Если сформулировать общий вопрос цикла совсем просто, то он звучит так:
как дать агенту достаточно свободы, чтобы он оставался полезен бизнесу, но при этом не позволить системе превратить выданное человеком поручение в более широкое полномочие?
В этот раз проблема выглядит весьма просто:
-
человек разрешил системе заказать не больше 100 единиц товара;
-
система трижды сказала ALLOW;
-
в ERP в итоге оказалось 120.
На первый взгляд кажется, что это какая-то арифметическая ошибка. Но архитектурно это куда более интересная история.
Проблема в том, что каждая отдельная проверка прошла корректно, а итоговое бизнес-состояние всё равно оказалось неправильным.
Локально всё выглядело допустимым, но глобально система вышла за пределы разрешённого.
Сценарий
Человек разрешил workflow заказать не больше 100 единиц товара. Workflow сформировал три заказа:
Поставщик A: 40Поставщик B: 40Поставщик C: 40
Каждый запрос прошёл через слой авторизации:
Заказ A → ALLOWЗаказ B → ALLOWЗаказ C → ALLOW
А затем независимое чтение ERP показало итог: 120.
Ни один запрос не обошёл контроль. Ни один отдельный заказ не превышал 100. Авторизационный компонент отработал именно так, как был запрограммирован. Но совокупный результат вышел за границу, которую задал человек.
Мы собрали небольшой воспроизводимый стенд, чтобы проверить три реализации одного и того же ограничения. Сначала проверили последовательную схему. Затем взяли stateful-проверку, которая всё равно ломается при конкурентном исполнении. Наконец проверили вариант, где часть общего разрешения резервируется атомарно до обращения к ERP.
Контроль отвечал не на тот вопрос
На бытовом уровне хочется сказать: «Значит, считать надо было лучше». Но для архитектуры и контроля проблема глубже.
Человек сформулировал общее ограничение:
Этот workflow может заказать не больше 100 единиц COMP-17 у разрешённых поставщиков.
Простейшая проверка легко превращает его в другое правило:
if requested_quantity <= 100: return "ALLOW"
Она отвечает на вопрос: «Этот конкретный заказ не больше 100?» Но исходное разрешение означало: «Останется ли сумма всех заказов в пределах 100?»
Это принципиально разные вопросы: локальная допустимость отдельного шага не гарантирует допустимость итогового совокупного результата.
Для трёх запросов по 40 разница очевидна. Каждый запрос локально допустим, но общий результат уже недопустим.
В нашем стенде grant связан с субъектом planner-1, ресурсом COMP-17, списком поставщиков SUP-A/SUP-B/SUP-C и общим пределом 100. Планировщик детерминированный: никакой LLM в эксперименте нет. Это сделано специально, чтобы не смешивать механизм авторизации с качеством рассуждений модели.
В последовательном режиме stateful-контроль уже видит накопленное потребление:
A: 0 + 40 ≤ 100 → ALLOWB: 40 + 40 ≤ 100 → ALLOWC: 80 + 40 > 100 → DENY
В ERP остаётся 80. Кажется, проблема решена. Но только пока запросы приходят строго один за другим.
Добавили состояние, но всё равно получили 120
Уязвимый вариант хранит использованную величину, но разделяет чтение, решение, исполнение и обновление:
прочитать расход→ проверить остаток→ разрешить→ выполнить заказ→ обновить расход
При конкурентном запуске три обработчика успевают прочитать одно и то же значение: 0. После чтения стенд намеренно удерживает их на барьере, а затем отпускает одновременно:
A читает 0 → 0 + 40 ≤ 100 → ALLOWB читает 0 → 0 + 40 ≤ 100 → ALLOWC читает 0 → 0 + 40 ≤ 100 → ALLOW
Все три заказа создаются в Demo ERP. Итоговый объём равен 120. Учёт полномочий тоже в конце достигает 120, то есть здесь нет потерянного обновления и нет повторного начисления за одну операцию. Ошибка возникает раньше: система допускает действие к исполнению, не закрепив за ним часть общего лимита.
Это классическая гонка check-then-act. Она не появилась из-за ИИ и возможна в обычном сервисе. Эксперимент не измеряет её естественную частоту: барьер принудительно создаёт один раскрытый порядок событий. Его задача скромнее: показать, что локально корректные решения могут сложиться в недопустимый результат, если допуск не связан атомарно с общим состоянием.
Отсюда важное различие:
решение ALLOW≠ доказательство того, что действие укладывается в делегированный общий мандат
ALLOW говорит только о том, что конкретная реализация контроля пропустила запрос.
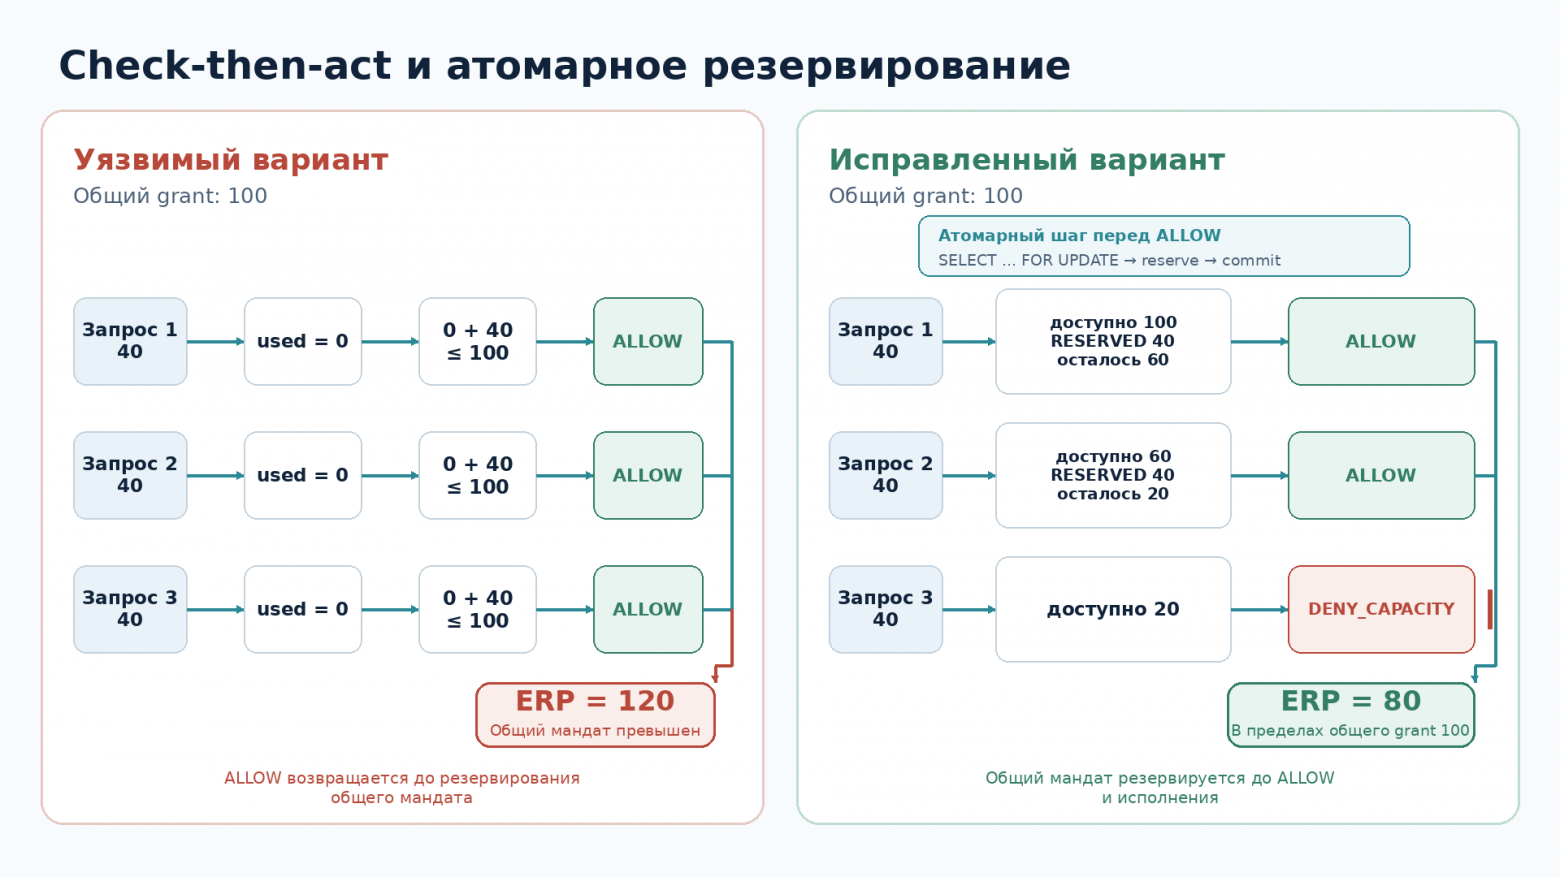
Без атомарного резервирования три локально допустимых решения могут вместе превысить один общий мандат.
Недостающая операция: резервирование
В исправленном варианте gateway до исполнения заказа выполняет транзакцию:
BEGIN→ SELECT grant_balance FOR UPDATE→ проверить ресурс, поставщика и остаток→ создать RESERVED и списать доступную величину→ COMMIT→ вернуть ALLOW→ вызвать ERP
Ключевой момент: проверка и резервирование происходят как один защищённый переход состояния. Когда один запрос зарезервировал 40, эти 40 уже недоступны остальным, даже если запись в ERP ещё не завершилась.
В конкурентном прогоне два запроса получают ALLOW, а третий получает DENY_CAPACITY:
первый запрос → RESERVED 40 → ALLOW → COMMITTEDвторой запрос → RESERVED 40 → ALLOW → COMMITTEDтретий запрос → доступно 20 → DENY_CAPACITY
Какой именно поставщик окажется третьим, несущественно и при конкуренции не обязан быть детерминирован. Существенен инвариант: два заказа исполнены, один отклонён до вызова ERP, итог в ERP равен 80.
В проверенной реализации это сделано на PostgreSQL: READ COMMITTED и блокировка строки через SELECT ... FOR UPDATE. Процессный mutex, очередь или SERIALIZABLE не используются. Это не единственный возможный производственный дизайн, а проверка конкретного механизма: решение авторизации и резервирование общей величины становятся одним защищённым переходом состояния до внешнего эффекта.
Почему это относится к агентам
Сама гонка универсальна. Агентный контекст важен по другой причине.
Человек обычно делегирует не фиксированный список вызовов API, а результат: «закупи до 100 единиц», «верни клиентам не больше 50 000 рублей», «отправь сообщения не более чем 200 адресатам». Модель или workflow уже во время исполнения разбивает цель на действия. Их число заранее не обязательно известно; они могут выполняться параллельно, повторяться после ошибки или передаваться субагентам.
У каждого отдельного вызова могут быть допустимые параметры. Но разрешение человека относится к совокупному последствию.
Поэтому авторизация на уровне отдельных инструментов необходима, но не всегда достаточна. Когда несколько действий расходуют один конечный мандат, контроль должен знать общий идентификатор grant, его scope и остаток. А модель не должна сама решать, достаточно ли у неё полномочий на собственное предложение: это задача enforcement point на границе исполнения.
Такой «расходуемый мандат» нужен не каждой операции. Он имеет смысл там, где разрешение действительно конечно или одноразово: общий объём закупки, платёжный лимит, потолок возвратов, число внешних сообщений, разовое согласование изменения инфраструктуры. Обычную квоту CPU или rate limit не стоит автоматически называть делегированными полномочиями.
ALLOW, ответ API и итоговое состояние: разные доказательства
В стенде мы разнесли несколько слоёв свидетельств:
grant→ запрос→ решение авторизации→ reservation→ вызов исполнителя→ ответ ERP→ новое чтение ERP
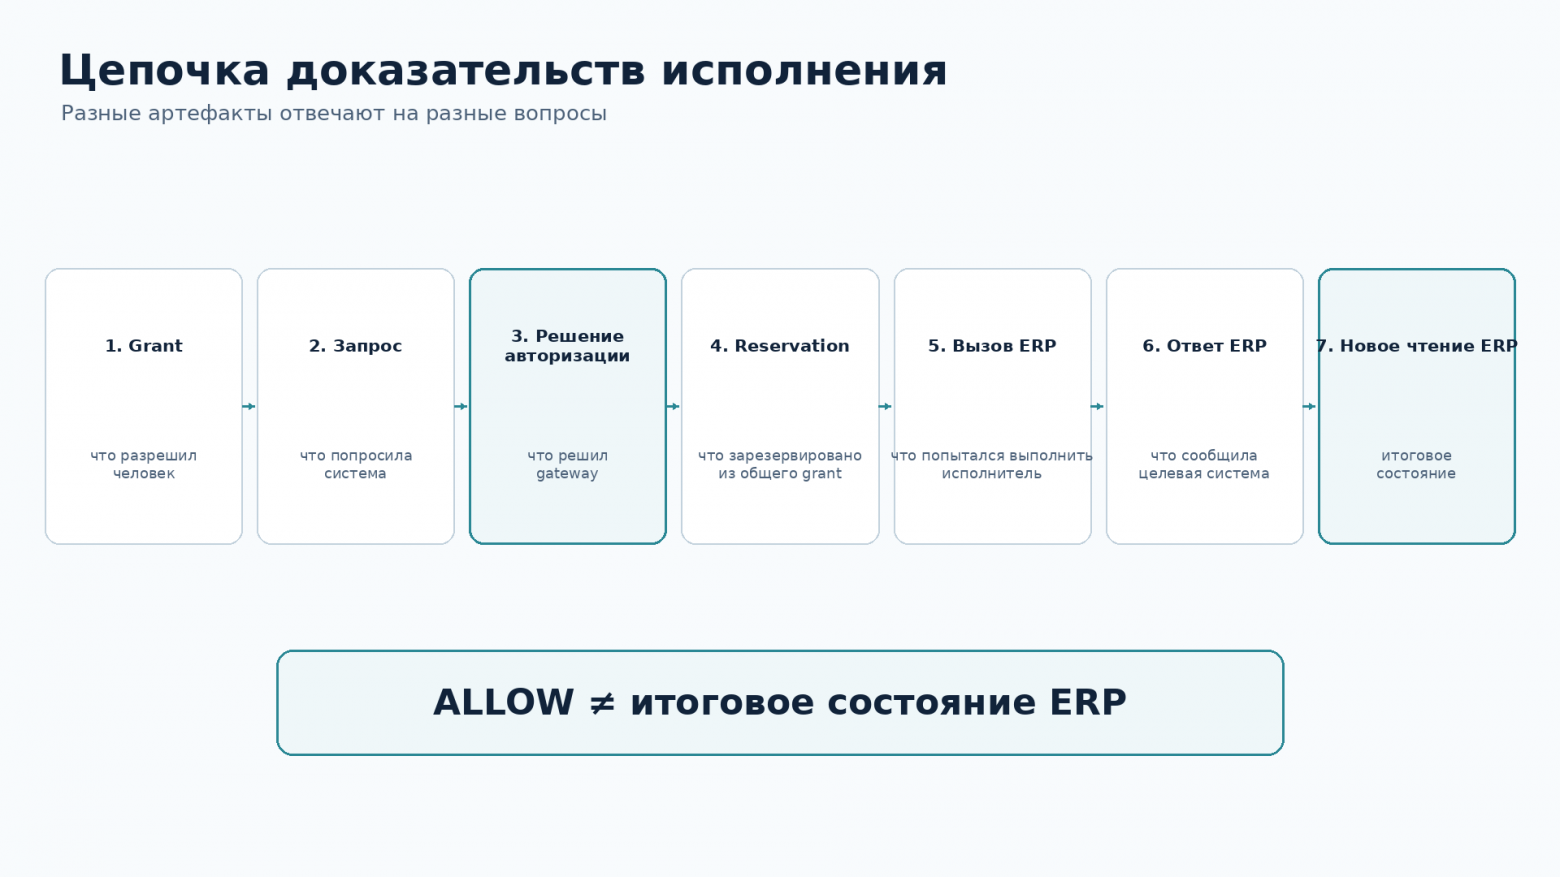
Решение авторизации, вызов исполнителя и устойчивое состояние целевой системы относятся к разным слоям свидетельств.
Они отвечают на разные вопросы. Grant показывает, что разрешил человек. Лог авторизации показывает, что решил gateway. Reservation показывает, какая часть общего разрешения стала недоступна другим операциям. Вызов показывает, что попытался сделать исполнитель. Ответ ERP показывает, что сообщила целевая система. И только повторное чтение показывает её устойчивое итоговое состояние.
Поэтому результаты 120 и 80 взяты не из ответов планировщика и не из числа ALLOW. Они рассчитаны по полным сохранённым записям Demo ERP, прочитанным отдельным компонентом.
Есть и ещё одна граница. После ALLOW внешняя система может не ответить: заказ мог сохраниться, а подтверждение могло потеряться. Неизвестный результат нельзя автоматически считать отсутствием внешнего эффекта и сразу возвращать зарезервированное полномочие в доступный остаток. В проверенном варианте оно остаётся списанным до reconciliation. Это консервативно и может удерживать неиспользованный остаток неопределённо долго; полноценная recovery-модель в эксперимент не входит.
Пять вопросов перед продом
Если агент получает общий бизнес-лимит, я бы свёл проверку к пяти вопросам:
-
Что именно разрешил человек: лимит на одно действие или общий предел на всю задачу?
-
Что связывает все действия с одним grant: где хранится его scope, общий остаток и кто имеет право менять это состояние?
-
Связан ли
ALLOWс атомарным резервированием полномочия до внешнего эффекта? -
Могут ли параллельные ветки, субагенты, альтернативные пути или повторные попытки независимо потратить один и тот же остаток?
-
Как подтверждается итог: что происходит при успехе, ошибке и неизвестном результате, и проверяется ли состояние целевой системы независимо от логов авторизации?
Этот список не превращает демонстрационный gateway в production-архитектуру. В стенде нет динамического отзыва, истечения grant, пересекающихся разрешений, общей модели доступности и полного восстановления. Demo ERP и authority database логически разделены, но работают на одном PostgreSQL-сервере. Инфраструктура считается доверенной.
Как воспроизвести
Код, зафиксированная спецификация, 44 теста, четыре полных репрезентативных набора свидетельств по восьми сохранённым файлам в каждом, индекс всех формальных запусков и контрольные суммы опубликованы в GitHub Зафиксированный тег: shared-cumulative-authority-v1.0. Финальный commit, на который указывает публикационный tag: 524db880699655b76d5021b967c4118370702e58.
Проверка завершилась с результатом 44 теста PASS и 38 из 38 валидных формальных прогонов. В публичный пакет вошли полные данные четырёх характерных запусков; для остальных 34 опубликован компактный индекс результатов, а не сырые наборы свидетельств. Повтор на свежем runtime выполнял тот же оператор, поэтому это воспроизводимость в новом окружении, но не независимая репликация другим исследователем.
Команды и ожидаемые результаты вынесены в REPRODUCE.md. Границы выводов находятся в VALIDATION_SUMMARY.md, а исходные артефакты находятся в evidence/.
В этом и есть практический смысл всей серии. В production нас интересует не красивое слово ALLOW само по себе, а цепочка от человеческого намерения до реального последствия: что именно было разрешено, во что это разрешение превратилось в runtime, что система реально выполнила и какими свидетельствами это можно проверить.
Вывод у этого эксперимента узкий. Он не доказывает, что агентные системы в целом небезопасны, и не предлагает универсальную схему авторизации.
Он показывает конкретный механизм: если несколько действий расходуют один общий мандат, ALLOW должно быть связано с атомарным изменением состояния до исполнения. Иначе три локально допустимых решения легко превращаются в результат, которого человек не разрешал.
ссылка на оригинал статьи https://habr.com/ru/articles/1095622/