В этой статье я делюсь опытом развертывания и предлагаю заглянуть в настройку этой технологии — сетевой стек на базе Gateway API и Cilium, выступающего в роли балансировщика. Это практический стенд, демонструет возможности Cilium и декларативный подход к маршрутизации в локальной среде.
⚠️ Параметры тестового стенда:
Все тесты проводятся на Linux-системе. Кластер из 9 нод (1 control-plane + 8 воркеров) успешно разворачивается и стабильно работает на ноутбуке с 4 ЦПУ и 16 Гб ОЗУ.
На первом этапе поднимается тестовый Kubernetes-кластер с помощью Kind. В Конфигурация мы отключаем стандартный CNI и kube-proxy, чтобы запустить Cilium. В качестве базового стандарта и правильной архитектурной привычки воркер-ноды на уровне конфигурации строго разделены на пулы по своим ролям (системные компоненты, базы данных инфраструктуры, MLflow, SeaweedFS и Web). Направленная изоляция рабочих нагрузок реализуется с помощью механизмов ограничений (taints) и меток (labels). Такая прозрачная топология позволяет наглядно увидеть, как именно трафик распределяется внутри кластера.
Команда для инициализации кластера
kind create cluster --name testlb --config infrastructure/kind/kind-config.yaml
Манифест для Kind — infrastructure/kind/kind-config.yaml
kind: ClusterapiVersion: kind.x-k8s.io/v1alpha4 networking: disableDefaultCNI: true # Отключаем автоматическую установку Kindnet kubeProxyMode: "none" # Убираем kube-proxynodes:- role: control-plane# systempool- role: worker# DATABASES - jupyterhub & mlflow- role: worker kubeadmConfigPatches: - | kind: JoinConfiguration nodeRegistration: kubeletExtraArgs: node-labels: "databasesnode=yesnaff" register-with-taints: "databasetaint=yestaint:NoSchedule"- role: worker kubeadmConfigPatches: - | kind: JoinConfiguration nodeRegistration: kubeletExtraArgs: node-labels: "databasesnode=yesnaff" register-with-taints: "databasetaint=yestaint:NoSchedule"- role: worker kubeadmConfigPatches: - | kind: JoinConfiguration nodeRegistration: kubeletExtraArgs: node-labels: "databasesnode=yesnaff" register-with-taints: "databasetaint=yestaint:NoSchedule"# mlflow- role: worker kubeadmConfigPatches: - | kind: JoinConfiguration nodeRegistration: kubeletExtraArgs: node-labels: "mlflownode=yesnaff" register-with-taints: "mlflowtaint=yestaint:NoSchedule"# seaweedfs- role: worker kubeadmConfigPatches: - | kind: JoinConfiguration nodeRegistration: kubeletExtraArgs: node-labels: "seaweedfsnode=yesnaff" register-with-taints: "seaweedfstaint=yestaint:NoSchedule"# WEB- role: worker kubeadmConfigPatches: - | kind: JoinConfiguration nodeRegistration: kubeletExtraArgs: node-labels: "webnode=yesnaff" register-with-taints: "webtaint=yestaint:NoSchedule"- role: worker kubeadmConfigPatches: - | kind: JoinConfiguration nodeRegistration: kubeletExtraArgs: node-labels: "webnode=yesnaff" register-with-taints: "webtaint=yestaint:NoSchedule"
Бывает, что Kind не собирает кластер
Альтернативный запуск Kind с флагом —retain
kind create cluster --name testlb --config infrastructure/kind/kind-config.yaml --retain
Копируем /etc/kubernetes/admin.conf из контейнера testlb-control-plane
docker exec -it testlb-control-plane cat /etc/kubernetes/admin.conf > ~/.kube/config
Проверяем control-plane
kubectl get noOutput:NAME STATUS ROLES AGE VERSIONtestlb-control-plane NotReady control-plane 2m59s v1.37.0
Генерация команды подключения нод с флагом —print-join-command через docker exec
docker exec -it testlb-control-plane kubeadm token create --print-join-command
Output:
kubeadm join testlb-control-plane:6443 —token uvukvj.40pf1jzlosjffgar —discovery-token-ca-cert-hash sha256:ee6183fc29377ab060e9e5ff01b2956611ea9b8a153cd2696dd5b3da4316d644
К полученному выводу для тестового окружения добавляем флаг в конце команды —ignore-preflight-errors=SystemVerification,Swap
docker ps --format '{{.Names}}' | grep testlb-worker | xargs -I {} docker exec -t {} kubeadm join testlb-control-plane:6443 --token uvukvj.40pf1jzlosjffgar --discovery-token-ca-cert-hash sha256:ee6183fc29377ab060e9e5ff01b2956611ea9b8a153cd2696dd5b3da4316d644 --ignore-preflight-errors=SystemVerification,Swap
docker ps —format ‘{{.Names}}’ | grep testlb-worker | xargs -I {} docker exec -t {} kubeadm join testlb-control-plane:6443 —token uvukvj.40pf1jzlosjffgar —discovery-token-ca-cert-hash sha256:ee6183fc29377ab060e9e5ff01b2956611ea9b8a153cd2696dd5b3da4316d644 —ignore-preflight-errors=SystemVerification,Swap
Проверяем ноды кластера
kubectl get no# Output:NAME STATUS ROLES AGE VERSIONtestlb-control-plane NotReady control-plane 17m v1.37.0testlb-worker NotReady <none> 2m31s v1.37.0testlb-worker2 NotReady <none> 2m23s v1.37.0testlb-worker3 NotReady <none> 2m27s v1.37.0testlb-worker4 NotReady <none> 2m22s v1.37.0testlb-worker5 NotReady <none> 2m30s v1.37.0testlb-worker6 NotReady <none> 2m26s v1.37.0testlb-worker7 NotReady <none> 2m29s v1.37.0testlb-worker8 NotReady <none> 2m24s v1.37.0
Если используется схема “K8s in Docker” через kubeadm join, то метки и тейнты нужно добавить вручную командами kubectl label и kubectl taint.
Если имя кластера — testlb, то это можно сделать одной строкой
w_idx=1; while read -r line; do if [[ "$line" =~ "role: worker" ]]; \then [ $w_idx -eq 1 ] && name="testlb-worker" || name="testlb-worker$w_idx"; num=$(echo "$line" | cut -d: -f1); \labels=$(sed -n "$num,/role:/p" infrastructure/kind/kind-config.yaml | grep "node-labels:" | \sed -E 's/.*node-labels:[[:space:]]*"([^"]+)".*/\1/'); taints=$(sed -n "$num,/role:/p" infrastructure/kind/kind-config.yaml | grep "register-with-taints:" | \sed -E 's/.*register-with-taints:[[:space:]]*"([^"]+)".*/\1/'); [ -n "$labels" ] && kubectl label node "$name" "$labels" --overwrite; [ -n "$taints" ] \&& kubectl taint node "$name" "$taints" --overwrite; ((w_idx++)); fi; done < <(grep -n "role:" infrastructure/kind/kind-config.yaml)# Output:node/testlb-worker2 labelednode/testlb-worker2 modifiednode/testlb-worker3 labelednode/testlb-worker3 modifiednode/testlb-worker4 labelednode/testlb-worker4 modifiednode/testlb-worker5 labelednode/testlb-worker5 modifiednode/testlb-worker6 labelednode/testlb-worker6 modifiednode/testlb-worker7 labelednode/testlb-worker7 modifiednode/testlb-worker8 labelednode/testlb-worker8 modified
Проверим taints тестовых нод в Kind
kubectl get no -o custom-columns="NAME:.metadata.name,TAINTS:.spec.taints[*].key"# Output:NAME TAINTStestlb-control-plane node-role.kubernetes.io/control-planetestlb-worker <none>testlb-worker2 databasetainttestlb-worker3 databasetainttestlb-worker4 databasetainttestlb-worker5 mlflowtainttestlb-worker6 seaweedfstainttestlb-worker7 webtainttestlb-worker8 webtaint
Проверяем метки
kubectl get no --show-labels | awk 'NR==1 {printf "%-25s %s\n", "NAME", "YESNAFF_LABELS"} NR>1 {labels=""; \for(i=1;i<=NF;i++) if($i ~ /=yesnaff/) {split($i, a, ","); for(j in a) if(a[j] ~ /=yesnaff/) labels=labels a[j] " "}; \if(labels=="") labels="<none>"; printf "%-25s %s\n", $1, labels}'# Output:NAME YESNAFF_LABELStestlb-control-plane <none>testlb-worker <none>testlb-worker2 databasesnode=yesnaff testlb-worker3 databasesnode=yesnaff testlb-worker4 databasesnode=yesnaff testlb-worker5 mlflownode=yesnaff testlb-worker6 seaweedfsnode=yesnaff testlb-worker7 webnode=yesnaff testlb-worker8 webnode=yesnaff
Проверяем StorageClasses
kubectl get storageclasses.storage.k8s.io# Output:No resources found
Если ресурсы SC не найдены, то устанавливаем их следующим образом
kubectl apply -f https://raw.githubusercontent.com/rancher/local-path-provisioner/v0.0.37/deploy/local-path-storage.yaml
Создаём дополнительный StorageClass “standard”. Kind создаёт SC с именем standard по умолчанию
kubectl apply -f - <<EOFapiVersion: storage.k8s.io/v1kind: StorageClassmetadata: name: standardprovisioner: rancher.io/local-pathvolumeBindingMode: WaitForFirstConsumerreclaimPolicy: DeleteallowVolumeExpansion: falseEOF
Проверяем SC
kubectl get storageclasses.storage.k8s.io# Output:NAME PROVISIONER RECLAIMPOLICY VOLUMEBINDINGMODE ALLOWVOLUMEEXPANSION AGElocal-path rancher.io/local-path Delete WaitForFirstConsumer false 2m14sstandard rancher.io/local-path Delete WaitForFirstConsumer false 2m7s
Архитектурное планирование: проектируем топологию кластера
В реальном продакшене базы данных, тяжелые хранилища и веб-сервисы принято разносить по изолированным пулам нод. В нашем локальном окружении Kind мы частично сымитируем эту серьезную топологию. Это позволит наглядно протестировать механизмы планирования подов (Scheduling), изоляцию ресурсов и, главное, отказоустойчивость сети под управлением Cilium.
Для демонстрации мы спроектируем кластер со следующей логикой распределения нагрузок:
-
Системный пул (System нода) — одна нода без дополнительных меток и тейнтов. Она предназначена для служебных компонентов кластера и сервисов, которые потребляют меньше всего ресурсов.
-
Базы данных (JupyterHub DB + MLflow DB) — в идеальном мире под каждую БД выделяется своя нода. Однако для оптимизации ресурсов нашей локальной машины мы совместим инфраструктурные базы данных для JupyterHub и MLflow на общем пуле из трёх нод. Чтобы обычные поды туда случайно не попадали, мы закроем эти ноды специальным запрещающим тейнтом (Taint) и добавим опознавательный лейбл.
-
Сервисы приложений (JupyterHub + MLflow) — сами управляющие интерфейсы и воркеры JupyterHub и MLflow мы поселим вместе на одной выделенной ноде. Это для экономии ресурсов.
-
SeaweedFS — для работы с S3-совместимым хранилищем мы выделим одну независимую ноду.
-
Сетевой пул (Web-ноды) — две выделенные ноды, на которых мы развернем целевую веб-нагрузку. Именно на этом пуле мы будем тестировать отказоустойчивость, балансировку трафика и High Availability (HA) с помощью Cilium LoadBalancer.
Такое разделение позволит нам гибко управлять распределением подов через выражения nodeAffinity и tolerations, а также наглядно увидеть, как Cilium мгновенно перенаправляет трафик на выжившую веб-ноду при имитации аварии и отключении одного из узлов.
Установка Gateway API CRD
# Определяем базовый URL для CRDGW_API="https://raw.githubusercontent.com/kubernetes-sigs/gateway-api/v1.6.1/config/crd/standard"kubectl apply --server-side -f ${GW_API}/gateway.networking.k8s.io_gatewayclasses.yaml \ -f ${GW_API}/gateway.networking.k8s.io_gateways.yaml \ -f ${GW_API}/gateway.networking.k8s.io_httproutes.yaml \ -f ${GW_API}/gateway.networking.k8s.io_referencegrants.yaml \ -f ${GW_API}/gateway.networking.k8s.io_grpcroutes.yaml \ -f ${GW_API}/gateway.networking.k8s.io_backendtlspolicies.yaml \ -f ${GW_API}/gateway.networking.k8s.io_tlsroutes.yaml
Установка и настройка Cilium
После подготовки Gateway API переходим к развертыванию самого Cilium.
Поскольку на этапе создания Kind-кластера мы полностью вырезали kube-proxy, Cilium разворачивается и заменяет собой старые механизмы маршрутизации и беря на себя управление сетевым трафиком и балансировкой.
Подключение репозитория и деплой
# Добавляем официальный репозиторий Ciliumhelm repo add cilium https://helm.cilium.io/helm repo update# Запускаем установку заданной версииhelm upgrade --install cilium -f infrastructure/cilium/values.yaml -n kube-system cilium/cilium --create-namespace --version 1.20.2
*Содержимое values-файла — infrastructure/cilium/values.yaml*
k8sServiceHost: "testlb-control-plane"k8sServicePort: "6443"l2announcements: enabled: truegatewayAPI: enabled: truekubeProxyReplacement: "true"hubble: enabled: true relay: enabled: true ui: enabled: true
Назначение параметров конфигурации:
-
k8sServiceHost и k8sServicePort — указывают Cilium имя Docker-контейнера управляющей ноды (testlb-control-plane) и порт для подключения Cilium к API-серверу.
-
kubeProxyReplacement: “true” — включает полную замену механизмов kube-proxy на eBPF для маршрутизации трафика внутри кластера.
-
l2announcements.enabled: true — активирует поддержку Layer 2 анонсов (ARP), чтобы Cilium мог объявлять IP-адреса сервисов типа LoadBalancer в подсети Docker.
-
gatewayAPI.enabled: true — включает встроенную поддержку Kubernetes Gateway API для управления входящим трафиком.
-
hubble.enabled,relay.enabledиui.enabled— активируют систему Hubble для мониторинга и визуализации сетевого трафика в реальном времени с включением графического веб-интерфейса (Hubble UI).
Цель стенда и тестируемые сервисы
В качестве комплексного теста веб-маршрутизации и балансировки в кластере разворачивается тестовый MLOps-стек. Мы будем тестировать доступ к следующим веб-сервисам:
-
JupyterHub — для организации многопользовательской среды работы с ноутбуками.
-
MLflow — для трекинга и логирования экспериментов машинного обучения.
Для обеспечения их стабильной работы, хранения данных и артефактов в кластер также устанавливаются:
-
CloudNativePG (CNPG) — оператор PostgreSQL для баз данных.
-
SeaweedFS — в качестве S3-совместимого хранилища артефактов и моделей.
Добавляем репозитории компонентов инфраструктуры и приложений
# Добавляем репозитории компонентов инфраструктуры и приложенийhelm repo add cnpg https://cloudnative-pg.github.io/chartshelm repo add jupyterhub https://hub.jupyter.org/helm-chart/helm repo add seaweedfs https://seaweedfs.github.io/seaweedfs/helm# Синхронизируем локальный кэш чартовhelm repo update
Установка CloudNativePG (Оператор PostgreSQL)
Для развертывания и управления базами данных в нашем кластере используется оператор CloudNativePG (CNPG). Он идеально подходит для исследования облачных СУБД в локальной среде, так как умеет автоматически управлять отказоустойчивостью и репликацией.
Мы устанавливаем его через Helm в изолированное пространство имен cnpg-system.
Команда установки Для деплоя версии v0.29.1 выполним следующую команду
helm upgrade --install cnpg -f infrastructure/operators/cnpg/values.yaml -n cnpg-system --create-namespace cnpg/cloudnative-pg --version 0.29.1
values — infrastructure/operators/cnpg/values.yaml
Ждём запуск оператора
kubectl -n cnpg-system rollout status deployment/cnpg-cloudnative-pg --timeout=5m# Output:deployment "cnpg-cloudnative-pg" successfully rolled out
НАСТРОЙКА двух PG кластеров для JupyterHub и mlflow
Манифест для создания namespace и CR для БД JupyterHub расположен по пути — platform/database/jupyter/postgres-cluster.yaml
kubectl apply -f platform/database/jupyter/postgres-cluster.yaml# Output:namespace/jnhdb configuredcluster.postgresql.cnpg.io/cluster-jnhdb created
Содержимое манифеста platform/database/jupyter/postgres-cluster.yaml
apiVersion: v1kind: Namespacemetadata: labels: name: jnhdb---apiVersion: postgresql.cnpg.io/v1kind: Clustermetadata: name: cluster-jnhdb namespace: jnhdbspec: instances: 3 # Ограничение планирования подов на целевые ноды affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: databasesnode operator: In values: - "yesnaff" # Допуск на ноды с запрещающим тейнтом tolerations: - key: "databasetaint" operator: "Equal" value: "yestaint" effect: "NoSchedule" # Переопределение имени базы данных при инициализации кластера bootstrap: initdb: database: jupyterhub storage: size: 5Gi storageClass: standard
Манифест для создания namespace и CR для БД MLflow расположен по пути — platform/database/mlflow/postgres-cluster.yaml
kubectl apply -f platform/database/mlflow/postgres-cluster.yaml# Output:namespace/mlflowdb createdcluster.postgresql.cnpg.io/cluster-mlflowdb created
Содержимое манифеста platform/database/mlflow/postgres-cluster.yaml
apiVersion: v1kind: Namespacemetadata: labels: name: mlflowdb---apiVersion: postgresql.cnpg.io/v1kind: Clustermetadata: name: cluster-mlflowdb namespace: mlflowdbspec: instances: 3 # Ограничение планирования подов на целевые ноды affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: databasesnode operator: In values: - "yesnaff" # Допуск на ноды с запрещающим тейнтом tolerations: - key: "databasetaint" operator: "Equal" value: "yestaint" effect: "NoSchedule" # Переопределение имени базы данных при инициализации кластера bootstrap: initdb: database: mlflow # Вместо "app" будет создана БД "mlflow" storage: size: 5Gi storageClass: standard
Установка SeaweedFS (S3-совместимое хранилище)
Для хранения артефактов, логов и обученных моделей из MLflow нам необходимо объектное хранилище. В рамках этого стенда используется SeaweedFS, который разворачивается через Helm в изолированном пространстве имен seaweedfs и предоставляет полноценный S3-совместимый API.
Команда установки
helm upgrade --install seaweedfs -f platform/seaweedfs/values.yaml -n seaweedfs --create-namespace seaweedfs/seaweedfs
в platform/seaweedfs/values.yaml не меняем весь, только добавляем nodeAffinity и tolerations ниже выделил изменения этого values
master: enabled: true affinity: | nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: seaweedfsnode operator: In values: - "yesnaff" podAntiAffinity: requiredDuringSchedulingIgnoredDuringExecution: - labelSelector: matchLabels: app.kubernetes.io/name: {{ template "seaweedfs.name" . }} app.kubernetes.io/instance: {{ .Release.Name }} app.kubernetes.io/component: master topologyKey: kubernetes.io/hostname tolerations: | - key: "seaweedfstaint" operator: "Equal" value: "yestaint" effect: "NoSchedule"volume: enabled: true affinity: | nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: seaweedfsnode operator: In values: - "yesnaff" podAntiAffinity: requiredDuringSchedulingIgnoredDuringExecution: - labelSelector: matchLabels: app.kubernetes.io/name: {{ template "seaweedfs.name" . }} app.kubernetes.io/instance: {{ .Release.Name }} app.kubernetes.io/component: {{ $volumeName }} topologyKey: kubernetes.io/hostname tolerations: | - key: "seaweedfstaint" operator: "Equal" value: "yestaint" effect: "NoSchedule"filer: enabled: true affinity: | nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: seaweedfsnode operator: In values: - "yesnaff" podAntiAffinity: requiredDuringSchedulingIgnoredDuringExecution: - labelSelector: matchLabels: app.kubernetes.io/name: {{ template "seaweedfs.name" . }} app.kubernetes.io/instance: {{ .Release.Name }} app.kubernetes.io/component: filer topologyKey: kubernetes.io/hostname tolerations: | - key: "seaweedfstaint" operator: "Equal" value: "yestaint" effect: "NoSchedule"
Создание пространств имён и копирование секретов для JupyterHub и MLflow
Создание пространств имён:
kubectl create ns jupyterhub; kubectl create ns mlflow
Копирование пароля БД для JupyterHub:
kubectl -n jnhdb get secret cluster-jnhdb-app -o json | jq '.type = "Opaque" | {apiVersion: .apiVersion, kind: .kind, type: .type, metadata: {name: "jupyterhub-db-secret"}, data: {"hub.db.password": .data.password}}' | kubectl apply -f - -n jupyterhub
Пример с переносом строк
kubectl -n jnhdb get secret cluster-jnhdb-app -o json | jq ‘.type = «Opaque» | {apiVersion: .apiVersion, kind: .kind, type: .type, metadata: {name: «jupyterhub-db-secret»}, data: {«hub.db.password»: .data.password}}’ | kubectl apply -f — -n jupyterhub
Копирование строки подключения (URI) БД для MLflow:
kubectl -n mlflowdb get secret cluster-mlflowdb-app -o json | jq '.type = "Opaque" | {apiVersion: .apiVersion, kind: .kind, type: .type, metadata: {name: "mlflow-db-secret"}, data: {"uri": .data.uri}}' | kubectl apply -f - -n mlflow
Пример с переносом строк
kubectl -n mlflowdb get secret cluster-mlflowdb-app -o json | jq ‘.type = «Opaque» | {apiVersion: .apiVersion, kind: .kind, type: .type, metadata: {name: «mlflow-db-secret»}, data: {«uri»: .data.uri}}’ | kubectl apply -f — -n mlflow
Копирование секретов S3 SeaweedFS для MLflow:
kubectl -n seaweedfs get secret seaweedfs-s3-secret -o json | jq '.type = "Opaque" | {apiVersion: .apiVersion, kind: .kind, type: .type, metadata: {name: "mlflow-s3-env-secret"}, data: {"AWS_ACCESS_KEY_ID": .data.admin_access_key_id, "AWS_SECRET_ACCESS_KEY": .data.admin_secret_access_key}}' | kubectl apply -f - -n mlflow
Пример с переносом строк
kubectl -n seaweedfs get secret seaweedfs-s3-secret -o json | jq ‘.type = «Opaque» | {apiVersion: .apiVersion, kind: .kind, type: .type, metadata: {name: «mlflow-s3-env-secret»}, data: {«AWS_ACCESS_KEY_ID»: .data.admin_access_key_id, «AWS_SECRET_ACCESS_KEY»: .data.admin_secret_access_key}}’ | kubectl apply -f — -n mlflow
Установка JupyterHub
Для организации многопользовательской среды разворачивается JupyterHub. Мы устанавливаем его через Helm в выделенное пространство имён jupyterhub, используя версию 4.4.2.
Команда установки:
helm upgrade --cleanup-on-fail --install jupyterhub jupyterhub/jupyterhub --namespace jupyterhub --version 4.4.2 --values platform/jupyter/values.yaml
Конфигурация values-файла JupyterHub (параметры tolerations и nodeAffinity) — platform/jupyter/values.yaml
При настройке планировщика мы ориентируемся на официальную документацию Zero to JupyterHub K8s, чтобы понять, какие метки и параметры планирования необходимы.
Для примера найдём ноду с тейнтом mlflowtaint
kubectl get no -o custom-columns="NAME:.metadata.name,TAINTS:.spec.taints[*].key"# Output:NAME TAINTStestlb-control-plane node-role.kubernetes.io/control-plane...testlb-worker5 mlflowtaint...
Устанавливаем метку hub.jupyter.org/node-purpose=core для ноды testlb-worker5
kubectl label nodes testlb-worker5 hub.jupyter.org/node-purpose=core
Используем стандартный values-файл (platform/jupyter/values.yaml), добавив или переопределив в нём следующие параметры
hub: # tolerations: [] tolerations: - key: "mlflowtaint" operator: "Equal" value: "yestaint" effect: "NoSchedule" db: # type: sqlite-pvc # upgrade: # pvc: # annotations: {} # selector: {} # accessModes: # - ReadWriteOnce # storage: 1Gi # subPath: # storageClassName: # url: # password: type: postgres url: postgresql+psycopg2://jupyterhub@cluster-jnhdb-rw.jnhdb:5432/jupyterhub # existingSecret: existingSecret: "jupyterhub-db-secret"singleuser: extraNodeAffinity: required: - matchExpressions: - key: mlflownode operator: In values: - "yesnaff" # required: [] # preferred: []scheduling: corePods: tolerations: - key: hub.jupyter.org/dedicated operator: Equal value: core effect: NoSchedule - key: hub.jupyter.org_dedicated operator: Equal value: core effect: NoSchedule - key: "mlflowtaint" operator: "Equal" value: "yestaint" effect: "NoSchedule" nodeAffinity: matchNodePurpose: prefer userPods: tolerations: - key: hub.jupyter.org/dedicated operator: Equal value: user effect: NoSchedule - key: hub.jupyter.org_dedicated operator: Equal value: user effect: NoSchedule - key: "mlflowtaint" operator: "Equal" value: "yestaint" effect: "NoSchedule" nodeAffinity: matchNodePurpose: ignore # prefer
Установка и настройка MLflow
Команда установки через Helm:
helm upgrade --install mlflow oci://ghcr.io/mlflow/charts/mlflow --version 3.17.0 --namespace mlflow --values platform/mlflow/values.yaml
Содержимое конфигурационного файла platform/mlflow/values.yaml
mlflow: backendStoreUriFrom: secretKeyRef: name: mlflow-db-secret key: uri defaultArtifactRoot: "mlflow-artifacts:/" artifactsDestination: "s3://mlflow"env: - name: MLFLOW_S3_ENDPOINT_URL value: "http://seaweedfs-s3.seaweedfs.svc.cluster.local:8333" - name: AWS_DEFAULT_REGION value: "us-east-1" - name: MLFLOW_SERVER_ALLOWED_HOSTS value: "172.18.255.240,mlflow-mlflow.mlflow.svc.cluster.local,mlflow-mlflow.mlflow.svc.cluster.local:5000,localhost,127.0.0.1" - name: MLFLOW_SERVER_CORS_ALLOWED_ORIGINS value: "http://172.18.255.240"envFrom: - secretRef: name: mlflow-s3-env-secretserver: staticPrefix: "/mlflow"tolerations:- key: "mlflowtaint" operator: "Equal" value: "yestaint" effect: "NoSchedule"affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: mlflownode operator: In values: - "yesnaff"
Настройка CiliumLoadBalancerIPPool
docker network inspect kind -f '{{range .IPAM.Config}}{{.Subnet}} {{end}}'# Output:fc00:f853:ccd:e793::/64 172.18.0.0/16
Выбираем диапазон подсети через маску /28 Чтобы адреса наших виртуальных балансировщиков никогда не пересеклись с реальными IP-адресами нод (в том числе если мы решим подключить ещё десяток воркер-нод через kubeadm join), мы уходим в самый конец сети — на диапазон 172.18.255.X.
Почему именно маска /28 и адрес 172.18.255.240? Для тестового стенда с JupyterHub и MLflow нам не нужны сотни IP-адресов.
Разбиения сети выглядит следующим образом:
-
Подсеть:
172.18.255.240/28 -
Диапазон выдаваемых адресов: от
172.18.255.241до172.18.255.254 -
Broadcast-адрес:
172.18.255.255
ipcalc 172.18.255.240/28# Output:Address: 172.18.255.240 10101100.00010010.11111111.1111 0000Netmask: 255.255.255.240 = 28 11111111.11111111.11111111.1111 0000Wildcard: 0.0.0.15 00000000.00000000.00000000.0000 1111=>Network: 172.18.255.240/28 10101100.00010010.11111111.1111 0000HostMin: 172.18.255.241 10101100.00010010.11111111.1111 0001HostMax: 172.18.255.254 10101100.00010010.11111111.1111 1110Broadcast: 172.18.255.255 10101100.00010010.11111111.1111 1111Hosts/Net: 14 Class B, Private Internet
Применяем манифест platform/gateway/cilium/clb.yaml
apiVersion: cilium.io/v2kind: CiliumLoadBalancerIPPoolmetadata: name: kind-pool namespace: kube-system labels: pool: kindspec: blocks: - cidr: 172.18.255.240/28---apiVersion: cilium.io/v2alpha1kind: CiliumL2AnnouncementPolicymetadata: name: kind-l2-policy namespace: kube-systemspec: interfaces: - ^eth[0-9]+ loadBalancerIPs: true nodeSelector: matchLabels: webnode: "yesnaff"
Анонсы завязывем по matchLabels строго на ноды с меткой webnode, это изолирует сетевой внешний трафик от остальных нод.
Проверяем типы сервисов
kubectl get svc -A# Output:NAMESPACE NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEcnpg-system cnpg-webhook-service ClusterIP 10.96.81.40 <none> 443/TCP 4h26mdefault kubernetes ClusterIP 10.96.0.1 <none> 443/TCP 8hjnhdb cluster-jnhdb-r ClusterIP 10.96.214.15 <none> 5432/TCP 4h18mjnhdb cluster-jnhdb-ro ClusterIP 10.96.97.73 <none> 5432/TCP 4h18mjnhdb cluster-jnhdb-rw ClusterIP 10.96.192.167 <none> 5432/TCP 4h18mjupyterhub hub ClusterIP 10.96.53.24 <none> 8081/TCP 3h14mjupyterhub proxy-api ClusterIP 10.96.231.137 <none> 8001/TCP 3h14mjupyterhub proxy-public ClusterIP 10.96.61.233 <none> 80/TCP 3h14mkube-system cilium-envoy ClusterIP None <none> 9964/TCP 4h36mkube-system hubble-peer ClusterIP 10.96.115.63 <none> 443/TCP 4h36mkube-system kube-dns ClusterIP 10.96.0.10 <none> 53/UDP,53/TCP,9153/TCP 8hmlflow mlflow-mlflow ClusterIP 10.96.186.249 <none> 5000/TCP 36mmlflowdb cluster-mlflowdb-r ClusterIP 10.96.241.117 <none> 5432/TCP 3h31mmlflowdb cluster-mlflowdb-ro ClusterIP 10.96.82.54 <none> 5432/TCP 3h31mmlflowdb cluster-mlflowdb-rw ClusterIP 10.96.111.65 <none> 5432/TCP 3h31mseaweedfs seaweedfs-filer ClusterIP None <none> 8888/TCP,18888/TCP,8333/TCP,9327/TCP 3h18mseaweedfs seaweedfs-filer-client ClusterIP None <none> 8888/TCP,18888/TCP,9327/TCP 3h18mseaweedfs seaweedfs-master ClusterIP None <none> 9333/TCP,19333/TCP,9327/TCP 3h18mseaweedfs seaweedfs-s3 ClusterIP 10.96.105.179 <none> 8333/TCP 3h18mseaweedfs seaweedfs-volume ClusterIP None <none> 8080/TCP,18080/TCP,9327/TCP 3h18m
Внешний IP-адрес балансировщика (LoadBalancer) появится только после создания объекта Gateway.
Создадим namespace с именем “infra-gw-jml” в нём будут объекты “Gateway”
kubectl create ns infra-gw-jml
Применяем манифест шлюза platform/gateway/mlflow/gateway.yaml
apiVersion: gateway.networking.k8s.io/v1kind: Gatewaymetadata: name: jml-cilium-gateway namespace: infra-gw-jml annotations: io.cilium/lb-ipam-pool: kind-poolspec: gatewayClassName: cilium listeners: - name: http protocol: HTTP port: 80 allowedRoutes: namespaces: from: All
Проверяем появление сервиса типа LoadBalancer
kubectl get svc -A|grep -E LoadBalancer\|TYPE# Output:NAMESPACE NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEinfra-gw-jml cilium-gateway-jml-cilium-gateway LoadBalancer 10.96.107.1 172.18.255.240 80:31109/TCP 5m11s
Внешний адрес EXTERNAL-IP успешно назначился и получил IP 172.18.255.240.
Проверяем доступность адреса
curl -I http://172.18.255.240/# Output:HTTP/1.1 404 Not Founddate: Mon, 15 Oct 2026 17:23:46 GMTserver: envoytransfer-encoding: chunked
Теперь добавим HTTPRoute — platform/gateway/mlflow/HTTPRoute-jupyterhub.yaml
apiVersion: gateway.networking.k8s.io/v1kind: HTTPRoutemetadata: name: web-route namespace: jupyterhub # ПЕРЕНЕСЛИ маршрут в неймспейс самого приложенияspec: parentRefs: - name: jml-cilium-gateway namespace: infra-gw-jml # Явно указываем, что шлюз лежит в другом ns rules: - matches: - path: type: PathPrefix value: / backendRefs: - name: proxy-public # Чистое имя сервиса без точек namespace: jupyterhub # ЯВНО указываем целевой неймспейс сервиса port: 80
Проверяем доступность адреса и ищем в ответе статус “HTTP/1.1 200 OK”
curl -o /dev/null -s -v http://172.18.255.240/hub/login# Output:* Trying 172.18.255.240:80...* Established connection to 172.18.255.240 (172.18.255.240 port 80) from 172.18.0.2 port 52214 * using HTTP/1.x> GET /hub/login HTTP/1.1> Host: 172.18.255.240> User-Agent: curl/8.18.0> Accept: */*> * Request completely sent off< HTTP/1.1 200 OK< server: envoy< content-type: text/html< date: Mon, 17 Oct 2026 17:45:59 GMT< x-jupyterhub-version: 5.3.0< access-control-allow-headers: accept, content-type, authorization< content-security-policy: frame-ancestors 'none'; report-uri /hub/security/csp-report< etag: "df589664a25d5c3eb4c091fcadd7ea94f9add5f3"< content-length: 7870< set-cookie: _xsrf=MnwxOjB8MTA6MTc5MTgyNzE1OXw1Ol94c3JmfDY4OlRtOXVaVHBZTlVwSVMySkRlbVZmUWtVek9GTnNlRFpsWlY5d2NrZHhMVkJLYW5WZlkyOVlNek5ZZFZwaU1HZzRQUT09fGU4YWJlMjc3ZDA2M2MzZTU3NjllYWZjZTMxNGIzNjNiMmNkZTljZWUxOGI1ZmUzMGQzZjNkMjQ1MzZiMjdkNTk; Max-Age=3600; Path=/hub/< x-envoy-upstream-service-time: 7< { [7870 bytes data]* Connection #0 to host 172.18.255.240:80 left intact
Добавим HTTPRoute для mlflow — platform/gateway/mlflow/HTTPRoute-mlflow.yaml
apiVersion: gateway.networking.k8s.io/v1kind: HTTPRoutemetadata: name: web-route-mlflow namespace: mlflow # ПЕРЕНЕСЛИ маршрут в неймспейс самого приложенияspec: parentRefs: - name: jml-cilium-gateway namespace: infra-gw-jml # Явно указываем, что шлюз лежит в другом ns rules: - matches: - path: type: PathPrefix value: /mlflow backendRefs: - name: mlflow-mlflow # Имя сервиса без точек namespace: mlflow # Указываем целевой неймспейс сервиса port: 5000
Добавим gateway с именем “hubble-cilium-gateway” для создания ещё одного LB для hubble-ui Манифест для hubble-cilium-gateway
apiVersion: gateway.networking.k8s.io/v1kind: Gatewaymetadata: name: hubble-cilium-gateway namespace: infra-gw-jml annotations: io.cilium/lb-ipam-pool: kind-poolspec: gatewayClassName: cilium listeners: - name: http protocol: HTTP port: 80 allowedRoutes: namespaces: from: All
Проверяем новый LB
kubectl get svc -A|grep -E LoadBalancer\|TYPE# Output:NAMESPACE NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEinfra-gw-jml cilium-gateway-hubble-cilium-gateway LoadBalancer 10.96.67.14 172.18.255.241 80:30556/TCP 15sinfra-gw-jml cilium-gateway-jml-cilium-gateway LoadBalancer 10.96.107.1 172.18.255.240 80:31109/TCP 4d18h
Видим новый внешний IP 172.18.255.241
Добавим HTTPRoute для Hubble UI — platform/gateway/hubble/HTTPRoute-hubble.yaml
apiVersion: gateway.networking.k8s.io/v1kind: HTTPRoutemetadata: name: web-route-hubble-ui namespace: kube-system # ПЕРЕНЕСЛИ маршрут в неймспейс самого приложенияspec: parentRefs: - name: hubble-cilium-gateway # Здесь указываем имя gateway которое указали для hubble-ui namespace: infra-gw-jml # Явно указываем, что шлюз лежит в другом ns rules: - matches: - path: type: PathPrefix value: / backendRefs: - name: hubble-ui # Имя сервиса без точек namespace: kube-system # Указываем целевой неймспейс сервиса port: 80
Проверяем доступность адреса и ищем в ответе статус “HTTP/1.1 200 OK”
curl -o /dev/null -sv "http://172.18.255.241"# Output:* Trying 172.18.255.241:80...* Established connection to 172.18.255.241 (172.18.255.241 port 80) from 172.18.0.2 port 55256 * using HTTP/1.x> GET / HTTP/1.1> Host: 172.18.255.241> User-Agent: curl/8.18.0> Accept: */*> * Request completely sent off< HTTP/1.1 200 OK< server: envoy< date: Sat, 17 Oct 2026 11:43:10 GMT< content-type: text/html< content-length: 642< last-modified: Tue, 08 Sep 2026 12:41:20 GMT< etag: "6aa00270-282"< accept-ranges: bytes< x-envoy-upstream-service-time: 0< { [642 bytes data]* Connection #0 to host 172.18.255.241:80 left intact
Наблюдаемость и сетевая безопасность: работа с Hubble UI
Для тестирования сетевой связности и проверки работы политик изоляции мы запускаем проверочный скрипт py/test.py внутри JupyterHub, создав новый ноутбук, и отслеживаем поведение трафика в реальном времени через Hubble UI.
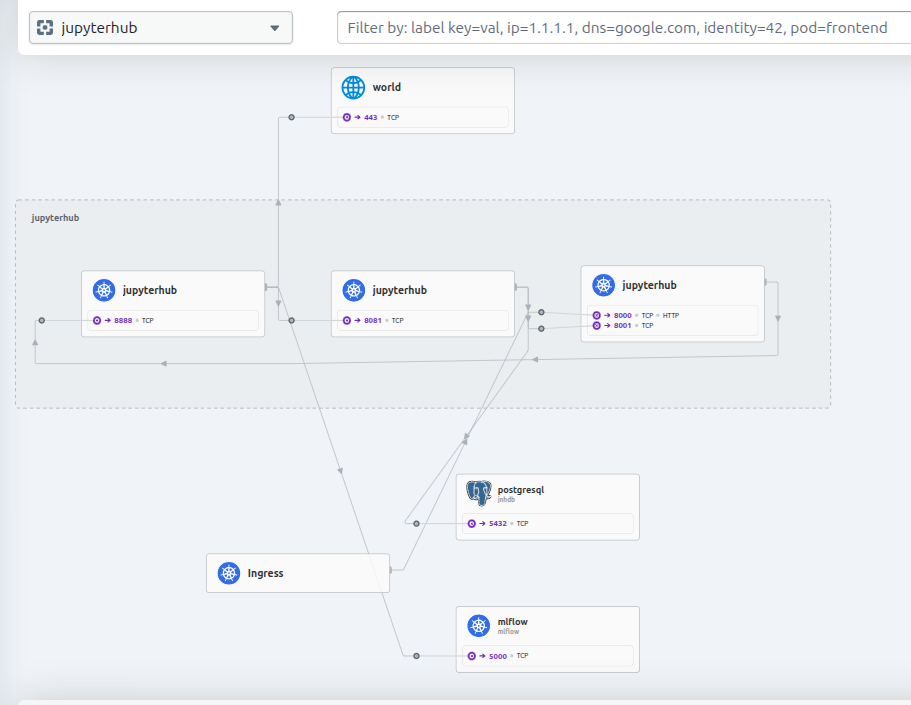
1. Мониторинг пространства имен jupyterhub
На первом этапе мы заглядываем в неймспейс jupyterhub. Здесь отчетливо видна вся цепочка взаимодействия: трафик успешно заходит через Ingress, обрабатывается компонентами JupyterHub, отправляется во внешний мир (world), а также уходит в сторону сервера трекинга mlflow:
2. Мониторинг пространства имен mlflow
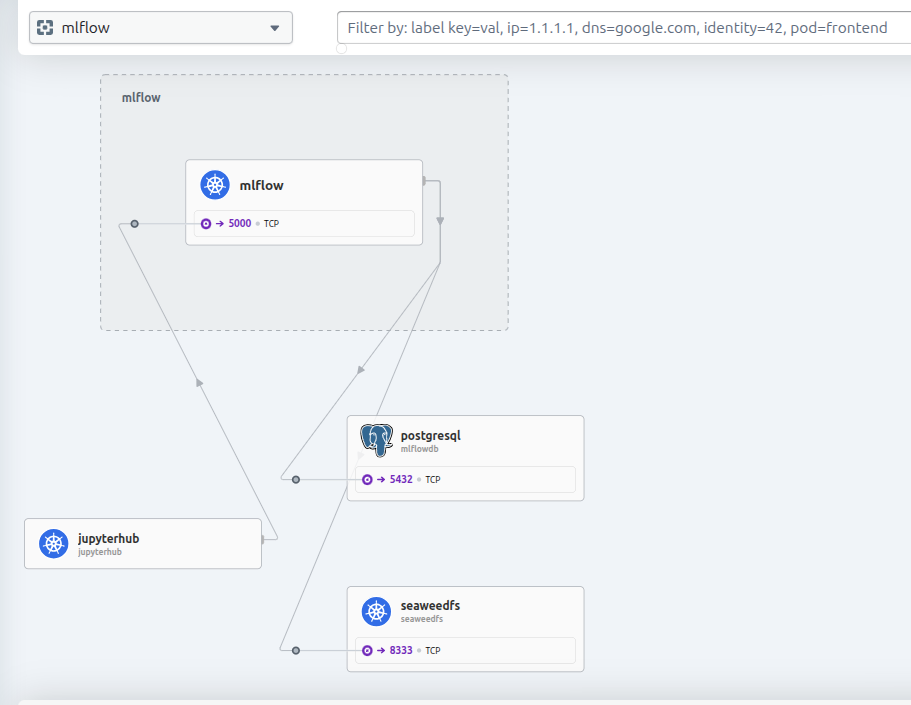
Затем мы переключаемся на пространство имен mlflow, чтобы детально рассмотреть инфраструктуру самого приложения. На карте зависимостей видно, как сервис mlflow принимает входящие запросы от jupyterhub и успешно коммуницирует со своими внутренними ресурсами: базой данных postgresql (порт 5432) и объектным хранилищем seaweedfs (порт 8333):
3. Обнаружение нежелательного внешнего трафика (Телеметрия)
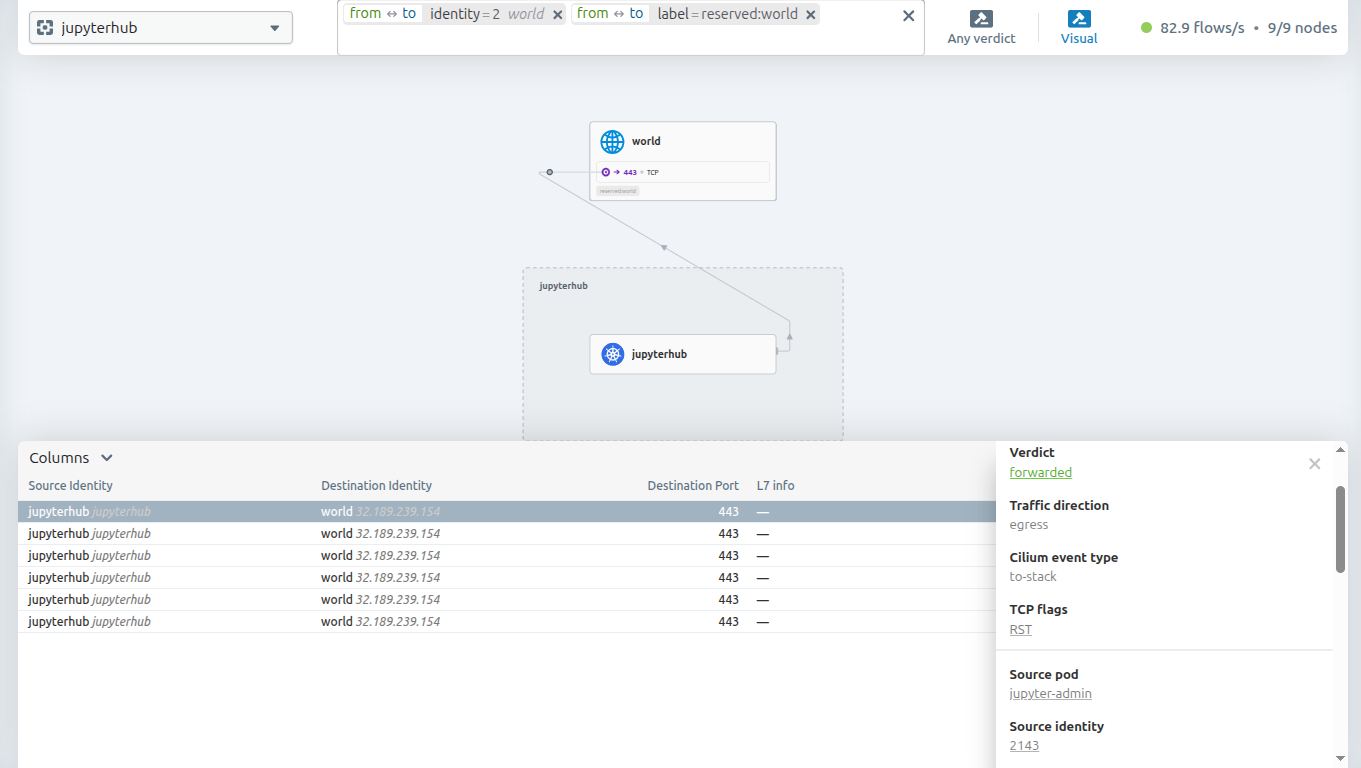
При детальном анализе логов в Hubble UI мы замечаем, что из нашего кластера наружу уходят запросы. В логах четко фиксируются пакеты, отправляемые на внешний адрес api.mlflow-telemetry.io на порт 443 со статусом forwarded (перенаправлено). Наша задача — полностью заблокировать этот поток в интернет, сохранив внутреннюю связность кластера.
Применение политики безопасности (CiliumNetworkPolicy)
Для изоляции подов JupyterHub от внешней сети применяем манифест platform/gateway/cilium/cnp.yaml
apiVersion: "cilium.io/v2"kind: CiliumNetworkPolicymetadata: name: jupyterhub-isolation namespace: jupyterhubspec: endpointSelector: matchLabels: app.kubernetes.io/component: singleuser-server egress: # 1. Разрешаем DNS-запросы ко всему кластеру (чтобы поды могли резолвить имена) - toEndpoints: - matchLabels: "k8s:io.kubernetes.pod.namespace": kube-system k8s-app: kube-dns toPorts: - ports: - port: "53" protocol: UDP rules: dns: - matchPattern: "*" # 2. Разрешаем трафик ко ВСЕМ внутренним подам кластера (Kube-DNS, MLflow, SeaweedFS) - toEndpoints: - matchExpressions: - key: "k8s:io.kubernetes.pod.namespace" operator: Exists # Обратите внимание: секции для "reserved:world" здесь нет, # поэтому весь трафик в интернет будет отброшен.
Результат фильтрации трафика в Hubble UI
4. Фиксация заблокированных запросов (Dropped Flows)
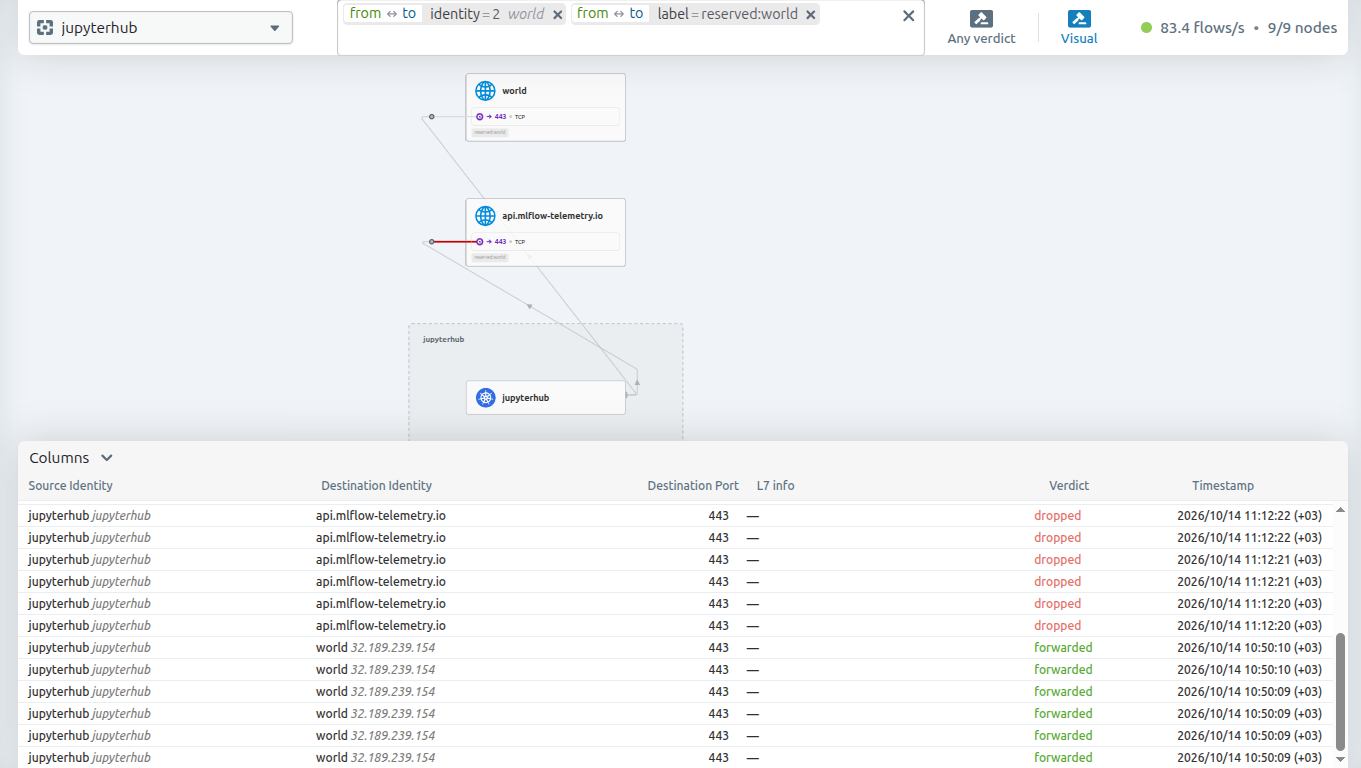
Как только политика вступает в силу, eBPF-программы Cilium начинают блокировать внешние запросы. В панели Hubble мы сразу видим маркеры dropped (подсвечены красным) при новой попытке отправить пакеты на api.mlflow-telemetry.io.
Кликнув по строке заблокированного лога, можно провести глубокий анализ пакета: увидеть вердикт, направление трафика (egress), TCP-флаги (RST) и конкретный исходный под (jupyter-admin), на котором сработала наша политика изоляции
Проверка артефактов в SeaweedFS S3
Политика безопасности успешно заблокировала внешнюю сеть, но сохранила внутреннюю связность кластера. Чтобы окончательно убедиться, что JupyterHub и MLflow беспрепятственно сохраняют данные во внутреннем объектном хранилище, проверим содержимое бакета mlflow.
Для этого отправим прямой запрос к API SeaweedFS S3 внутри кластера, используя встроенную в curl подпись AWS SigV4
Политика безопасности успешно заблокировала внешнюю сеть, но сохранила внутреннюю связность кластера. Чтобы окончательно убедиться, что стек JupyterHub ➔ MLflow беспрепятственно сохраняет данные во внутреннем объектном хранилище, проверим содержимое бакета mlflow.
Для этого сначала извлечем credentials для чтения из секрета Kubernetes и расшифруем их с помощью jq
kubectl -n seaweedfs get secret seaweedfs-s3-secret -o json | jq -r '"\(.data.read_access_key_id | @base64d):\(.data.read_secret_access_key | @base64d)"'# OutputTzk74FVIQAOnPbqfOc6z:uVSXdFcpTOwxjoj8PeRIUPvDN5tCzakFhnfNmTBY
Используя полученные данные формата username:password, отправляем запрос к SeaweedFS S3 внутри кластера с авторизацией AWS SigV4, чтобы увидеть список файлов
curl --user "Tzk74FVIQAOnPbqfOc6z:uVSXdFcpTOwxjoj8PeRIUPvDN5tCzakFhnfNmTBY" --aws-sigv4 "aws:amz:us-east-1:s3" -s "http://seaweedfs-s3.seaweedfs.svc.cluster.local:8333/mlflow"| grep -o '<Key>[^<]*</Key>' | sed 's|<Key>||g; s|</Key>||g'# Output:1/13229738f0f644de80a412e89cd284f4/artifacts/check-status.txt1/2d38b8d475d545d199a71a502bcedd4c/artifacts/check-status.txt1/757d5f747aad4059b1396933ecab5654/artifacts/check-status.txt1/b460b792eaeb489fbc1b7a2bc2b8668d/artifacts/check-status.txt1/c04b8b16cee74e52a4918adc712db8ea/artifacts/check-status.txt1/d802426e487c40898a0e62c9d7605bfc/artifacts/check-status.txt
Итог эксперимента: Все артефакты (файлы check-status.txt) от запусков экспериментов MLflow успешно создаются и логируются в S3-бакете. Сетевая изоляция работает: внутренний трафик ходит без ограничений, а несанкционированная внешняя телеметрия полностью заблокирована.
Лог хаос-тестирования (Файловер в действии)
Вот как выглядит живой лог из терминала, когда мы поочередно отключаем и включаем наши ноды testlb-worker7 и testlb-worker8 (фоновый скрипт мониторинга перемешался с командами управления Docker):
while true; do echo -n "$(date +%T) -> HTTP Code: "; curl -o /dev/null -s -w "%{http_code}\n" http://172.18.255.240/hub/login; sleep 10; done &[1] 6015214:36:37 -> HTTP Code: 200# Шаг 1: Гасим ОБЕ ноды, имитируя полный отказ$ docker stop testlb-worker7$ docker stop testlb-worker814:56:13 -> HTTP Code: 00014:57:02 -> HTTP Code: 000 # Кластер лежит, шлюз недоступен# Шаг 2: Возвращаем к жизни первую ноду$ docker start testlb-worker714:57:15 -> HTTP Code: 000 # Идет инициализация Cilium агента...14:57:28 -> HTTP Code: 00014:57:41 -> HTTP Code: 200 # L2-анонсы отработали, шлюз ОЖИЛ!14:58:12 -> HTTP Code: 200# Шаг 3: Поднимаем вторую ноду для обеспечения HA$ docker start testlb-worker814:58:42 -> HTTP Code: 200 # две ноды полностью в строю# Шаг 4: Тест файловера. Выбиваем активную ноду worker7$ docker stop testlb-worker714:59:23 -> HTTP Code: 200 # трафик ушел на worker8!14:59:34 -> HTTP Code: 20014:59:44 -> HTTP Code: 200# Шаг 5: Добиваем последнюю ноду$ docker stop testlb-worker814:59:53 -> HTTP Code: 000 # Все ноды с метками webnode отключены
И способ посмотреть через объекты Kubernetes (нужно запустить ноды worker7 и worker8 перед следующей проверкой):
# Проверяем какая нода принимает трафикkubectl -n kube-system get lease | grep -E jml-cilium-gateway\|HOLDERNAME HOLDER AGEcilium-l2announce-infra-gw-jml-cilium-gateway-hubble-cilium-gateway testlb-worker8 25mcilium-l2announce-infra-gw-jml-cilium-gateway-jml-cilium-gateway testlb-worker8 25m# Останавливаем ноду из столбца HOLDER - testlb-worker8docker stop testlb-worker8testlb-worker8# Проверяем какая нода принимает трафикkubectl -n kube-system get lease | grep -E jml-cilium-gateway\|HOLDERNAME HOLDER AGEcilium-l2announce-infra-gw-jml-cilium-gateway-hubble-cilium-gateway testlb-worker7 26mcilium-l2announce-infra-gw-jml-cilium-gateway-jml-cilium-gateway testlb-worker7# Останавливаем оставшуюся ноду из столбца HOLDER - testlb-worker7docker stop testlb-worker7testlb-worker7# Убеждаемся, что аренды сброшены и лидеры отсутствуют (в выводе осталась только строка заголовков)kubectl -n kube-system get lease | grep -E jml-cilium-gateway\|HOLDERNAME HOLDER AGEkubectl -n kube-system get lease | grep -E jml-cilium-gateway\|HOLDER|wc -l1
Вывод: Тест наглядно показал:
-
При падении одной из нод (
worker7) Cilium выполняет переключение трафика наworker8. Клиент не замечает аварии. -
При падении всех нод и последующем старте хотя бы одной, балансировщик самостоятельно восстанавливает работоспособность за ~20-30 секунд (время на инициализацию пода
cilium-agent).
Оптимизация для KinD кластера
Локальный запуск тяжелого стека приложений (JupyterHub, MLflow, SeaweedFS, PostgreSQL) накладывает свои ограничения на ресурсы хоста. Ниже собраны проверенные рецепты для оптимизации работы и решения частых проблем с KinD.
1. Отключаем автостарт кластера testlb
По умолчанию KinD настраивает контейнеры нод на автоматический запуск вместе с Docker-демоном. Если вы хотите контролировать ресурсы вашей машины и запускать кластер только для работы, отключите автостарт одной командой:
docker update --restart=no $(docker ps -a -q --filter name=testlb)
2. Запуск кластера testlb
Теперь кластер будет «спать» до тех пор, пока вы не поднимете его вручную, когда это необходимо:
docker start $(docker ps -a -q --filter name=testlb)
3. Регулировка лимитов ядра (Inotify)
Если вы разворачиваете в KinD большое количество микросервисов, вам может потребоваться подобрать оптимальные параметры ядра хост-системы (Linux/WSL2): fs.inotify.max_user_watches, fs.inotify.max_user_instances и fs.inotify.max_queued_events. Без их увеличения можно столкнуться с нехваткой лимитов подсистемы inotify.
4. Лечение подов в статусе “Unknown”
После выключения кластера, падения Docker или ухода компьютера в сон, часть подов зависает в статусе Unknown. Лечим эту проблему командой принудительного удаления
kubectl get pods --all-namespaces | grep -i "Unknown" | awk '{print \$1, \$2}' | xargs -n2 kubectl delete pod --grace-period 0 --force -n
🏁 Вместо заключения
Конечно, в рамках одной статьи получилось затронуть всего понемногу. Мы развернули базовый локальный стенд, настроили простейшую маршрутизацию и посмотрели на базовую блокировку трафика через интерфейс Hubble.
Этот проект — отличная отправная точка для дальнейших экспериментов. Куда можно копать дальше:
-
CiliumNetworkPolicy: углубиться в eBPF-фильтрацию, настроить L7-политики (например, фильтровать трафик по конкретным HTTP-путям или методам) и протестировать защиту от спуфинга.
-
Gateway API: подробно изучить возможности продвинутого управления трафиком.
Технологии Cilium и Gateway API развиваются очень быстро, и их локальное тестирование в связке с KinD — лучший способ разобраться в современных сетевых стандартах Kubernetes.
ссылка на оригинал статьи https://habr.com/ru/articles/1095700/