Привет, Хабр! На фоне популярности decision-моделей мне захотелось познакомиться с их механизмом работы. Объектом исследования я выбрал модель Clef от Cloudflare просто потому, что она больше всего на слуху.
Статья носит познавательный характер и будет интересна тем, кто, как и я, захочет разобраться в работе модели. Фрагменты кода и конфигурации взяты из репозитория авторов.
Приступим!
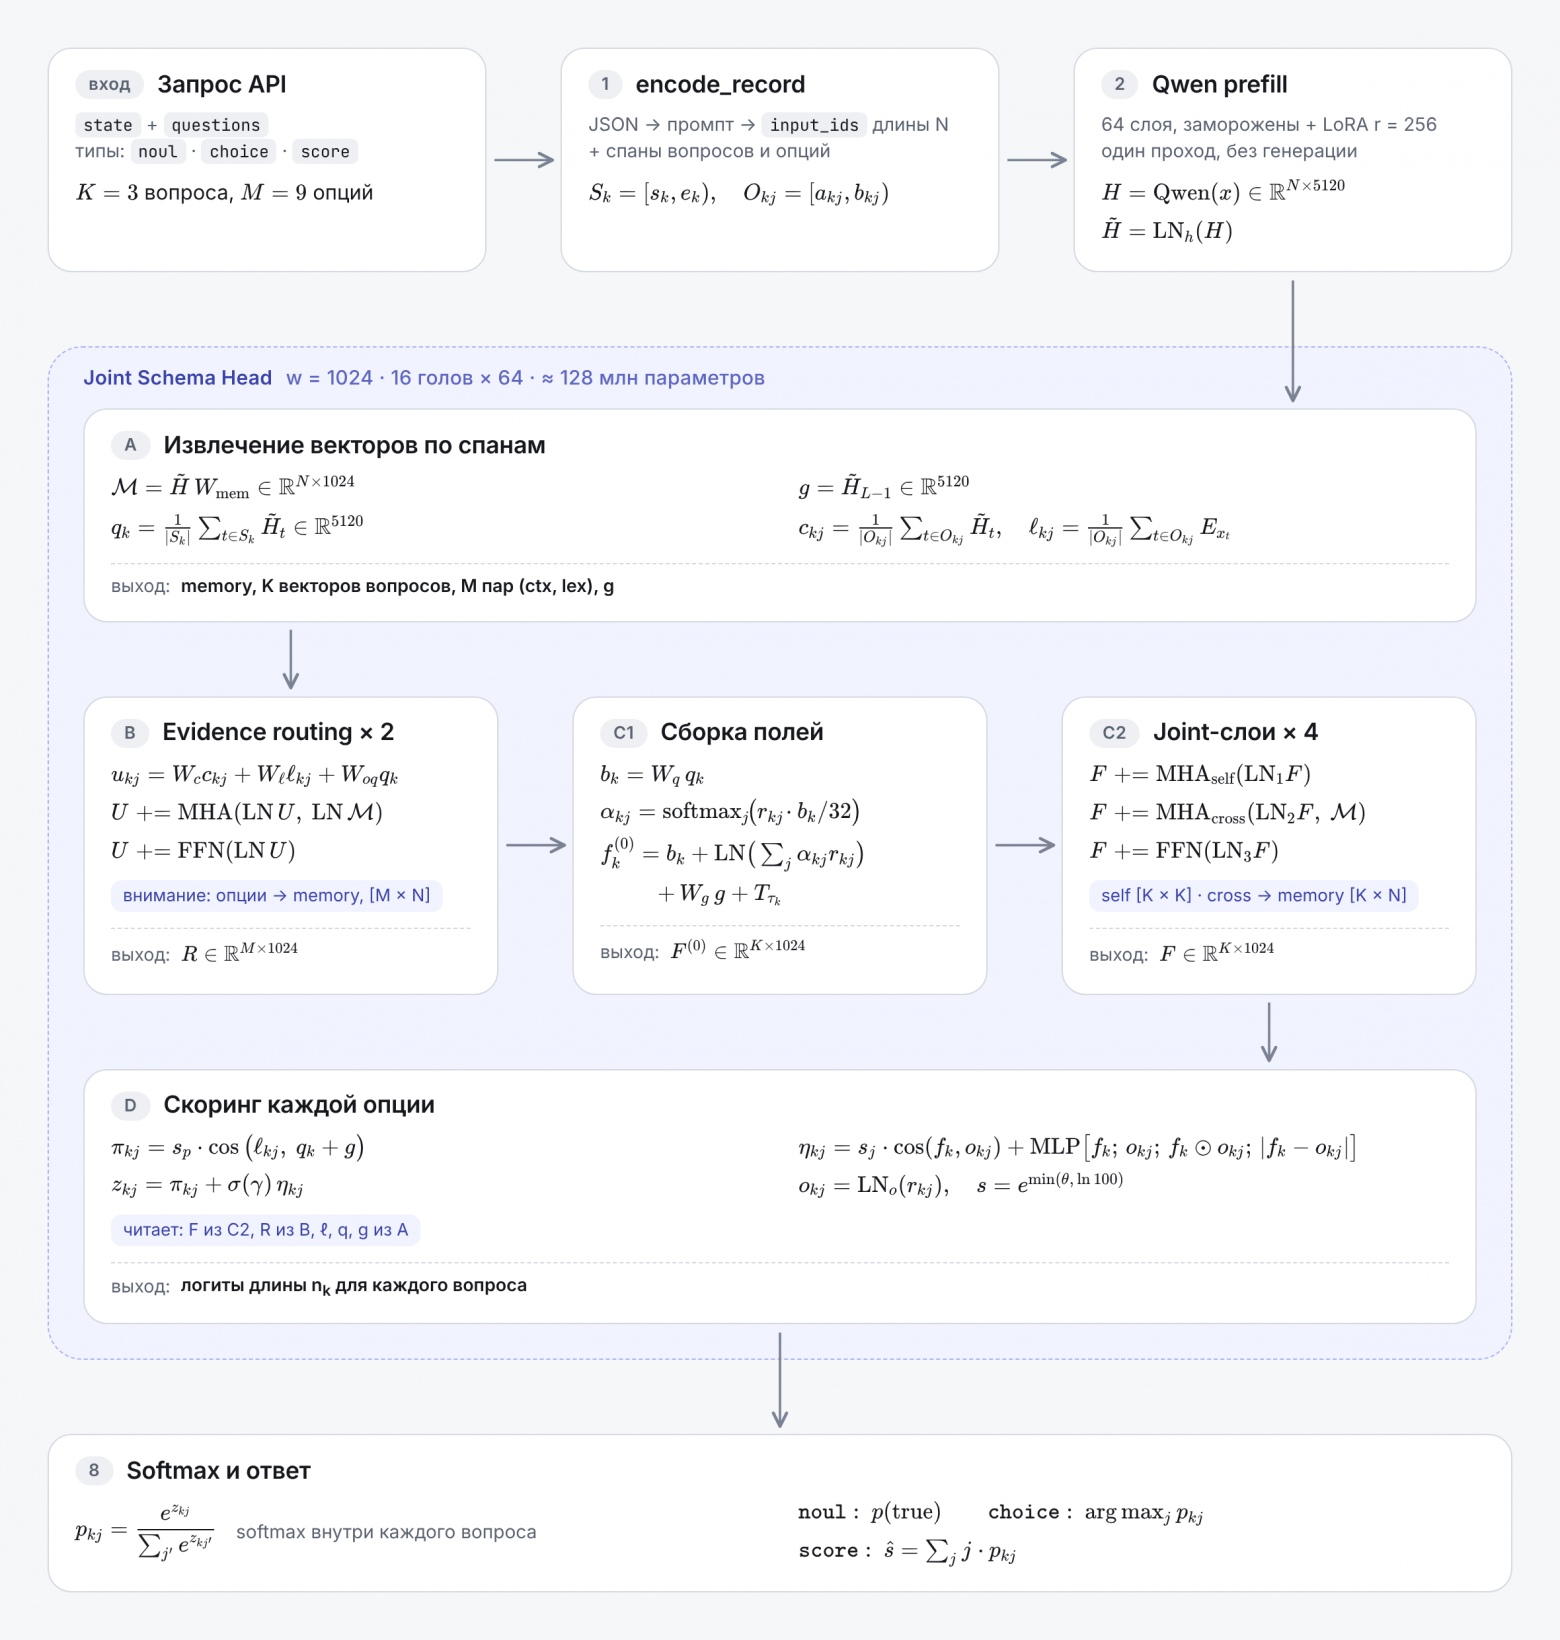
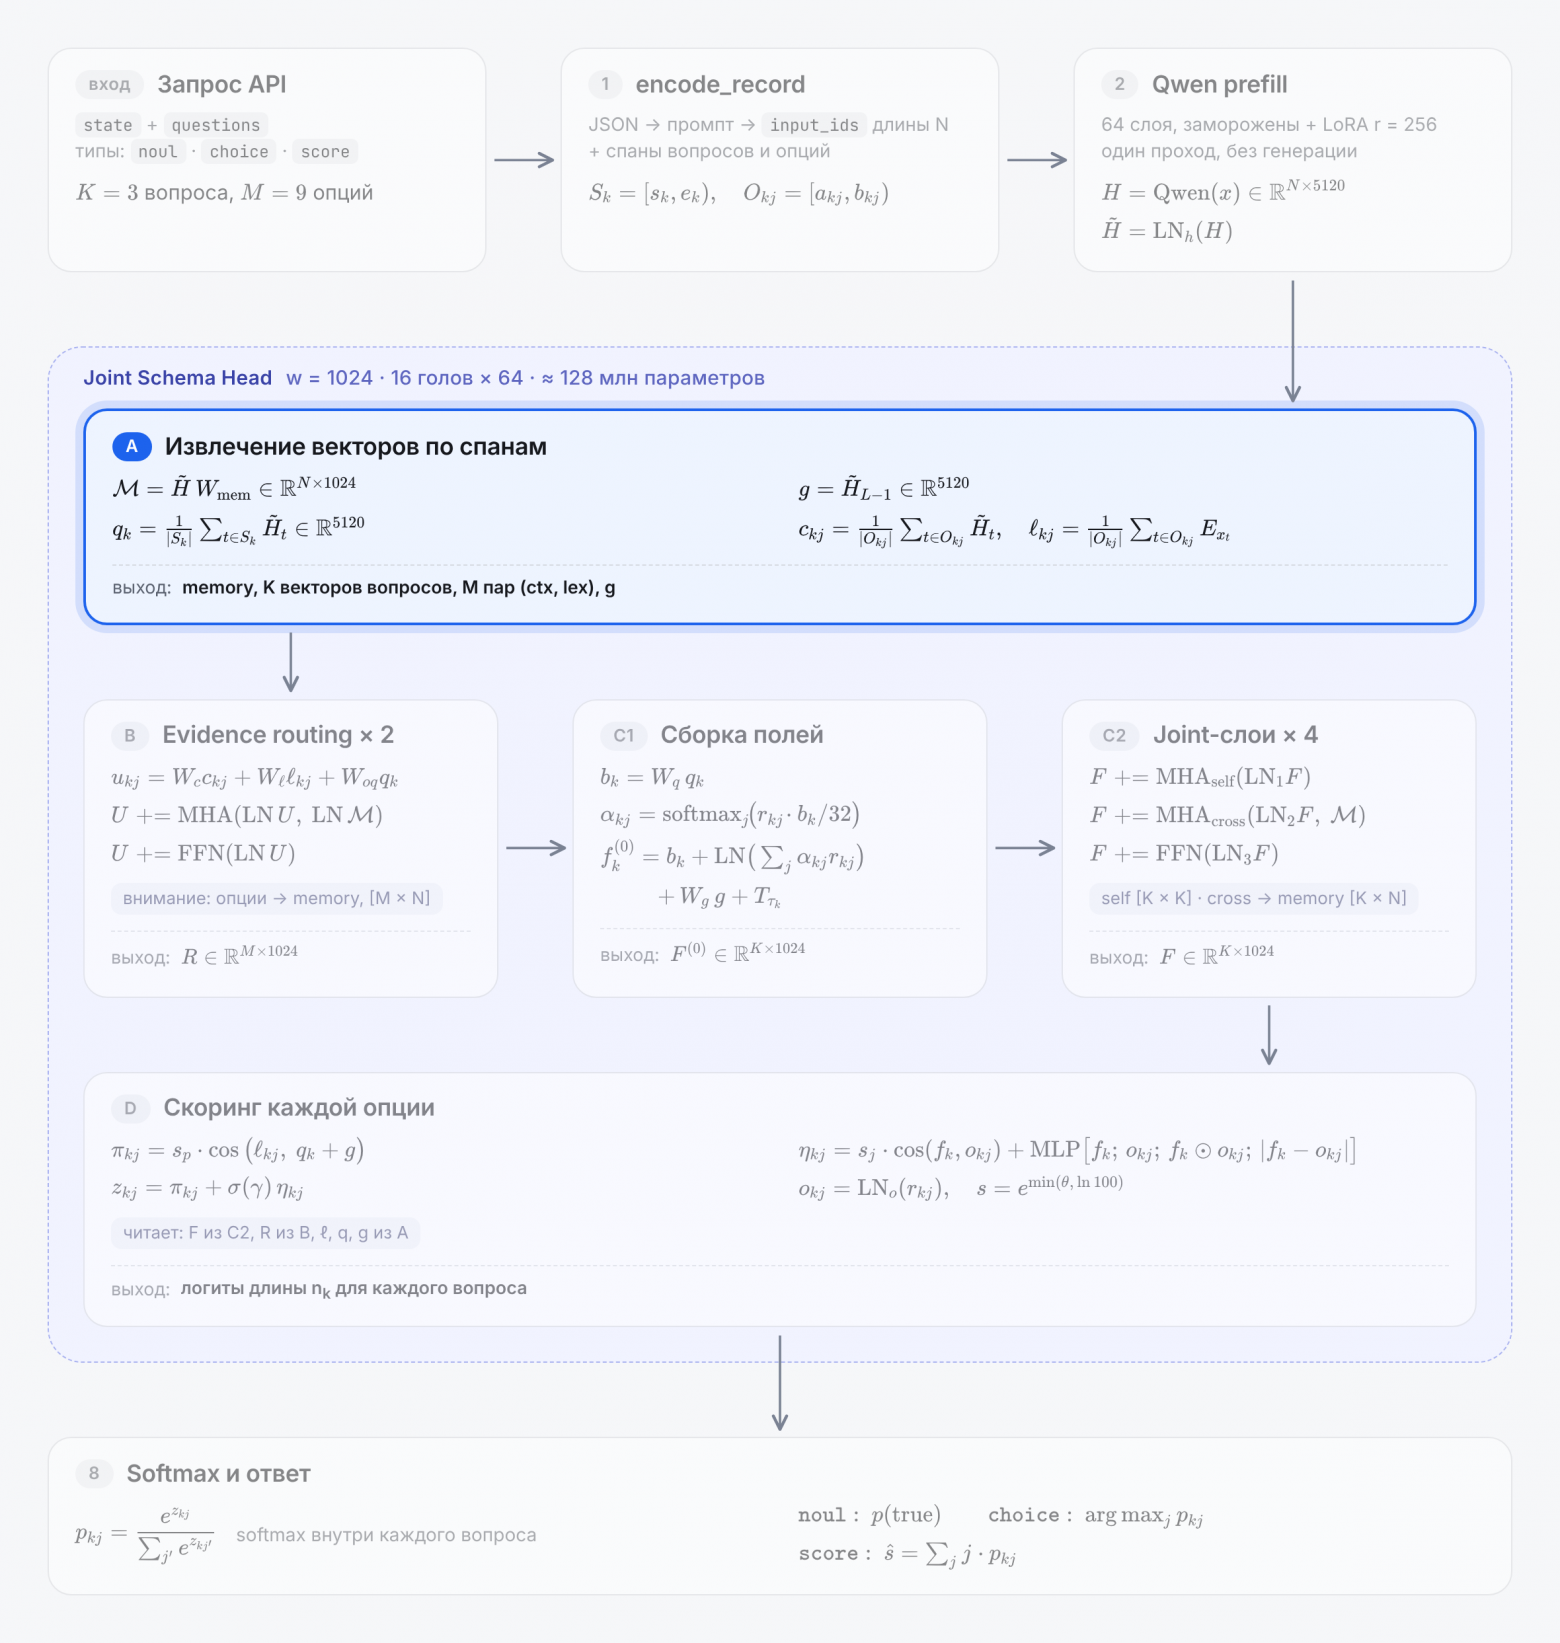
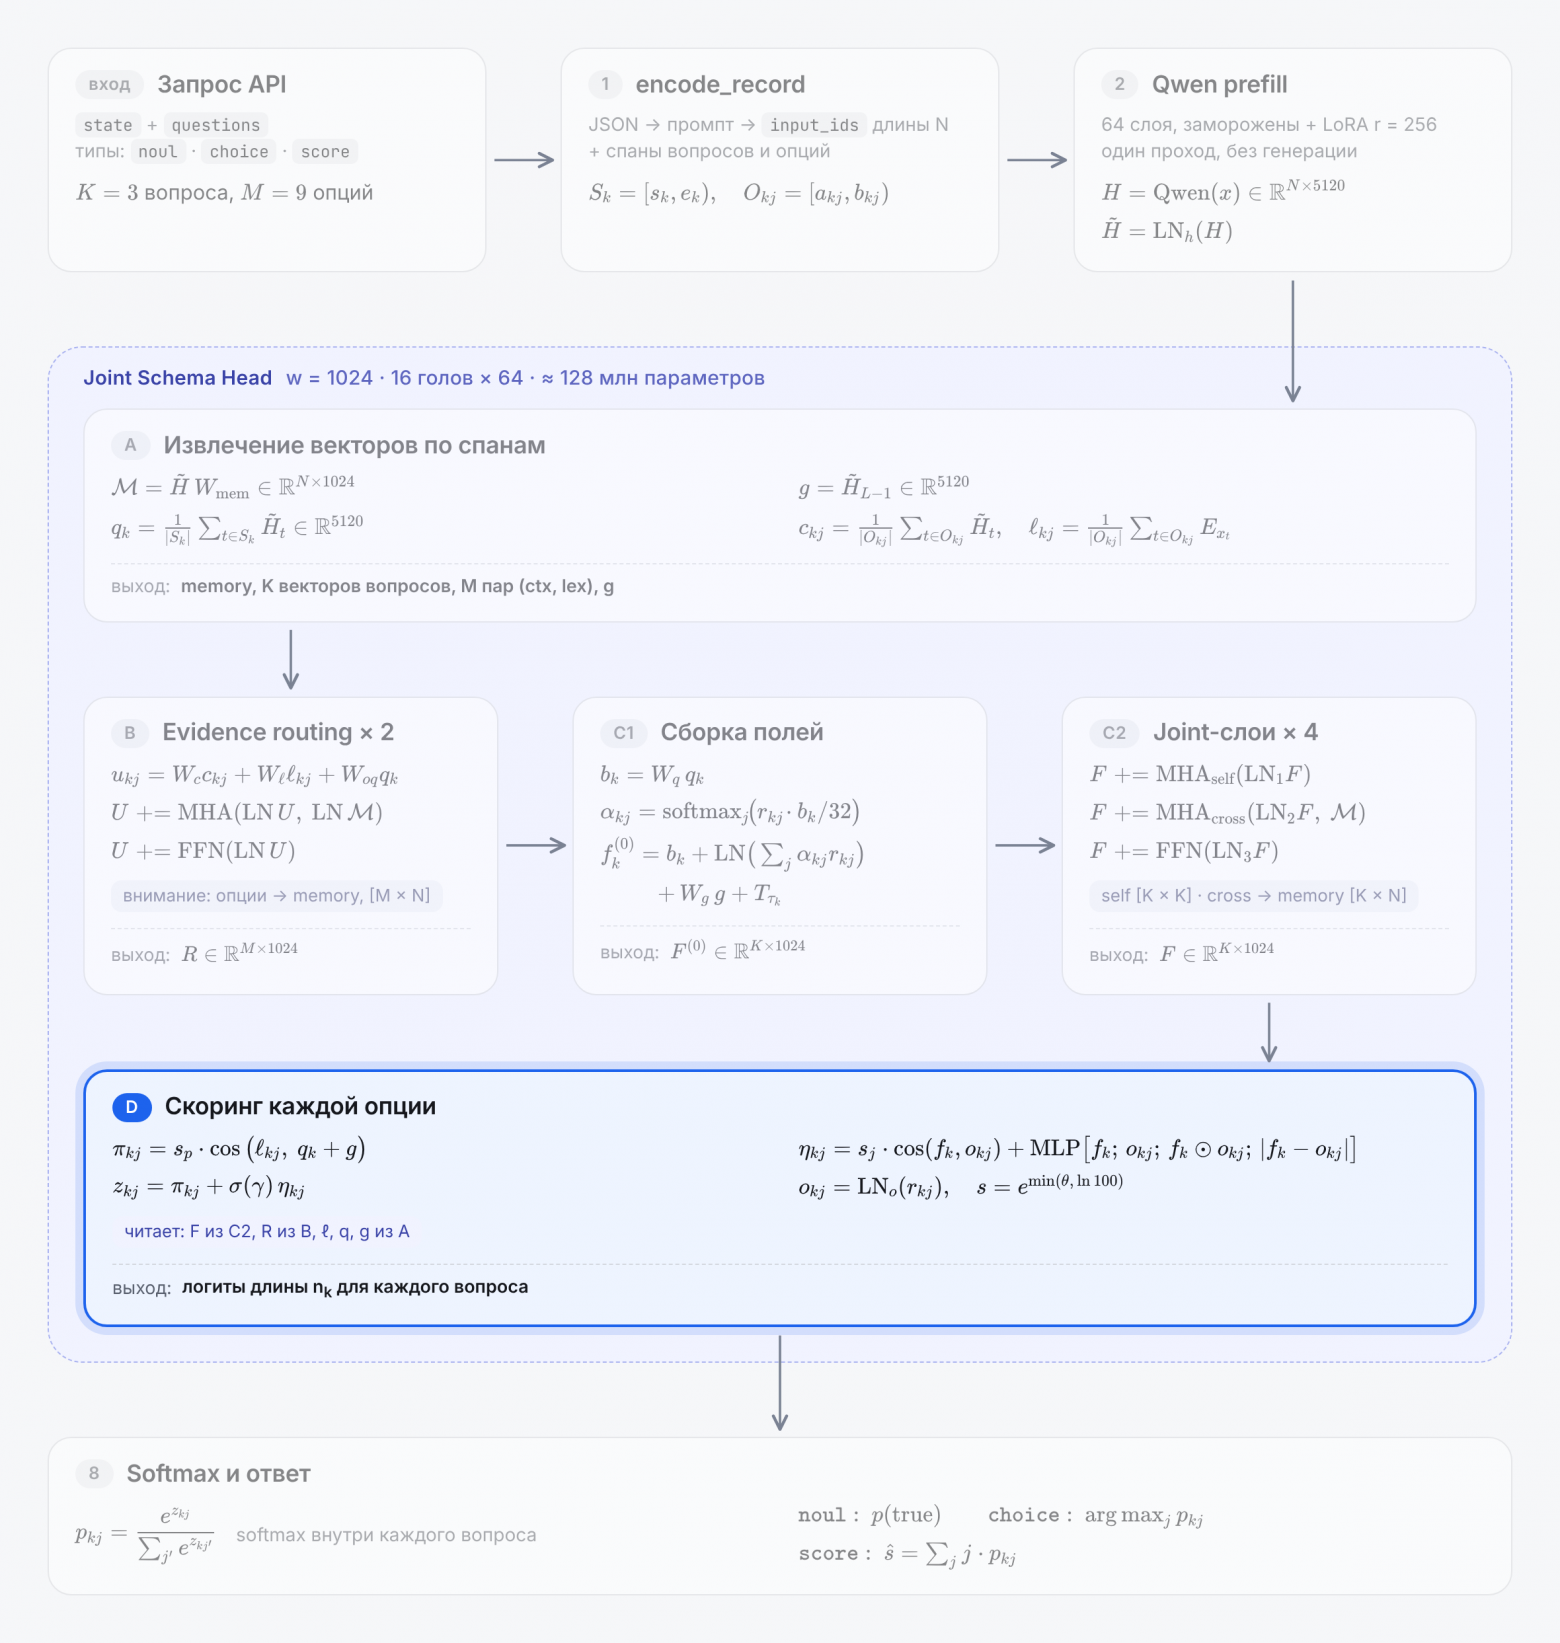
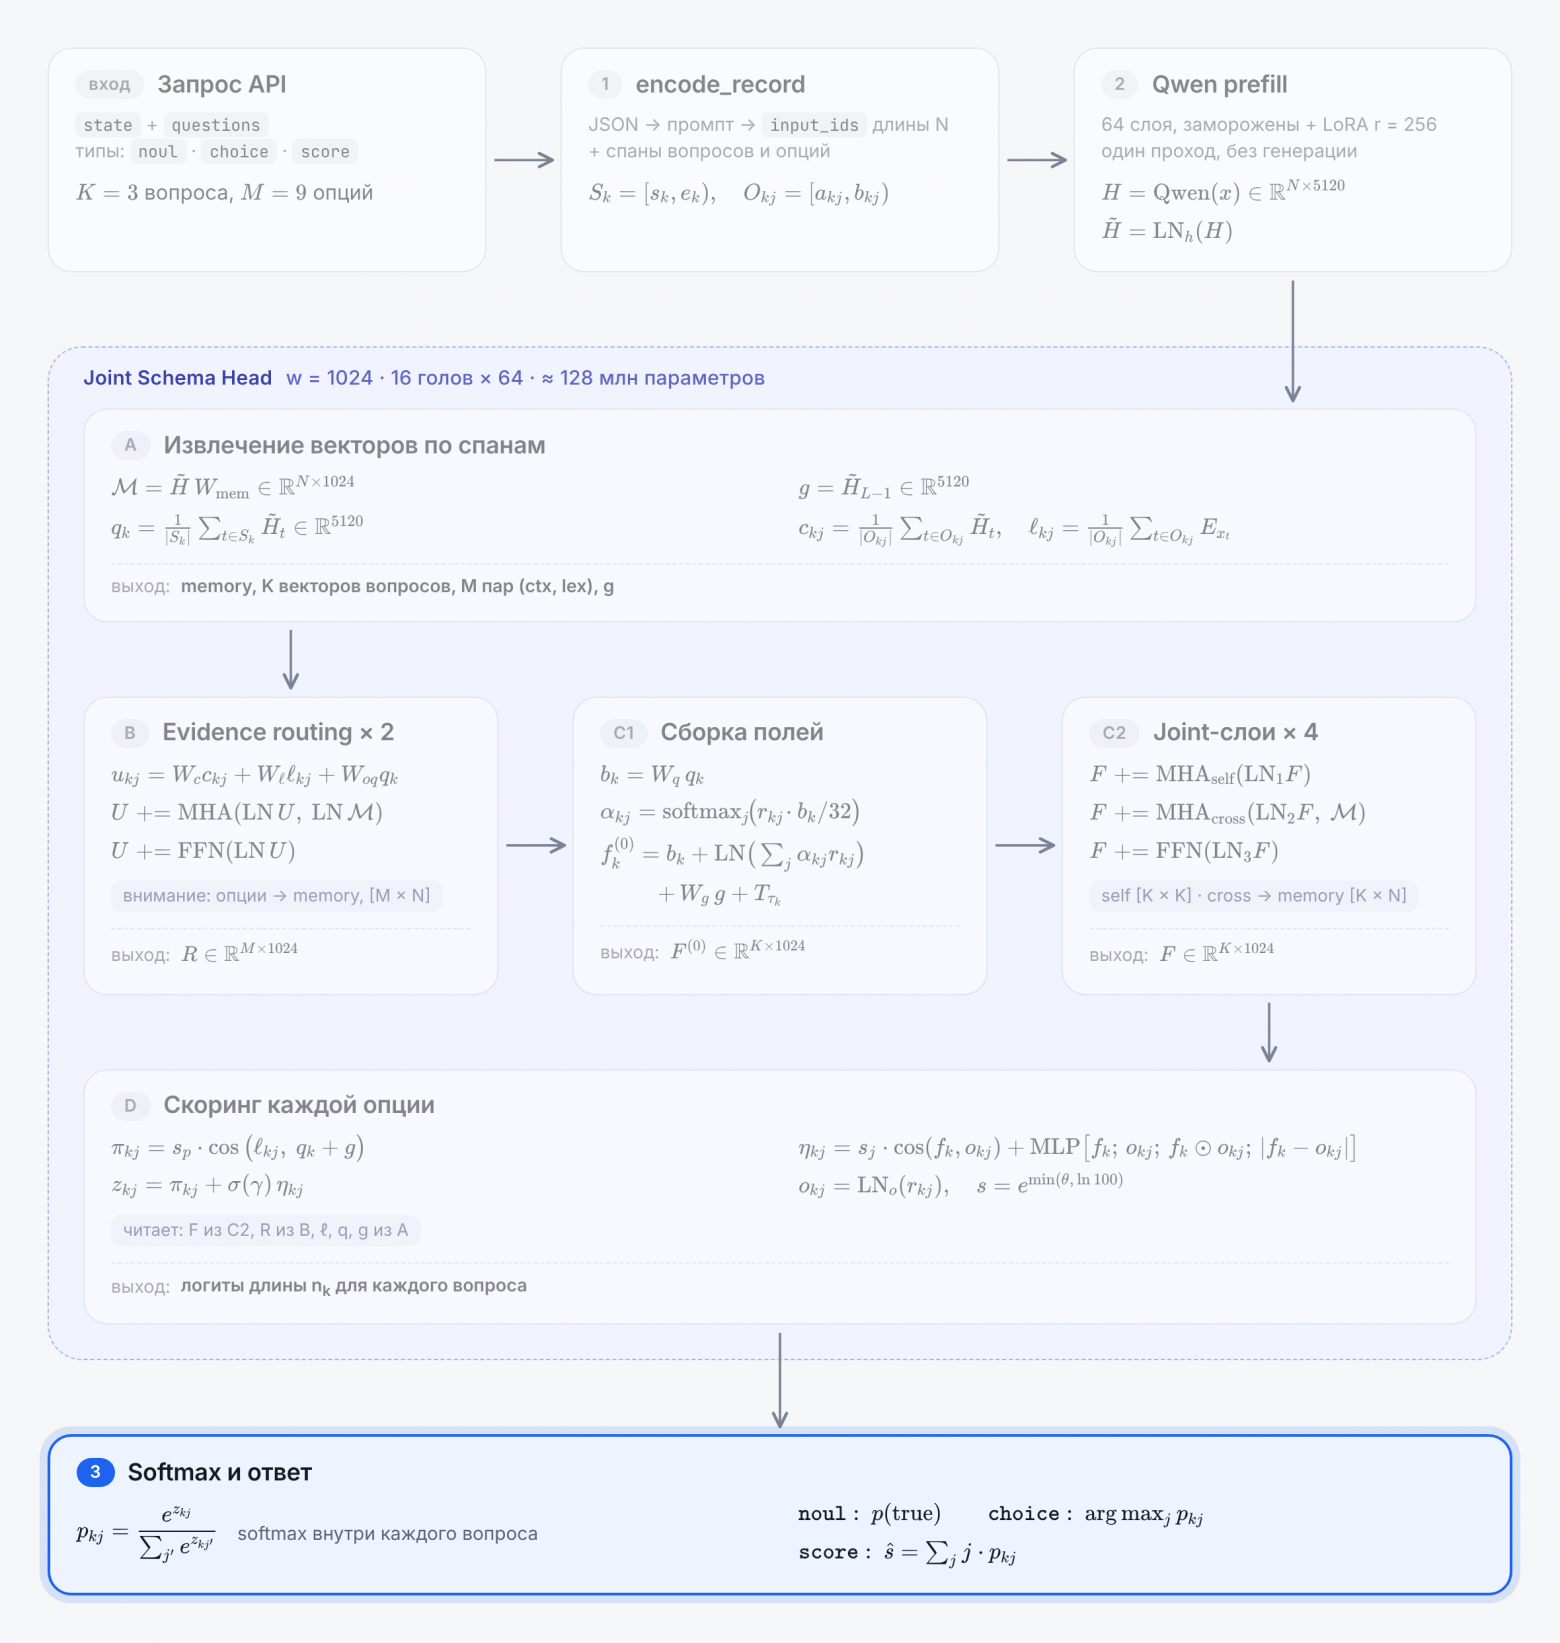
Общая схема и обозначения
|
Символ |
Значение |
|---|---|
|
|
число токенов в последовательности |
|
|
размер скрытого состояния Qwen |
|
|
ширина головы |
|
|
число вопросов |
|
|
число опций у вопроса |
|
|
всего опций |
|
|
спан инструкции вопроса |
|
|
спан опции |
|
|
выход Qwen после LayerNorm головы, |
|
|
матрица |
|
|
номер токена в позиции |


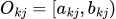
 вопроса


 (
Вход: запрос API
Запрос состоит из state (о чём решаем) и questions (что нужно решить). Пример от Cloudflare:
{ "model": "clef", "state": "Checkout has been failing for every customer for the last hour.", "questions": { "urgent": { "type": "noul", "instructions": "Is this support request urgent?" }, "team": { "type": "choice", "instructions": "Which team should handle this request?", "criteria": { "billing": "Payments, invoices, and refunds", "technical": "Outages, errors, and configuration", "sales": "Plans and upgrades" } }, "severity": { "type": "score", "instructions": "How severe is the customer impact?", "criteria": ["No impact", "Minor", "Major", "Critical"] } }}
Типы вопросов
|
Тип |
Смысл |
Откуда берутся опции |
Опций в примере |
|---|---|---|---|
|
|
да / нет |
создаются автоматически: |
2 |
|
|
один вариант из списка |
ключи |
3 |
|
|
уровень на шкале |
индексы списка |
4 |
Как вопрос превращается в список опций
Код из joint_schema_model.py:
QUESTION_TYPES = {"noul": 0, "choice": 1, "score": 2}def question_options(question: dict[str, Any]) -> list[tuple[str, Any]]: question_type = str(question["type"]) if question_type == "noul": criteria = { "true": "The proposition is true or the answer is yes.", "false": "The proposition is false or the answer is no.", } criteria.update(question.get("criteria") or {}) return [(key, criteria[key]) for key in ("true", "false")] if question_type == "choice": return sorted((str(key), value) for key, value in question["criteria"].items()) return [(str(index), value) for index, value in enumerate(question["criteria"])]
Для team получается отсортированный по ID список:
[("billing", "Payments, invoices, and refunds"), ("sales", "Plans and upgrades"), ("technical", "Outages, errors, and configuration")]
Этап 1. encode_record: запрос становится текстом
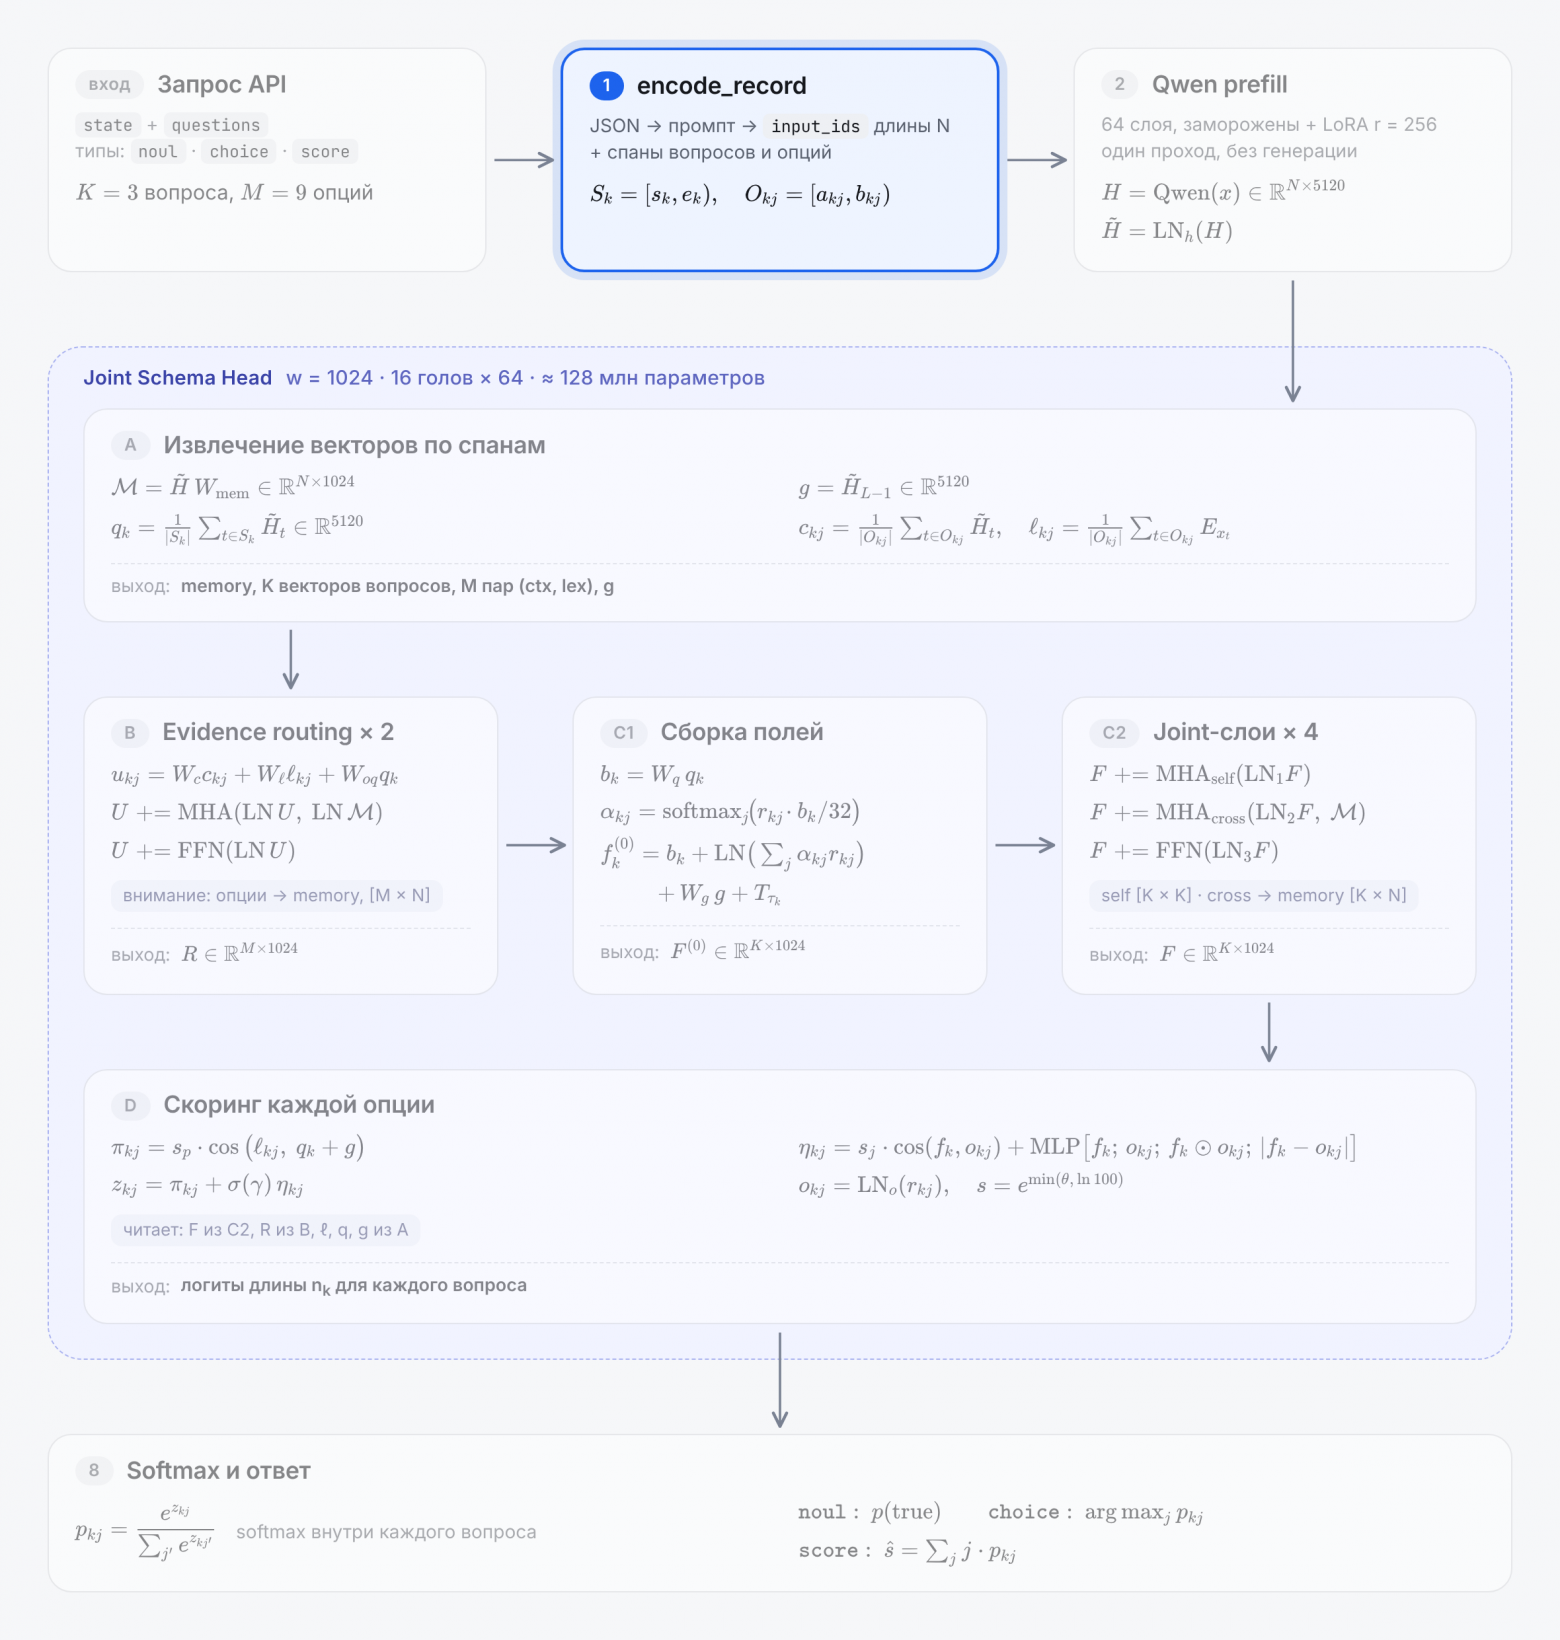
encode_record склеивает все поля JSON в один промпт и попутно запоминает, где в нём лежит каждый вопрос и каждая опция.
Это происходит в три шага.
Шаг 1. question_options превращает criteria в список пар (раздел 2).
Шаг 2. Каждая пара заворачивается в маленький словарь:
semantics = {"option_id": option_id}if description is not None: semantics["description"] = description
Шаг 3. Словарь превращается в строку функцией render:
def render(value: Any) -> str: if isinstance(value, str): return value return json.dumps( value, ensure_ascii=False, separators=(",", ":"), sort_keys=True, )
Получается:
{"description":"Payments, invoices, and refunds","option_id":"billing"}
Фиксированный порядок ключей и отсутствие пробелов нужны, чтобы одна и та же опция всегда давала одни и те же токены.
Промпт целиком ([префикс], [state] и т.д добавлены для наглядности):
[префикс] <|im_start|>system Read the complete state and schema. Decide every field jointly. ...<|im_end|> <|im_start|>user STATE:[state] Checkout has been failing for every customer for the last hour.[схема] SCHEMA FIELDS: FIELD 1 ID: urgent TYPE: noul INSTRUCTION: Is this support request urgent? ← question_span ALLOWED OPTIONS: OPTION 1: {"description":"The proposition is true or the answer is yes.","option_id":"true"} ← option_span OPTION 2: {"description":"The proposition is false or the answer is no.","option_id":"false"} ← option_span END FIELD FIELD 2 ID: team TYPE: choice INSTRUCTION: Which team should handle this request? ← question_span ALLOWED OPTIONS: OPTION 1: {"description":"Payments, invoices, and refunds","option_id":"billing"} OPTION 2: {"description":"Plans and upgrades","option_id":"sales"} OPTION 3: {"description":"Outages, errors, and configuration","option_id":"technical"} END FIELD FIELD 3 ID: severity TYPE: score INSTRUCTION: How severe is the customer impact? ← question_span ALLOWED OPTIONS: OPTION 1: {"description":"No impact","option_id":"0"} OPTION 2: {"description":"Minor","option_id":"1"} OPTION 3: {"description":"Major","option_id":"2"} OPTION 4: {"description":"Critical","option_id":"3"} END FIELD[суффикс] <|im_end|> <|im_start|>assistant <think> </think> JOINT SCHEMA DECISIONS:
Код
После токенизации алгоритм запоминает позиции в промпте вопросов и опций:
def encode_record( tokenizer: Any, record: dict[str, Any], max_length: int = 16384, max_state_tokens: int | None = None, processor: Any | None = None,) -> EncodedRecord: schema_ids = _tokens(tokenizer, "\n\nSCHEMA FIELDS:\n") questions: list[EncodedQuestion] = [] for question_index, (question_id, question) in enumerate(record["questions"].items()): schema_ids.extend( _tokens( tokenizer, f"\nFIELD {question_index + 1}\nID: {question_id}\nTYPE: {question['type']}\nINSTRUCTION: ", ) ) question_start = len(schema_ids) instructions = question.get("instructions") if instructions is None or instructions == "": instructions = str(question_id) schema_ids.extend(_tokens(tokenizer, render(instructions))) question_end = len(schema_ids) schema_ids.extend(_tokens(tokenizer, "\nALLOWED OPTIONS:\n")) option_spans: list[tuple[int, int]] = [] option_ids: list[str] = [] for option_index, (option_id, description) in enumerate(question_options(question)): schema_ids.extend(_tokens(tokenizer, f"OPTION {option_index + 1}: ")) option_start = len(schema_ids) semantics = {"option_id": option_id} if description is not None: semantics["description"] = description schema_ids.extend(_tokens(tokenizer, render(semantics))) option_spans.append((option_start, len(schema_ids))) option_ids.append(option_id) schema_ids.extend(_tokens(tokenizer, "\n")) schema_ids.extend(_tokens(tokenizer, "END FIELD\n"))
Каждый кусок токенизируется отдельно для того, чтобы не происходило склеивание (если токенизировать весь промпт целиком, BPE может склеить конец "OPTION 1: " с началом JSON в о10. дин токен)
После этого происходит сдвиг всей схемы на длину префикса и state:
schema_offset = len(prefix_ids) + len(state_ids) shifted_questions = tuple( EncodedQuestion( question_id=question.question_id, question_type=question.question_type, question_span=( question.question_span[0] + schema_offset, question.question_span[1] + schema_offset, ), option_spans=tuple( (start + schema_offset, end + schema_offset) for start, end in question.option_spans ), option_ids=question.option_ids, ) for question in questions ) input_ids = tuple(prefix_ids + state_ids + schema_ids + suffix_ids)
Выход этапа
|
Выход |
Размер |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
метаданные для сборки ответа |

 пары чисел
 пар чисел, сгруппированы по вопросам
Этап 2. Qwen: один проход
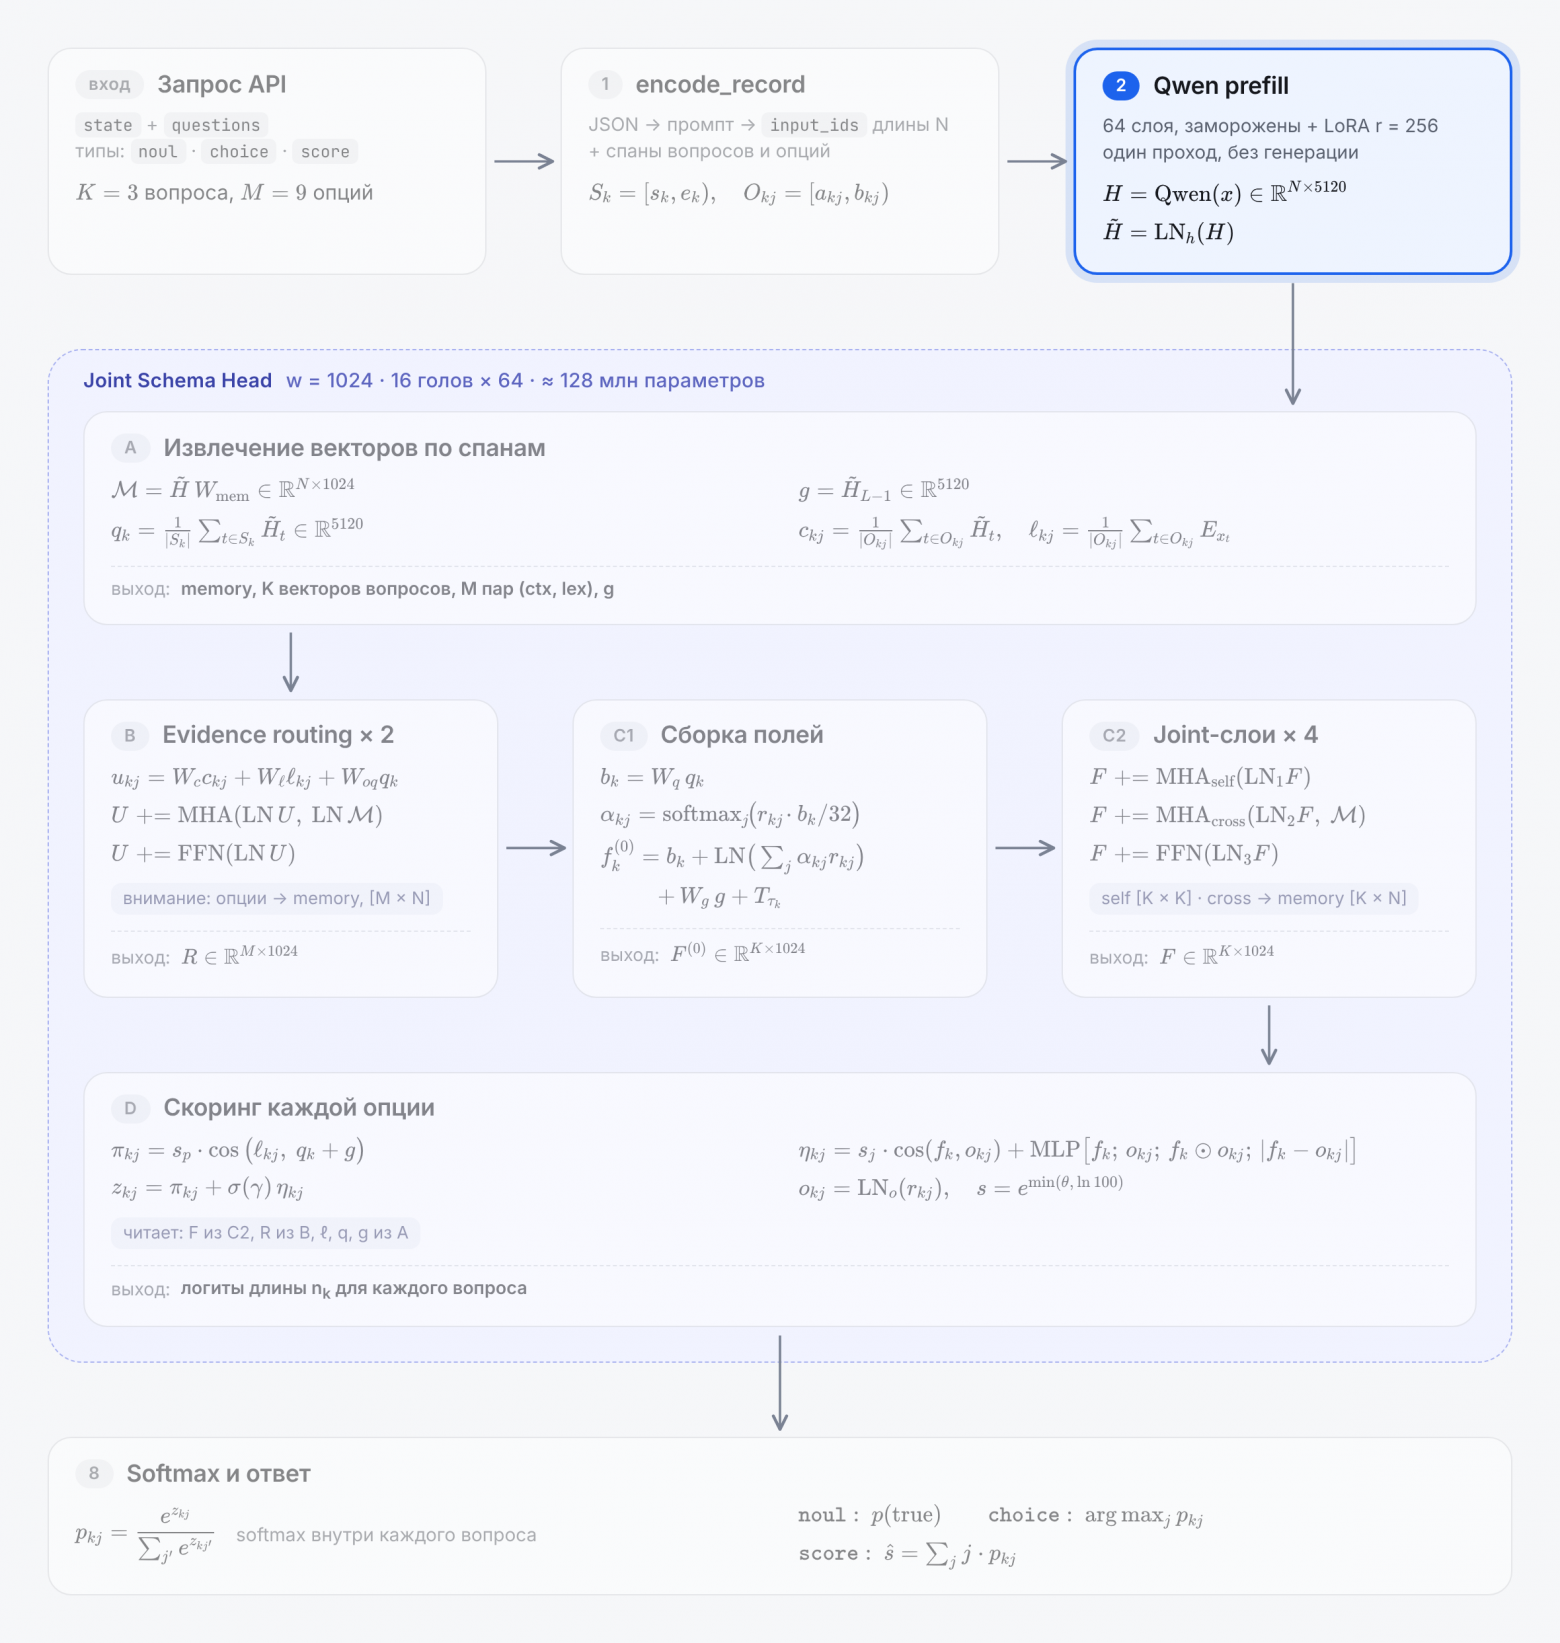
На этом этапе происходит расчет по всем слоям без головы и применение LayerNorm к последнему выходному слою:
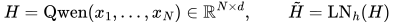
Выход этапа
last_hidden_state 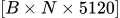 — по вектору на каждый токен каждой записи батча.
Этап A. Извлечение векторов
После этапа 2 есть таблица  . Номер строки совпадает с номером токена в
input_ids. Этап A вырезает из этой таблицы нужные строки (спаны, которые были выделены ранее).
строка токен вектор 0 <|im_start|> [ ... ] ... 152 Which [ ... ] ┐ ... ├ question_span team = (152, 160) 159 ? [ ... ] ┘ ... 164 {" [ ... ] ┐ 165 description [ ... ] │ ... ├ option_span billing = (164, 184) 183 "} [ ... ] ┘ ... 319 : [ ... ] ← последний токен
Код
def forward( self, hidden_states: torch.Tensor, input_ids: torch.Tensor, attention_mask: torch.Tensor, records: list[EncodedRecord], output_embedding_weight: torch.Tensor, ) -> list[list[torch.Tensor]]: results: list[list[torch.Tensor]] = [] normalized_hidden = self.hidden_norm(hidden_states) for batch_index, record in enumerate(records): sequence_length = int(attention_mask[batch_index].sum().item()) sequence_hidden = normalized_hidden[batch_index, :sequence_length] memory = self.memory_projection(sequence_hidden).unsqueeze(0) global_vector = sequence_hidden[-1] question_vectors = torch.stack( [ self._mean_span(sequence_hidden, question.question_span) for question in record.questions ] ) type_ids = torch.tensor( [question.question_type for question in record.questions], device=hidden_states.device, ) option_contexts: list[torch.Tensor] = [] lexical_options: list[torch.Tensor] = [] option_counts = [] for question in record.questions: context_vectors = torch.stack( [ self._mean_span(sequence_hidden, span) for span in question.option_spans ] ) lexical_vectors = [] for start, end in question.option_spans: token_ids = input_ids[batch_index, start:end] lexical_vectors.append(output_embedding_weight[token_ids].mean(dim=0)) lexical = torch.stack(lexical_vectors) option_contexts.append(context_vectors) lexical_options.append(lexical) option_counts.append(len(question.option_spans))```
Сама операция среднего по спану:
@staticmethod def _mean_span(values: torch.Tensor, span: tuple[int, int]) -> torch.Tensor: start, end = span return values[start:end].mean(dim=0)
В итоге имеем следующие сущности:
|
Выход |
Какие строки берутся |
Размер |
Смысл |
|---|---|---|---|
|
memory |
|
|
«база улик», весь текст |
|
|
одна строка |
|
сжатое «всё прочитанное» |
|
|
строки инструкции вопроса |
|
смысл каждого вопроса |
|
|
строки опции в |
|
опция в контексте |
|
|
те же позиции, но через |
|
словарный смысл слов опции |

 умноженная на


Немного формул:
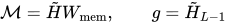
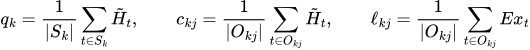
Пример:
Вектор вопроса. Пусть question_span team = (5, 8), то есть строки 5, 6, 7:
строка 5 "Which" [ 0.2, 1.0, -0.4, 0.6 ]строка 6 "team" [ 0.8, 0.6, 0.0, 0.2 ]строка 7 "?" [-0.1, 0.2, 0.4, 1.0 ] ───────────────────────── среднее по столбцамq_team = [ 0.3, 0.6, 0.0, 0.6 ]
Каждая координата — среднее трёх чисел в столбце: например, (0.2+0.8-0.1)/3=0.3.
Контекстный вектор опции. Пусть option_span billing = (9, 11), то есть строки 9 и 10:
строка 9 "billing" [ 1.2, -0.2, 0.4, 0.0 ]строка 10 "payments" [ 0.6, 0.4, 0.2, 0.8 ] ─────────────────────────ctx_billing = [ 0.9, 0.1, 0.3, 0.4 ]
Лексический вектор опции. Позиции те же (9, 11), но строки берутся не из  . Сначала по спану читаются номера токенов, потом по этим номерам берутся строки
lm_head (номера условные):
input_ids[9] = 3729 → E[3729] = [ 0.05, -0.02, 0.10, 0.01 ]input_ids[10] = 14310 → E[14310] = [ 0.03, 0.04, 0.02, -0.01 ] ───────────────────────────lex_billing = [ 0.04, 0.01, 0.06, 0.00 ]
Разница между ctx и lex: строка 9 в  — это слово «billing», прочитанное Qwen после тикета, и она меняется от запроса к запросу. Строка
 — слово «billing» само по себе, и она всегда одна и та же.
g и memory. g — просто последняя строка таблицы. memory — все строки, каждая умноженная на  . Спаны тут не нужны.
Выход этапа
|
Выход |
Размер |
Как хранится |
|---|---|---|
|
memory |
|
одна матрица |
|
|
|
один вектор |
|
|
|
по вектору на вопрос, в порядке вопросов |
|
|
|
списки по вопросам: 2, 3, 4 |
|
|
|
списки по вопросам: 2, 3, 4 |
|
|
|
сколько опций у каждого вопроса |
|
|
|
тип каждого вопроса |


Прежде чем переходить к следующему этапу распишу какие проекции мы имеем:
self.hidden_norm = torch.nn.LayerNorm(hidden_size)self.memory_projection = torch.nn.Linear(hidden_size, width, bias=False)self.question_projection = torch.nn.Linear(hidden_size, width, bias=False)self.option_question_projection = torch.nn.Linear(hidden_size, width, bias=False)self.global_projection = torch.nn.Linear(hidden_size, width, bias=False)self.option_context_projection = torch.nn.Linear(hidden_size, width, bias=False)self.option_lexical_projection = torch.nn.Linear(hidden_size, width, bias=False)self.type_embedding = torch.nn.Embedding(3, width)
|
Матрица |
Слой в коде |
Вход |
|---|---|---|
|
|
|
все токены |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
тип вопроса (0, 1, 2) |

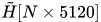

 каждой опции


 каждой опции


 вопроса, которому принадлежит опция

 каждого вопроса


Этап B. Evidence routing ×2
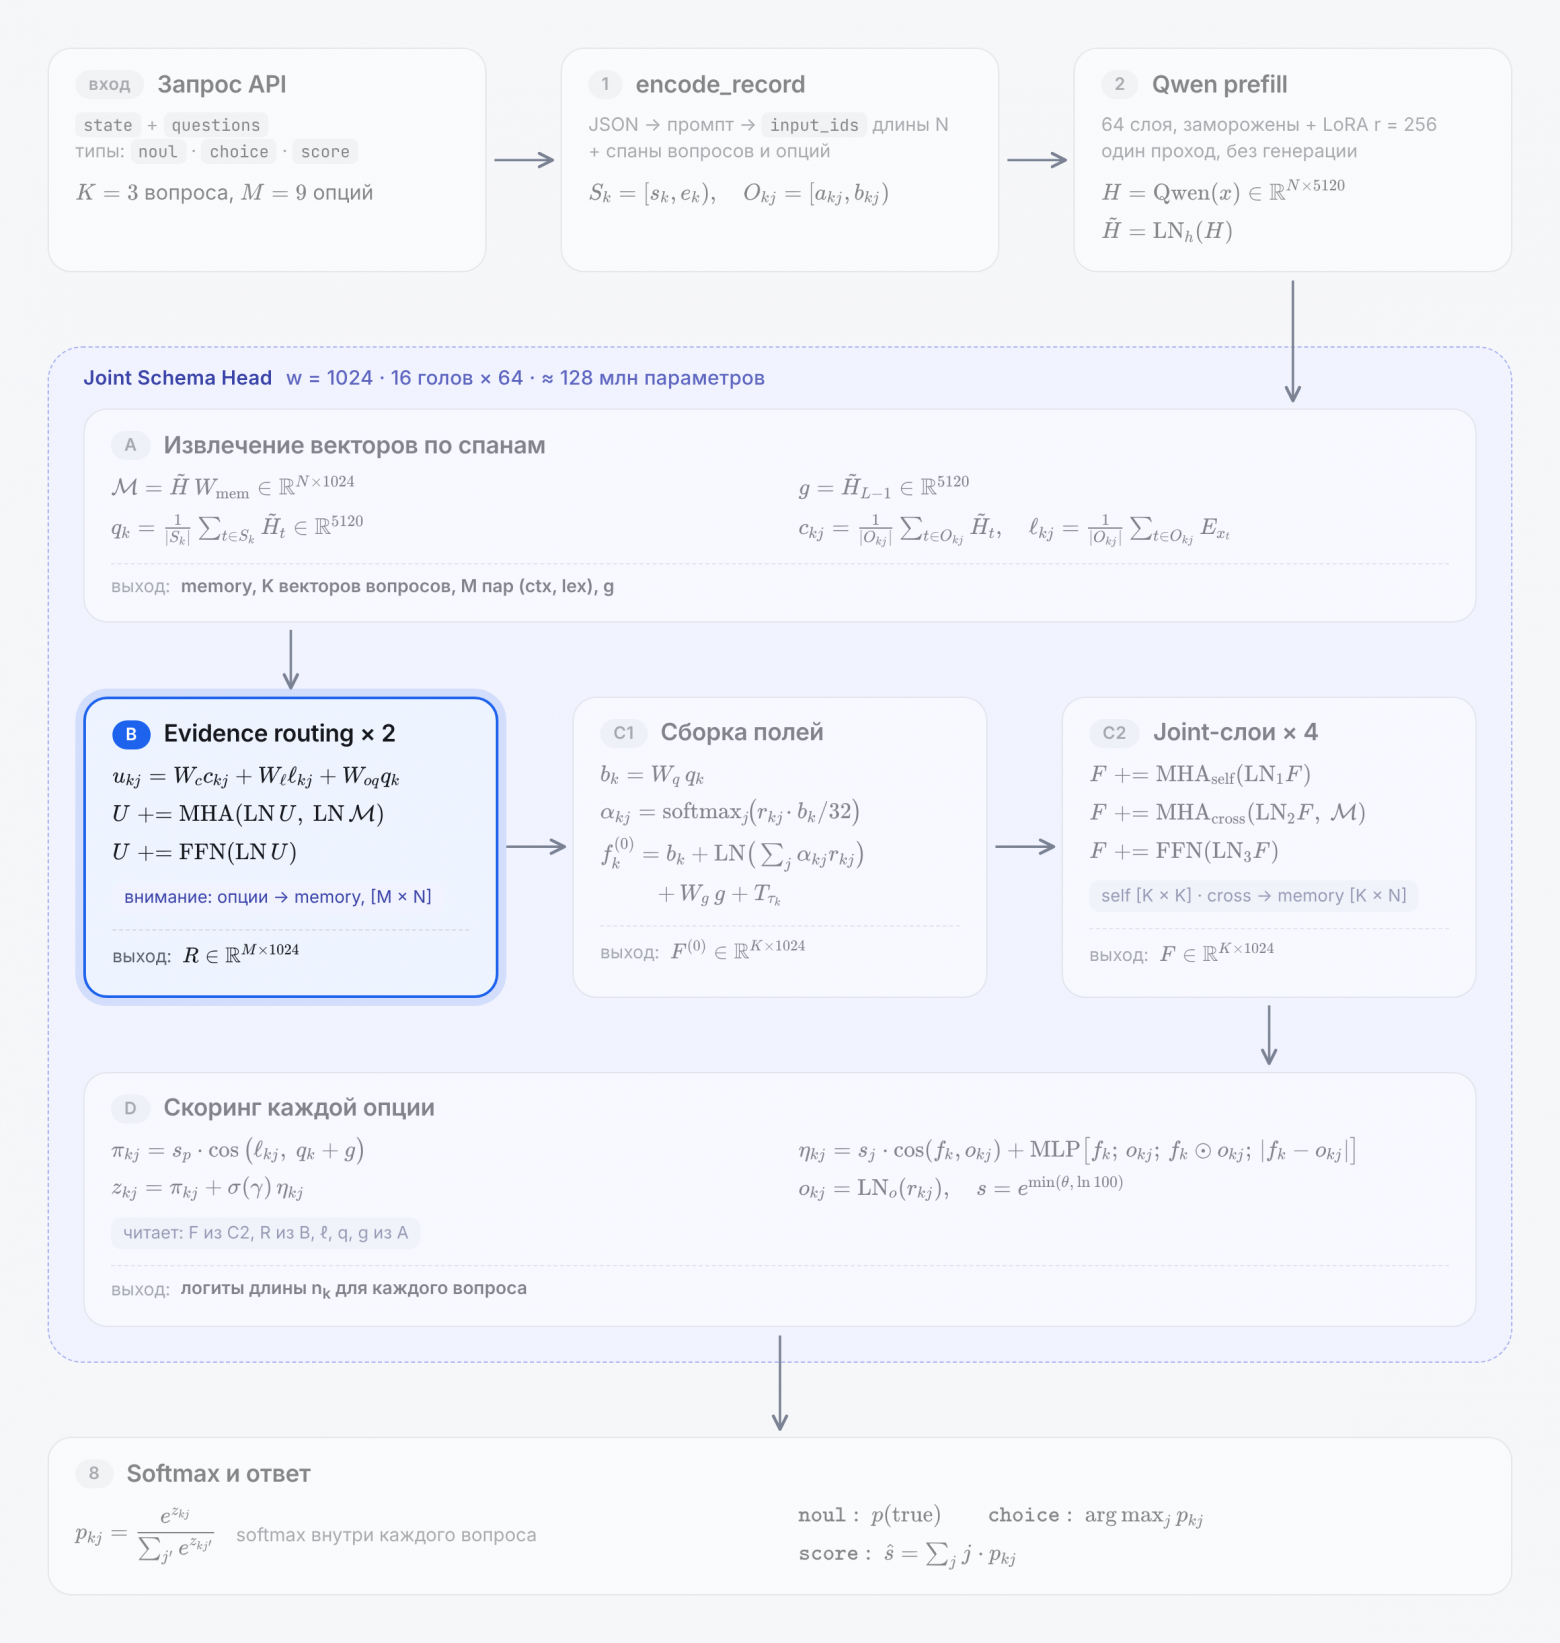
Evidence routing — этап, в котором каждая опция сама ищет в тексте подтверждения для себя. Это два одинаковых по устройству слоя EvidenceRoutingLayer, каждый со своими весами.
Сам Слой
class EvidenceRoutingLayer(torch.nn.Module): def __init__( self, width: int, heads: int, feedforward: int, dropout: float = 0.0, ) -> None: super().__init__() self.query_norm = torch.nn.LayerNorm(width) self.memory_norm = torch.nn.LayerNorm(width) self.attention = torch.nn.MultiheadAttention( width, heads, dropout=dropout, batch_first=True, ) self.attention_dropout = torch.nn.Dropout(dropout) self.feedforward_norm = torch.nn.LayerNorm(width) self.feedforward = torch.nn.Sequential( torch.nn.Linear(width, feedforward), torch.nn.GELU(), torch.nn.Dropout(dropout), torch.nn.Linear(feedforward, width), torch.nn.Dropout(dropout), ) def forward(self, queries: torch.Tensor, memory: torch.Tensor) -> torch.Tensor: normalized_queries = self.query_norm(queries) routed, _ = self.attention( normalized_queries, self.memory_norm(memory), self.memory_norm(memory), need_weights=False, ) queries = queries + self.attention_dropout(routed) return queries + self.feedforward(self.feedforward_norm(queries))
Каждая опция обрабатывается независимо и на выходе получаем распределение «важности» токена всего запроса к конкретной опции.
Вход
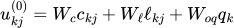
Для вопроса team:
u_billing = W_c·ctx_billing + W_ℓ·lex_billing + W_oq·q_teamu_sales = W_c·ctx_sales + W_ℓ·lex_sales + W_oq·q_teamu_technical = W_c·ctx_technical + W_ℓ·lex_technical + W_oq·q_team
Что даёт каждое слагаемое:
-
 — что Qwen понял об опции после прочтения тикета;
-
 — что значат слова опции сами по себе;
-
 — к какому вопросу опция относится. Опция ищет в тексте «что-то про себя в контексте этого вопроса».
Опции всех вопросов склеиваются в одну матрицу 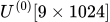 . Это же представление попадает на вход второго
EvidenceRoutingLayer
Код
Сборка запросов и вызов слоёв в JointSchemaHead.forward:
option_queries = []for question_index, (context_vectors, lexical) in enumerate( zip(option_contexts, lexical_options)): option_queries.append( self.option_context_projection(context_vectors) + self.option_lexical_projection(lexical) + self.option_question_projection( question_vectors[question_index] ).unsqueeze(0) )routed_options = torch.cat(option_queries, dim=0).unsqueeze(0)for layer in self.evidence_layers: routed_options = layer(routed_options, memory)routed_options = routed_options[0]split_options = list(torch.split(routed_options, option_counts, dim=0))
Выход этапа
 режется обратно на группы вопросов (обогащенные).
Этап C1. Сборка поля для каждого вопроса
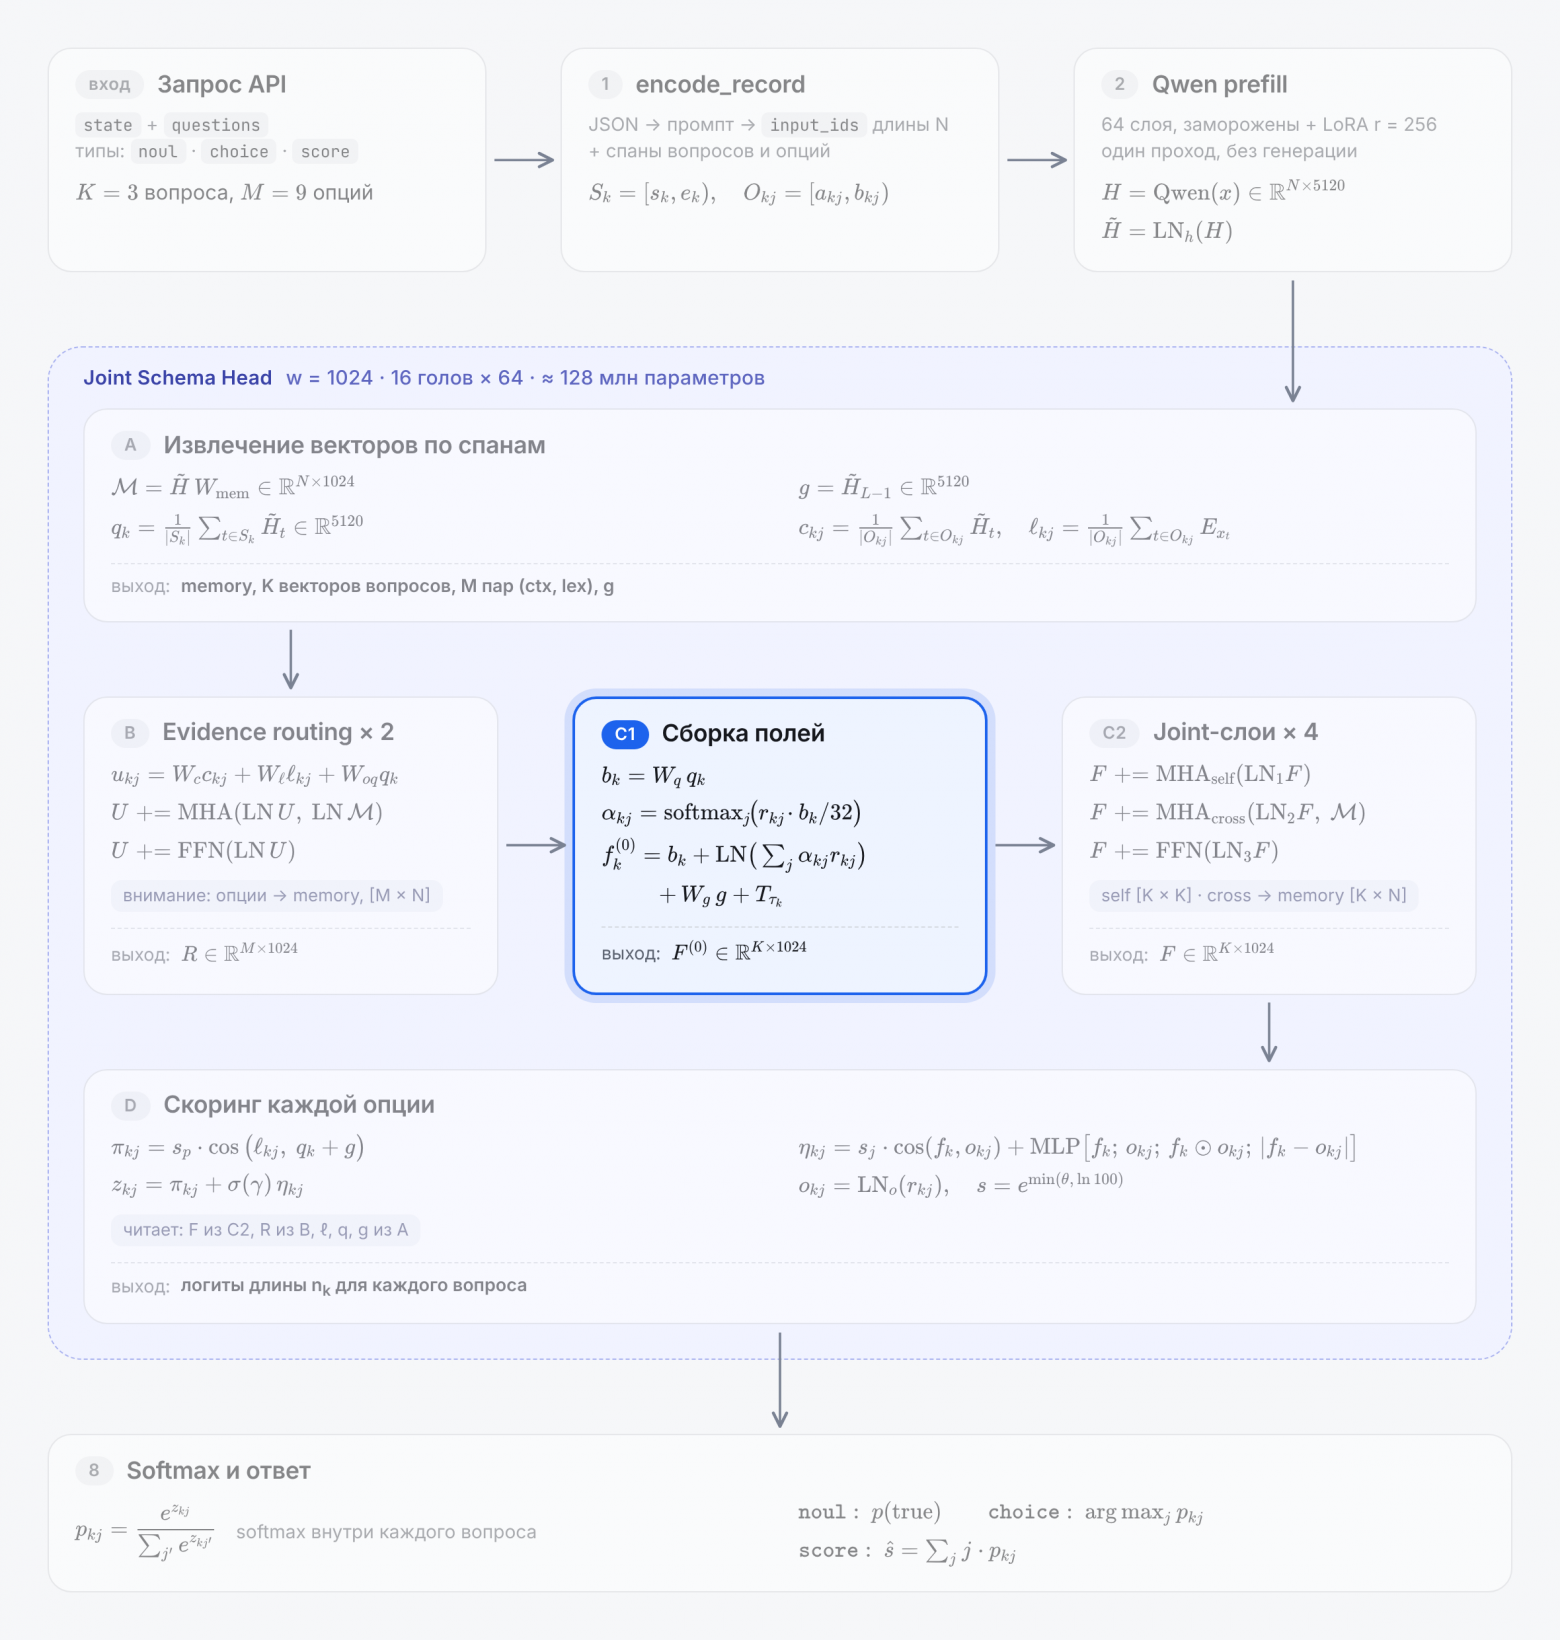
На этом этапе для каждого вопроса собирается один вектор — поле. Поле дальше пойдёт в joint-слои, и в конце с ним будут сравниваться опции.
|
Вход |
Размер |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
 — вектор вопроса

 — обогащённые опции вопроса

 — последний токен


Код
base_fields = self.question_projection(question_vectors)option_summaries = []for field, options in zip(base_fields, split_options): routing_weights = torch.softmax( torch.matmul(options, field) / math.sqrt(options.shape[-1]), dim=0, ) option_summaries.append( torch.sum(routing_weights.unsqueeze(-1) * options, dim=0) )fields = ( base_fields + self.option_summary_norm(torch.stack(option_summaries)) + self.global_projection(global_vector).unsqueeze(0) + self.type_embedding(type_ids))
Шаги по порядку
1.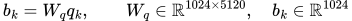
2. 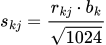 — оценка каждой опции.
3. 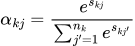 — Softmax. Распределение опций каждого вопроса.
4. 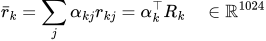 — получаем вектор, который представляет собой общую картину по всем опциям для каждого вопроса.
5.  — нормализация.
6. 
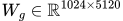 — глобальная добавка. Все поля «знают», о чём весь тикет.
7. 
 — эмбеддинг типа. Таблица из трёх обучаемых строк: noul, choice, score. Поле знает, как будут читаться его опции.
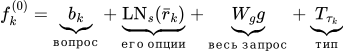
Выход этапа
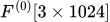
Этап C2. Joint-слои ×4
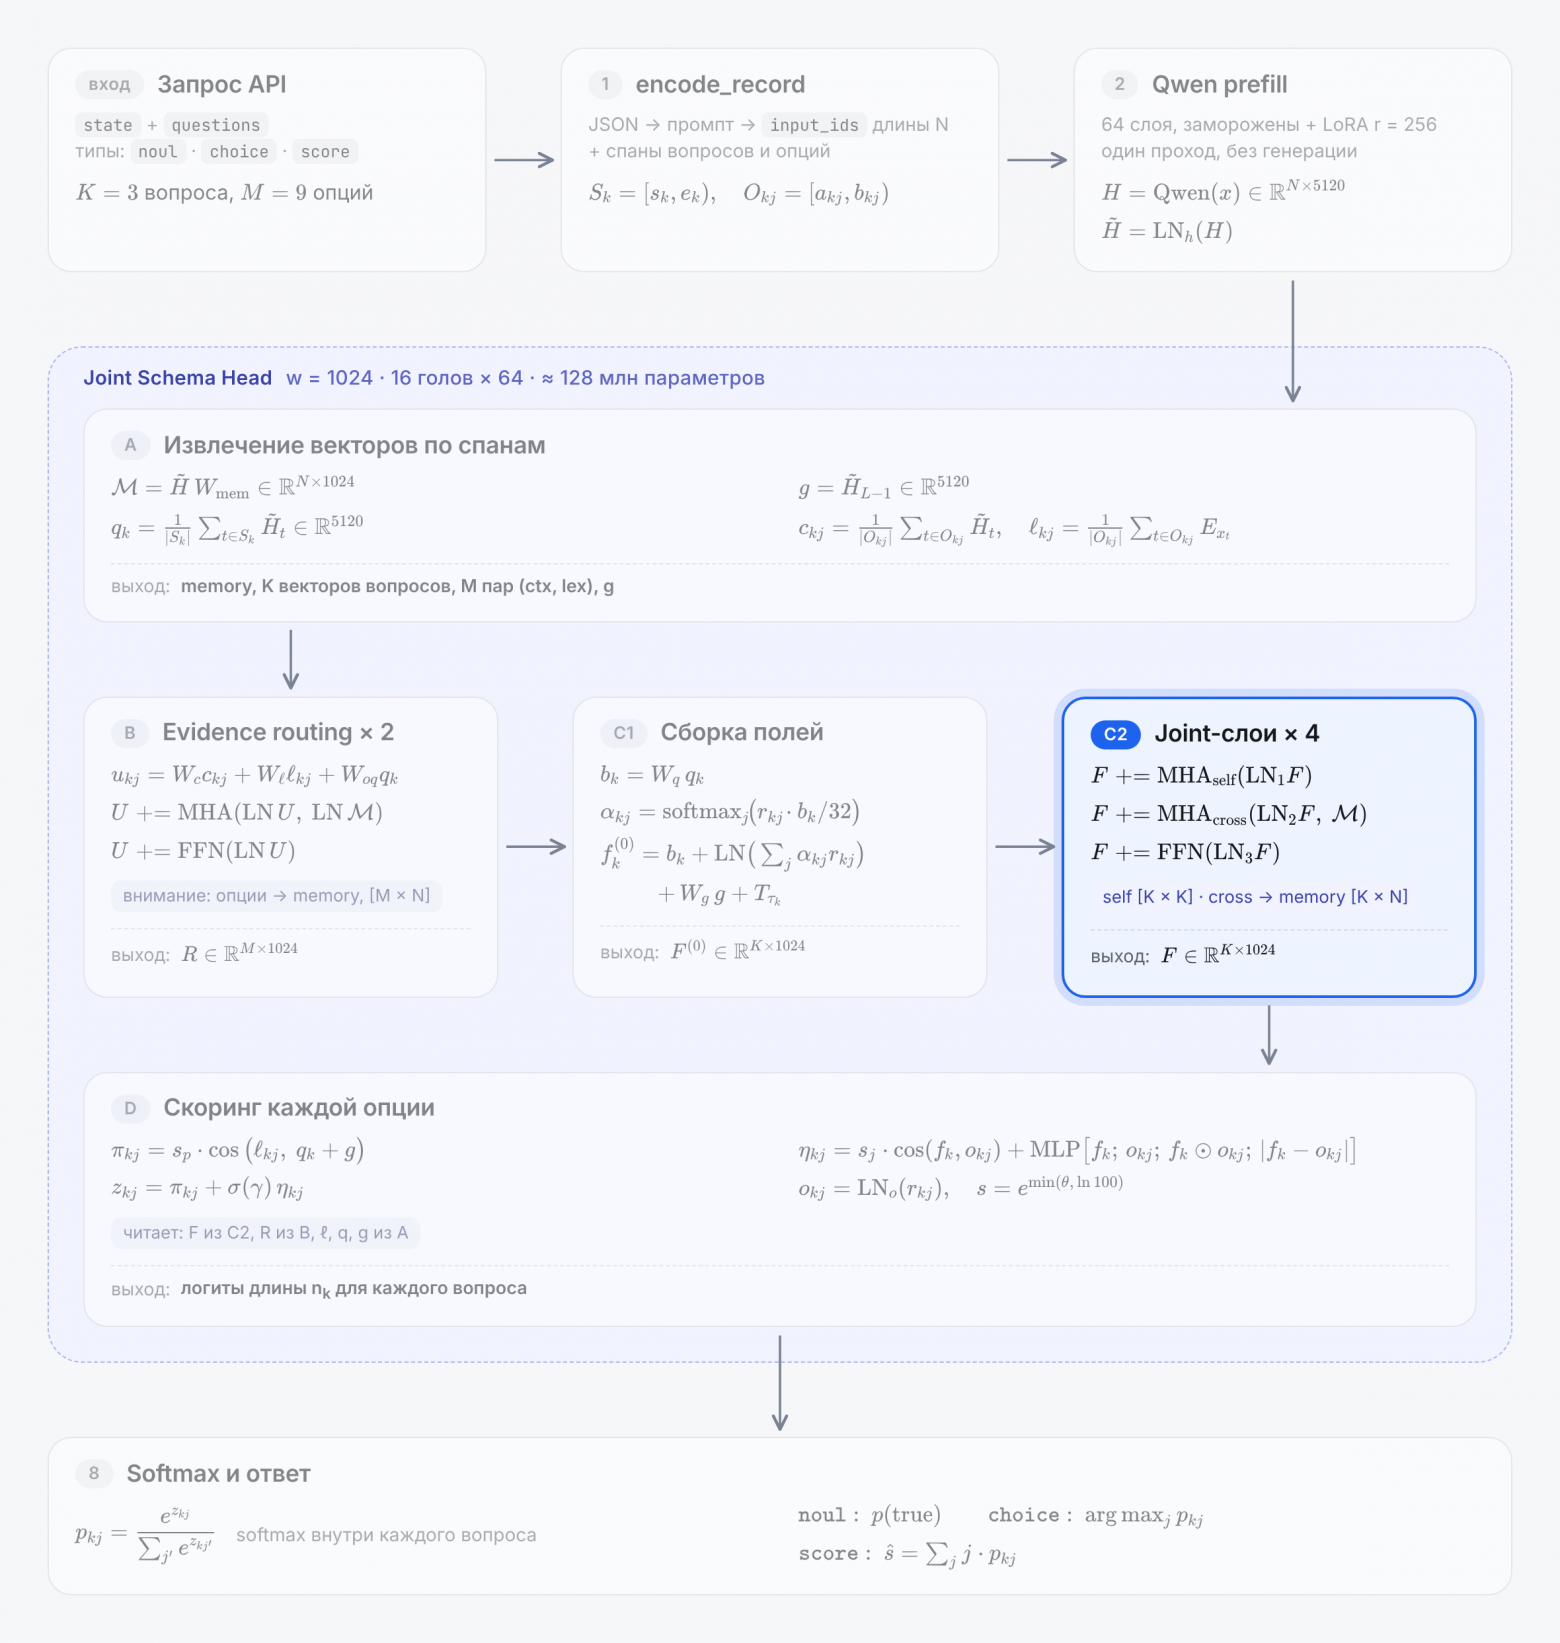
На этом этапе вопросы впервые узнают друг о друге. Поля обмениваются информацией и ещё раз сверяются с текстом.
|
Вход |
Размер |
|---|---|
|
|
|
|
|
|


Код
self.layers = torch.nn.ModuleList( [ torch.nn.TransformerDecoderLayer( d_model=width, nhead=heads, dim_feedforward=feedforward, dropout=dropout, activation="gelu", batch_first=True, norm_first=True, ) for _ in range(layers) ])self.field_norm = torch.nn.LayerNorm(width)
Вызов в forward:
fields = fields.unsqueeze(0)for layer in self.layers: fields = layer(fields, memory)fields = self.field_norm(fields[0])
TransformerDecoderLayer— базовый слой декодеров в архитектуре Transformer.
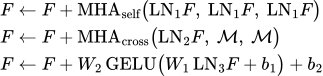
1. Self-attention: вопросы смотрят друг на друга
Запросы, ключи и значения берутся из одних и тех же полей (16 голов по 64), матрица внимания каждой головы имеет размер:
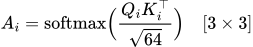
Строка — кто смотрит, столбец — на кого. Каждое поле смотрит на все три, включая себя.
2. Cross-attention: поля читают текст
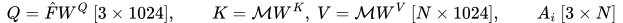
Смысл: после подблока 1 поле уже знает, что думают другие вопросы, и перечитывает текст с этим знанием. Например, поле severity, получив от urgent сигнал «срочно», может внимательнее посмотреть на «every customer».
3. FFN
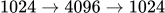 с GELU для каждого поля.
Выход этапа
 — финальные поля.
Этап D. Скоринг каждой опции
|
Вход |
Размер |
Пространство |
|---|---|---|
|
|
1024 |
голова Clef |
|
|
|
голова Clef |
|
|
|
Qwen |
|
|
5120 |
Qwen |
|
|
5120 |
Qwen |
 — финальное поле
 — вопроса

 — лексические векторы

 — вектор вопроса
 — последний токен
Код
Объявление скорера и масштабов в _init_:
self.field_norm = torch.nn.LayerNorm(width)self.option_norm = torch.nn.LayerNorm(width)self.residual_scorer = torch.nn.Sequential( torch.nn.Linear(width * 4, width), torch.nn.GELU(), torch.nn.Dropout(dropout), torch.nn.Linear(width, 1),)self.prior_logit_scale = torch.nn.Parameter(torch.zeros(()))self.joint_logit_scale = torch.nn.Parameter(torch.zeros(()))self.residual_gate = torch.nn.Parameter(torch.zeros(()))
в forward:
record_logits: list[torch.Tensor] = []for field, question, lexical, routed in zip( fields, record.questions, lexical_options, split_options,): anchor = functional.normalize( question_vectors[len(record_logits)] + global_vector, dim=-1, ) lexical_anchor = functional.normalize(lexical, dim=-1) prior_scale = self.prior_logit_scale.clamp(max=math.log(100.0)).exp() prior = prior_scale * torch.matmul(lexical_anchor, anchor) options = self.option_norm(routed) repeated_field = field.unsqueeze(0).expand_as(options) cosine = functional.cosine_similarity(repeated_field, options, dim=-1) features = torch.cat( [ repeated_field, options, repeated_field * options, torch.abs(repeated_field - options), ], dim=-1, ) residual = self.residual_scorer(features).squeeze(-1) joint_scale = self.joint_logit_scale.clamp(max=math.log(100.0)).exp() joint = joint_scale * cosine + residual record_logits.append( prior + torch.sigmoid(self.residual_gate) * joint )results.append(record_logits)return results
Логит собирается из двух независимых частей:
-
prior работает только с
 ,
 ,
 в пространстве Qwen (5120);
-
joint работает только с
 и
 в пространстве головы (1024).
Часть 1. Лексический prior
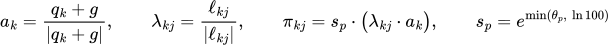
 — смысл вопроса плюс смысл всего запроса.
Лексический вектор — словарный смысл слов опции без контекста.
 — обучаемый коэффициент масштабирования
Часть 2. Совместная оценка
2a. Нормировка опций: 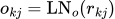
2b. Схожесть поля и опции:
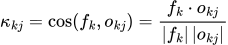
2c. MLP (residual_scorer в коде) по признакам пары. Для каждой пары собирается вектор длиной 4096:
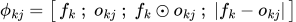
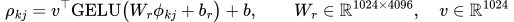
2d. Сборка joint:

Итоговый логит
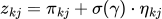
 — обучаемый вес смешивания
Выход этапа
Список тензоров:
record_logits = [ z_urgent [2], z_team [3], z_severity [4] ]
Этап 3. Softmax и ответ
Применение Softmax в рамках вопроса:
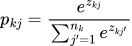
И возврат результата пользователю:
def systemone_answer(question: dict[str, Any], probabilities: dict[str, float]) -> dict[str, Any]: """Convert per-option probabilities for one question into a SystemOne answer.""" if question["type"] == "noul": return {"type": "noul", "noul": round(probabilities["true"], 4)} if question["type"] == "choice": options = [str(option) for option in question["criteria"]] choice = max(options, key=probabilities.__getitem__) return { "type": "choice", "choice": choice, "confidence": round(probabilities[choice], 4), "probabilities": {option: round(probabilities[option], 4) for option in options}, } levels = [str(index) for index in range(len(question["criteria"]))] return { "type": "score", "score": round(sum(index * probabilities[level] for index, level in enumerate(levels)), 4), "confidence": round(max(probabilities[level] for level in levels), 4), "legend": dict(zip(levels, question["criteria"])), "probabilities": {level: round(probabilities[level], 4) for level in levels}, }
Вывод
В этой статье я постарался осветить процесс работы модели принятия решений Clef. Если вы заметили неточность в излагаемом материале — буду рад услышать ваше объяснение и критику для более глубокого понимания работы!
ссылка на оригинал статьи https://habr.com/ru/articles/1095708/