У сменного персонала нет даты увольнения. Грузчик или комплектовщик, который работает самозанятым по договору оказания услуг, не пишет заявление. Он просто перестаёт брать смены, а через месяц может снова появиться в приложении, как будто никуда не пропадал. Поэтому классическая формула, по которой считают текучесть кадров организации (уволившиеся за период, делённые на среднесписочную численность), здесь не работает: в числителе нечего считать.
Зато есть журнал событий: в нашем приложении у исполнителя на каждой смене четыре кнопки: «Выехал», «На месте», «Работа выполнена», «Оплата получена», и каждое нажатие ложится строкой в таблицу. Из такого журнала текучесть можно посчитать прямо в базе, без выгрузок в Excel и без Python: нужны две оконные функции и один честно выбранный параметр. Ниже разбор по шагам, с запросами и с тем, как сильно результат зависит от этого параметра: на одних и тех же данных месячная текучесть получается и 19%, и 213%.
Запросы написаны для SQLite (нужна версия 3.25 или новее, где появились оконные функции), в конце есть заметки про PostgreSQL.
Таблица и первая ловушка
CREATE TABLE events ( worker_id INTEGER, shift_id INTEGER, shift_date TEXT, -- дата начала смены, а не дата нажатия кнопки kind TEXT -- departed / arrived / done / paid);
Про shift_date стоит договориться сразу, потому что ночная смена начинается в 20:00 и заканчивается утром, «Работа выполнена» нажимают уже на следующий день. Если брать дату из времени события, одна смена превращается в два рабочих дня, поэтому храним дату начала смены.
Дальше нужно решить, что считать выходом на работу. Нажатие «Выехал» им не является, ведь человек мог выехать и не доехать, так что выходом считаем смену, на которой есть «Работа выполнена». Заодно убираем дубли, потому что кнопку иногда нажимают дважды.
CREATE VIEW worked ASSELECT DISTINCT worker_id, shift_dateFROM eventsWHERE kind = 'done';
На тестовом журнале, о котором ниже, без этого шага получилось бы 1 492 лишние смены «выехал и пропал» и 2 249 двойных нажатий. Для «среднего числа смен на человека» это уже заметная ошибка.
Тестовые данные
Реальный журнал я показать не могу, поэтому все цифры дальше посчитаны на синтетике. Генератор раскладывает 2 000 исполнителей на три группы, которые узнает любой, кто видел базу сменных работников:
-
пробуют и пропадают: одна‑две смены, через неделю человека нет;
-
постоянные: выходят в среднем раз в три дня и держатся месяцами;
-
«когда удобно»: выходят реже и иногда пропадают на две‑шесть недель (подработка в другом месте, уехал домой, сидит с детьми), а потом возвращаются.
Именно третья группа ломает все простые метрики, и дальше будет видно, как.
import random, sqlite3from datetime import date, timedeltarandom.seed(42)D0 = date(2025, 1, 1)db = sqlite3.connect("shifts.db")db.executescript("""DROP TABLE IF EXISTS events;CREATE TABLE events ( worker_id INTEGER, shift_id INTEGER, shift_date TEXT, -- дата начала смены, а не дата нажатия кнопки kind TEXT -- departed / arrived / done / paid);""")rows, shift_id = [], 0for w in range(1, 2001): day = random.uniform(0, 330) r = random.random() if r < 0.35: stay, gap, pause = random.expovariate(1/6), 3, 0.0 elif r < 0.75: stay, gap, pause = random.expovariate(1/300), 3, 0.0 else: stay, gap, pause = random.expovariate(1/250), 6, 0.08 end = day + stay while day <= min(end, 364): shift_id += 1 d = (D0 + timedelta(days=int(day))).isoformat() rows.append((w, shift_id, d, "departed")) if random.random() < 0.97: # иногда «Выехал» и не доехал rows.append((w, shift_id, d, "arrived")) rows.append((w, shift_id, d, "done")) if random.random() < 0.05: # двойное нажатие rows.append((w, shift_id, d, "done")) rows.append((w, shift_id, d, "paid")) day += random.expovariate(1/gap) if random.random() < pause: day += random.uniform(14, 42)db.executemany("INSERT INTO events VALUES (?,?,?,?)", rows)db.commit()print(len(rows), "событий,", shift_id, "смен")
Получается 185 301 событие и 46 882 смены за 2 025 год, отчёт строим на 31 декабря. Плюс синтетики в том, что про каждого исполнителя известно, ушёл он на самом деле или просто взял паузу, и любой способ подсчёта можно сверить с правдой.
Сколько молчания считать уходом
Любой подсчёт по такому журналу упирается в правило «не выходил N дней, значит ушёл». Обычно N берут из головы (неделя, две, месяц), хотя его можно взять из данных.
Смотрим на каждое молчание: промежуток между соседними сменами одного человека плюс текущее молчание тех, кто пока не вернулся. Для каждого порога считаем, какая доля молчаний длиннее порога закончилась возвращением.
WITH w AS ( SELECT worker_id, julianday(shift_date) AS d, julianday(LEAD(shift_date) OVER ( PARTITION BY worker_id ORDER BY shift_date)) AS next_d FROM worked),silences AS ( SELECT COALESCE(next_d, julianday(:report)) - d AS len, next_d IS NOT NULL AS came_back FROM w)SELECT g.value AS threshold, COUNT(*) AS silences, ROUND(100.0 * SUM(came_back) / COUNT(*)) AS came_back_pctFROM silencesJOIN json_each('[7,14,21,30,45,60]') AS g ON silences.len > g.valueGROUP BY g.valueORDER BY g.value;
json_each здесь просто способ получить список порогов без отдельной таблицы. На дату отчёта 31 декабря запрос возвращает такую таблицу:
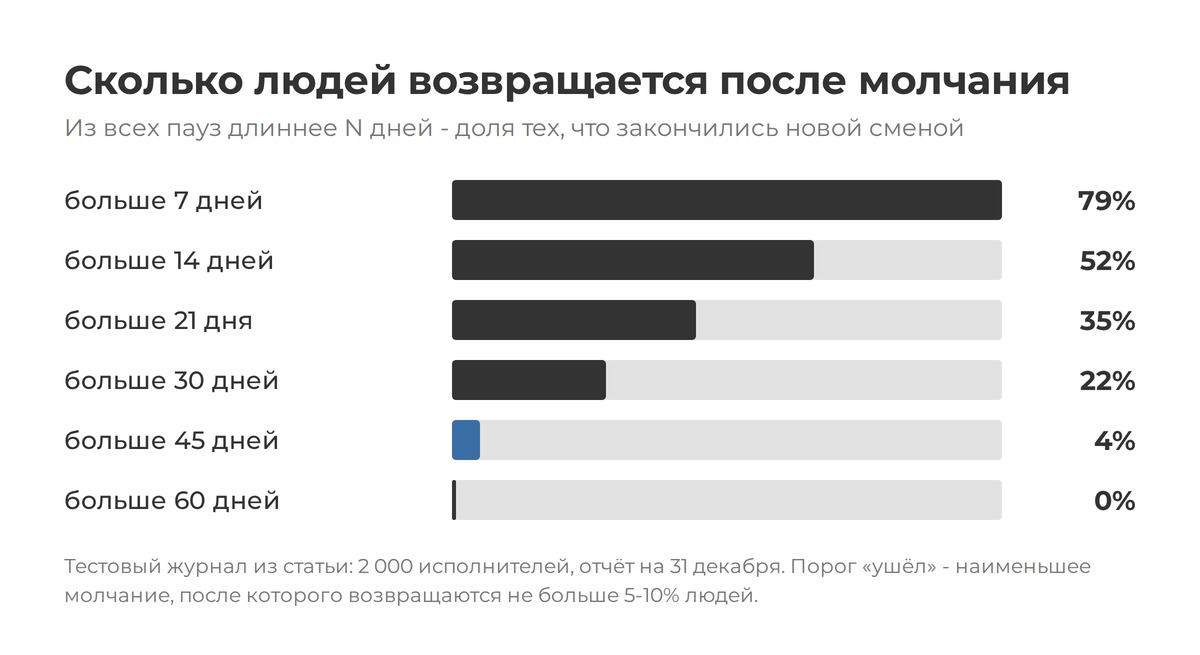
threshold silences came_back_pct7 7121 7914 2871 5221 2027 3530 1656 2245 1246 460 1123 0
Из тех, кто молчал больше недели, вернулись четверо из пяти, так что записывать недельную паузу в уходы значит ошибаться в четырёх случаях из пяти. Между 30 и 45 днями доля возвращений падает с 22% до 4%: это и есть граница, после которой человек скорее ушёл, чем отдыхает. Рабочее правило, которое я бы предложил: N равно наименьшему молчанию, после которого возвращаются не больше 5–10%. На тестовых данных это 45 дней.
Острова: периоды работы одним запросом
Теперь нужно склеить смены каждого человека в периоды работы. Это классическая задача gaps and islands: новый остров начинается там, где разрыв с предыдущей сменой больше N. Отмечаем такие места единицей и считаем накопительную сумму, которая и будет номером острова.
WITH w AS ( SELECT worker_id, shift_date, julianday(shift_date) - julianday(LAG(shift_date) OVER ( PARTITION BY worker_id ORDER BY shift_date)) AS gap FROM worked),marked AS ( SELECT *, SUM(CASE WHEN gap IS NULL OR gap > :n THEN 1 ELSE 0 END) OVER ( PARTITION BY worker_id ORDER BY shift_date) AS island FROM w)SELECT worker_id, island, MIN(shift_date) AS started, MAX(shift_date) AS last_shift, COUNT(*) AS shiftsFROM markedGROUP BY worker_id, island
Результат сохраняем в таблицу islands. Вот как выглядит один исполнитель из третьей группы при N = 7:
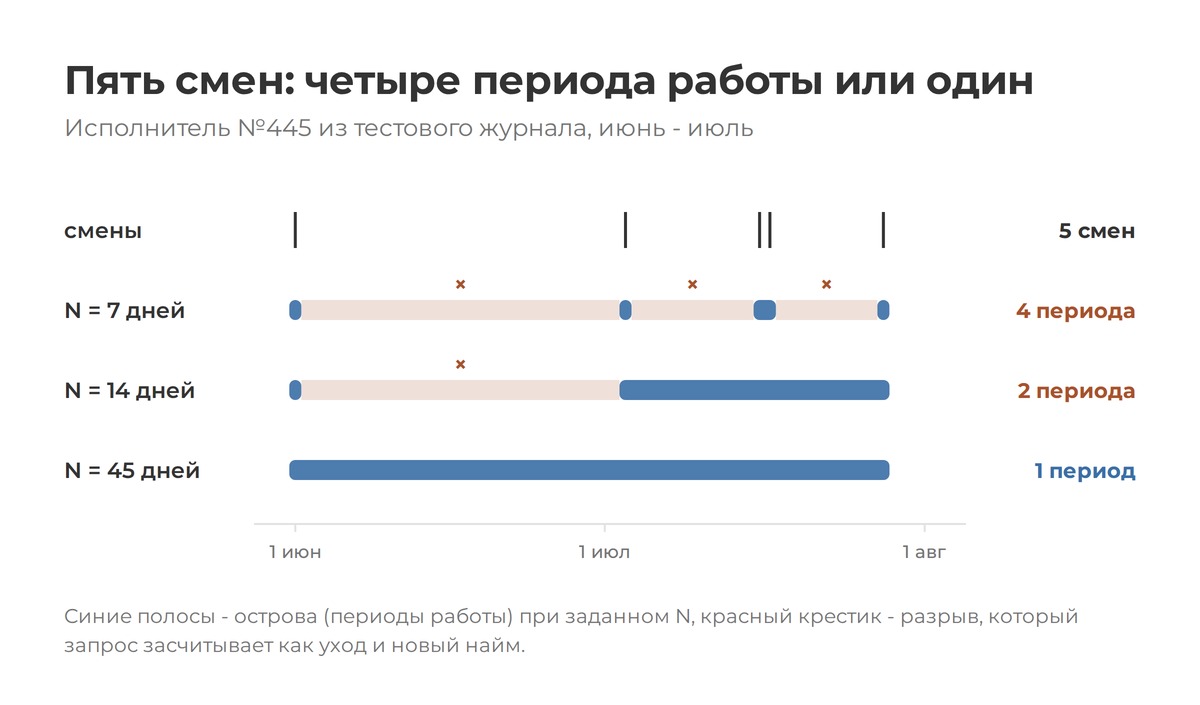
worker_id island started last_shift shifts445 1 2025-06-01 2025-06-01 1445 2 2025-07-03 2025-07-03 1445 3 2025-07-16 2025-07-17 2445 4 2025-07-28 2025-07-28 1
И он же при N = 45:
worker_id island started last_shift shifts445 1 2025-06-01 2025-07-28 5
За два месяца у него пять смен. С недельным окном это четыре найма и три увольнения, с окном в 45 дней это один человек, который работает с перерывами. Если HR‑отчёт и отчёт рекрутеров строятся на коротком окне, рекрутеры получают в зачёт трёх «нанятых», которых никто не нанимал.
Месячная текучесть и её зависимость от N
Когда острова есть, текучесть за месяц считается как в учебнике. Ушедшими за месяц считаем острова, у которых последняя смена попала в месяц. Численность берём как среднее между числом открытых островов на первое и на последнее число месяца.
SELECT SUM(last_shift BETWEEN :m_start AND :m_end) AS left_cnt, (SUM(started <= :m_start AND last_shift >= :m_start) + SUM(started <= :m_end AND last_shift >= :m_end)) / 2.0 AS avg_headcount, ROUND(100.0 * SUM(last_shift BETWEEN :m_start AND :m_end) / ((SUM(started <= :m_start AND last_shift >= :m_start) + SUM(started <= :m_end AND last_shift >= :m_end)) / 2.0)) AS churn_pctFROM islands
Считаем сентябрь при разных N. Сентябрь выбран специально: он далеко от даты отчёта, и про всех, кто перестал выходить в сентябре, к декабрю уже точно известно, вернулись они или нет.
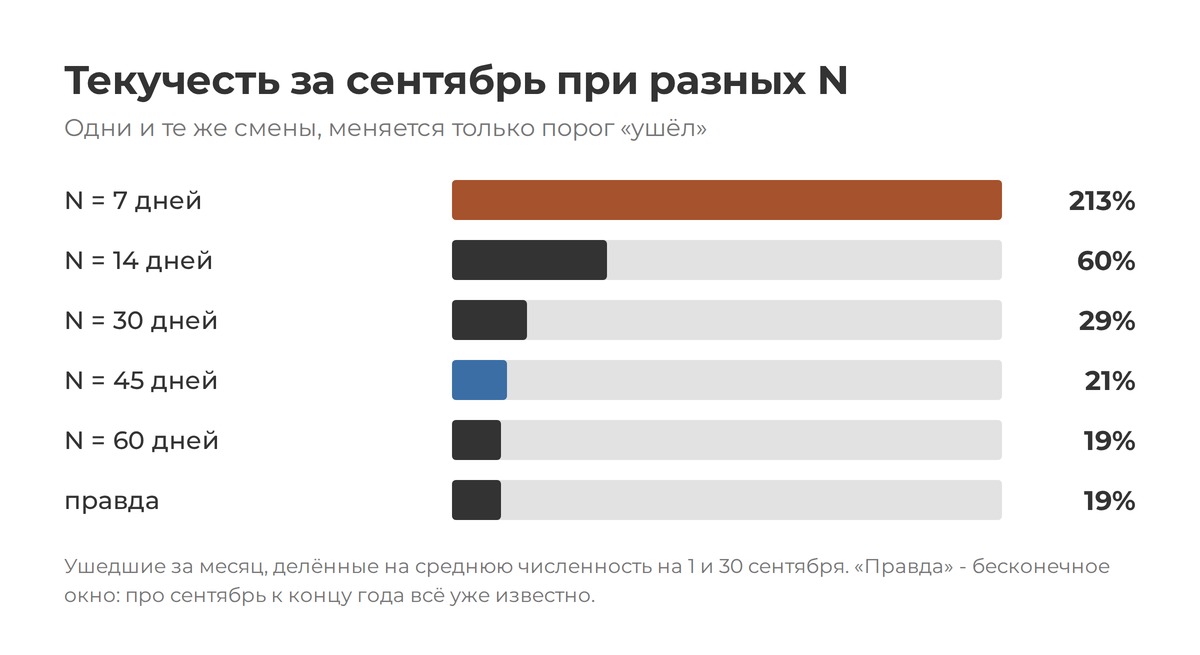
N, дней островов ушли в сентябре средняя численность текучесть7 7635 794 372.5 213%14 3486 309 518.5 60%30 2357 173 601.5 29%45 2039 135 652.0 21%60 1993 129 662.0 19%правда 1990 129 662.0 19%
Строка «правда» посчитана с бесконечным окном: каждый человек это один остров от первой до последней смены. Для прошлых месяцев так можно, потому что всё будущее уже известно.
С окном в неделю текучесть получается 213% в месяц, и по такому отчёту руководитель решит, что база выгорает и все деньги нужно тратить на снижение текучести кадров. На деле за месяц уходит около пятой части людей. Вдобавок 1 990 реальных людей превращаются в 7 635 «периодов работы», то есть в 5 645 фантомных наймов. Двухнедельное окно ошибается втрое, месячное в полтора раза, а окно 45 дней, выбранное по кривой возвращений, промахивается на два процентных пункта.
Отсюда простое правило: число в отчёте о текучести без указанного N ничего не значит. Два отчёта с разными N нельзя сравнивать между собой, даже если они построены по одной базе.
Хвост отчёта: третий статус
Почему бы тогда не взять окно побольше, раз 60 дней даёт точный ответ? Потому что за точность платим хвостом: про тех, кто последний раз выходил меньше N дней назад, мы ещё ничего не знаем, и чем длиннее окно, тем больше людей в этом состоянии и тем позже текучесть за текущий месяц становится известна.
Прятать их в «работает» или в «ушёл» нельзя, честнее завести третий статус:
SELECT status, COUNT(*) AS peopleFROM ( SELECT worker_id, CASE WHEN julianday(:report) - julianday(MAX(last_shift)) <= :usual THEN 'работает' WHEN julianday(:report) - julianday(MAX(last_shift)) <= :n THEN 'под вопросом' ELSE 'ушёл' END AS status FROM islands GROUP BY worker_id)GROUP BY status
:usual здесь означает обычную паузу между сменами (взял 14 дней, после них возвращается около половины), :n равно тем же 45 дням. На 31 декабря получается 615 работают, 178 под вопросом, 1 197 ушли. Эти 178 человек и есть список для обзвона: им ещё можно позвонить, и часть из них вернётся. Через полтора месяца они сами разойдутся по двум другим статусам, и текучесть за декабрь станет известна. До этого момента в отчёте её лучше помечать как предварительную.
Если база на PostgreSQL
Логика остаётся той же, меняется только синтаксис:
-
julianday(a) - julianday(b)превращается вa - bдля столбцов типаdate, результат сразу в днях; -
json_each('[7,14,...]')удобнее заменить наunnest(ARRAY[7,14,21,30,45,60]); -
SUM(условие)в PostgreSQL не сработает, потому что boolean не складывается, зато подойдётCOUNT(*) FILTER (WHERE условие).
На больших журналах нужен индекс по (worker_id, shift_date): оба окна партиционируются и сортируются именно так.
Чего этот подход не видит
Первое, что он не видит, это сезонность. Зимой у части людей длинные паузы считаются нормой, на складах перед праздниками и на стройке летом смен больше. Кривую возвращений стоит пересчитывать хотя бы раз в квартал и смотреть, не съезжает ли граница.
Не видна и причина ухода: человек мог уйти сам, а мог перестать получать предложения: заказчик поставил низкую оценку после смены и попросил его больше не присылать. В журнале смен это выглядит одинаково, но в первом случае речь об удержании, а во втором об отборе. Если оценки хранятся в той же базе, острова, после которых была низкая оценка, лучше считать отдельно.
Наконец, остров не видит интенсивности работы и не отличает человека, который выходит через день, и того, кто держится за базу одной сменой в месяц. Для планирования смен полезно добавить к острову частоту выходов: shifts делённое на длину острова в днях.
Если у вас похожий журнал (курьеры, такси, любая сменная подработка), интересно, на каком N у вас ломается кривая возвращений. Подозреваю, что у разных профессий граница сильно разная.
ссылка на оригинал статьи https://habr.com/ru/articles/1096506/