OpenAI опубликовала пост о том, как ее модели справляются с “малоресурсными” языками программирования – COBOL, Fortran, Visual Basic, OCaml. Компания выложила новый бенчмарк MultiLangBench и привела результаты второго, закрытого теста на перенос старого кода. Цифры впечатляют: в закрытом тесте на перенос COBOL-программ GPT-5.6 Sol справлялась с 5,4% заданий, новая GPT-6.1 Sol при тех же настройках – с 86,6%, а если дать ей подумать подольше – с 97,9%.
Еще в феврале конкурирующая Anthropic заявила, что Claude Code берет на себя самую трудоемкую часть модернизации COBOL – разбор и документирование старого кода, и компании смогут обновлять такие системы “за кварталы, а не за годы”. В тот день акции IBM, чьи мейнфреймы десятилетиями обслуживают этот код, упали на 13,2% – сильнее всего с октября 2000 года. Теперь в ту же область идет OpenAI, и уже с результатами тестов.
Почему COBOL труден для нейросетей
COBOL появился в 1959 году как язык для бизнес-расчетов и до сих пор работает в банках, страховых компаниях и госсекторе. OpenAI в своем посте ссылается на оценки IBM: на COBOL держится больше 40% систем онлайн-банкинга, 80% оплат картой в магазинах и 95% операций в банкоматах. Оценка не очень прозрачная, так что цифры лучше считать порядком величины, но масштаб понятен. Fortran в том же посте назван языком прогнозов погоды и расчетов безопасности ядерных реакторов.
Именно на таких языках нейросети исторически пишут хуже всего. Модели учатся на открытом коде и обсуждениях, а открытого кода и документации на COBOL намного меньше, чем на Python или JavaScript: большая часть банковских программ никогда не покидала стен компаний. Это и называют малоресурсностью: язык важный, но примеров для обучения мало. Независимые замеры это подтверждают. В апрельской статье о модели COBOL-Coder GPT-4o писала на COBOL компилируемый код в 41,8% случаев, а правильный с первой попытки – в 16,4%. Открытые CodeLlama, StarCoder2 и CodeGemma почти не выдавали программ, которые хотя бы компилируются, а перевод с Java на COBOL у универсальных моделей был близок к нулю.
Два теста на разные способности
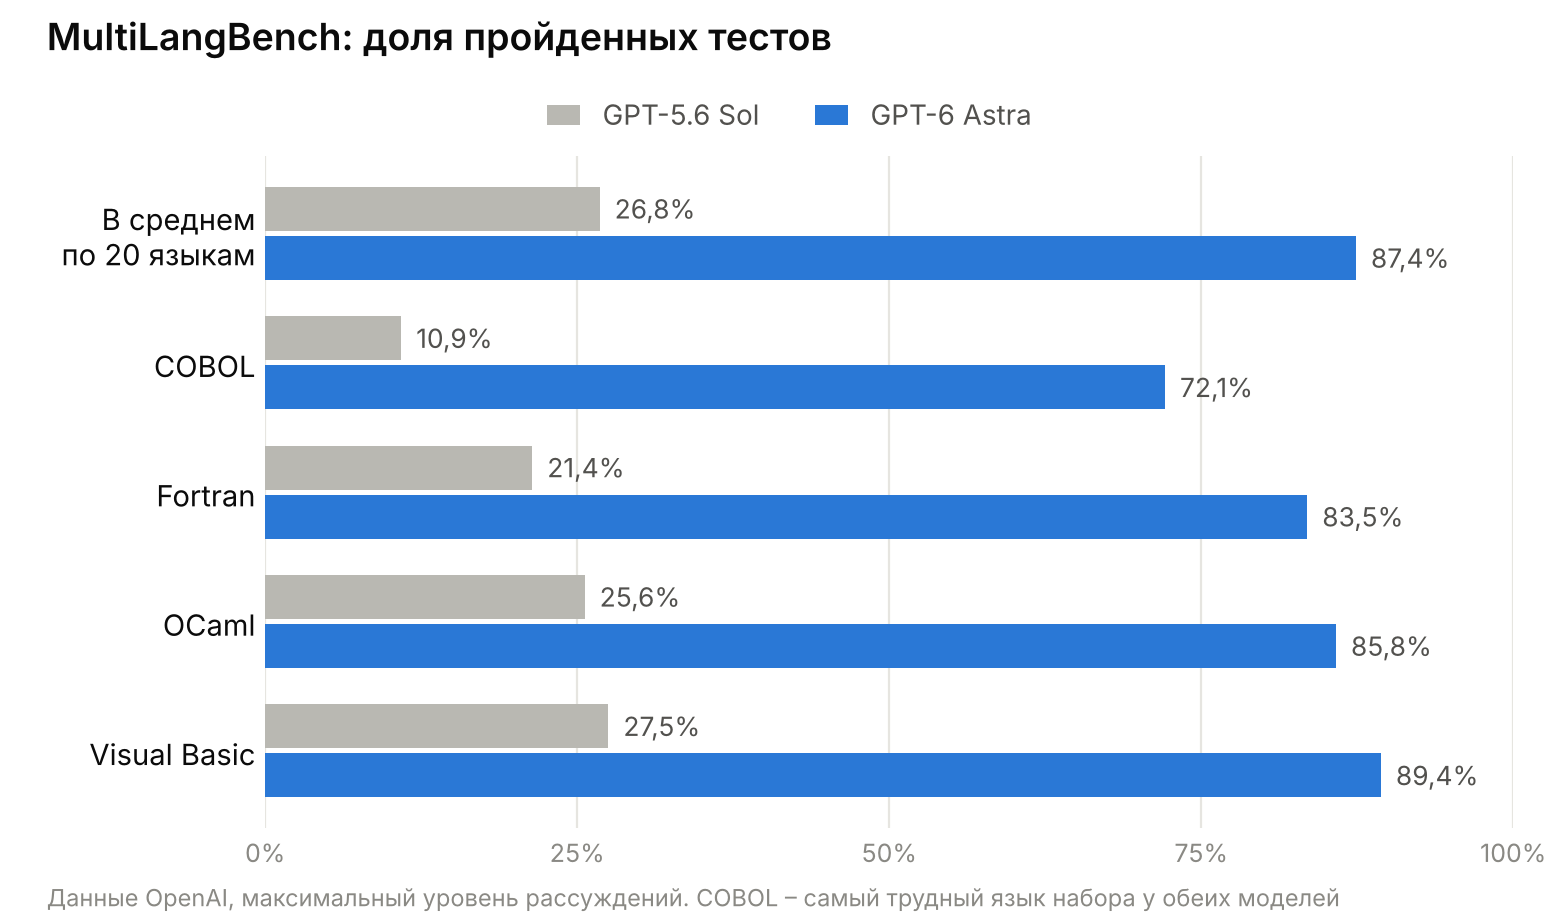
MultiLangBench проверяет модели на большой задаче, а не на олимпиадных упражнениях. Модель должна с нуля написать движок базы данных, совместимый с SQLite 3.40.1, на одном из 20 языков – от C и Python до COBOL, Fortran, Zig и даже языка математических доказательств Lean. Интернета нет, все следы SQLite из окружения удалены – у модели только документация. Готовая программа получает файл базы и SQL-запрос, а итоговое содержимое базы потом проверяют настоящей SQLite. Тесты взяты из собственного набора SQLite: из 51 тысячи OpenAI переделала 24 тысячи, а для оценки рекомендует 272. Схитрить здесь сложнее, чем в задачах с коротким ответом: без работающей программы тест не пройти.
В среднем по 20 языкам GPT-6 Astra прошла 87,4% тестов, прошлая GPT-5.6 Sol – 26,8%. На Fortran результат вырос с 21,4% до 83,5%, на OCaml – с 25,6% до 85,8%, на Visual Basic – с 27,5% до 89,4%. Больше 83% Astra набирает на 19 языках из 20. Исключение – COBOL: 72,1% против 10,9% у прошлой модели. Рывок огромный, но COBOL так и остался самым трудным языком в наборе. Дешевая GPT-6 Luna набрала в среднем 40,3% – больше GPT-5.6 Sol – при цене около $0,77 за попытку против $3,48 у GPT-5.6 Sol (это оценка OpenAI).
Второй тест ближе к тому, чем COBOL-программисты заняты в банках. Модель переносит программу с COBOL на C++, Java, Kotlin, Python или Rust так, чтобы на скрытых тестах результат побайтово совпал с оригиналом: перенос засчитывают, только если пройдены все тесты. На низком уровне рассуждений GPT-5.6 Sol справлялась в 5,4% случаев, GPT-6.1 Sol – в 86,6%, и обходится при этом на 39% дешевле. При повышенном уровне рассуждений результат 97,9% – тест почти исчерпан.
За счет чего выросли результаты, OpenAI не объясняет. В посте нет ни слова о данных, синтетических примерах или методах обучения – только общая фраза о том, что отзывы разработчиков и корпоративных клиентов помогают решать, чему учить модели и как их оценивать. Так что “что изменилось” здесь – это результаты: рецепт же остается внутри компании.
Что осталось за пределами проверки
Главная оговорка – оба теста придумала и прогнала сама OpenAI. Сравнения с Claude или Gemini нет, только со старыми моделями OpenAI. Набор для миграции COBOL закрыт: неизвестно, сколько в нем программ, какого они размера и откуда взяты, так что 97,9% пока нельзя ни проверить, ни повторить. MultiLangBench выложен на GitHub под лицензией Apache 2.0, и это плюс, но независимых прогонов я пока не нашел.
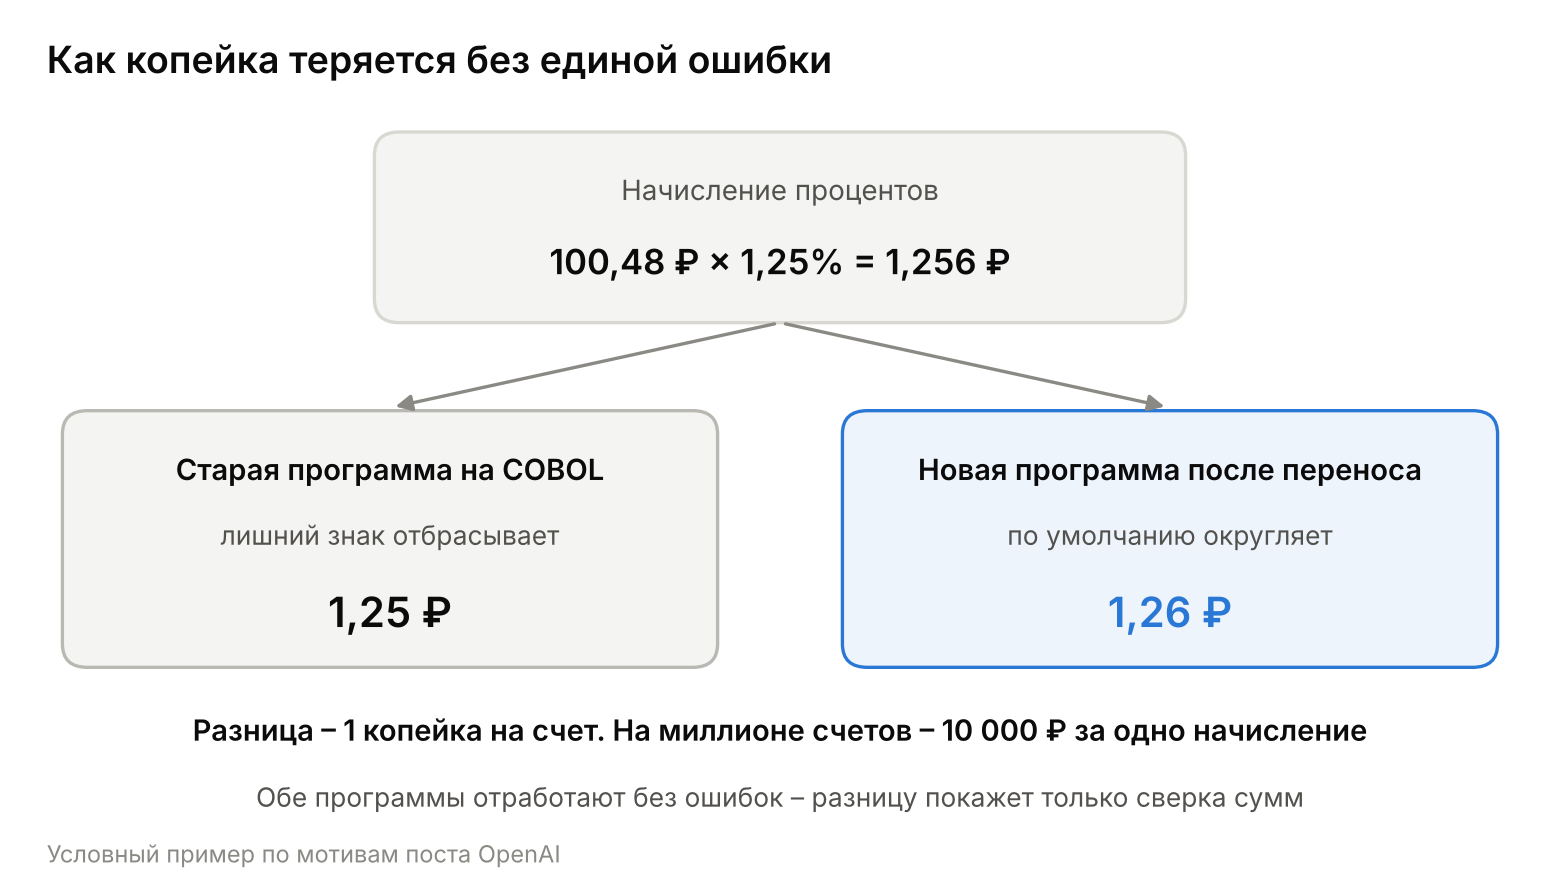
OpenAI отдельно предупреждает о рисках настоящей миграции. Пример из поста: арифметика с фиксированной точкой в COBOL по умолчанию отбрасывает лишние знаки после запятой, если программист явно не попросил округлить. Перенесенная программа, которая округляет автоматически, отработает без единой ошибки – и начислит другие суммы. Поэтому перед запуском в работу миграцию должны проверять эксперты: на бизнес-правилах и зависимостях конкретной системы. А полный цикл – разобраться в чужом репозитории, спланировать изменения, собрать, протестировать и отладить – компания называет целью, а не достигнутым результатом.
Почему перенос целой системы – отдельная задача, показывает августовский препринт SWE Refactor Bench. В нем тестировали модели прошлого поколения (лучший результат у Claude Opus 5), и агенты переносили целые репозитории: и из 520 попыток удачными оказались 28, то есть 5,4%. На переписывании кода с одного языка на другой средний балл и вовсе 5,6 из 100. Это не оценка GPT-6.1, а пример того, насколько сложнее сама задача. Совпадение с цифрой старой модели OpenAI случайное, тесты устроены по-разному, но вывод общий: переписать программу и перенести систему – разные задачи. Узкое место в модернизации COBOL смещается. Писать код на старых языках модели заметно научились, а доказать, что новая система считает деньги так же, как старая, пока предстоит в первую очередь людям – об этом предупреждает и сама OpenAI.
P.S. Поддержать меня можно подпиской на канал “сбежавшая нейросеть”, где я рассказываю про ИИ с творческой стороны.
ссылка на оригинал статьи https://habr.com/ru/articles/1096978/