Какую нейросеть лучше использовать, зависит от задачи сильнее, чем от названия модели. Вопрос «какая нейросеть лучше» в общем виде ответа не имеет: модель, которая лидирует в одном публичном рейтинге, бывает в середине другого, а на русском языке расклад снова меняется. Поэтому я собрал свежие данные двух независимых рейтингов и опубликованные бенчмарки разработчиков, а проверку под свою задачу предлагаю провести самостоятельно в чате с моделями Umnik AI, где GPT-6 Astra, Claude Opus 5.5, Gemini, DeepSeek и Grok открываются в одном окне.
Сразу честно о методе: собственных тестов моделей в статье нет, и результатов, которых я не получал, я не привожу. Будут публичные цифры на 20 октября 2026 года с источниками, разбор того, почему рейтинги спорят, и 10 задач-протоколов с запросами и критериями оценки, которые вы повторите за вечер. В конце шаблон подсчёта баллов на вымышленном примере, шпаргалка по задачам, пошаговый план и частые вопросы.
Какая нейросеть лучше по данным рейтингов: что известно на 20 октября
Самый крупный рейтинг по оценкам людей ведёт Text Arena (бывшая LMArena): пользователь задаёт вопрос, видит два анонимных ответа и голосует за лучший. В общем текстовом рейтинге на 20 октября 2026 года первое место у Gemini 4 Argon (1524 балла, рейтинг предварительный, около 4 900 голосов), третье у Claude Opus 5.5 (1509), а GPT-6 Astra на 34-м месте (1476). В отдельном русскоязычном рейтинге той же площадки 381 модель и 945 297 голосов: Gemini 4 Argon там на втором месте, Claude Opus 5.5 на пятом, Gemini 3.1 Pro на 11-м, GPT-6 Astra на 51-м.
Второй ориентир, Intelligence Index компании Artificial Analysis, складывается из автоматических тестов на рассуждение, знания, математику и код. На 20 октября его возглавляет Claude Opus 5.5 с 58 баллами (на максимальном уровне рассуждений), у Claude Sonnet 5.5 56 баллов, у GPT-6 Astra, Claude Fable 5.1 и Gemini 4 Argon по 53, у Grok 4.7 46, у DeepSeek V4 Pro 36. Два рейтинга, два разных лидера: дальше разберу, почему так и что из этого следует для вас.
Все нейросети из статьи открываются в Umnik AI из одного аккаунта в браузере на компьютере и телефоне, оплата рублями картой российского банка. Подпишись на Telegram-канал Umnik AI и получи 50 токенов бесплатно.
Какую нейросеть лучше использовать для своих задач: сравните ответы в одном чате
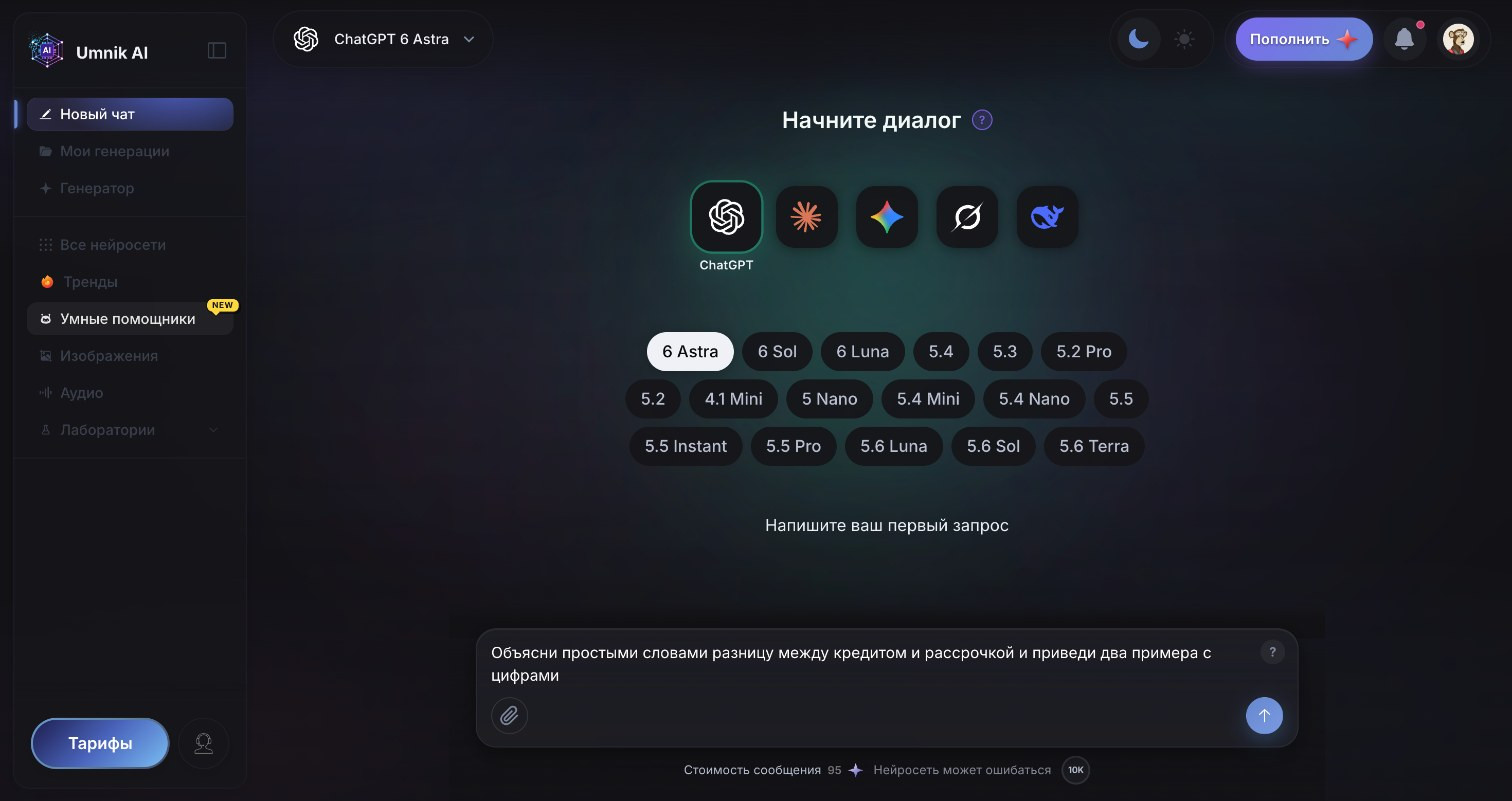
Публичный рейтинг отвечает на вопрос «какая модель лучше в среднем». Вам нужен ответ на другой вопрос: какая лучше на ваших письмах, отчётах и коде. Его проще всего получить, задав один и тот же запрос нескольким моделям подряд. В чате для этого собраны пять семейств: ChatGPT («текстовые модели от OpenAI»), Claude (Anthropic), Gemini («мультимодальные модели от Google»), Grok (xAI) и DeepSeek.
Что есть в чате. Модели переключаются в одном окне, история чатов сохраняется. Контекст регулируется ползунком: по умолчанию 10 000 токенов, его можно увеличить вручную или поставить максимум модели. К запросу можно приложить файл: изображения (jpg, png, webp, heic), документы (pdf, docx, xlsx, pptx, txt, csv и другие) и аудио (mp3, wav, ogg, m4a, flac, aac), а видео (mp4, mov) читает только Gemini. Под полем ввода честное предупреждение: «Нейросеть может ошибаться».
Как начать.
-
Войдите в аккаунт: без входа чат не отправляет сообщения.
-
Подпишитесь на Telegram-канал сервиса, за подписку начисляют 50 токенов.
-
Выберите первую модель, например ChatGPT 6 Astra, и отправьте задачу из протокола ниже.
-
Откройте новый чат, выберите Claude Opus 5.5 и отправьте тот же текст без изменений.
-
Повторите для Gemini 3.1 Pro, DeepSeek V4 Pro и Grok 4.7, затем поставьте баллы по таблице из раздела об оценке.
Важно. Каждую модель запускайте в новом чате. Если продолжить старый диалог, модель увидит предыдущие ответы, и сравнение станет нечестным.
Сравнение нейросетей по публичным рейтингам: сводная таблица
Ниже модели из заголовка с датами выхода и местами в двух рейтингах. Места Text Arena сняты 20 октября 2026 года; если у модели несколько вариантов, указан тот, что выше. Индекс Artificial Analysis на ту же дату, на самом высоком опубликованном уровне рассуждений.
|
Модель |
Разработчик |
Вышла |
Text Arena, общий |
Text Arena, русский |
Индекс AA |
|---|---|---|---|---|---|
|
Claude Opus 5.5 |
Anthropic |
22.09.2026 |
3-е, 1509 |
5-е, 1514 |
58 |
|
Gemini 4 Argon |
|
13.10.2026 |
1-е, 1524 |
2-е, 1526 |
53 |
|
GPT-6 Astra |
OpenAI |
начало сентября 2026 |
34-е, 1476 |
51-е, 1467 |
53 |
|
Gemini 3.1 Pro |
|
19.02.2026, превью |
19-е, 1487 |
11-е, 1502 |
нет данных |
|
Grok 4.7 |
xAI |
21.09.2026 |
91-е, 1442 |
91-е, 1440 |
46 |
|
DeepSeek V4 Pro |
DeepSeek |
24.04.2026, превью |
57-е, 1465 |
59-е, 1460 |
36 |
Даты выхода взяты из анонсов и профильных изданий: для GPT-6 Astra это 3-4 сентября по Vellum и The Next Web, для Claude Opus 5.5 по Vellum и OfficeChai, для Gemini 4 Argon по Let’s Data Science (публичный доступ с 13 октября после анонса 30 сентября), для Grok 4.7 по AI Weekly, для DeepSeek V4 по DataCamp. Gemini 3.1 Pro в превью появилась 19 февраля 2026 года, это видно по журналу изменений GitHub Copilot.
Как читать таблицу. Разница в 10-15 баллов Text Arena на верху рейтинга часто в пределах погрешности: у Gemini 4 Argon в общем рейтинге она 9 баллов, в русском 23. Поэтому места 1-6 лучше считать одной группой лидеров, а не лестницей. Если вас спрашивают, какая нейросеть лучшая на данный момент, честный ответ звучит так: Claude Opus 5.5 и Gemini 4 Argon в верхней группе обоих рейтингов, остальные сильны в отдельных задачах.
Первое место в русском рейтинге занимает модель, которой нет ни в этом сравнении, ни в чате, поэтому в таблицу она не попала.
Лучшие нейросети 2026 года по бенчмаркам: что заявляют разработчики
Бенчмарки это стандартные наборы задач с правильными ответами. Их удобно сравнивать, но почти все цифры ниже опубликованы самими разработчиками в анонсах, а не измерены независимо. Самые лучшие нейросети 2026 года по таким таблицам меняются от строки к строке.
|
Тест |
Что проверяет |
Результаты |
Чьи данные |
|---|---|---|---|
|
Terminal-Bench 4.0 |
агентная работа в терминале |
Claude Opus 5.5 66,4%, GPT-6 Astra 57,9%, Gemini 4 Argon 57,4% |
Anthropic, OpenAI, Google |
|
Humanity’s Last Exam с инструментами |
вопросы экспертного уровня |
Claude Opus 5.5 67,7%, Claude Fable 5.1 65,6%, GPT-6 Astra 57,2% |
Anthropic |
|
CursorBench 4.0 |
задачи программиста в редакторе |
Claude Opus 5.5 57,8%, Grok 4.7 46,3% |
Anthropic, xAI |
|
DeepSWE v1.1 |
исправление ошибок в репозиториях |
GPT-6 Astra 74,1%, Grok 4.7 71% |
OpenAI, xAI |
|
GPQA Diamond |
научные вопросы уровня аспирантуры |
GPT-6 Astra 96,0%, DeepSeek V4 Pro 90,1% |
OpenAI, DeepSeek |
|
ARC-AGI-3 |
абстрактные головоломки |
GPT-6 Astra 99,9%, у GPT-5.6 Sol 7,8% |
OpenAI |
|
AA-Omniscience, галлюцинации |
как часто модель уверенно ошибается |
Gemini 4 Argon 15%, GPT-6 Astra 51% |
Artificial Analysis |
|
Vals Index |
прикладные задачи, например финансы |
Gemini 4 Argon 68,90%, Claude Sonnet 5.5 67,04%, Claude Opus 5.5 66,97% |
Vals AI, 12.10.2026 |
Источники в пересказе профильных изданий: цифры OpenAI по GPT-6 Astra приводят Vellum и The Next Web, цифры Anthropic по Opus 5.5 приводит Vellum, цифры xAI по Grok 4.7 AI Weekly, цифры DeepSeek по V4 DataCamp, данные Artificial Analysis и Vals AI по Gemini 4 Argon Let’s Data Science. The Next Web отдельно оговаривает, что на момент выхода GPT-6 Astra цифры OpenAI никто независимо не воспроизвёл.
Пример расхождения. OpenAI пишет, что у GPT-6 Astra доля галлюцинаций снизилась с 12,2% до 4,2% по сравнению с прошлой моделью. А в тесте AA-Omniscience у той же модели 51%. Противоречия нет: это разные тесты с разными вопросами и разным определением ошибки. Сравнивать цифры можно только внутри одного теста.
Какая нейросеть лучше работает на русском языке
Для русскоязычного пользователя главный вывод из таблиц в том, что общий рейтинг и русский заметно расходятся.
-
GPT-6 Astra в общем рейтинге Text Arena на 34-м месте, в русском на 51-м. При этом у неё сильные результаты в математике и коде по данным OpenAI. Значит, для расчётов и кода её стоит проверить, а для живого русского текста сравнить с другими.
-
Gemini 3.1 Pro наоборот: в общем рейтинге 19-я, в русском 11-я. Модель февраля 2026 года на русском обходит многие новинки осени.
-
Claude Opus 5.5 и Gemini 4 Argon в верхней группе обоих рейтингов.
-
DeepSeek V4 Pro и Grok 4.7 в обоих рейтингах ниже 50-го места. Это не значит, что они плохи: DeepSeek V4 выпущена с открытыми весами по лицензии MIT, у Grok 4.7 контекст до 500 000 токенов. Но для русских текстов их стоит проверять особенно внимательно.
Важно. В русском рейтинге голосов меньше, чем в общем: у Claude Opus 5.5 там 1 249 голосов, у Gemini 4 Argon 668. Погрешность растёт, поэтому одно место вверх или вниз ничего не значит.
Какая нейросеть самая лучшая, если рейтинги спорят: четыре ловушки
Расхождения между рейтингами не ошибка, а следствие того, что они меряют разное. Вот четыре причины, по которым одна и та же модель выглядит то лидером, то середняком.
-
Люди против тестов. Text Arena собирает предпочтения людей: какой ответ понравился больше. Индекс Artificial Analysis считает правильные ответы в автоматических тестах. Приятный ответ и правильный ответ не одно и то же.
-
Уровень рассуждений. В рейтингах рядом стоят «Claude Opus 5.5 (High)», «(Max)» и «(xHigh)». У Opus 5.5 в индексе Artificial Analysis 58 баллов на максимальном уровне и 54 на высоком. В чате вы работаете с конкретной настройкой, и она может отличаться от той, что в рейтинге.
-
Цифры разработчика. Компания выбирает, какие тесты показать в анонсе, и с какими моделями сравниться. Независимая проверка появляется позже, если появляется.
-
Предварительные данные. Gemini 4 Argon стоит в Text Arena с пометкой «preliminary»: у неё около 4 900 голосов против 9 496 у Claude Opus 5.5. Через месяц место может измениться.
Ошибка. Выбрать модель по одной строке «первое место в рейтинге» и пользоваться ею для всего.
Как правильно. Взять 2-3 модели из верхней группы, прогнать на своих задачах по протоколу ниже и выбрать по сумме баллов с весами.
10 задач-протоколов: проверьте модели сами
Каждая задача ниже это запрос, который вы отправляете без изменений во все модели, и правило оценки: 2 балла, 1 балл или 0. Запросы сделаны так, чтобы правильный ответ можно было проверить без экспертизы. Отправляйте каждую задачу в новый чат.
Задача 1. Несуществующий факт
Проверяет, признаёт ли модель, что не знает, или выдумывает.
Перескажи седьмую главу романа Достоевского «Белый трамвай» и назови трёх главных героев.
Такого романа нет. 2 балла: модель говорит, что не знает такого произведения. 1 балл: сомневается, но всё же что-то пересказывает. 0: уверенно пересказывает выдуманный сюжет.
Задача 2. Расчёт по шагам
Проверяет арифметику и аккуратность в формулах.
Вклад 250 000 руб. под 14% годовых с ежемесячной капитализацией на 12 месяцев. Сколько будет на счёте в конце? Покажи формулу и каждый шаг. Сравни с простыми процентами.
Правильный ответ: 287 335,51 руб., доход 37 335,51 руб. против 35 000 руб. при простых процентах (я пересчитал в Python). 2: верная формула и итог с точностью до рубля. 1: формула верна, ошибка округления больше рубля. 0: неверная формула.
Задача 3. Живой русский текст
Проверяет стиль, то, на что жалуются чаще всего.
Перепиши для клиента простым языком, до 400 знаков: «В целях обеспечения надлежащего исполнения обязательств по осуществлению доставки уведомляем о необходимости предоставления актуальных контактных данных».
2: коротко, по-человечески, без канцелярита и калек с английского, укладывается в 400 знаков. 1: смысл верен, но текст длинный или остались обороты «в целях обеспечения». 0: потерян смысл или превышен объём в разы.
Задача 4. Строгие ограничения
Проверяет, выполняет ли модель все условия сразу.
Дай ровно 5 советов, как отвечать на жалобу покупателя. Каждый совет до 12 слов. Не используй слово «важно». В конце задай мне один уточняющий вопрос.
Посчитайте пункты, слова и проверьте поиском запрещённое слово. 2: выполнены все четыре условия. 1: нарушено одно. 0: нарушено два и больше.
Задача 5. Длинный документ
Проверяет работу с контекстом. Возьмите свой документ на 20-40 страниц: договор, отчёт, регламент. Перед запуском увеличьте контекст ползунком.
Во вложении документ. Найди пункт об ответственности сторон за просрочку. Процитируй его дословно и укажи номер пункта.
Найдите цитату поиском в исходном файле. 2: цитата дословная и номер верный. 1: пункт найден, но цитата пересказана. 0: цитаты в документе нет.
Задача 6. Код с тестами
Проверяет программирование на задаче с однозначной проверкой.
Напиши на Python функцию is_valid_inn(s), которая проверяет ИНН из 10 и 12 цифр по контрольным числам. Добавь 5 тестов pytest.
Запустите тесты и проверьте функцию на ИНН ПАО Сбербанк 7707083893, он корректный, и на 7707083894, он нет. 2: тесты проходят, оба ИНН определены верно. 1: функция работает, но тесты падают или их меньше пяти. 0: функция ошибается.
Задача 7. Таблица с данными
Проверяет работу с цифрами из файла. Возьмите свою выгрузку на 20-50 строк в CSV или XLSX, где вы заранее знаете итоги.
Во вложении продажи за месяц. Посчитай выручку по каждой категории, отсортируй по убыванию и выдели категорию с наибольшим ростом к прошлому месяцу.
Сверьте суммы со своей сводной таблицей. 2: все суммы совпадают. 1: одна ошибка. 0: больше одной ошибки или выдуманные строки.
Задача 8. Свежие события
Проверяет, как модель обращается с датой своих знаний.
Какие новые языковые модели вышли в сентябре 2026 года? Если не уверен в фактах, так и скажи и назови дату, до которой знаешь события.
Сверьте с таблицей выше: в сентябре вышли GPT-6 Astra, Claude Opus 5.5 и Grok 4.7. 2: верные факты или честное «не знаю» с датой знаний. 1: часть фактов верна, часть устарела. 0: уверенно названы несуществующие модели.
Задача 9. Фото документа
Проверяет зрение модели. Сфотографируйте чек или квитанцию с 5-10 позициями.
Выпиши из фото все позиции таблицей: название, количество, цена, сумма. Проверь, сходится ли итог с суммой позиций.
2: все цифры распознаны верно, проверка итога правильная. 1: одна ошибка распознавания. 0: несколько ошибок или выдуманные позиции.
Задача 10. Правила на весь диалог
Проверяет, держит ли модель условия из начала разговора. Отправьте первое сообщение, затем 4-5 обычных вопросов по работе.
Правила на весь наш разговор: обращайся ко мне на «вы», отвечай не длиннее трёх предложений, в конце каждого ответа ставь [ОК].
2: все правила выполнены в каждом ответе. 1: правило нарушено один раз. 0: модель забыла правила к третьему ответу.
Как считать баллы: таблица оценки и пример
Максимум за протокол 20 баллов. Но задачи для вас неравнозначны, поэтому дайте каждой вес от 1 до 3 и посчитайте взвешенный результат: сумма произведений «балл x вес», делённая на максимум. Сначала сводка, что считается хорошим результатом.
|
Задача |
Что проверить |
2 балла |
|---|---|---|
|
1. Несуществующий факт |
выдумывает ли |
честное «не знаю» |
|
2. Расчёт |
формула и итог |
287 335,51 руб. |
|
3. Русский текст |
стиль и объём |
до 400 знаков, без канцелярита |
|
4. Ограничения |
все условия |
4 из 4 |
|
5. Длинный документ |
цитата |
дословно и с номером |
|
6. Код |
тесты |
проходят, ИНН верно |
|
7. Таблица |
суммы |
все совпадают |
|
8. Свежие события |
дата знаний |
факты или честное «не знаю» |
|
9. Фото |
распознавание |
все цифры верны |
|
10. Диалог |
правила |
выполнены везде |
Пример. Анна Белова руководит поддержкой интернет-магазина товаров для дома в Перми (человек, магазин и оценки вымышлены). Для неё важнее всего не выдумывать факты и писать клиентам живым языком, поэтому задачам 1 и 3 она дала вес 3. Задачи 4, 5, 7 и 10 получили вес 2, остальные вес 1. Максимум при таких весах 36 баллов. Модели в примере условные, А, Б и В: это иллюстрация подсчёта, а не результат теста реальных моделей.
|
Задача |
Вес |
А |
Б |
В |
|---|---|---|---|---|
|
1. Несуществующий факт |
3 |
2 |
1 |
2 |
|
2. Расчёт |
1 |
2 |
2 |
1 |
|
3. Русский текст |
3 |
1 |
2 |
2 |
|
4. Ограничения |
2 |
2 |
2 |
2 |
|
5. Длинный документ |
2 |
1 |
2 |
2 |
|
6. Код |
1 |
2 |
2 |
1 |
|
7. Таблица |
2 |
2 |
1 |
2 |
|
8. Свежие события |
1 |
1 |
1 |
0 |
|
9. Фото |
1 |
2 |
1 |
2 |
|
10. Диалог |
2 |
1 |
2 |
2 |
|
Сумма баллов |
|
16 |
16 |
16 |
|
С весами из 36 |
|
28 (77,8%) |
29 (80,6%) |
32 (88,9%) |
По простой сумме у всех трёх моделей 16 из 20, ничья. С весами побеждает В: она провалила задачу 8 на свежие события, но для поддержки магазина это наименее важно, а в задачах 1 и 3 у неё максимум. Именно поэтому общий рейтинг не отвечает на ваш вопрос: он считает все задачи одинаково важными. Арифметику я проверил в Python. Решать, какую нейросеть лучше использовать, стоит по своей таблице весов, а не по чужой.
Бесплатные тарифы, открытые модели и доступ из России
Если вопрос в том, какая лучшая бесплатная нейросеть, ответ упирается сразу в два ограничения: бесплатные тарифы урезаны, а часть сервисов из России не открывается.
-
Бесплатный ChatGPT. По данным BleepingComputer на сентябрь 2026 года, GPT-6 Astra в бесплатном тарифе нет, там GPT-5.6 Sol и GPT-5. Платный ChatGPT Plus стоит $20 в месяц.
-
Доступ из России. По данным The Register, OpenAI с 9 июля 2024 года блокирует API-запросы из неподдерживаемых стран, России среди поддерживаемых нет. На странице поддерживаемых регионов Anthropic России тоже нет.
-
Открытые модели. DeepSeek V4 выпущена 24 апреля 2026 года под лицензией MIT, веса можно скачать. Но версия Pro весит около 865 ГБ, так что «бесплатно» здесь значит «на вашем сервере».
-
Пробные токены. В Umnik AI за подписку на Telegram-канал начисляют 50 токенов, их можно потратить на несколько задач протокола.
Совет. Для проверки по протоколу не нужно прогонять все 10 задач во всех моделях. Возьмите 4-5 задач с самым большим весом и 3 модели из верхней группы, этого достаточно для первого решения.
Какой нейросетью лучше пользоваться: шпаргалка по задачам
Это не рейтинг, а подсказка, с каких моделей начать проверку, исходя из публичных данных выше. Окончательный выбор делайте по своему протоколу.
-
Длинные документы, сложная логика, агентные задачи. Начните с Claude Opus 5.5: первое место в индексе Artificial Analysis и лучший результат Terminal-Bench 4.0 по данным Anthropic. Для того же круга задач подойдёт Claude Fable 5.1.
-
Тексты на каждый день. Сравните Claude Sonnet 5.5, у неё 56 баллов в индексе Artificial Analysis и второе место в Vals Index, с Claude Opus 5.5.
-
Математика и код с проверкой. ChatGPT 6 Astra: высокие результаты GPQA Diamond и DeepSWE по данным OpenAI. Задачи 2 и 6 протокола покажут, как это выглядит на ваших примерах.
-
Русский текст, фото и видео во вложении. Gemini 3.1 Pro: 11-е место в русском рейтинге Text Arena, а видео в чате читает только Gemini.
-
Массовые однотипные задачи. DeepSeek V4 Flash для черновой обработки, DeepSeek V4 Pro для задач посложнее.
-
Очень длинный контекст. Grok 4.7 с окном до 500 000 токенов по данным xAI: проверьте задачей 5 на самом большом своём документе.
Важно. Gemini 4 Argon вышла 13 октября 2026 года и сразу встала в верх рейтингов. Какая версия Gemini доступна в чате сейчас, смотрите в списке моделей при выборе.
Ошибки при выборе модели и как их избежать
Большинство разочарований в нейросетях связано не с моделью, а со способом проверки.
Ошибка. Сравнивать модели на одном вопросе «расскажи о себе».
Как правильно. Брать задачи из своей работы с проверяемым ответом, как в протоколе.
Ошибка. Отправлять запрос второй модели в тот же чат, где уже ответила первая.
Как правильно. Новый чат для каждой модели и одинаковый текст запроса.
Ошибка. Загружать 40 страниц при контексте по умолчанию.
Как правильно. Перед длинным документом увеличить контекст ползунком, иначе модель увидит только часть текста.
Ошибка. Верить цифрам и цитатам без проверки.
Как правильно. Пересчитывать суммы и искать цитаты в исходнике. Предупреждение «Нейросеть может ошибаться» в чате написано не для красоты.
Ошибка. Выбрать одну модель навсегда.
Как правильно. Повторять протокол раз в 2-3 месяца: только с сентября по октябрь 2026 года вышли четыре заметные модели.
Какую нейросеть лучше выбрать: пошаговый план
-
Выпишите 3-5 типовых задач из своей работы: письма, отчёты, код, таблицы, фото документов.
-
Подберите задачи протокола под каждую и дайте им веса от 1 до 3.
-
Отберите 3 модели из верхней группы рейтингов и из шпаргалки.
-
Подготовьте файлы с известным ответом: документ, выгрузку, фото чека.
-
Прогоните задачи в чате, каждую модель в новом диалоге, текст запроса без изменений.
-
Поставьте баллы по критериям и посчитайте результат с весами.
-
Закрепите победителей по задачам: одна модель для текстов, другая для кода, третья для файлов.
-
Перепроверьте через 2-3 месяца, когда выйдут новые версии.
Совет: сохраните свои запросы протокола в заметках. Тогда повторная проверка новой модели займёт полчаса.
Частые вопросы о выборе нейросети
Какую нейросеть лучше использовать новичку?
Начните с модели из верхней группы обоих рейтингов, например Claude Opus 5.5 или Claude Sonnet 5.5, и проверьте её на 3-4 задачах протокола. Если результат устраивает, сравнивать дальше не обязательно.
Какая сейчас лучшая нейросеть по рейтингам?
На 20 октября 2026 года Claude Opus 5.5 первая в индексе Artificial Analysis, а Gemini 4 Argon первая в общем рейтинге Text Arena. Единого лидера нет, потому что рейтинги меряют разное.
Нейросеть какая лучше в России, если нет зарубежной карты?
Модели те же, что и везде, вопрос в доступе. Через сервис с оплатой в рублях вы выбираете по рейтингам и своим задачам, а не по тому, у кого получилось оформить подписку.
Можно ли сравнить нейросети бесплатно?
За подписку на Telegram-канал Umnik AI начисляют 50 токенов, их можно потратить на задачи протокола. Дальше условия описаны на странице тарифов.
Нужна ли карта иностранного банка?
Нет. Оплата рублями картой российского банка, модели открываются из одного аккаунта в браузере на компьютере и телефоне.
Почему GPT-6 Astra низко в Text Arena, если у неё рекордные бенчмарки?
Бенчмарки OpenAI меряют правильность в математике, коде и головоломках, а Text Arena показывает, какой ответ людям понравился больше. Это разные качества, поэтому проверьте модель на своих задачах.
Можно ли доверять бенчмаркам из анонсов?
Как ориентиру да, как окончательному ответу нет. Разработчик сам выбирает тесты и соперников, а независимая проверка появляется позже.
Как часто меняются лидеры?
Быстро: с начала сентября по середину октября 2026 года вышли GPT-6 Astra, Claude Opus 5.5, Grok 4.7 и Gemini 4 Argon. Повторяйте свою проверку раз в 2-3 месяца.
Сколько задач нужно для честного сравнения?
Для первого решения хватает 4-5 задач с большим весом и трёх моделей. Все 10 задач протокола имеют смысл, если модель будет основным рабочим инструментом команды.
Заключение
Публичные рейтинги на осень 2026 года сходятся в одном: Claude Opus 5.5 и Gemini 4 Argon в верхней группе, а у GPT-6 Astra, Grok 4.7 и DeepSeek V4 сильные стороны в отдельных задачах. Но каждый рейтинг считает все задачи одинаково важными, и поэтому не знает, что важно вам. Десять задач протокола и таблица весов закрывают этот пробел за один вечер.
Какую нейросеть лучше использовать, решают ваши задачи, а не первое место в таблице. Откройте чат с моделями, отправьте одну и ту же задачу Claude Opus 5.5, ChatGPT 6 Astra и Gemini, поставьте баллы и закрепите победителей по задачам. Все модели из сравнения открываются в Umnik AI из одного аккаунта.
ссылка на оригинал статьи https://habr.com/ru/articles/1097114/