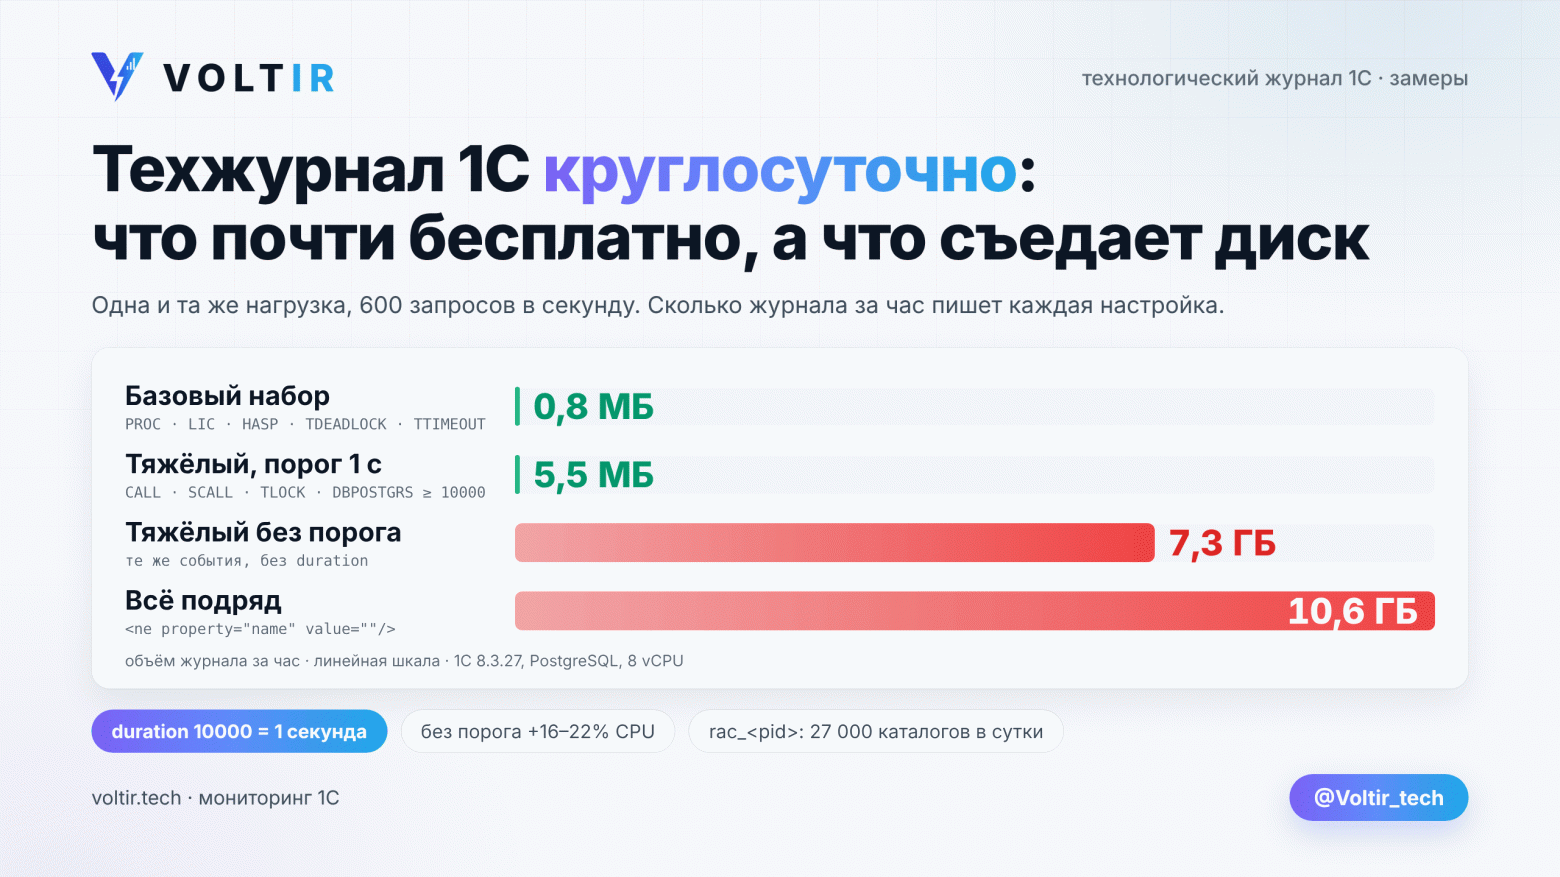
Объём техжурнала 1С за час при разных настройках: 0,8 МБ, 5,5 МБ, 7,3 ГБ, 10,6 ГБЯ делаю платформу мониторинга, и агент на сервере 1С включает журнал сам: ловит дедлоки, таймауты на блокировках и проблемы с лицензиями. Платформа называется Voltir, я её автор. Дальше про неё будет только там, где без этого непонятно, откуда цифры.
Раз агент включает журнал на чужом рабочем сервере, я должен понимать, во что это обходится клиенту. Готовых цифр я не нашёл: везде пишут «много» и «осторожно», но не пишут, сколько именно. Поэтому взял стенд, одну и ту же нагрузку и прогнал её шесть раз с разными настройками журнала.
Стенд и нагрузка
Виртуалка на Proxmox: 8 vCPU, 16 ГБ, Windows 11. Сервер 1С 8.3.27.2130 (32-битный) и PostgreSQL 18.1-2.1C стоят на ней же. Для замера я завёл отдельную базу с пустой конфигурацией, чтобы ничего лишнего в журнал не попадало.
Нагрузку давали шесть внешних соединений через COM (V83.COMConnector) из PowerShell. Каждое крутит цикл:
-
короткий запрос к СУБД: счёт строк по вложенному запросу из 1000 строк, медиана около 6 мс;
-
каждый 50-й раз — запрос с синтаксической ошибкой;
-
каждый 2000-й раз — тяжёлый запрос: декартово произведение на 10 миллионов строк, 3–10 секунд.
Один прогон — 6 минут. После смены logcfg.xml ждал 75 секунд: платформа перечитывает файл в течение минуты. Мерил число запросов, их время, процессорное время rphost и postgres и объём каталога журнала. Порядок: выключен, базовый набор, тяжёлый с порогом, тяжёлый без порога, «всё подряд» и снова выключен. Последний прогон нужен, чтобы увидеть шум самого стенда.
Пока собирал нагрузку, наступил на мелочь: из PowerShell у COM-объектов 1С не читаются свойства. $таблица.Columns возвращает $null, а присвоение $запрос.TempTablesManager = … не срабатывает. Методы работают, поэтому текст запроса я передаю в конструктор (NewObject('Query', текст)), а строки генерирую прямо в запросе через ОБЪЕДИНИТЬ ВСЕ из десяти цифр.
Что этот стенд не показывает. Конфигурация пустая, управляемых блокировок нет, и событий TLOCK, TDEADLOCK и TTIMEOUT в журнале не было вовсе. Сервер при этом был недогружен: rphost занимал 0,7–0,9 ядра из восьми. Предел ставили сами потоки: шесть клиентов, и каждый ждёт ответа на свой запрос. Поэтому скорость тут журнал почти не чувствует, а на сервере, где rphost упирается в ядра, почувствует. Linux я в этот раз не мерил.
Что получилось
Базовый набор и тяжёлый с порогом в 1 секунду пишут меньше 6 МБ в час, и их цена для процессора не выходит за разброс стенда. Тот же тяжёлый набор без порога пишет 7 гигабайт в час, а «всё подряд» больше десяти. Это при 600 коротких запросах в секунду.
|
Настройка журнала |
Запросов в секунду |
CPU rphost на запрос, мс |
95-й перцентиль, мс |
Журнал за 6 минут |
В пересчёте на час |
|---|---|---|---|---|---|
|
Выключен |
631 |
1,16 |
11,3 |
— |
— |
|
Базовый: PROC, LIC, HASP, TDEADLOCK, TTIMEOUT |
604 |
1,31 |
13,0 |
81 КБ |
0,8 МБ |
|
Тяжёлый с порогом 1 с |
631 |
1,30 |
11,7 |
0,56 МБ |
5,5 МБ |
|
Тяжёлый без порога |
584 |
1,47 |
14,8 |
749 МБ |
7,3 ГБ |
|
Всё подряд |
608 |
1,39 |
12,2 |
1,08 ГБ |
10,6 ГБ |
|
Выключен (повтор) |
635 |
1,25 |
12,6 |
— |
— |
«Тяжёлый» набор — базовый плюс SESN, EXCP, TLOCK, CALL, SCALL, DBMSSQL и DBPOSTGRS. Порог стоит на пяти последних событиях. «Всё подряд» — это <event><ne property="name" value=""/></event>. Везде стоит <property name="all"/>. CPU на запрос — процессорное время rphost за прогон, делённое на число коротких запросов. Перцентиль считал по коротким запросам в каждом потоке и усреднял по шести, это не p95 общей выборки.
Что из этого следует
Два прогона с выключенным журналом разошлись на 8%: 1,16 и 1,25 мс процессора rphost на запрос. Это разброс самого стенда, и разницу меньше 10% я здесь не различаю. Базовый набор и тяжёлый с порогом дали 1,31 и 1,30 мс, на 9% выше среднего по двум «выключенным», то есть на границе шума. Без порога выходит 1,39–1,47 мс, на 16–22% больше среднего: rphost пишет запись на каждый вызов сервера и каждый запрос к СУБД.
Со скоростью то же самое. Без порога потеряно 8% относительно среднего по «выключенным», но базовый набор потерял 4,6%, а «всё подряд» 3,9%, и это явно шум. Сервер на стенде был недогружен, поэтому журнал отнимал у него процессор, но не скорость. Там, где rphost упирается в ядра, те же 16–22% процессора превратятся в потерю скорости.
Заметно другое — объём. Без порога rphost за 6 минут записал 864 тысячи записей. На каждый короткий запрос там три CALL и один DBPOSTGRS: внешнее соединение несколько раз ходит на сервер, пока выполнит запрос и заберёт результат. В «всём подряд» к ним добавляются две SDBL, и записей уже 1,35 миллиона. На один вызов сервера rphost пишет примерно 0,9 КБ без порога и 1,4 КБ в «всём подряд». Отсюда оценка для своего сервера: 100 вызовов в секунду дадут 0,3–0,5 ГБ в час только в каталогах rphost, 8–12 ГБ в сутки.
Число 10000 в фильтре <ge property="duration" value="10000"/> — это одна секунда. В фильтрах logcfg.xml длительность задаётся в десятитысячных долях секунды, а в записях 8.3 пишет микросекунды. Так же считают в примерах на Инфостарте: там 50000 подписано как 5 секунд. На прогоне с порогом в журнал попали все 115 тяжёлых запросов и ни одного короткого, по три записи на запрос: SCALL на клиенте, CALL и DBPOSTGRS на сервере. Самая короткая запись — 3 234 947 микросекунд. Ровно секунду этот прогон не доказывает: запросов от 0,1 до 3 секунд в нагрузке не было. Но он исключает обе ошибки, на которых спотыкаются. Будь число в миллисекундах, порог был бы 10 секунд и почти все тяжёлые запросы прошли бы мимо. Будь оно в микросекундах, порог был бы 10 мс, и в журнал попала бы заметная часть коротких. А если написать в фильтре 1 000 000, думая про микросекунды, порог станет 100 секунд, и медленное в журнал попадать перестанет.
Базовый набор за 6 минут записал 68 серверных записей, и все они про лицензии: 52 HASP и 16 LIC. PROC не было ни одного, процессы не перезапускались. На живой базе добавятся дедлоки и таймауты, ради которых журнал и включают.
Чего нет в таблице
Кроме объёма, вылезло несколько мелочей, которых в таблице не видно.
1. Каталоги rac_
Каждый запуск rac создаёт в каталоге журнала свой каталог, даже если в нём не окажется ни одной записи. В базовом прогоне их набралось 124 за 6 минут: мониторинг дёргает rac примерно раз в три секунды. Это больше тысячи каталогов в час и около 27 тысяч в сутки. Старые файлы платформа удаляет по history, а пустые каталоги остаются.
Лечится пустым logcfg.xml в профиле пользователя, от которого запускается rac: <config xmlns="http://v8.1c.ru/v8/tech-log"/>. На Linux это ~/.1cv8/1C/1cv8/conf/, на Windows — AppData\Local\1C\1cv8\conf и AppData\Roaming\1C\1cv8\conf в профиле.
Тут же нашёлся наш баг. Агент кладёт этот файл в профиль SYSTEM, C:\Windows\System32\config\systemprofile. Но у 32-битного сервера 1С и rac 32-битный, а такой процесс Windows перенаправляет в C:\Windows\SysWOW64\config\systemprofile. Там файла не было. Положил его туда: за 3 минуты было 56 каталогов, стало ноль.
2. ADMIN от самого мониторинга
В режиме «всё подряд» ragent за 6 минут записал 241 событие ADMIN и 252 ATTN. ADMIN появляется на каждую административную команду, а команды здесь отдавал наш же rac. Поэтому ADMIN в постоянный набор мы не берём, иначе журнал заполнится вызовами мониторинга.
3. Клиентские процессы на сервере
logcfg.xml из каталога conf читает любой процесс этой установки, не только rphost. Шесть процессов PowerShell с COM-соединением записали 143 МБ без порога и 150 МБ в «всём подряд». Если на сервере крутятся обмены через внешнее соединение, их журнал ляжет рядом с серверным.
4. Ошибки запросов лежат не в rphost
На запросы с синтаксической ошибкой в журнале появилось 4442 записи QERR, и все в каталогах PowerShell. EXCP в rphost было 7, столько же, сколько в прогоне с порогом, так что к ошибочным запросам они не относятся. QERR в тяжёлый набор не входит. Для запросов из внешнего соединения искать их надо в журнале клиента. Куда попадут ошибки серверного кода, я не проверял.
5. Один файл на всю установку
logcfg.xml один на все базы и все процессы. Если подрядчик включил журнал для расследования, а мониторинг пишет свой, кто-то затрёт чужую настройку. Свой файл мы метим строкой-маркером, а файл без маркера агент не трогает: значит, журналом занимается человек.
6. Тяжёлый набор забывают выключить
Это не из замера, сами так делали. Поэтому у нас диагностический набор включается на три дня и потом сам возвращается к базовому.
Что в итоге стоит у нас
Постоянно включён только базовый набор с хранением на сутки. Путь в примерах — для Linux, на Windows подставьте свой каталог, например C:\1c-tj.
<?xml version="1.0" encoding="UTF-8"?><config xmlns="http://v8.1c.ru/v8/tech-log"> <dump create="false"/> <log location="/var/log/1c-tj" history="24"> <event><eq property="name" value="PROC"/></event> <event><eq property="name" value="LIC"/></event> <event><eq property="name" value="HASP"/></event> <event><eq property="name" value="TDEADLOCK"/></event> <event><eq property="name" value="TTIMEOUT"/></event> <property name="all"/> </log></config>
Диагностический включается на три дня, с порогом в одну секунду и хранением на 72 часа:
<?xml version="1.0" encoding="UTF-8"?><config xmlns="http://v8.1c.ru/v8/tech-log"> <dump create="false"/> <log location="/var/log/1c-tj" history="72"> <event><eq property="name" value="PROC"/></event> <event><eq property="name" value="LIC"/></event> <event><eq property="name" value="HASP"/></event> <event><eq property="name" value="TDEADLOCK"/></event> <event><eq property="name" value="TTIMEOUT"/></event> <event><eq property="name" value="SESN"/></event> <event><eq property="name" value="EXCP"/></event> <!-- 10000 = 1 секунда: в фильтре десятитысячные доли секунды --> <event><eq property="name" value="TLOCK"/><ge property="duration" value="10000"/></event> <event><eq property="name" value="CALL"/><ge property="duration" value="10000"/></event> <event><eq property="name" value="SCALL"/><ge property="duration" value="10000"/></event> <event><eq property="name" value="DBMSSQL"/><ge property="duration" value="10000"/></event> <event><eq property="name" value="DBPOSTGRS"/><ge property="duration" value="10000"/></event> <property name="all"/> </log></config>
Что проверить у себя, если журнал должен жить постоянно:
-
В постоянном наборе только редкие события, ADMIN в нём нет.
-
У CALL, SCALL, TLOCK и событий СУБД стоит порог по
duration, в десятитысячных долях секунды. По самому журналу видно, что записей короче порога нет. -
У диагностического набора есть срок, и выключается он по таймеру, не руками.
-
У пользователя, от которого мониторинг запускает rac, в профиле лежит пустой
logcfg.xml. На 32-битной 1С под Windows — и вSysWOW64\config\systemprofile. -
В каталоге журнала не копятся пустые подкаталоги:
historyудаляет только файлы. -
Ошибки запросов ищутся и по QERR, а не только по EXCP: из внешнего соединения они пишутся в журнал клиента.
-
Понятно, кто владеет
logcfg.xmlна этой установке, и файл помечен. -
На диске есть запас под полный журнал на время расследования: около 1–1,4 КБ на вызов сервера в каталогах rphost, плюс журнал клиентских процессов на сервере.
Как события из такого журнала выглядят на графиках, можно посмотреть на публичном дашборде 1С без регистрации. Данные там с демо-стенда, имена вымышленные.
Вопрос к тем, кто держит журнал на рабочих базах
Какой порог по duration вы ставите для CALL и запросов к СУБД, если журнал работает неделями? У меня одна секунда, и мне интересно, сколько это даёт на живых базах на 100–300 пользователей. Если сможете назвать объём журнала за сутки, добавлю эти цифры в статью рядом со стендовыми.
ссылка на оригинал статьи https://habr.com/ru/articles/1097436/