В большей степени эта статья будет полезна тем, кто уже пытался реализовать или реализовал свои сложные рендеры на Vulkan. Я лишь расскажу, как пытался организовать современный Vulkan-код, чтобы получить его эффективность и гибкость.
Каждый, кто имеет хоть какой-нибудь опыт работы с Vulkan, задавался вопросом, как правильно его организовать. Какие платформы поддерживать? Какие фичи GPU считать обязательными, а какие опциональными? Можно ли поддерживать вообще все? А еще многопоточность и async compute…
Самая большая проблема — то, что GPU очень разные (IMR vs TBDR, UMA vs Discrete). Когда пытаешься описать все это разнообразие одним API и поддержать его целиком, приходишь к веткам, очень большим веткам кода.
Vulkan 1.3 устраняет множество проблем и, особенно для ПК, сокращает объем кода, поэтому я рекомендовал бы начинать сразу с него. Со временем разница между GPU становится все меньше, и полностью ПК-рендер с небольшими доработками (а то и без них) можно будет запустить на мобильных устройствах.
Чтобы все же дойти до работающего результата, я взял за основу профиль VP_LUNARG_desktop_baseline_2024 и брал оттуда все расширения и большинство лимитов, форматов и фич. Профиль гарантирует, что GPU поддерживает определенный минимальный набор возможностей, хотя на реальном устройстве лимиты, скорее всего, выше.
Из-за многословности Vulkan и объема темы дальше я опишу только самые важные по моему мнению вещи, главное чтобы была понятна идея:
pub struct RenderContext { pub(crate) size_dependent: RwLock<SizeDependentResources>, pub(crate) device: Device, pub(crate) surface: Surface, pub(crate) instance: Instance,}impl RenderContext { pub fn new(window: &Window) -> Arc<Self> { let instance = Instance::new(); let surface = Surface::new(&instance, window); let device = Device::new(&instance, &surface); let size_dependent = RwLock::new( SizeDependentResources::new(&instance, &surface, &device) ); Arc::new(Self { size_dependent, device, surface, instance, }) }}
Структура RenderContext (она возвращается как Arc<RenderContext>) инициализирует и хранит основной набор Vulkan-объектов: device, queue и GPU-аллокаторы. Я с самого начала заложил в нее Send и Sync, хотя бы для того, чтобы glTF-модель можно было целиком создавать в другом потоке, не затрагивая основной. Честно говоря, я до сих пор не знаю, стоило ли делать это сразу или было бы проще добавить многопоточность позже, уже имея однопоточный рендерер.
Затем я написал большую структуру, которая создает «голые» vk-объекты и управляет ими через Handle. Handle — это легкая структура-идентификатор объекта, а для работы с такими идентификаторами давно есть готовый crate — slotmap. Handle-based подход можно увидеть в докладе Frostbite на GDC, «FrameGraph: Extensible Rendering Architecture in Frostbite»: там любой ресурс — лишь непрозрачный идентификатор (idResource), с которым работает FrameGraph. Я поступил так же и для долгоживущих ресурсов, и для временных.
#[derive(Clone)]pub struct RenderResources { pub persistent: Arc<ResourcePool>, pub transient: Arc<TransientResourceCache>, pub bindless: Arc<Bindless>,}impl RenderResources { pub fn new(ctx: &Arc<RenderContext>) -> Self { Self { bindless: Bindless::new(ctx), persistent: ResourcePool::new(ctx), transient: TransientResourceCache::new(), } }}pub struct RenderGraphExecutor { pub ctx: Arc<RenderContext>, resources: RenderResources,}impl RenderGraphExecutor { pub fn new(window: &winit::window::Window) -> Arc<Self> { let ctx = RenderContext::new(window); Arc::new(Self { resources: RenderResources::new(&ctx), ctx, }) } pub fn create_render_graph(&self) -> RenderGraph<'_> { RenderGraph { transient_cache: self.resources.transient.clone(), passes: vec![], _marker: PhantomData, } } pub fn resize(&self, width: u32, height: u32) { self.ctx.resize(width, height); self.resources.transient.invalid_cache(); } pub fn create_texture(&self, desc: &TextureDesc, data: Option<&[u8]>) -> Handle<Texture> { self.resources .persistent .create_texture(&self.ctx, desc, data) } pub fn register_bindless_texture(&self, handle: Handle<Texture>) -> u32 { let texture = self.resources.persistent.get_texture(handle); self.resources .bindless .bind_image_view(&self.ctx, texture.view) .unwrap() } pub fn swapchain_texture(&self) -> Handle<Texture> { self.resources.persistent.swapchain_texture() } pub fn execute(self: &Arc<Self>, rg: &mut RenderGraph<'_>) { ... } // И дальше похожие методы}pub struct Texture { pub image: vk::Image, pub allocation: Option<Allocation>, pub view: vk::ImageView, pub extent: vk::Extent2D, pub aspect_mask: vk::ImageAspectFlags,}
И да, я не клоную vk::Device в каждый объект для самостоятельного удаления. Вместо этого у меня большая группа SlotMap<Id, vk::*>. Для безопасного удаления нужна была бы очередь с подсчетом кадров, которая гарантировала бы, что ресурс больше не используется, но я ее так и не реализовал и почти не уделял этому вопросу внимания.
RenderResources обязательно должна быть Clone, Send и Sync: это требуется для PassContext, о котором я расскажу чуть позже.
Каждый кадр RenderGraphExecutor создает временную структуру RenderGraph, в которую записывается вся основная информация о необходимых проходах и ресурсах. При этом он клонирует кеш временных (transient) ресурсов, чтобы уберечь себя и других разработчиков от ситуации, когда Handle из разных кадров пересекутся.
Функция execute одним вызовом полностью берет на себя вывод изображения на экран. Она также совмещает в себе ответственность compile и создает барьеры перед исполнением.
Swapchain Texture — постоянный Handle, но особенный. Перед тем как Handle будет преобразован в настоящую текстуру resolve(), его содержимое обновляется: я получаю индекс изображения через acquire_next_image(), беру соответствующие image и view и напрямую подставляю их вместо прежних. Код для этого выглядит ужасно, но работает:
{ let backbuffer = self.resources.persistent.swapchain_texture(); let mut resources = self.resources.persistent.inner.write(); let new_image = frame.swapchain_images[image_index as usize]; let texture = resources.textures.get_mut(backbuffer.id).unwrap(); texture.image = new_image; texture.view = frame.swapchain_image_views[image_index as usize]; resources .image_access .entry(new_image) .or_insert(AccessType::Nothing);}
RenderGraph — контейнер, в который записываются все данные о кадре: проходы и ресурсы. Ресурсы делятся на три вида: временные, постоянные и экспортируемые. Чтобы их различать на уровне типов, я ввел RgHandle<T> для временных ресурсов и ExportHandle<T> для экспортируемых; постоянные по-прежнему адресуются обычным Handle.
pub struct RenderGraph<'a> { pub passes: Vec<Pass<'a>>, pub transient_cache: Arc<TransientResourceCache>, pub _marker: PhantomData<*mut ()>,}impl<'a> RenderGraph<'a> { pub fn new(cache: Arc<TransientResourceCache>) -> Self { Self { transient_cache: cache, passes: vec![], _marker: PhantomData, } } pub fn add_pass<S: Into<String>>(&mut self, name: S) -> PassBuilder<'_, 'a> { PassBuilder::new(self, name.into()) } pub fn import_texture(&mut self, handle: Handle<Texture>) -> RgHandle<Texture> { self.transient_cache.import_texture(handle) } pub fn export_texture( &mut self, handle: RgHandle<Texture>, final_access: vk_sync::AccessType, ) -> ExportHandle<Texture> { self.transient_cache.export_texture(handle, final_access) } pub fn import_buffer(&mut self, handle: Handle<Buffer>) -> RgHandle<Buffer> { self.transient_cache.import_buffer(handle) } // Другие методы...}
Для описания того, как проход обращается к ресурсу, я взял AccessType из vk-sync в будущем это поможет упростить синхронизацию.
Кеш транзитных ресурсов хранит запросы на создание ресурсов и сами ресурсы, использовавшиеся в предыдущих кадрах. При изменении размера экрана почти все они становятся невалидными.
В пассах хранится достаточно информации об читаемых и пишуших ресурсах. Тип очереди и имя пасса не использовал пока что. Вот такое сейчас это выглядит:
#[derive(PartialEq)]pub enum QueueType { Compute, Transfer, Graphics,}pub enum DependencyResource { ColorAttachment { handle: RgHandle<Texture>, load: vk::AttachmentLoadOp, store: vk::AttachmentStoreOp, clear_value: vk::ClearColorValue, }, DepthAttachment { handle: RgHandle<Texture>, load: vk::AttachmentLoadOp, store: vk::AttachmentStoreOp, clear_value: vk::ClearDepthStencilValue, }, Buffer(RgHandle<Buffer>), Texture(RgHandle<Texture>),}pub struct Pass<'a> { pub name: String, pub queue_type: QueueType, pub reads: Vec<(DependencyResource, AccessType)>, pub writes: Vec<(DependencyResource, AccessType)>, pub callback: Box<dyn Fn(&mut PassContext) + 'a>,}pub struct PassBuilder<'b, 'a> { name: String, queue_type: QueueType, reads: Vec<(DependencyResource, AccessType)>, writes: Vec<(DependencyResource, AccessType)>, rg: &'b mut RenderGraph<'a>,}
В execute остаётся лишь:
-
создать или переиспользовать ресурсы из запроса
RenderGraph -
правильно вычислить барьеры
-
пройти по каждому проходу и записать команды в командный буфер
-
выполнить всю работу с выводом изображения на экран
Расстановка барьеров у меня довольно тупая: я не сортирую проходы и не удаляю ненужные. Я просто прохожусь по всем ресурсам, и если AccessType ресурса отличается от того, который требуется проходу, ставлю барьер перед его выполнением.
С помощью vk-sync можно по небольшому описанию получить лишь классические барьеры 1.0. Хотя я давно использую новые барьеры из VK_KHR_synchronization2 (в Vulkan 1.3 они входят в ядро), но при этом могу совмещать их с классическими. У классических барьеров флаги и маски 32-битные (u32), а у новых 64-битные, и простое приведение к u64 решает эту проблему:
fn image_barrier2( image: vk::Image, range: vk::ImageSubresourceRange, prev: AccessType, next: AccessType, discard: bool,) -> vk::ImageMemoryBarrier2<'static> { let prev = &[prev]; let next = &[next]; let (src_stage, dst_stage, b) = vk_sync::get_image_memory_barrier(&vk_sync::ImageBarrier { previous_accesses: prev, next_accesses: next, previous_layout: vk_sync::ImageLayout::Optimal, next_layout: vk_sync::ImageLayout::Optimal, discard_contents: discard, src_queue_family_index: vk::QUEUE_FAMILY_IGNORED, dst_queue_family_index: vk::QUEUE_FAMILY_IGNORED, image, range, }); vk::ImageMemoryBarrier2::default() .src_stage_mask(vk::PipelineStageFlags2::from_raw(src_stage.as_raw() as u64)) .dst_stage_mask(vk::PipelineStageFlags2::from_raw(dst_stage.as_raw() as u64)) .src_access_mask(vk::AccessFlags2::from_raw(b.src_access_mask.as_raw() as u64)) .dst_access_mask(vk::AccessFlags2::from_raw(b.dst_access_mask.as_raw() as u64)) .src_queue_family_index(vk::QUEUE_FAMILY_IGNORED) .dst_queue_family_index(vk::QUEUE_FAMILY_IGNORED) .old_layout(b.old_layout) .new_layout(b.new_layout) .image(b.image) .subresource_range(b.subresource_range)}
RenderContext и RenderGraphExecutor быстро инициализируются и берут на себя создание и удаление ресурсов, а RenderGraph описывает весь кадр. Благодаря этому использование становится очень простым. Покажу это на примере:
pub struct MotionBlurRenderer { pipeline: Handle<Pipeline>,}impl MotionBlurRenderer { pub fn new(executor: &Arc<RenderGraphExecutor>) -> Self { let pipeline = executor.create_pipeline( &GraphicsPipelineDesc::new("./simple.spv", "./motion_blur.spv") .with_color(vk::Format::R8G8B8A8_UNORM) .with_dynamic_scissor(true) .with_dynamic_viewport(true) .with_bindless(true) .with_bindings(vec![ BindingDesc { binding: 0, kind: BindingKind::SampledImage, stages: vk::ShaderStageFlags::FRAGMENT, }, BindingDesc { binding: 1, kind: BindingKind::SampledImage, stages: vk::ShaderStageFlags::FRAGMENT, }, ]), ); Self { pipeline } } pub fn render<'a>( &'a mut self, rg: &mut RenderGraph<'a>, color_target: RgHandle<Texture>, velocity_target: RgHandle<Texture>, ) -> RgHandle<Texture> { let blurred_color = rg.create_texture(TextureDesc { name: "Pbr Color Blurred", format: Format::Explicit(vk::Format::R8G8B8A8_UNORM), resolution: Resolution::FullRes, usage: TextureUsage::ColorAttachmentSampled, }); rg.add_pass("Motion Blur Pass") .color_attachment( blurred_color, vk_sync::AccessType::ColorAttachmentWrite, vk::AttachmentLoadOp::CLEAR, vk::AttachmentStoreOp::STORE, vk::ClearColorValue { float32: [0.0, 0.0, 0.0, 0.0], }, ) .read_texture( color_target, vk_sync::AccessType::FragmentShaderReadSampledImageOrUniformTexelBuffer, ) .read_texture( velocity_target, vk_sync::AccessType::FragmentShaderReadSampledImageOrUniformTexelBuffer, ) .execute(move |ctx| { #[repr(C)] #[derive(Clone, Copy, Pod, Zeroable, Debug)] struct MotionBlurPush { sample_count: u32, max_velocity: f32, scale: f32, } ctx.bind_pipeline(self.pipeline, vk::PipelineBindPoint::GRAPHICS); ctx.bind_bindless(); ctx.push_descriptor_texture(color_target, 2, 0); ctx.push_descriptor_texture(velocity_target, 2, 1); ctx.set_full_scissor(); ctx.set_full_viewport(); ctx.push_constants(&MotionBlurPush { sample_count: 4, max_velocity: 0.01, scale: 0.1, }); ctx.draw(3); }); blurred_color }}
Размер транзитных текстур удобнее описывать относительно полного размера экрана, и лишь немногим из них нужен фиксированный размер.
Push descriptors позволяют привязать ресурс сразу, без выделения descriptor set, но ценой дополнительной нагрузки на CPU.
Bindless позволяет один раз привязать огромный массив ресурсов, а в шейдере обращаться к ним по индексу, что снижает нагрузку на CPU.
Каждый проход рендеринга заканчивается объявлением callback, который принимает тот самый PassContext. Каждый проход получает собственную копию контекста и может записывать команды в командный буфер (primary или secondary) из главного или из собственного потока. Вот как выглядит объявление этого контекста:
#[derive(Default)]pub struct RuntimeData { pub current_layout: Option<vk::PipelineLayout>, pub current_bind_point: Option<vk::PipelineBindPoint>, pub descriptor_sets: Vec<vk::DescriptorSet>,}pub struct StaticData<'a> { pub device: &'a ash::Device, pub push_descriptor: &'a ash::khr::push_descriptor::Device, pub resources: RenderResources, pub extent: vk::Extent2D, pub cmd: vk::CommandBuffer,}pub struct PassContext<'a> { pub static_data: StaticData<'a>, pub runtime_data: RuntimeData,}
Несколько советов по работе с Vulkan, которые я выделил для себя:
-
Если рефакторинг сломал основной render loop, починить его нужно как можно быстрее. Иначе велик риск, что всё затянется и ты в итоге бросишь проект.
-
Код будет ужасен. Vulkan подталкивает к тому, чтобы все части кода знали друг о друге, поэтому инкапсуляция всегда будет страдать. Скрыть эти детали может только очень большой слой абстракции, но внутри него инкапсуляции не будет. Костыли останутся надолго.
-
Попытка с самого начала поддерживать все GPU, от Mali-G76 до RTX 5090, будет ошибкой. Сначала поддерживать то железо, на котором работаешь, а затем либо добавь вторую ветку кода для совсем другого железа, переиспользуя общую кодовую базу, либо аккуратно расширь существующий код.
-
Безопасности не будет
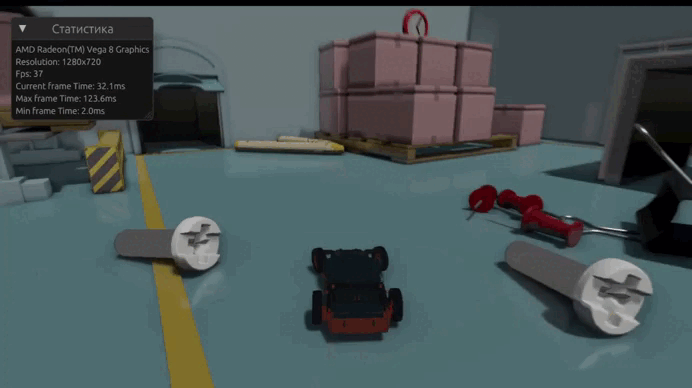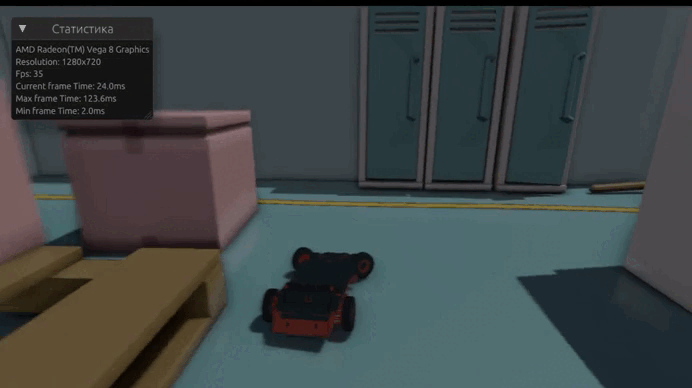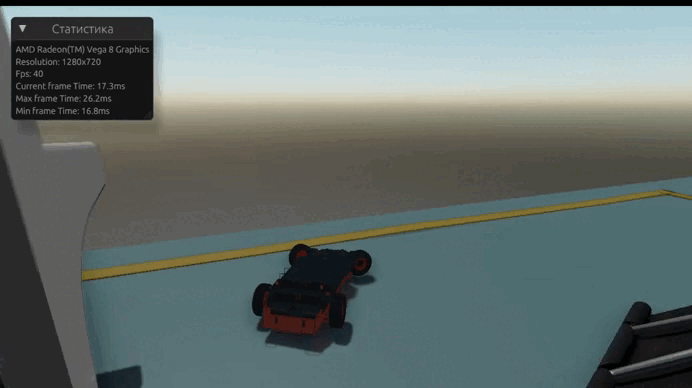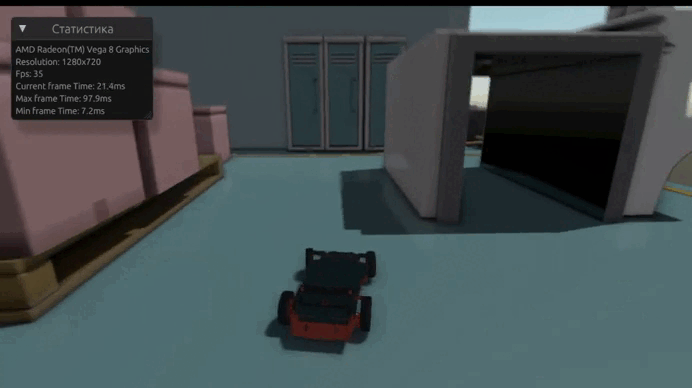
Надеюсь, что такой статьей я немного открыл то, каким образом можно получить урезанную версию графа, но даже она может очень многое. К примеру я реализовал две небольшие техно-демки вдохновившись движком kajiya от Embark
Полезные ссылки:
Граф внутри движка Kajiya: https://github.com/EmbarkStudios/kajiya/tree/main/crates/lib/kajiya-rg
Очень близкая реализация графа как у Frostbite на C++ и OpenGL: https://github.com/skaarj1989/FrameGraph
Статья от Traverse Research об их внутреннем графе: https://blog.traverseresearch.nl/render-graph-101-f42646255636
ссылка на оригинал статьи https://habr.com/ru/articles/1097618/