В XXI веке все считают себя экспертами по литературному стилю, потому что все умеют читать и писать (слава Декрету «О ликвидации безграмотности в РСФСР» 1919 года!). Это просто факт, с ним надо смириться. С появлением ChatGPT стала очевидна другая грань проблемы — оказалось, что если что-то «разговаривает» (имитирует речь алгоритмами), то мы автоматически галлюцинируем, что на том конце «кто-то» есть (даже если мы Ричард Докинз).
В особо запущенных случаях мы готовы отстаивать с пеной у рта, что наше сознание это то же самое, что наш язык, то есть буквально код, то есть точно такие же нейросети, и вообще это даже не метафора, а буквально нет никакой разницы.
Разумеется, самой возможности такой постановки вопроса для всезнающих технарей бы не случилось, если бы в течение XX века наука (гуманитарная, отметим, наука) не совершила несколько революций и не выдвинула несколько радикальных теорий о том, что такое язык, как он возникает и как эволюционирует.
Давайте рассмотрим четыре самые интересные, а потом попробуем осознать, где мы находимся в изучении языка сегодня.
Мы думаем на языке или пользуемся им, чтобы думать?
На релизе в 2022 году большая языковая модель уже могла написать связный текст о философии, объяснить принцип работы компилятора и сочинить стилизацию под научную статью. Выглядело это, разумеется, довольно деревянно (а для насмотренного человека выглядит так до сих пор). Вскоре такие системы научились генерировать программный код, пересказывать книги, имитировать диалог с историческими персонажами… и с убедительным видом рассуждать о предметах, которых никогда не существовало (то есть, погружаться в языковые галлюцинации, не основанные ни на каком означаемом, кроме самой структуры-означающего — Ноам Хомский должен был быть в восторге; правда, он не был).
Для очень многих, как ни странно, это стало доказательством того, что человеческий интеллект наконец удалось разложить на вычислительные операции, и можно праздновать победу над проблемой сознания (ну и праздновать, соответственно, создание Искусственного Интеллекта— ведь если все так просто, то он, получается, уже создан! правда, с этим, скрипя зубами, не согласны даже почти-триллионеры Альтман и Брокман).
Сама постановка вопроса в таком виде, однако, неправильна, и нужно вернуться от инженерных радостей к гуманитарным корням, чтобы исправить эту ошибку. Более корректная постановка была бы такая: что именно мы моделируем, когда моделируем язык?
Ну что за бред, спросят хабровчане, у которых в голове, по их мнению, буквальный биологический чатджпт. Язык это система символов, правил и преобразований. Алфавит, синтаксис, семантика, грамматика, протоколы взаимодействия. Мы можем придумать формальный язык, описать его грамматику, написать парсер и компилятор, проверить корректность программы. Естественный язык действительно более чем допускает формализацию: существуют грамматики, словари, корпуса, статистические модели и алгоритмы, позволяющие извлекать структуру из огромного массива текстов. Короче, все понятно!
Это все, конечно, здорово, но не совсем верно. Человеческий язык не код и не ПО, у него нет единого автора или даже системы авторов, утвержденного стандарта или момента, когда кто-то собрал комиссию и решил, как именно надо правильно строить предложения. Язык меняется, распадается на диалекты, заимствует слова, переживает грамматические перестройки и сохраняет следы давно исчезнувших жизненных практик.
Дети осваивают язык без формального обучения (но не без контактов с другими людьми вообще, это важно), взрослые регулярно понимают высказывания, которые никогда прежде не слышали и даже вообще бессмысленные высказывания, а одна и та же фраза в разных обстоятельствах способна означать противоположные вещи (примеры из русской нецензурной лексики подберете сами).
Интересно, что первый формальный эксперимент, является ли язык врожденным или приобретаемым, согласно Геродоту провели еще в Древнем Египте (История II:2):
Египтяне же до царствования Псамметиха считали себя древнейшим народом на свете. Когда Псамметих вступил на престол, он стал собирать сведения о том, какие люди самые древние. С тех пор египтяне полагают, что фригийцы еще древнее их самих, а сами они древнее всех остальных народов. Псамметих, однако, собирая сведения, не нашел способа разрешить вопрос: какие же люди древнейшие на свете? Поэтому он придумал вот что. Царь велел отдать двоих новорожденных младенцев (от простых родителей) пастуху на воспитание среди стада [коз]. По приказу царя никто не должен был произносить в их присутствии ни одного слова. Младенцев поместили в отдельной пустой хижине, куда в определенное время пастух приводил коз и, напоив детей молоком, делал все прочее, что необходимо. Так поступал Псамметих и отдавал такие приказания, желая услышать, какое первое слово сорвется с уст младенцев после невнятного детского лепета. Повеление царя было исполнено. Так пастух действовал по приказу царя в течение двух лет.
Однажды, когда он открыл дверь и вошел в хижину, оба младенца пали к его ногам и, протягивая ручонки, произносили слово «бекос». Пастух сначала молча выслушал это слово. Когда затем при посещении младенцев для ухода за ними ему всякий раз приходилось слышать это слово, он сообщил об этом царю; а тот повелел привести младенцев пред свои царские очи. Когда же сам Псамметих также услышал это слово, то велел расспросить, какой народ и что именно называет словом «бекос», и узнал, что так фригийцы называют хлеб. Отсюда египтяне заключили, что фригийцы еще древнее их самих. Так я слышал от жрецов Гефеста в Мемфисе. Эллины же передают об этом еще много вздорных рассказов, и, между прочим, будто Псамметих велел вырезать нескольким женщинам языки и затем отдал им младенцев на воспитание.
Помимо того, что язык это формальная система (тот аспект, в котором и оперирует ChatGPT, создавая в результате когнитивной инерции у пользователя иллюзию живого собеседника) — он еще и биологическая способность, исторический процесс (а не устойчивый результат в виде собрания словарей) и общественная практика, которая соотносится с конкретными реалиями употребления. Проблема начинается тогда, когда (как, не устану указывать, в случае с ChatGPT) один из этих аспектов принимают за исчерпывающее объяснение остальных.
История науки о языке это, простите за штамп, череда вопросов. Серьезных вопросов. Можно ли вывести структуру языка из структуры мышления (или надо наоборот)? Существуют ли универсальные грамматические правила, общие для всех людей, при всей разности структур языков? Является ли способность говорить чем-то вроде врожденного инстинкта? Можно ли определить значение слова через правила его употребления? Если машина научилась производить текст, который человек принимает за осмысленную речь, означает ли это, что мы приблизились к пониманию самого языка?
Начнем с начала, точнее, с поиска начала: мы сначала воспринимаем мир, а потом описываем его словами — или это язык участвует в том, каким этот мир нам представляется?
Мир, который язык заставляет нас замечать
Представим человека, который знает два языка. На одном, чтобы сказать, что он видел птицу, ему достаточно сказать, что он видел птицу. На другом, чтобы выразиться естественно и точно (с точки зрения парадигмы используемого языка — как англофоны найдут вашу речь странной без использования артиклей a и the или открытых форм глагола to be), ему придется уточнить, какого она цвета, где находилась или в каком направлении двигалась. Само событие от этого не меняется. Но в одном случае говорящий может оставить часть информации неопределенной, а в другом привычная грамматическая конструкция подталкивает его эту информацию обозначить.
Что происходит с такой разницей в языковом подходе? Меняется ли только речь — или вместе с ней меняется внимание к происходящему, из мира выделяются определенные элементы, и общая картинка складывается по-другому? То есть, действительно ли настолько картины мира разных людей отличаются друг от друга так (и структурно по тому же принципу), как отличаются их языки?
Это один из центральных вопросов гипотезы лингвистической относительности, которую обычно связывают с именами Эдварда Сепира и Бенджамина Ли Уорфа (и называют Гипотезой Сепира-Уорфа, хотя ученые никогда не работали вместе). В некоем стереотипном смысле эта гипотеза принята в популярном культурном сознании народа по умолчанию как верная. Например, обладатели самых странных и экзотических языков, типа китайцев, японцев или индейцев, экзотизируются как носители по-другому устроенного сознания, которое проявляется в их сильно отличающейся в визуальном и смысловом плане культуре (с чем, на первый взгляд, поспорить довольно сложно).
В популярном изложении гипотезу Сепира-Уорфа (давайте, добросовестно сделав все оговорки, все же будем ее называть так для краткости) нередко сводят к эффектной формуле: язык определяет мышление, а значит, носители разных языков буквально живут в разных мирах. Это жесткая версия лингвоотносительности (если бы она была правильной, то, наверное, перевод между языками был бы куда более суровой задачей).
В строгом смысле эта версия опровергнута экспериментально (а также здравым смыслом и житейским опытом): нет, мы не живем в разных мирах потому, что говорим на разных языках. Более того, говорящие на одном языке люди (например, христианин-амиш, атеист-любитель Вархаммера, шизофреник-оккультист и программист с Хабра), даже живущие в одном доме, могут буквально жить в совершенно разных реальностях.
Более мягкая версия гипотезы Сепира-Уорфа указывает, что язык не обязательно ограничивает доступные человеку мысли, но может влиять на то, какие различия между феноменами и их свойствами тот привычно замечает, как группирует опыт и какие характеристики события играют первоочередную роль.
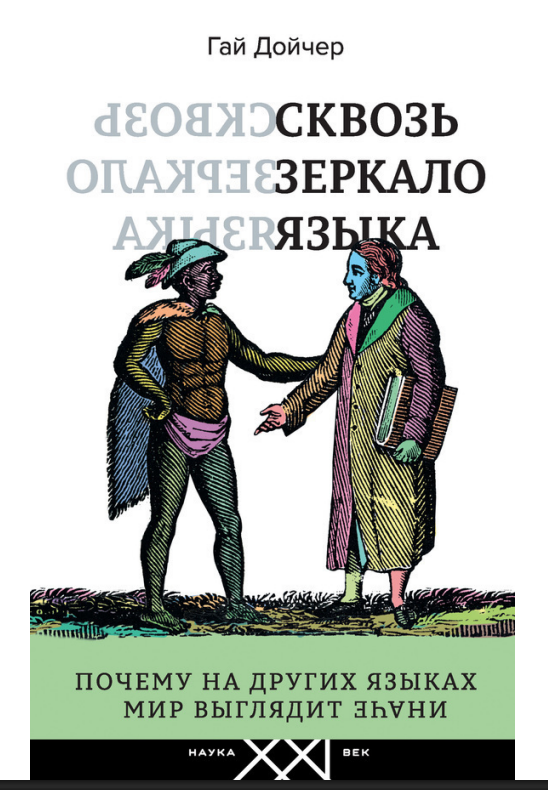
Эту позицию, которая уже больше похожа на правду, хорошо раскрывает книга лингвиста Гая Дойчера «Сквозь зеркало языка. Почему на других языках мир выглядит иначе». Дойчер довольно беспощадно разносит популярные представления о том, как связаны язык и мышление (или, допустим, язык и «национальный характер» — здесь должна быть типичная бумерская шутка, что любая длинная фраза на немецком звучит как речь Гитлера (максимально осуждаем)), а также строго и методично рассматривает, как культурно и исторически сложившиеся языковые привычки могут влиять на внимание и интерпретацию опыта, не отменяя общих ограничений человеческого восприятия.
Среди его основных примеров — цветовые категории (вспоминаем в том числе и Гомера, конечно!), грамматический род и способы описания пространства.
Сепир превратил утверждения о влиянии языка на философские идеи в тезис о влиянии родного языка на обыденные мысли и восприятие. Он заговорил о «тираническом влиянии, которое оказывает языковая форма на нашу ориентацию в мире», и в отличие от всех своих предшественников, он стал подкреплять такие лозунги реальным содержанием. Вот какой пример того, как специфические языковые отличия должны влиять на мысли носителя языка, он предложил в 1931 году.
Когда мы наблюдаем камень, летящий в пространстве к земле, объяснял Сепир, мы невольно разделяем это событие на два отдельных понятия: камень и действие падения, и мы заявляем, что «камень падает». Мы считаем, что это единственно возможный способ описания такого события. Но необходимость деления на «камень» и «падает» – это лишь иллюзия, потому что язык нутка, на котором говорят на острове Ванкувер, действует иначе. Там нет глагола, соответствующего нашему «падать», который может независимо описывать действие разных падающих объектов. Вместо этого для описания движения камня используется специальное слово вроде «камнить». Чтобы описать событие падения камня, это слово сочетается с элементом «вниз». Так что описание события, которое мы разбиваем на «камень» и «падать», на нутка описывается как что-то вроде «камнит вниз».
Такие реальные примеры «несоизмеримости членения опыта в разных языках, – говорит Сепир, – привели бы нас к общему выводу об одном виде относительности, которую скрывает от нас наше наивное принятие жестких навыков нашей речи… мы имеем дело с относительностью понятий, или, как ее можно назвать по-другому, с относительностью формы мышления». Этот вид относительности, добавляет Сепир, «не столь трудно усвоить, как физическую относительность Эйнштейна; однако наша относительность наиболее легко ускользает от научного анализа. Ибо для ее понимания сравнительные данные лингвистики являются условием „sine qua non“».
К несчастью для Сепира, именно за счет того, что он оставил уютную неопределенность философских лозунгов и углубился в ледяные сквозняки конкретных языковых примеров, стал виден тонкий лед, на котором стоит его теория. Выражение из языка нутка «это камнит вниз», безусловно, очень оригинальный способ описания событий, и это, конечно, звучит странно, но должна ли эта странность означать, что говорящие на нутка обязаны воспринимать это событие по-иному? Подразумевает ли слияние глагола и существительного в нутка, что носители этого языка не имеют в своем сознании отдельных образов объекта и действия? Мы можем проверить это, если приложим аргумент Сепира к несколько более знакомому языку.
Возьмем английскую фразу «идет дождь», буквально «это дождит» (it rains). Эта конструкция на самом деле очень схожа с «это камнит вниз» из нутка, потому что действие («падает») и объект («капли воды») скомбинированы в одно глагольное понятие. Но так поступают не все языки. В моем родном языке объект и действие разделяются, мы говорим нечто вроде «дождь падает». Так что вот вам глубокое отличие в том, как наши языки выражают событие дождя. Но значит ли оно, что вы и я должны по-разному воспринимать дождь? Чувствуете ли вы, что грамматика вашего родного языка мешает вам понять разницу между водной субстанцией и действием падения? Кажется ли вам трудным соотнести падение дождевых капель с другими объектами, которые падают? Или отличия в способах, которыми наши языки выражают идею дождя, – всего лишь отличия в грамматической организации?
Дойчер выливает ведро холодной воды на распаленное воображение исследователя лингвистической относительности, например, (не без горечи) указывая, что ряд неверно понятых предпосылок к изучению вопроса основан… попросту на недопонимании социальных факторов! Так, человек, который говорит на чужом языке (и знает его плохо) всегда кажется по умолчанию менее умным, чем если бы он говорил на родном.
Многие десятилетия, однако, исследователи искренне полагали, что проблема именно в самих дикарях-недочеловеках:
…неразвитый образ жизни отражен в некоем неразвитом способе говорить, примитивные орудия каменного века – показатель примитивных грамматических структур, нагота и наивность отражаются в детской и нечленораздельной речи.
Это неверное представление столь распространено по довольно простой причине. Наше восприятие языка в основном базируется на контакте с его носителями, а для большинства из нас соприкосновение с какими бы то ни было аборигенными языками происходит через популярную литературу, кино и телевизор. И то, что мы слышим в таких отображениях, от Тэнтэна[172] до вестернов, – это неизбежные индейцы, африканцы и всяческие прочие «туземцы», говорящие этаким рудиментарным образом: «Моя нет прийти, Сагиб». Так не в том ли проблема, что мы просто одурачены популярным чтивом? Может, ломаная речь, которая у нас ассоциируется с аборигенами разных континентов, – это лишь предрассудок, фикция искаженного воображения шовинистическо-империалистических умов? Если кто-то возьмет на себя труд съездить в Северный Квинсленд, чтобы самому убедиться, обнаружит ли он, что все туземцы на самом деле блистают каскадами шекспировского красноречия?
Не совсем так. Хотя популярные источники могут не вполне соответствовать высочайшим стандартам академической точности, изображаемая ими картина в целом основана на реальности. В самом деле, аборигены действительно часто используют грубые и внеграмматические языковые конструкции: «не деньги не дали», «нет мог сделать», «очень много я был спать», «раньше долго я не иметь проблемы» («я давно не попадал в неприятности»), «я они шли шли шли темно» (мы продолжали идти, пока совсем не стемнело). Все это аутентичные примеры речи аборигенов.
Но вы заметили тут некоторую неувязку? Примитивный язык, на котором говорят эти люди, всегда… английский. И если, говоря по-английски, они действительно используют урезанную, внеграмматическую, рудиментарную, нечленораздельную – короче, «примитивную» – версию языка, то это просто потому, что английский – не их язык. Просто представьте себе на миг, что вот такое красноречивое, утонченное, грамматически подкованное создание, как вы, пытается изъясниться на языке, которому вас никогда не учили. Вы приезжаете в богом забытую деревушку, куда-то, где никто не говорит по-английски, и уже отчаялись найти ночлег. Все, что у вас есть, – это карманный словарь. Все богатство и утонченность тут же без вопросов отбрасываются. Никаких больше: «Не будете ли вы так любезны сообщить мне, где бы я мог найти в этой деревне помещение, чтобы переночевать?» Ничего подобного! Вы стоите лингвистически голым и запинаетесь: yo dormir aqui? ana alnoom hoona? или произносите: «где я спать?» на любом языке, на котором попробуете изъясниться.
Когда пытаешься говорить на иностранном языке, не потратив годы на заучивание его грамматических нюансов, действует вечная стратегия выживания: отбросить все, кроме самого необходимого, оставить только самое важное, забыть обо всем, что не представляется жизненно важным для четкого выражения основного смысла. Аборигены, пытающиеся говорить по-английски, делают именно это не потому, что в их языке нет грамматики, просто богатство их собственного языка совершенно не помогает справиться с чужим, который они как следует не выучили. Североамериканские индейцы, например, в чьих языках используются труднопроизносимые длинные слова с умопомрачительной архитектурой окончаний и приставок, не могут справиться с одним рудиментарным окончанием -s в английских глаголах и говорят he come – «он приходить», she work – «она работать» и так далее. А южноамериканские индейцы, в чьих собственных языках часто употребляются несколько прошедших времен, чтобы обозначить разные степени предшествования, не могут справиться с одним-единственным прошедшим временем в английском или испанском и говорят что-то вроде: «он идет вчера».
Или взять амазонское племя, чей язык требует от своих носителей определять эпистемологический статус событий с такой степенью тщательности, какая заставила бы заикаться от изумления даже самого находчивого адвоката. Те же самые люди, пытаясь говорить по-испански или по-английски, были способны использовать только самый примитивный язык, казавшийся нечленораздельным бормотанием.
Цвет, пространство и принадлежность
Вернемся к проблеме именования цвета. У света есть физические характеристики, у человеческого зрения — определенные физиологические ограничения, а между ними располагается наше восприятие. Казалось бы, остается лишь договориться, как называть разные участки цветового пространства. Но даже здесь все оказывается сложнее.
Видимый спектр непрерывен, а словарь цвета дискретен. Мы различаем множество оттенков, однако повседневная речь делит их на сравнительно небольшое число категорий. Границы между ними не всегда очевидны: самый понятный русскому человеку пример это «голубой» и «синий». «Light blue» в английском не совпадает семантически с «голубым» (при этом в ряде других европейских языков, от итальянского до польского, свое слово для «голубого» есть).
Различия между языками в этом плане не произвольны, но и не связаны с каким-то «национальным духом». Исследования Брента Берлина и Пола Кея, начатые в 1960-х годах, обнаружили устойчивые закономерности в том, как языки формируют основные цветовые категории. Более поздние работы уточнили эту картину: универсальные особенности человеческого зрения взаимодействуют с культурными различиями и потребностями коммуникации.
Это закопало гипотезу Сепира-Уорфа (в жестком ее варианте) окончательно. Люди, в языке которых нет отдельного слова для определенного оттенка, не «неспособны» его различать. Способность различать два цвета и привычка обозначать их разными словами — разные вещи. Вместе с тем язык, несомненно, способен влиять на то, как быстро мы проводим границу между категориями и какие различия используем в задачах классификации.
Для технического читателя здесь возникает знакомая проблема классификации данных. Непрерывное пространство (массив) приходится разбивать на классы, хотя границы классов не всегда заданы самой природой однозначно. Но цветовые категории в человеческом восприятии одновременно и отражают особенности мира и влияют на то, как именно мы его воспринимаем. Это не просто «сетка», которую можно просто взять и наложить на что-то.
Далее к ориентации в пространстве. В большинстве знакомых нам ситуаций мы используем эгоцентрические координаты: предмет находится справа или слева от нас, впереди или позади. Такая система удобна, поскольку отсчет ведется от тела наблюдателя. Повернулся — и правая сторона комнаты стала левой, хотя сами предметы остались на месте.
Существуют, однако, языковые сообщества, в которых в повседневной речи гораздо активнее используются абсолютные направления — например, стороны света. Один из известных примеров, обсуждаемых Дойчером, — язык гугу-йимитир, на котором говорят в Австралии. В такой системе вместо привычного «чашка стоит слева от тебя» говорящий может описать расположение предмета через север, юг, восток или запад. Причем направление сохраняется независимо от того, куда повернут собеседник.
Означает ли это, что представители племени воспринимают пространство иначе? Или что у них нет такого понятия эго-как-центра-мира, как у нас?
Конечно, не означает. Речь лишь о том, какие координаты привычнее и удобнее использовать (например, если ты живешь на большой равнине, где направление движения солнца указать быстрее и очевиднее, чем возиться с какими-то относительно расположенными объектами) и какие сведения приходится удерживать, чтобы успешно коммуницировать.
В предыдущем разделе мы упоминали пример с наблюдением птицы, которое считается в одном языке грамматически правильным и полным, только если включает ее характеристики помимо таксономического наименования. В одних языках маркировка свойств и принадлежности выражена сильно, а в других (тех, что лучше знакомы нам) отсутствуют или устроены иначе.
В английском говорящий может сказать I broke the vase — «я разбил вазу» — указав на действующее лицо. Но при необходимости (например, если ему стыдно) он может построить фразу иначе (the vase was broken — «ваза разбилась», типа сама) и не обозначать исполнителя действия. В других языках определенные грамматические конструкции делают одни типы информации более обязательными, чем другие.
Если привычные для говорящего правила языка требуют регулярно отмечать время, число, род или пространственное отношение, говорящий чаще сталкивается с необходимостью выбирать соответствующую категорию. Если такого требования нет, часть информации можно оставить невыраженной — и это не делает высказывание неправильным.
Короче, если человек годами использует язык, который требует регулярно отмечать определенные характеристики события, эти характеристики могут стать для него более доступными в повседневных задачах. Но это не означает, что он не способен освоить другую систему категорий, выучить новый язык или осознать понятие, для которого раньше не было привычного слова.
Итак, если язык влияет на мышление, пусть и не в жестком смысле, значит ли это, что его устройство само по себе можно вывести из устройства мира или сознания? Или, напротив, язык обладает собственной организацией, которую следует описывать независимо от конкретных мыслей и ситуаций употребления?
Вопрос ведет к следующему крупному повороту в истории лингвистики. В середине XX века Ноам Хомский предложил рассматривать язык как формальную систему, способную порождать бесконечное множество предложений из конечного набора средств. Если у Сепира, Уорфа и Дойчера нас интересует, как язык участвует в организации опыта, то у Хомского на первый план выходит другой вопрос: какие правила позволяют человеку производить и понимать предложения, которых он никогда прежде не слышал?
Язык как порождающая система
В середине XX века лингвистика столкнулась с задачей, которая сегодня показалась бы знакомой (и наверняка (обманчиво) простой) специалисту по теории вычислений.
Человек знает сравнительно ограниченное количество слов и грамматических конструкций — но при этом способен строить и понимать огромное количество предложений, включая те, слова в которых никогда прежде не слышал и не знает, что они означают. Как это получается?
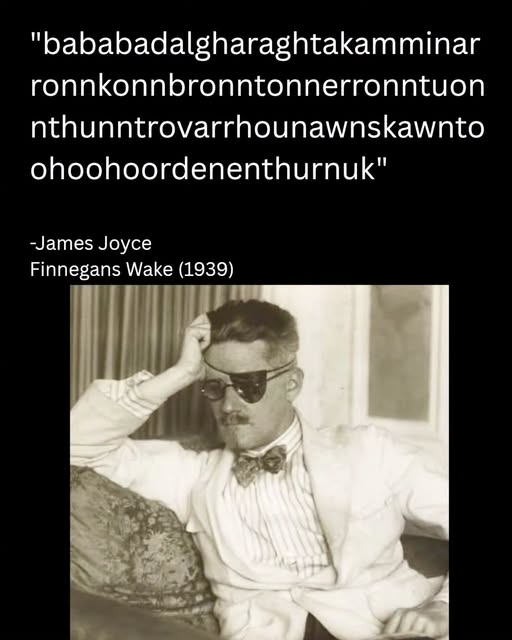
Причем новые предложения, которые строит носитель языка, могут содержать вложенные конструкции, уточнения, цитаты и другие элементы, потенциально увеличивающие сложность высказывания почти без ограничения, кроме, собственно, когнитивных способностей воспринимающего мозга. Можно условно оценить один предел такой способности в 1 финнеган, в честь романа Джеймса Джойса Finnegans Wake, целиком состоящего из словесных каламбуров на уровне корней, приставок и фонетики с использованием слов из 61 языка.
В поисках решения этой проблемы в 1957 году американский лингвист Ноам Хомский опубликовал книгу Syntactic Structures («Синтаксические структуры»), ставшую одним из важнейших текстов современной лингвистики.
Его проект заключался в том, чтобы описывать грамматику как формальную систему, которая в силу своего устройства позволяет порождать произвольные языковые конструкции по определенному набору правил и паттернов.
Допустим, что нам дано множество грамматически правильных предложений английского языка. Спрашивается, «какого рода механизм может порождать это множество (другими словами, какого рода теория дает адекватное описание структуры этого множества высказываний). Мы можем представлять себе каждое предложение этого множества как последовательность фонем конечной длины. Язык — необычайно запутанная система, и совершенно очевидно, что любая попытка представить непосредственным образом множество грамматически правильных последовательностей фонем привела бы к грамматике столь сложной, что практически она стала бы бесполезной. По этой причине (существуют и другие причины) для лингвистического описания используется система «уровней представления». Вместо того чтобы устанавливать фонемную структуру предложений непосредственно, лингвист исходит из элементов «более высокого уровня»— морфем; затем он отдельно устанавливает морфемную структуру предложений и фонемную структуру морфем. Легко понять, что совокупное описание этих двух уровней значительно проще непосредственного описания фонемной структуры предложений.
Рассмотрим теперь различные способы описания морфемной структуры предложений. Какого рода грамматика необходима для порождения всех последовательностей морфем (или слов), представляющих собой грамматически правильные английские предложения, и только такие последовательности?
Одно из требований, предъявляемых грамматике, состоит в том, что она должна быть конечной. Отсюда следует, что грамматика не может быть просто списком всех последовательностей морфем или слов, поскольку число их бесконечно. Обычная теоретико-коммуникационная модель языка предоставляет нам один из способов, которым мы можем воспользоваться, чтобы обойти эту трудность. Предположим, мы имеем машину, способную принимать одно из конечного числа различных внутренних состояний, и пусть эта машина при переходе из одного состояния в другое вырабатывает определенный символ (скажем, английское слово). Одно из этих состояний является начальным, некоторое другое — конечным.
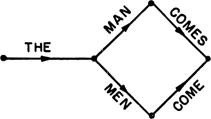
Допустим, машина начинает свою работу с начального состояния, проходит ряд промежуточных состояний (выдавая некоторый символ при каждой смене состояний) и оканчивает работу конечным состоянием. Порожденную таким способом последовательность слов назовем «предложением». Каждая подобная машина, таким образом, определяет какой-то язык, а именно — множество предложений, создаваемых с ее помощью. Всякий язык, который может быть порожден машиной такого рода, мы назовем языком с конечным числом состояний; самую машину мы можем назвать грамматикой с конечным числом состояний. Грамматику с конечным числом состояний можно представить в виде «диаграммы состояний».
Например, грамматика, порождающая равно два предложения — The man comes «Человек приходит» и The men come «Люди приходят»,— может быть представлена следующей диаграммой состояний:
Формальная грамматика работает следующим образом. В ней задаются правила, описывающие, как элементы одного типа могут объединяться в элементы другого типа. Например, предложение можно представить как сочетание именной и глагольной групп, а именную группу — как существительное с определениями. Глагольная группа, в свою очередь, может содержать глагол, дополнение и обстоятельства.
Схематически это можно записать так:
-
предложение → именная группа + глагольная группа;
-
именная группа → определение + существительное;
-
глагольная группа → глагол + именная группа.
Реальные грамматики значительно сложнее: они учитывают согласование, порядок слов, типы конструкций и множество других ограничений. Но уже в базовой схеме Хомского видна главная идея, несомненно, знакомая технарю: правила описывают не отдельные готовые предложения, а способы построения более крупных структур из мелких.
Если правила допускают вложенность, система способна производить конструкции, длина которых заранее не ограничена фиксированным списком. Можно сказать: «Человек прочитал книгу». Затем добавить уточнение: «Человек, которого я встретил вчера, прочитал книгу». Внутри этого предложения можно разместить еще одно: «Человек, которого я встретил вчера, прочитал книгу, которую ты мне рекомендовал». И так далее.
Именно способность к рекурсивному построению конструкций делает конечную систему правил потенциально продуктивной. Не нужно заранее хранить каждое возможное предложение, достаточно описать механизмы, которые позволяют строить новые структуры. Это как компилятор, который не содержит готового машинного кода для каждой программы, которую когда-либо напишет разработчик. Он использует правила синтаксиса и алгоритмы обработки, позволяющие разбирать новые исходные тексты.
Правда, тут сходство и заканчивается. Как именно реальные люди, дети, обучаются пользоваться языком, не зная всех этих правил сознательно? То есть, чуть более формально — какая система языкового знания позволяет говорящему создавать и понимать новые предложения?
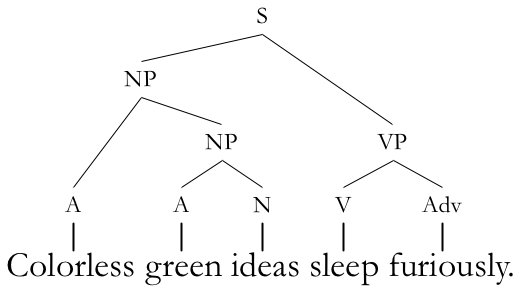
Самый известный пример Хомского, из этой самой книги — предложение Colorless green ideas sleep furiously, обычно переводимое как «Бесцветные зеленые идеи яростно спят».
Идеи не бывают зелеными, бесцветными и не спят в буквальном смысле. Но английский язык позволяет построить такую последовательность слов в соответствии с привычными синтаксическими правилами, и предложение нормально читается и даже как-то визуализируется, что делает возможным, например, сюрреалистическое искусство (а также, возможно, образы, приходящие к нам в сновидениях, но это уже тема для совсем другой статьи).
Сравним ее с другой последовательностью: Furiously sleep ideas green colorless. Здесь слова расположены так, что конструкция нарушает обычный английский синтаксис, и предложение для носителя языка ощущается как «неправильное», хотя и первое, и второе одинаково семантически бессмысленны. Очевидно, оба предложения до придумавшего их Хомского никогда никем не произносились вслух (по крайней мере, вероятность этого исчезающе мала) — и все-таки каким-то образом мы безошибочно способны оценить их структуру.
Таким нехитрым образом Хомский продемонстрировал революционную вещь: для обучения языку синтаксис важнее семантики, более того, он как будто первичен (в русском языке и других, где порядок слов не фиксирован, как в английском, это может быть менее очевидно, но понятно, что принцип сохраняется для любого языка, просто по-разному).
Генеративная грамматика стала частью более широкого поворота в науке о человеке: от попыток объяснить поведение через внешние стимулы и усвоенные реакции — к изучению внутренних когнитивных механизмов.
В 1959 году Хомский опубликовал влиятельную критическую рецензию на книгу психолога Берреса Фредерика Скиннера Verbal Behavior. Скиннер пытался объяснить речевое поведение в рамках бихевиоризма, уделяя особое внимание стимулам, истории подкрепления и условиям обучения.
Хомский возражал, что такого описания недостаточно для объяснения продуктивности языка: говорящие способны создавать новые высказывания и понимать конструкции, которые нельзя свести к простому повторению ранее подкрепленных реакций. Человек может оговориться, забыть слово, начать фразу и не закончить ее. Такие сбои не означают, что он не знает грамматики. И наоборот, человек способен повторить предложение, не понимая его структуры.
Хомского интересовала именно языковая компетенция — знание, позволяющее строить и интерпретировать конструкции, — в отличие от реального исполнения, на которое влияют память, внимание и обстоятельства.
Опять же, тут можно провести аналогию с программированием, так как это различие напоминает разницу между алгоритмом и конкретным запуском программы. Ошибка во время выполнения не обязательно свидетельствует о дефекте самой спецификации, а успешное выполнение одного примера еще не доказывает, что система правильно обобщает правило. Аналогия полезна, но, опять же, не следует понимать ее буквально: человеческая языковая компетенция не является готовым исходным кодом, который можно просто извлечь из мозга.
В последующих работах Хомский развивал представление о внутреннем языке — системе, реализованной в индивидуальном когнитивном устройстве человека. Самой спорной (и самой влиятельной) его идеей стало то, что человек рождается с каким-то базовым набором правил понимания языка (или машинным прото-языком, который позволяет собрать возможность понимания этих правил).
Доступный ребенку языковой материал ограничен. Речь взрослых неполна, содержит оговорки и незаконченные предложения. Ребенок не слышит всех возможных конструкций языка и не получает прямого объяснения всех случаев, которые впоследствии способен понимать. Тем не менее, он усваивает систему, позволяющую создавать новые предложения, и способен это сделать даже без формального школьного обучения языку (как, собственно, и было многие тысячелетия).
Для Хомского это стало основанием поставить вопрос о том, какие предварительные ограничения должны быть заложены в человеческую способность к усвоению языка. Если ребенок не выводит грамматику исключительно из готового набора правил, то, возможно, сама структура человеческого познания делает одни обобщения доступными, а другие — маловероятными.
Но если человеческий мозг действительно обладает особыми механизмами, позволяющими осваивать язык, то как они возникли? Является ли язык результатом длительной культурной эволюции, специфической адаптацией человеческого вида или сочетанием этих процессов?
На этот вопрос уже попытался ответить Стивен Пинкер. В книге «Языковой инстинкт» он популяризировал мысль о языке как биологически обусловленной человеческой способности и попытался пойти дальше Хомского, связав теоретическую лингвистику с эволюцией и психологией, чтобы понять — почему у человеческого вида вообще возникла способность так быстро и гибко осваивать сложную систему общения?
Инстинкт языка
Представим двух детей. Первый растет в семье, где взрослые регулярно объясняют ему устройство языка: показывают схемы предложений, разбирают части речи, поправляют каждую грамматическую ошибку и постепенно вводят все более сложные правила. Второй просто живет среди людей, которые разговаривают, спорят, шутят, рассказывают истории и просят его что-нибудь сделать. При прочих равных второй освоит родной язык точно так же — причем без необходимости сначала понять, что такое подлежащее, сказуемое и придаточное предложение. Возможно, его речь будет более грубоватой по сравнению с другим, получившим формальное образование, но это будет именно речь, такая же, сказуемое не станет определением и наоборот.
Английский, русский, китайский или японский не записаны в генах. Но человеческий организм, согласно концепции Пинкера (в которой нетрудно увидеть развитие идей Хомского), обладает специализированными когнитивными предпосылками, благодаря которым язык возникает и усваивается с необычайной легкостью. В генеративной традиции проблема часто обсуждалась через аргумент о недостаточности доступных ребенку языковых данных. В упрощенном виде он выглядит так: ребенок осваивает больше, чем ему явно сообщают, поэтому исходные данные должны интерпретироваться при помощи некоторой предварительной структуры.
Тут же возникает сложный методологический вопрос: насколько беден входной материал на самом деле, если учитывать не только предложения, которые ребенок слышит, но и контекст, повторение, реакции взрослых, общие знания о мире и способность наблюдать за действиями окружающих? Становится интересно, каким образом и для чего такой широкий контекст, помогающий обучению, задается растущему мозгу изначально, чтобы он обучился именно языку (это то, что принципиально отличает нас от животных, даже высших обезьян — и да, от ChatGPT тоже).
Пинкер, опираясь на эволюционную перспективу, рассматривал язык как адаптацию, связанную с человеческой коммуникацией. Эта идея привлекательна и может даже казаться очевидной и банальной, ведь способность передавать информацию, координировать действия, делиться знаниями и поддерживать сложные социальные связи могла давать существенные преимущества. Но наличие преимуществ не доказывает (как и в случае с непосредственно биологическим естественным отбором, правила отбора на уровне базовой единицы могут быть неочевидными), что каждая особенность языка возникла в результате прямого естественного отбора именно для коммуникации.
Некоторые способности могли появиться как побочные эффекты других изменений, а культурная эволюция языков могла существенно влиять на то, какие структуры сохраняются и распространяются.
Я могу наугад выбрать пример сложной лингвистической формы из языка неиндустриализованного общества. Лингвист Джоан Бреснан недавно написала статью, посвященную специально сравнению конструкции языка кивунджо из группы банту, на котором говорят в нескольких деревнях на склонах горы Килиманджаро в Танзании, с родственной ей конструкцией в английском, который она описывает как «язык западногерманской группы, на котором говорят в Англии и ее бывших колониях». Английская конструкция называется «дательный падеж», и ее можно встретить в предложениях типа She baked me a brownie ‘Она испекла мне шоколадное пирожное’ или He promised her Arpège ‘Он пообещал ей сыграть на рояле’, где косвенное дополнение, такое как me ‘мне’ и her ‘ей’ находится после глагола, чтобы указать на кого/на что направлено действие. Соответствующая конструкция в языке кивунджо называется «аппликатив», сходство которого с английским дательным Бреснан характеризует как «сходство шахмат с шашками».
Эта конструкция в кивунджо полностью умещается внутри глагола, который имеет семь приставок и суффиксов, два залога и четырнадцать времен; глагол согласуется и с подлежащим, и с дополнением, и с существительными, на которые направлено его действие, каждое из которых может быть шестнадцати родов. (В случае, если у вас возникает вопрос, эти «роды» не имеют ничего общего с трансвеститами, транссексуалами, гермафродитами, людьми андрогинного типа и иже с ними, как предположил один из читателей этой главы. Для лингвиста термин «род» сохраняет свое первоначальное значение «вид», как и в однокоренных словах «порода» и «народ».
«Роды» языков банту относятся к объектам типа людей, животных, предметов на расстоянии, групп предметов, частей тела. Просто случилось так, что во многих европейских языках «род» соответствует полу, по крайней мере, у местоимений. По этой причине лингвистический термин «род» стал активно использоваться нелингвистами как удобное обозначение сексуальной вариативности; а более точный термин sex теперь отводится для тех случаев, когда нужно деликатно выразиться о половых связях.) Среди других любопытных языковых инструментов, которые я заметил в грамматиках так называемых примитивных народов, особенно удобной кажется сложная система местоимений у чероки. В ней делается различие между «ты и я», «другой человек и я», «несколько других людей и я» и «вы, один или несколько других людей и я», что в английском просто-напросто свернуто в местоимение на все случаи жизни — we ‘мы’.
На самом деле люди, чьи лингвистические способности самым ужасным образом недооцениваются, принадлежат именно к нашему языковому сообществу. Лингвисты постоянно сталкиваются с мифом о том, что представители рабочего класса или менее образованных слоев среднего класса говорят на упрощенном или более грубом языке. Это — пагубное заблуждение, возникающее от неудачных попыток вести диалог. Повседневная речь, как и видение мира в цвете или ходьба, является набором чисто технических достижений — технологией, которая так прекрасно работает, что ее пользователь принимает результат как нечто само собой разумеющееся, не имея представления о сложном механизме, скрытом за панелями управления. За такими «простыми» предложениями, как Where did he go? ‘Куда он пошел?’ или The guy I met killed himself ‘Парень, с которым я познакомился, покончил с собой’, автоматически употребляемых любым носителем английского языка, стоят десятки скрытых подпрограмм, которые организуют слова для выражения смысла.
Вместе с тем, давайте помнить, что перед нами все еще метафора. Метафора языка как инстинкта не должна закрывать вопрос, который она помогает поставить. Наблюдение, что ребенок осваивает язык без учебника, само по себе не доказывает, что в его мозге присутствует готовая универсальная грамматика.
В итоге перед нами остаются три взаимосвязанные, но разные проблемы. Первая — структура языка: какие правила и ограничения позволяют строить предложения? Вторая — приобретение: как человек (ребенок) усваивает эти правила из неполного и изменчивого опыта? Третья — происхождение: как в эволюции человека возникли способности, которые делают такое обучение возможным?
Все три подхода, что были описаны выше, едва затрагивают подлинную суть проблемы. Ни один из этих подходов сам по себе не исчерпывает того, что происходит, когда люди используют слова в реальных обстоятельствах.
Мы можем описывать синтаксические правила, моделировать обучение и искать биологические предпосылки. Однако остается вопрос: достаточно ли этого, чтобы объяснить значение? Что значит не просто построить правильное предложение, а понять его, следовать правилу в новой ситуации, распознать просьбу, иронию или намек?
Этим вопросом занимался сын сталелитейного магната, математик, философ и один из самых странных (и влиятельных) мыслителей XX века — Людвиг Витгенштейн.
Значение, правило, ощущение
В 1953 году, через два года после смерти Людвига Витгенштейна, вышли «Философские исследования» — книга, которая изменила способ постановки вопросов о языке, значении и мышлении. Причем Людвиг сделал это уже второй раз, первый раз перевернув мир философии за тридцать лет до этого своим «Логико-философским трактатом» (сформировавшим так называемую аналитическую философию, которая до сего дня остается доминирующим течением в США и изрядной части Европы).
Если ранний Витгенштейн из «Логико-философского трактата» пытался установить логические границы осмысленного высказывания, то поздний обращается к повседневному употреблению слов, обучению, следованию правилам и разнообразию человеческих практик (формализовано академически это направление было как философия обыденного языка).
О чем идет речь? Мы склонны представлять значение слова как нечто, что существует отдельно от самого слова: предмет, понятие, образ или определенная запись в уме, с которой слово связывается. Тогда понимание выглядит как успешный поиск соответствия. Услышал слово — активировал нужное представление — получил значение. Если система достаточно хорошо выучила эти соответствия, кажется, что проблема решена.
В некоторых случаях такая модель работает. Слово «термометр» обозначает определенный тип прибора, а техническое описание позволяет уточнить, что именно мы называем термометром. Но далеко не каждое слово работает как название предмета. Слова «если», «потому что», «можно», «обещаю», «больно» или «справедливо» нельзя понять, просто указав на соответствующий объект. Даже названия конкретных вещей усваиваются не так механически, как предполагает идея прямого соответствия между словом и предметом.
Поздний Витгенштейн, несомненно, под влиянием преподавания в школе в поздние годы, предлагает отойти от придуманных им же абстрактных формальных моделей и посмотреть непосредственно на то, как слово функционирует в человеческой жизни. Что делают люди, когда употребляют его? Как они учатся использовать его правильно? В каких обстоятельствах применение слова уместно, а в каких вызывает недоумение или требует исправления? Какие действия, реакции и ожидания связаны с его употреблением?
В «Голубой книге», заметках, предшествовавших «Философским исследованиям», он предлагает мысленно назвать карандаш выдуманным словом tove. Мы показываем на карандаш и говорим: «Это tove». Но что именно мы объяснили? Что предмет деревянный? Что он твердый? Что это карандаш? Что он один? Или что он имеет определенную форму?
ФИ 138. Но разве значение слова, которое я понимаю, не может соответствовать смыслу предложения, который я тоже понимаю? Или значение одного слова соответствует значению другого? – Конечно, если значение есть употребление слова, не имеет смысла рассуждать о каком бы то ни было «соответствии». Но мы понимаем значение слова, когда слышим его или произносим; мы улавливаем значение мгновенно, и то, что мы схватываем таким образом, должно безусловно как-то отличаться от «употребления», которое развернуто во времени. Должен ли я знать, что понимаю слово? Разве порой мне не кажется, что я понимаю слово (как могу понимать некое вычисление), а затем сознаю, что на самом деле не понял? («Я думал, будто знаю, что означают “относительное” и “абсолютное” движение, но теперь вижу, что это не так».)
Чтобы понять, какое объяснение имелось в виду, человеку уже нужны некоторые представления о языке и ситуации. Сам жест не содержит готовой инструкции, однозначно определяющей значение нового слова. В зависимости от обстоятельств и того, чему человека уже научили, он может интерпретировать одно и то же указание по-разному.
Ребенок постепенно учится различать, когда взрослый называет предмет, когда просит его передать, когда спрашивает о цвете, а когда указывает на количество. Он наблюдает за тем, как люди обращаются с вещами, сопоставляет ситуации, пробует употреблять слова и получает обратную связь. Со временем он осваивает способы использовать слова в разнообразных обстоятельствах.
В «Философских исследованиях» Витгенштейн вводит понятие языковой игры (сегодня это стало расхожим выражением), имея в виду разнообразие ситуаций, в которых люди используют слова и действия, связанные с ними.
Можно отдавать приказы, задавать вопросы, описывать предметы, рассказывать истории, благодарить, шутить, спорить, считать, обещать и договариваться. Во всех этих случаях язык работает по-разному.
Возьмем фразу «Здесь холодно». В зависимости от обстоятельств она может быть сообщением о температуре, жалобой, предупреждением или косвенной просьбой закрыть окно. Сами слова не меняются, но собеседник интерпретирует их с учетом ситуации, отношений между участниками и того, что обычно происходит в подобных обстоятельствах.
Можно формально описать синтаксис фразы, значения отдельных слов и даже вероятные продолжения разговора. Все это полезно. Но если мы хотим объяснить, почему в конкретной ситуации человек воспринимает фразу как просьбу, нам приходится учитывать контекст, ожидания и социальные нормы. Грамматическая структура предложения сама по себе не содержит полной инструкции по его употреблению, имеют значение также внеязыковые факторы (если мы только не воспринимаем как язык весь мир целиком, следуя за французскими постструктуралистами 1960-х).
Самая интересная часть «Философских исследований» для технической аудитории — обсуждение следования правилу.
В §§138–242 Витгенштейн разбирает, что значит понимать выражение, интерпретировать его и применять в соответствии с правилом. Этот фрагмент породил огромную философскую дискуссию, включая влиятельную интерпретацию Сола Крипке. Но основной вопрос можно поставить без погружения в тонкости академического спора. Допустим, ученику объяснили правило сложения и попросили продолжить ряд:
2, 4, 6, 8, 10…Ожидаемое продолжение очевидно: 12, 14, 16.
Но что именно ученик усвоил? Может быть, он запомнил несколько знакомых примеров и продолжает ряд по аналогии. Может быть, он понял правило «прибавляй два». А может, он применяет совершенно другую процедуру, которая случайно дает правильные ответы на первых шагах.
Пока мы видим только несколько совпадений, различить эти варианты трудно. Система, которая продолжает ряд правильно в знакомых условиях, еще не обязательно продемонстрировала, что умеет применять правило в более широком диапазоне случаев. Немного напоминает «черный ящик» обучения «ИИ», правда?
Предположим, теперь ученик получает последовательность из больших чисел, отрицательных значений или дробей. Если он продолжает действовать корректно, у нас появляется больше оснований считать, что он усвоил соответствующую операцию. Если же он каждый раз возвращается к знакомому образцу и терпит неудачу при изменении условий, мы пересматриваем первоначальную оценку.
Но даже здесь нельзя просто найти еще один пример, который окончательно докажет, что человек понимает правило. Можно придумывать все новые проверки, расширять набор задач и искать неожиданные случаи. Вопрос в том, какие основания позволяют считать поведение человека устойчивым применением правила, а не совпадением с ограниченным набором образцов.
Вопрос, который Витгенштейн исследует в ФИ, заключается в том, что делает такое различение возможным и почему правило нельзя представить как некую формулу, которая сама по себе заранее определяет каждое будущее действие.
Если для понимания правила требуется интерпретация, то возникает следующий вопрос: как мы понимаем эту интерпретацию? Если для нее нужно еще одно правило, то как мы применяем его? Попытка объяснить каждое применение дополнительным объяснением порождает бесконечный регресс. В какой-то момент человек просто научается действовать определенным образом — в процессе обучения, исправления ошибок и участия в практике, где существуют устойчивые критерии правильности.
И мы никогда не можем выделить конкретный момент, когда это произошло
ФИ 157. Рассмотрим следующий случай. Люди или существа какого-либо иного вида применяются нами в качестве считывающих устройств. Их обучают для этой цели. Обучающий говорит относительно некоторых, что они уже могут читать, а относительно других – что они еще не в состоянии это делать. Возьмем ученика, который до сих пор не принимал участия в обучении: если ему показать написанное слово, он произнесет тот или иной звук, и в определенной ситуации этот звук «случайно» окажется примерно правильным. Некто третий слышит этого ученика и говорит: «Он читает». Но обучающий возражает: «Нет, он не читает; это просто случайность». – Но предположим, что этот ученик и далее правильно реагирует на слова, которые ему показывают. Через некоторое время обучающий говорит: «Теперь он может читать!» – Но что насчет того первого слова? Скажет ли обучающий: «Я был неправ, и он действительно его прочел» – или: «Он начал читать позже»? – Когда ученик начал читать? Какое первое слово он прочел?
Этот вопрос здесь не имеет смысла. Если только мы не дадим определение: «Первое слово, которое некто «прочитывает», есть первое слово в первой последовательности из 10 слов, которые он прочел правильно» (или что-то вроде этого).
Если, с другой стороны, мы обозначаем словом «чтение» некий опыт перехода от письменного знака к произносимому звуку, тогда безусловно имеет смысл говорить о первом слове, которое он на самом деле прочел. Он может сказать, например: «На этом слове у меня впервые возникло чувство: “Теперь я читаю”».
Или снова, в отличном случае считывающего устройства, которое переводит знаки в звуки, наподобие пианолы, возможно сказать: «Машина читает лишь после того, как с ней произошло то-то и то-то – после того, как такие-то и такие-то ее части были соединены проводами; и первым словом, которое она прочитало, было…».
Но в случае живого считывающего устройства «чтение» означает реагирование на письменные знаки таким-то и таким-то способом. Это понятие потому совершенно независимо от понятия умственных или прочих механизмов. – И при этом обучающий не может тут сказать об ученике: «Возможно, он уже умел читал, когда произнес то слово». Ведь не приходится сомневаться, что он и вправду умел. – Перемена, случившаяся, когда ученик начал читать, есть перемена в поведении; и нет смысла здесь рассуждать о «первом слове в новом состоянии».
Еще одна известная тема «Философских исследований» — аргумент против возможности частного языка. Его порой пересказывают как утверждение, будто Витгенштейн отрицал существование внутренних переживаний или считал, что мысли возможны только в присутствии других людей. Это неверно.
В §243 философ рассматривает особую идею языка, слова которого обозначают исключительно частные ощущения, доступные только самому говорящему.
Скрытый текст
243. Человек может поощрить себя, отдавать себе приказы, подчиняться, обвинять и наказать себя; может задавать себе вопросы и отвечать на них. Можно даже представить людей, которые говорят исключительно монологом; которые сопровождают свои действия разговорами с собой. – Исследователь, наблюдающий за ними и слушающий их беседы, мог бы перевести их язык на наш. (Это позволило бы ему правильно предсказывать действия этих людей, ведь он также слышит, как они принимают решения.)
Но возможно ли представить язык, на котором человек может записать или выразить вслух свой внутренний опыт – чувства, настроения и прочее – для личного пользования? Что ж, разве нельзя передать все это нашим обычным языком? – Но это не то, что я имею в виду. Отдельные слова этого языка должны обозначать то, что известно лишь самому человеку, его личные, приватные ощущения. Значит, никто другой не сможет понять этот язык.
Витгенштейн оспаривает представление, будто значение может быть полностью определено внутренним актом, который в принципе не связан ни с какими публично доступными критериями. Это особенно важно для слов, обозначающих ощущения. Когда ребенок учится говорить «мне больно», ему не требуется сначала найти внутренний объект и прикрепить к нему название. Он осваивает выражение в человеческих обстоятельствах: через собственные реакции, действия окружающих, способы утешения и ситуации, в которых слова о боли имеют смысл.
Разумеется, переживание боли не становится публичным только потому, что у нас есть слово для его обозначения. Другой человек не получает непосредственного доступа к чужому ощущению. Но из этого не следует, что значение слова «боль» определяется исключительно личным внутренним актом.
Мы осваиваем и используем это слово в общей человеческой практике, где существуют узнаваемые ситуации, выражения и способы реагировать на чужое состояние.
ФИ 244. Как слова соотносятся с ощущениями? – Тут как будто нет никакого затруднения; разве мы не говорим об ощущениях каждый день, не даем им имена? Но как устанавливается связь между именем и именуемым? Этот вопрос сходен со следующим: как человек выучивает значение имен ощущений? – Слова «боль», например? Вот одна возможность: слова связаны с изначальными, естественными выражениями ощущений и употребляются вместо них. Ребенок причиняет себе боль и плачет; затем взрослые говорят с ним, учат его восклицаниям и, позднее, предложениям. Они учат ребенка новому поведению при боли.
«Ты говоришь, что слово “боль” на самом деле означает “плач”?» – Напротив: словесное выражение боли заменяет плач и не описывает его.
245. И как я могу зайти настолько далеко, чтобы попытаться поместить язык между болью и ее выражением?
246. В каком смысле мои ощущения являются личными? – Что ж, только мне ведомо, вправду ли я испытываю боль; другой человек может это лишь предполагать. – В одном отношении это неверно, а в другом и вовсе нонсенс. Если мы употребляем слово «знать», как оно обычно употребляется (а как еще его можно употреблять?), тогда другие очень часто знают, когда я страдаю от боли. – Да, но все равно они лишены той убежденности, какая свойственна в этом случае мне! – Обо мне нельзя сказать в целом (разве что в шутку), будто я знаю, что страдаю от боли. И что это должно значить – исключая, быть может, то, что мне больно?
О других нельзя сказать, что они учатся узнавать мои ощущения только из моего поведения – ведь нельзя говорить, что я знаю о них. У меня они просто есть.
Правда такова: имеет смысл говорить о других, что они сомневаются, больно ли мне; но обо мне это говорить бессмысленно.
247. «Тебе одному ведомо, было ли у тебя такое намерение». Можно сказать так кому-то, объясняя значение слова «намерение». Ведь это означает: именно так мы употребляем это слово.
(И здесь «знать» означает, что выражение неуверенности лишено смысла.)
Витгенштейн помогает точнее поставить вопрос о том, что именно мы считаем пониманием. Вместо спора о том, есть ли у системы некая невидимая сущность под названием «смысл», можно исследовать ее реальные способности: как она применяет выражения, реагирует на исправления, переносит навыки в новые обстоятельства и участвует в сложных практиках.
Теперь самое время вернуться к большим языковым моделям. Они демонстрируют, что система, обученная на огромном количестве текстов, способна производить высказывания, которые выглядят осмысленными, и решать множество задач, требующих работы с языком. Это безусловно серьезное достижение.
Но если значение нельзя полностью свести к соответствию слова и объекта, а следование правилу требует анализа устойчивого применения в различных обстоятельствах, то одного качества текста (которое, к тому же, на текущем этапе все еще сомнительно) недостаточно, чтобы закрыть вопрос о понимании.
И тем более, конечно, чтобы называть нейронку ИИ.
Язык, который научился говорить сам с собой
В 2023 году Ноам Хомский вместе с лингвистом Иэном Робертсом и специалистом по искусственному интеллекту Джеффри Вотумуллом опубликовал в The New York Times эссе с провокационным названием The False Promise of ChatGPT — «Ложное обещание ChatGPT».
Ученые утверждали примерно те же самые очевидные вещи, что регулярно делает автор этой статьи — большие языковые модели, несмотря на впечатляющие результаты, не следует принимать за модели человеческого мышления. Хомский и компания противопоставляли машинное предсказание языковых последовательностей способности человека искать причинные объяснения, формулировать общие принципы и оценивать собственные выводы.
Большие языковые модели, безусловно, запустили интереснейший этап в истории науки о языке (и вообще в истории человеческой глупости способности к познанию). Они не разрешили спор между Хомским и Витгенштейном, не подтвердили теорию языкового инстинкта и не опровергли гипотезу лингвистической относительности. Зато они создали практическую ситуацию, в которой все эти вопросы можно поставить заново — и на кону уже не абстрактная философская правота, а реальные сотни тысяч рабочих мест и разрушенных жизней.
Напоминаем, как на самом деле устроено то, что маркетологи заставили нас называть «ИИ». Большие языковые модели обучаются на огромных массивах данных. В упрощенном виде их основная задача состоит в том, чтобы предсказывать следующий токен с учетом предыдущего контекста. Токеном может быть слово, часть слова, знак препинания или другой фрагмент последовательности. Модель получает текст, вычисляет распределение вероятностей для возможного продолжения и учится повышать вероятность подходящих ответов на обучающих примерах.
Конечно, не все так просто, и это не объясняет, почему ChatGPT вообще способен с высокой степенью имитации человеческого мышления (опустим комментарий об уровне этого мышления) писать программы, переводить между языками, объяснять научные концепции или решать математические задачи.
Чтобы правильно продолжить множество разных высказываний, модели приходится извлекать закономерности из контекста. Ей полезно учитывать синтаксические связи, значения выражений, отношения между сущностями, типичные структуры рассуждений и закономерности, характерные для разных областей знания. Внутренние представления обученной модели организуют информацию так, чтобы помогать решать задачу предсказания.
Архитектура Transformer, предложенная в 2017 году, стала важнейшей частью этого развития. Механизм внимания позволяет модели учитывать разные элементы контекста при обработке последовательности, а обучение на больших объемах текста дает возможность извлекать сложные статистические зависимости. В результате задача, формально заданная как предсказание токена, оказывается связана с гораздо более широким набором языковых и когнитивно значимых закономерностей.
Технари скажут, что ну вот же, полная имитация человеческого мышления, именно так все и устроено у нас в голове. Но это неправда. Мы не знаем, что каждая внутренняя структура модели соответствует отдельному человеческому понятию или что обучение обязательно создает у нее представления, тождественные человеческим.
То, что «ИИ-агенты» при «общении» между собой переходят на какой-то эзотерический язык (который, как гениально подметили там же в комментах на Хабре, вероятно, является просто упрощенным китайским из-за экономии токенов при переходе в формат иероглифов, типа как машинный перевод описаний товаров с AliExpress), показывает, что мы еще даже не подошли к правильной постановке вопроса.
Генеративная традиция Хомского стремилась объяснить человеческую языковую компетенцию, в том числе способность понимать и производить новые предложения. LLM создаются прежде всего как обучаемые вычислительные системы, способные решать широкий набор задач на основе закономерностей данных. Их цели, методы и критерии успеха не совпадают — разве что как структурная аналогия.
Можно ли сказать, что LLM поставили под сомнение одно из сильных интуитивных ожиданий генеративной традиции — будто для получения богатых языковых способностей необходимо заранее задать достаточно специфическую грамматическую структуру? Современные модели демонстрируют, что значительный набор языковых навыков может возникать из обучения на больших массивах текстов без явного кодирования человеком полной грамматики языка.
Или не демонстрируют? Наверное, теперь было бы логично заняться доказательством, какие именно языковые способности таким образом не удается получить, при каких условиях и почему. Никто этим заниматься, конечно, не будет.
Эпилог: о стохастических попугаях
В 2021 году исследовательницы Эмили Бендер, Тимнит Гебру, Анджелина Макмиллан-Мейджор и Маргарет Митчелл опубликовали остроумную статью On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? — «Об опасностях стохастических попугаев».
Авторы критиковали не только склонность языковых моделей воспроизводить закономерности обучающих данных, но и более широкую практику создания все более крупных систем такого рода без достаточного внимания к качеству данных, экологическим и финансовым издержкам, а также социальным последствиям их использования.
Метафора «стохастического попугая» быстро стала популярной, потому что выражает понятное опасение: модель может производить связную речь, не имея человеческого опыта того, о чем говорит. Она усваивает статистические отношения между фрагментами текста, но из этого не следует, что за каждым предложением стоит знание, сопоставимое со знанием человека.
Метафора попугая, конечно, тоже имеет пределы. Попугай повторяет услышанное, тогда как большая языковая модель может комбинировать усвоенные закономерности, переносить их на новые задачи и производить последовательности, которые не встречались в обучающих данных в готовом виде.
Теперь коварный вопрос: следует ли из того, что LLM это не попугай, то, что она реально Искусственный Интеллект, у которого есть агентность и мышление? Про которое разработчики переживают, что оно может страдать.
Конечно, не следует.
У Витгенштейна человек осваивает язык в мире, где предметы можно трогать, перемещать, терять и находить, где действия имеют последствия, а другие люди реагируют на наши слова. Даже абстрактные понятия усваиваются через образование, совместную деятельность, социальные нормы и практики, в которых они применяются.
У LLM нет такого человеческого пути обучения. Она получает последовательности символов и извлекает из них закономерности. Ее знания о чашках, реках, боли или обещаниях опосредованы текстовыми описаниями. Модель может усвоить, что чашки обычно держат за ручку, что реки текут в определенном направлении и что обещания предполагают обязательство перед другим человеком. Достаточно ли этого?
В философии и когнитивной науке данную проблему часто обсуждают через понятие заземления символов (symbol grounding). Если система оперирует символами, что делает их значения чем-то большим, чем связи между другими символами? В статье «The Symbol Grounding Problem» еще в 1990 году (!) когнитивный ученый Стеван Харнад сформулировал этот вопрос как проблему объяснения того, каким образом символы приобретают значение для самой системы, а не только для внешнего наблюдателя. (Harnad, 1990)
Ссылка на телесный опыт, однако, сама по себе еще не решает проблему (хотя в комментах на Хабре уверены, что если поместить «ИИ» в прыгающего китайского робота, то все решено). В когнитивной науке существует гипотеза embodied simulation: когда человек понимает высказывание о действии или предмете, он частично реактивирует сенсорные и двигательные представления, связанные с описываемой ситуацией. Читая о том, как кто-то забивает гвоздь молотком, мы можем задействовать представления о движении, форме предмета и взаимодействии с ним.
Исследования действительно обнаруживают подобные эффекты, однако из того, что сенсомоторные механизмы участвуют в обработке некоторых высказываний, еще не следует, что они сами по себе необходимы для любого понимания языка.
В статье Humans, LLMs, and the symbol grounding problem (2022) когнитивный ученый Шон Тротт обращает внимание именно на этот разрыв. Он различает слабую версию гипотезы, согласно которой телесная симуляция сопровождает некоторые процессы языковой обработки, и сильную, согласно которой без нее понимание невозможно. Как и в случае с гипотезой Сепира-Уорфа, к реальности в определенной степени применима только мягкая версия.
Между наблюдением за работой человеческого мозга и выводом о принципиальных возможностях искусственной системы лежит несколько самостоятельных исследовательских задач. Нужно выяснить, какие механизмы участвуют в понимании, какую роль они играют и можно ли получить сходные функциональные результаты другими способами. Иначе мы рискуем превратить предположение о человеческом познании в заранее установленный критерий, которому искусственная система обязана соответствовать независимо от того, как устроено ее обучение. И сейчас у нас, как писал автор этих строк, такого критерия буквально нет, ведь тест Тьюринга LLM проходит без проблем, оставаясь очевидным стохастическим попугаем.
В 2024 году на ту же тему вышла более подробная работа Do Multimodal Large Language Models and Humans Ground Language Similarly? в журнале Computational Linguistics. В ней рассматривается, насколько механизмы заземления у мультимодальных моделей могут быть сопоставимы с человеческими, в том числе с точки зрения гипотезы телесной симуляции.
Авторы подчеркивают, что интеграция языковой и других модальностей все еще остается недостаточно изученной. Подключение изображений, видео или взаимодействия со средой формально меняет ситуацию: модель получает информацию не только из текстовых описаний. Вместе с тем, мультимодальность еще не гарантирует, что разные типы данных интегрируются так же, как у человека, или, тем более, что у системы возникает человеческий тип понимания. Или хоть какое-то понимание вообще.
Если модель видит изображение чашки, это расширяет ее входные данные, но еще не означает, что она приобрела человеческий опыт обращения с чашками. Если робот поднимает предмет, это дает ему сенсомоторную обратную связь, но не доказывает наличия субъективного переживания.
Что же это за квалиа такое и каким образом оно отличает нас от «ИИ»? Ответа нет, но, согласитесь, трудно спорить с тем, что это мы создали LLM, а не они нас, и как минимум странно галлюцинировать, фантазируя, что мы сделали «искусственное сознание», которое нас заменит — когда на самом деле мы даже не понимаем пока, как устроено наше собственное.
ссылка на оригинал статьи https://habr.com/ru/articles/1097508/