Привет, Хабр! Это Кирилл Попов, руководитель команды проекта Tracer, и Маргарита Скокова, инженер мобильных приложений Android в Одноклассниках. Ещё год назад мы называли Tracer комплексной платформой для сбора и анализа ошибок мобильных и веб-приложений. О том, как всё начиналось и развивалось, можно прочитать в статьях 2023, 2024, 2025 годов и в январской новости. В 2026 году Tracer стал observability-платформой.
В этой статье мы расскажем, что нового в Tracer вы можете использовать для разбора проблем на релизе, сбоев у пользователей и упрощения рутины. Эти инструменты открываются по запросу — будем рады пригласить вас на ранний доступ, чтобы вы попробовали новые функции раньше официального релиза.
Решаем задачу «Ничего не работает»
Представим сценарий: поддержка приходит с жалобой от пользователя: «Приложение не грузит, невозможно пользоваться». Информации меньше некуда, время бежит, алерты молчат, а недовольство пользователя растёт. Приступаем к разбору проблемы.
Дано: атрибуты сессии и пользователя и название ошибки.
Решение: используем имеющиеся данные и объединённые в Tracer инструменты для выяснения настоящей причины сбоя.
Tracer становится вашей доской расследования — как у настоящих детективов, только вместо лупы и улик — трейсы, логи и OTLP-спаны.
В Tracer уже готова инфраструктура для сбора, хранения и анализа телеметрии. Логовница — агрегатор логов — хранит передаваемые по протоколу OTLP данные. Логи можно просматривать прямо в интерфейсе, искать, фильтровать и смотреть на графиках.
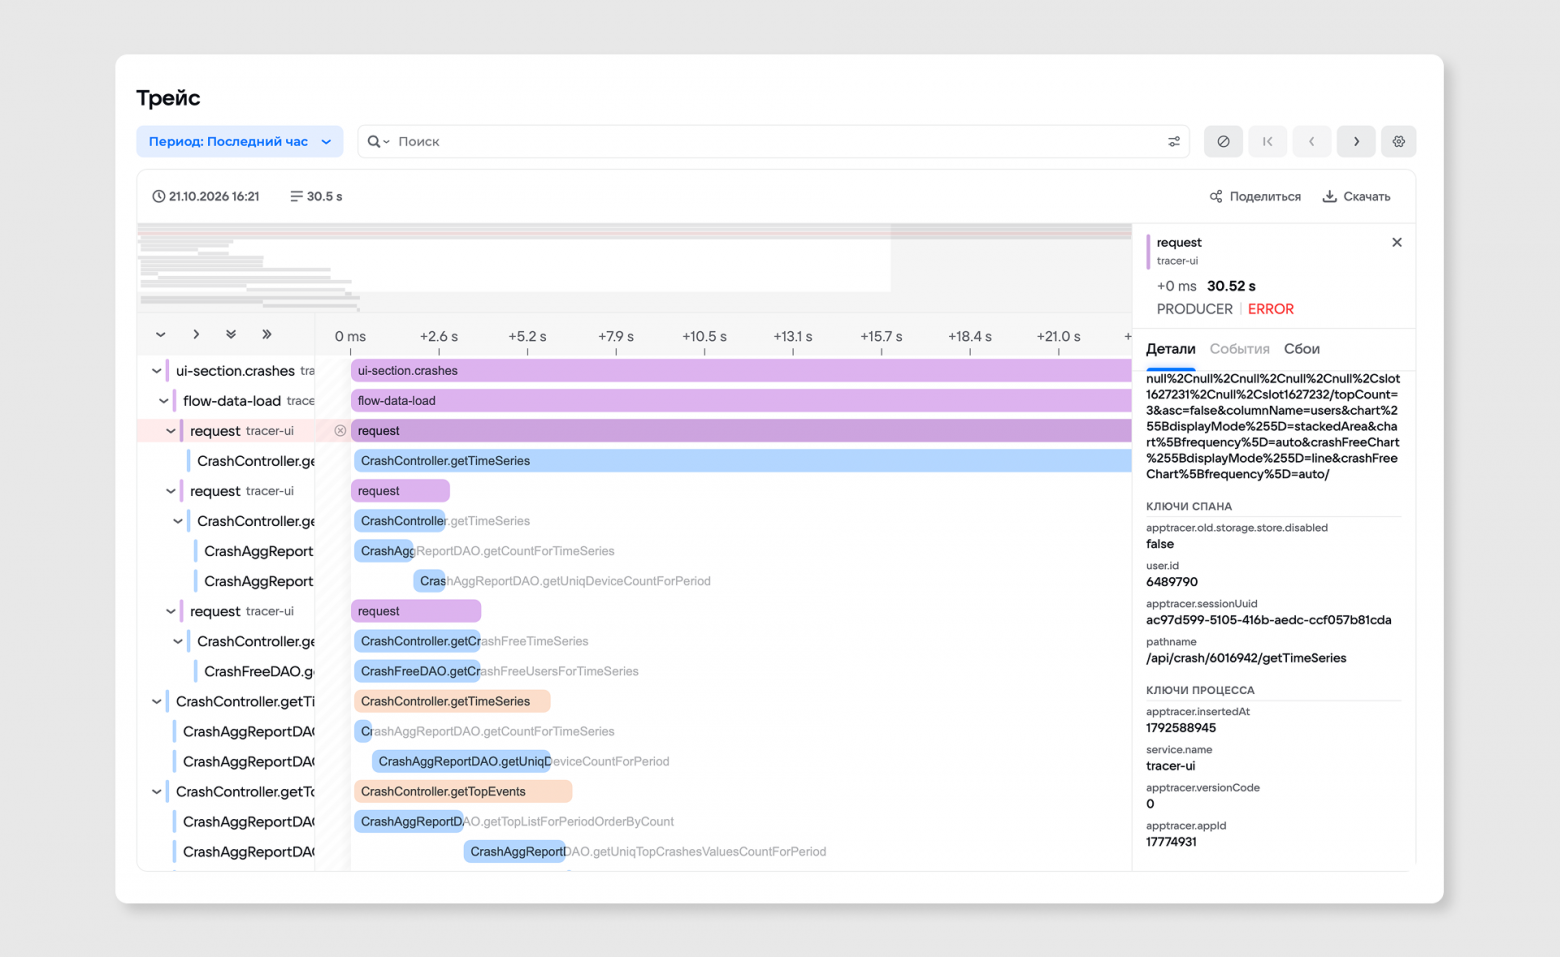
На странице телеметрии для поиска трейсов используем TQL — собственный язык запросов для фильтрации и выборки сбоев и логов в Tracer. Заходим в найденный трейс — и перед нами открывается арсенал инструментов:
-
просмотр автоматически прикреплённых к трейсу логов, поиск по их содержимому
-
просмотр времени выполнения спанов и их атрибутов
-
поиск по спанам с ошибками и предупреждениями
-
подсветка спанов с ошибками, переход на страницу привязанной ошибки
-
автоматическое превращение спана в метрики, что позволяет сразу видеть агрегированную картину производительности без дополнительной настройки
-
переход к спану из сбоя по прикреплённой ссылке
Для продвинутых детективов пригодятся такие инструменты:
-
Двусторонняя связь ошибки и сессии: можно воспроизвести реальный контекст пользователя, переходя из ошибки в сессии и из сессии — во все ошибки в ней
-
«Хлебные крошки»: в логах последнего запуска виден путь пользователя Android-приложения от момента старта приложения до возникновения ошибки
-
Локальные переменные в Python: можно лучше понять контекст возникновения ошибок — все значения переменных и строки кода в момент ошибки видны прямо в стектрейсе
-
Легковесные стектрейсы: с Native SDK можно снять стектрейс только одного потока без остановки всего процесса
-
Кастомные ANR: с reportThread можно отправить статус и стектрейс нужного потока на Android
Теперь нам остаётся сделать несколько шагов:
-
Фильтруем поиск TQL по ID пользователя и названию ошибки
-
Анализируем проблему по трейсу и логам
-
В телеметрии ищем трейсы с OTLP-спанами по содержимому лога со страницы сбоя
-
В дереве спанов найденного трейса видим спан, помеченный ошибкой
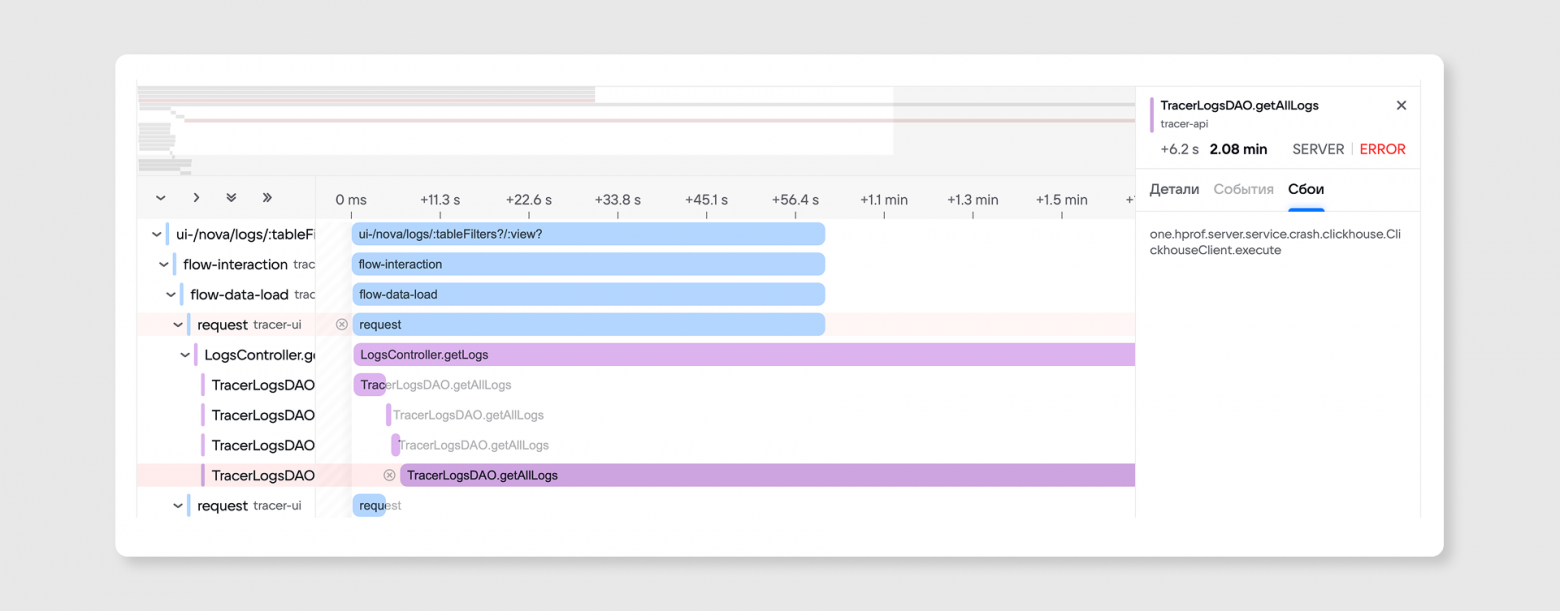
Результат: спан, привязанный к запросу, а именно его долгое выполнение и вероятное зависание, и является причиной исходной проблемы. Вся цепочка расследования укладывается в несколько кликов. Больше никаких переключений между окнами и ручного копирования ID.
Источник проблемы — долгое выполнение запроса и его завершение ошибкой, но из-за чего она возникает, ещё предстоит выяснить.
Волшебный способ помирить клиент и бэкенд
С новой уликой в виде проблемного запроса продолжим расследование: проведём первичную диагностику на клиенте, посмотрим графики, протестируем вручную. На первый взгляд всё чисто. Идём к команде бэкенда и отдаём им задачу, спокойно работаем. Пока они не перекинут задачу обратно на нас.
Такое в реальности больше не произойдёт, потому что Tracer объединил клиентскую и серверную ошибки. Командам клиентской и бэкенд-разработки не придётся спорить о том, где проблема, — они смотрят на один трейс и решают общую задачу.
Клиентский SDK связывает всё, что происходило на устройстве. К сессии прикрепляется флаг sampled, который уходит с OTLP, — и мобильное приложение с бэкендом видят один сквозной трейс. В одном представлении мы получаем визуализацию выполнения запроса с клиентскими спанами, вызовами бэкенда и сбоями. Это позволяет быстрее определить, на чьей стороне проблема. На чьей же она стороне?
Береги релиз снову, а алерты смолоду
Новый релиз выкатили, дежурный проверяет графики и замечает новый всплеск краша на платформе — именно того, который мы расследуем. Куда смотреть и что делать, пока поддержка не пришла с пачкой жалоб от пользователей? Tracer отвечает на эти вопросы и даёт инструкцию, как действовать.
Следим за последней версией
С анализом ошибок на релизе Tracer тоже поможет — сам определит, какая версия сейчас раскатывается. В поиске не нужно вспоминать и сверять версию, функция latestVersion() сделает это за вас: фильтры и алерты сами привязываются к актуальному релизу по активности пользователей.
Настраиваем алерты
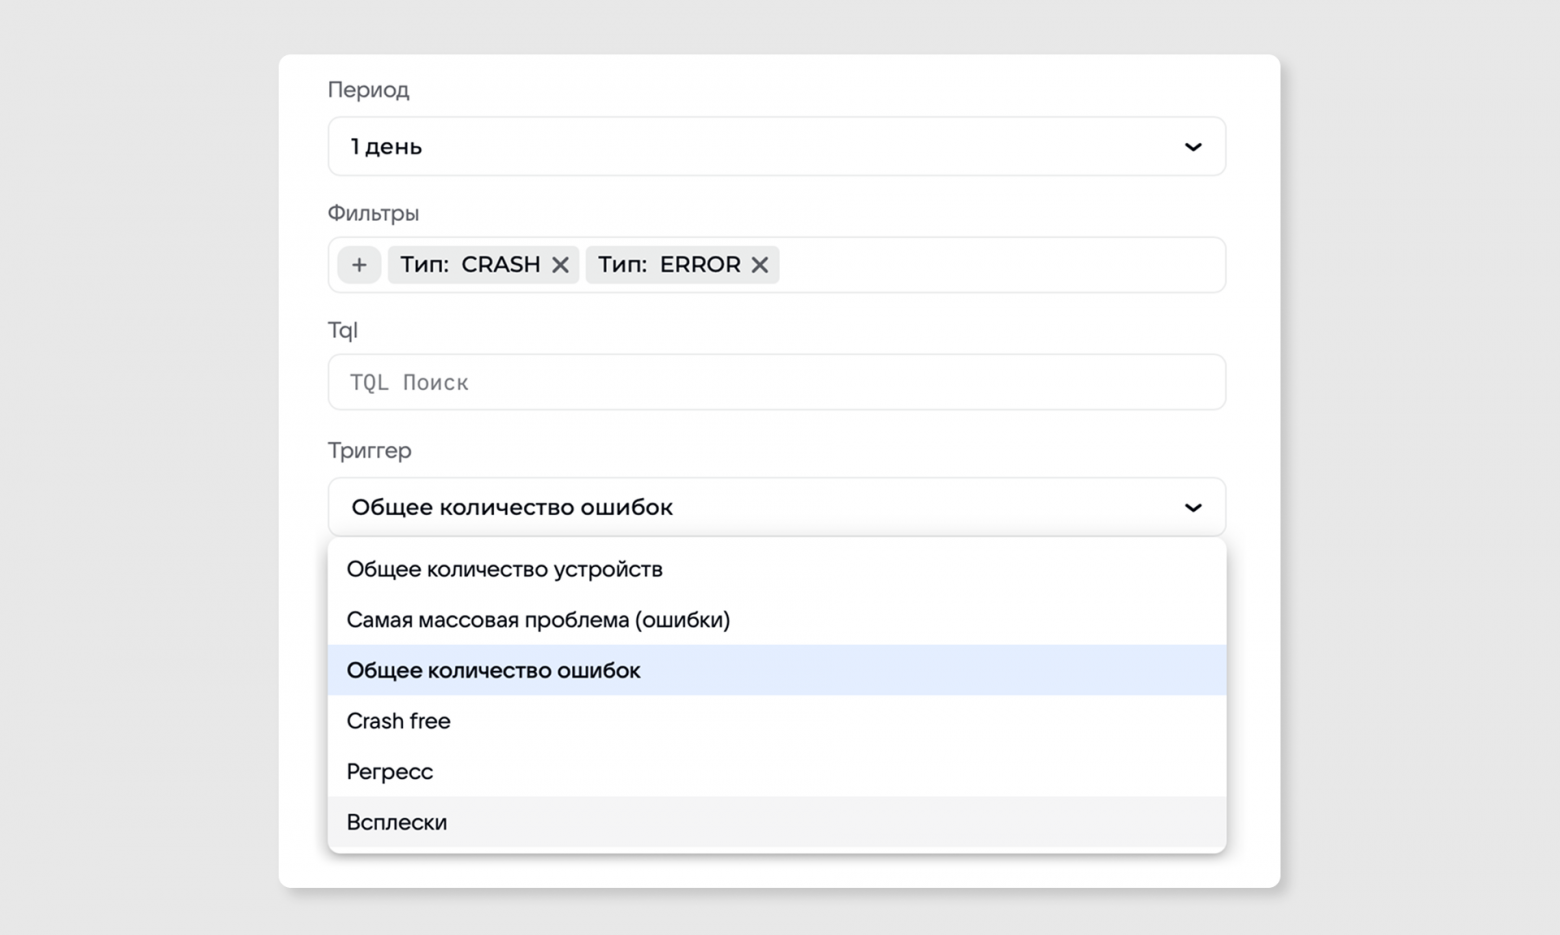
В 2026 году алерты в Tracer стали более гибкими и точными:
-
Всплеск и регресс: Tracer оповестит о росте числа неновых событий и о повторном появлении ранее исправленных ошибок
-
Не только триггеры из коробки: есть настройка порогов триггера по пользователям и процентам аудитории для crash и ANR
-
Отключение алертов до определённой даты на время работ или миграций
-
Дублирование алертов для ускорения копирования похожих настроек
-
Подписка на метрики: алерты на критические отклонения метрик телеметрии, не только на ошибки
-
Осмысленные сообщения: в текст алерта подставляются компонент краша, customData, счётчики — и в мессенджер приходит внятное информативное сообщение
-
SKIP_ALREADY_FIRED для регресса: алерт не отправится повторно по той же ошибке
-
Вебхук-каналы уведомлений: отправка алертов в любую систему через вебхук и редактирование каналов
-
Бот от Tracer продублирует уведомления в MAX и VK Мессенджер
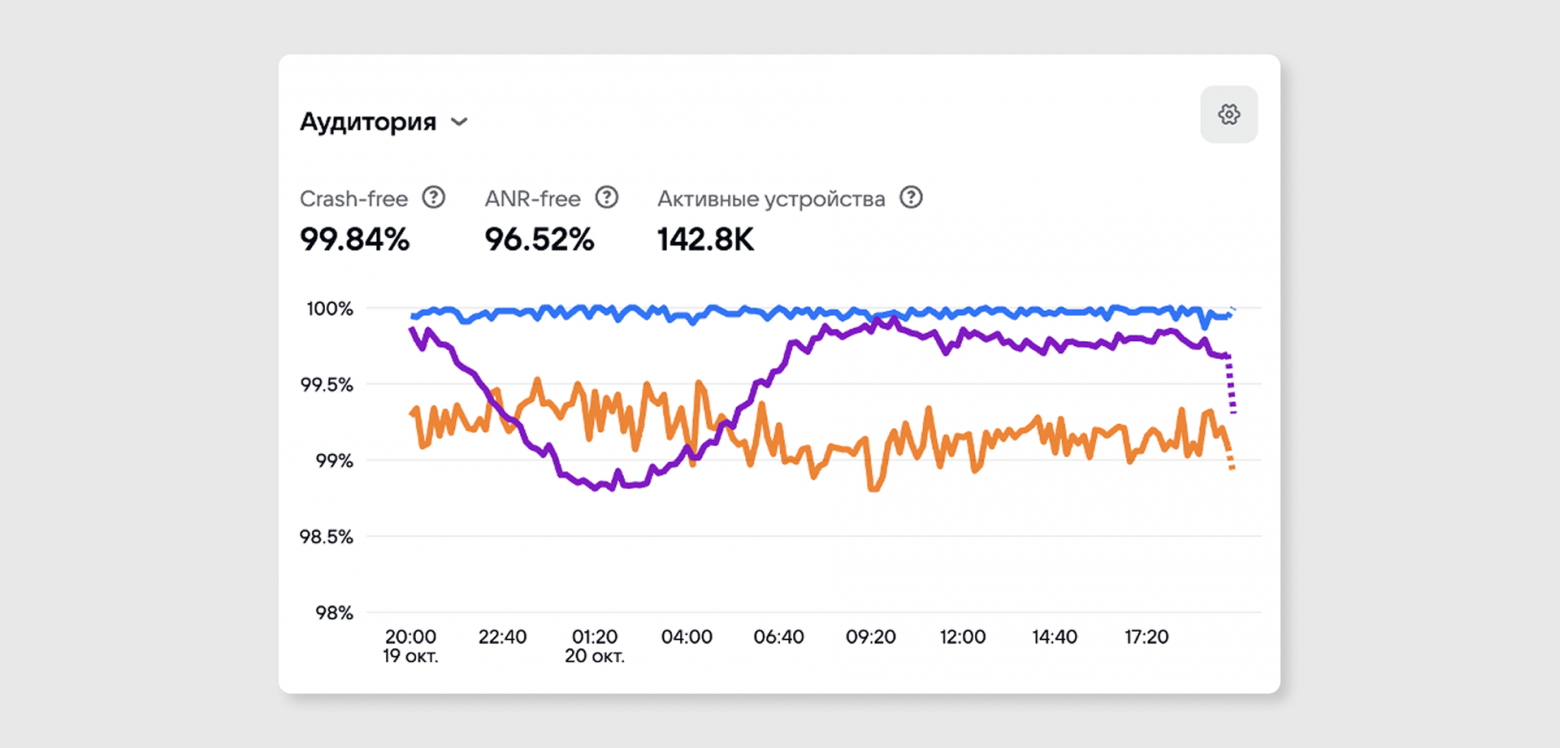
Помимо алертов, важно следить и за общим состоянием платформы — качество релиза видно по зависаниям. Для этого мы сделали аналог crash-free — график ANR-free, который показывает долю сессий без ANR.
Следим за историей сбоя
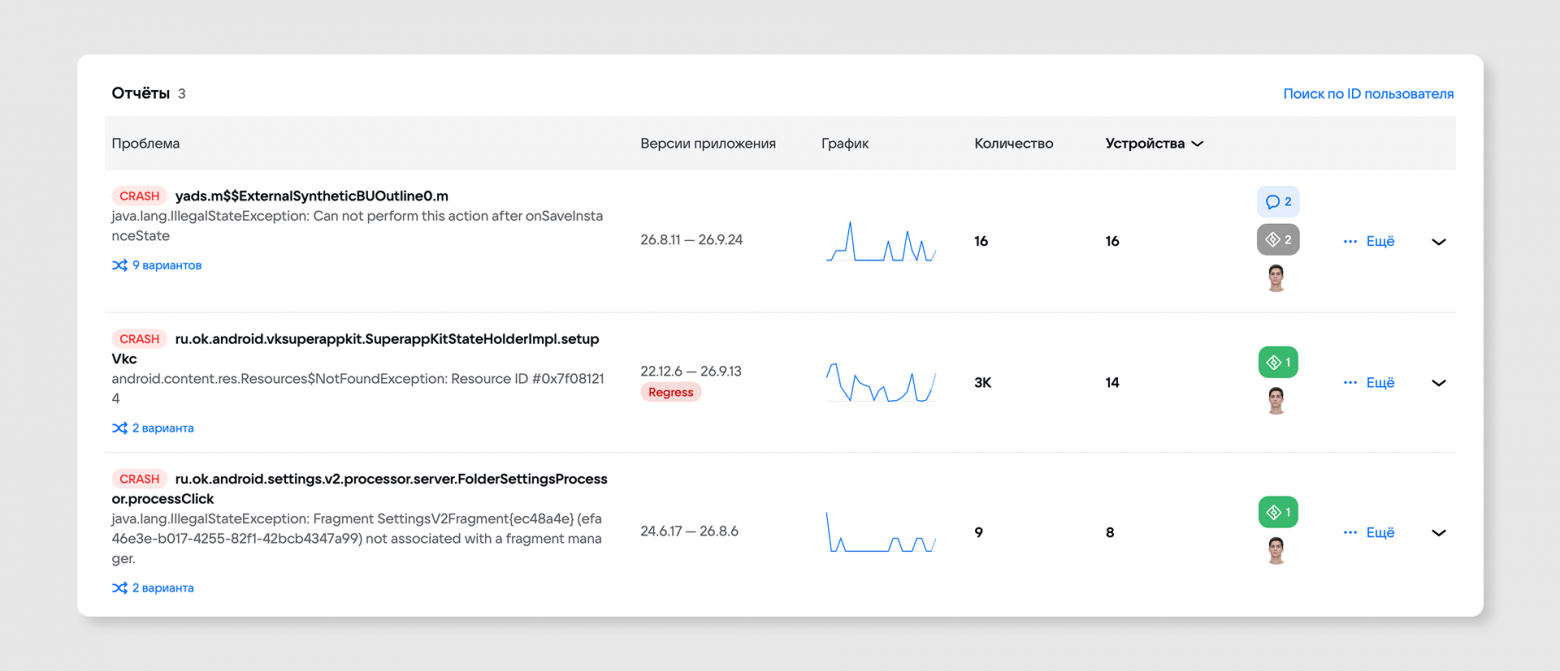
Не только поиск стал удобнее — представление самих сбоев теперь интуитивно понятно: ответственного за сбой можно назначить прямо из Tracer, а для удобства фильтрации — указать кастомные теги и срок их действия. Для отслеживания работы над сбоем можно оставлять комментарии и просматривать историю действий с ним. Не придётся искать по истории коммитов, задач и чатов в трёх разных сервисах — всё собрано в одной карточке сбоя.
Группируем трейсы и сбои
В работе с самими стектрейсами также появились новые возможности, которые позволят не тратить время на разбор одинаковых ошибок: можно группировать ошибки по кастомным правилам и объединять их по смыслу. В общем списке будет видна динамика каждой группы сбоя без открытия её страницы.
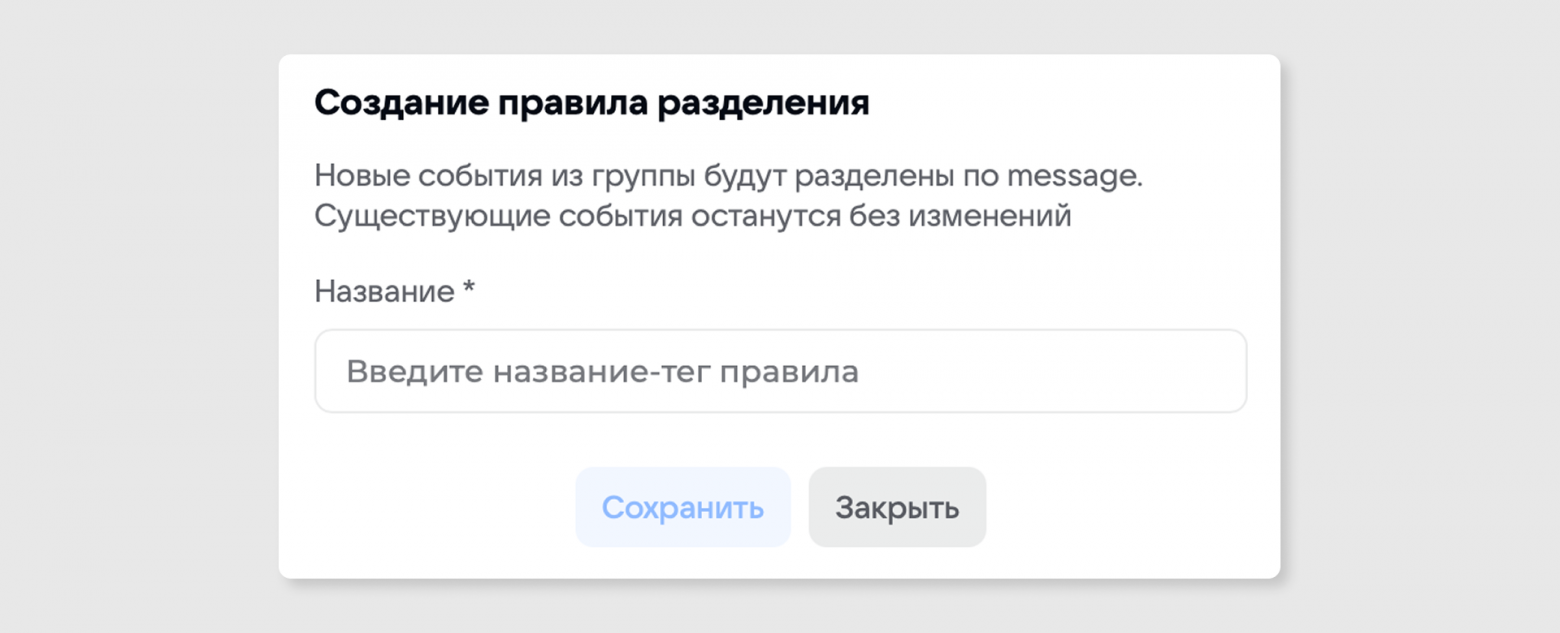
Некоторые сбои, напротив, могут объединяться по техническому сходству стектрейса, но по сути иметь разные сообщения, смысл и причину возникновения. Для работы с такими событиями Tracer сделал разделение по сообщению: на странице сбоя в настройках нужно найти «Разделение» и ввести тег правила разделения. По тегу можно найти все события, которые теперь автоматически будут добавлены в разные группы.
Рутину отдаём агенту
В июне 2026 Tracer выпустил MCP Server и apptracer-cli, которые помогут в работе со сбоями и телеметрией. ИИ-агент возьмёт на себя рутинные операции по мониторингу релизов и разбору ошибок.
Ассистенту можно задать вопрос, например «В чём причина роста ANR с версии 3.13.22?», а ИИ-агент получит доступ по личному токену, запросит логи, данные сбоя, трейсы и сформирует отчёт.
Ещё одно применение ИИ и MCP — анализ релизов на наличие новых проблем или критичных всплесков, требующих быстрого реагирования. Они найдут то, что может пропустить человек. Мониторинг релизов резко упрощается до пары фраз с ИИ-ассистентом.
Это не все кейсы применения MCP, на сегодняшний день агент может:
-
получать информацию об организации и её приложениях
-
читать распределённые трейсы, фильтровать их, получать детали трейса
-
работать с вариантами крашей, их деталями и трендами
-
точнее строить поисковые выражения с новой моделью TQL в последней версии
Агент находится на равном с вами положении: с последней версии — MCP 0.5.0 — он видит всё, что видно в UI. Доступен Remote MCP — hosted-режим для внешних пользователей apptracer, который позволяет подключаться по HTTP с помощью личного токена. А значит, локально скачивать и устанавливать MCP-сервер не нужно.
Подключить MCP можно к разным клиентам по соответствующим конфигурациям. В процессе подключения есть возможность выбрать фичи, которые будут необходимы при работе: сбои, логи, трейсы (apptracer-mcp-server —features reports,logs). Это позволяет экономить контекст на то, что важнее для решаемой задачи.
После подключения мы можем направить агента на расследование, например попросить его разобрать проблему пользователя.
Агент проанализирует запрос и вызовет необходимые инструменты, чтобы найти краш и локализовать проблему: сначала определит организацию и приложение с apptracer_list_orgs, apptracer_list_apps, а после получит информацию уже по ошибке apptracer_get_crash_list, apptracer_get_crash_details. Агент по трейсу и логам определит проблему, проанализирует, на чьей стороне причина, сравнит с ошибками в группе и на устройствах.
Убедимся в том, что нашёл агент, проанализировав и трейсы. Просим найти OTLP-спаны с соответствующей ошибкой: агент вызовет apptracer_get_trace_details, найдёт ошибку и предоставит расширенный отчёт, учитывая контекст всего диалога.
Проблема подтвердилась — ошибка вызвана необработанным исключением при неправильном ответе сервера. Попросим агента составить план защиты от падения на клиенте и создать отчёт о проблеме в файле, чтобы отдать бэкенду для исправления.
Разбор инцидента: меньше ручного переноса
Инцидент нужно разбирать по схеме — задача, скриншоты, стектрейсы, хронология. Теперь не придётся переносить всё вручную:
-
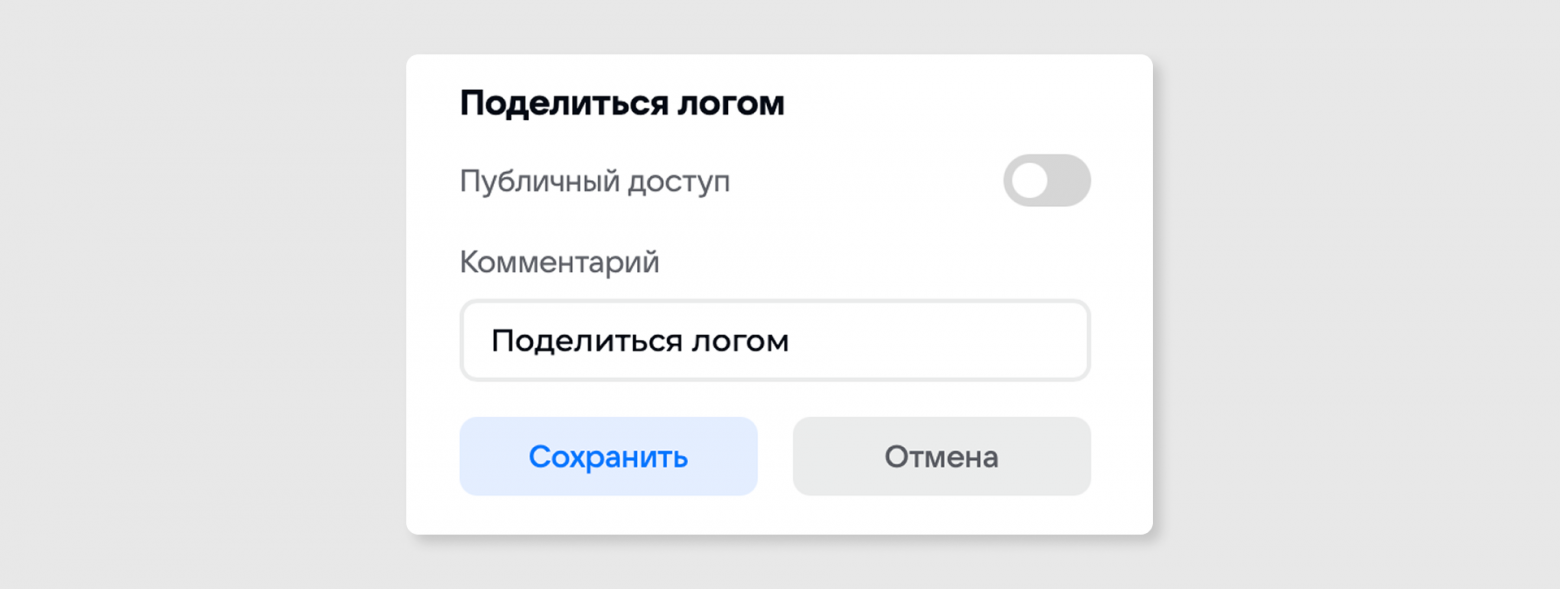
Публичная ссылка на лог, спан или стектрейс открывается в браузере без доступа к Tracer
-
Для внешнего анализа можно сгружать логи в CSV
-
Задачу в Jira можно создать со страницы ошибки. Вручную заполнять почти ничего не нужно: стектрейс и ключи уже в шаблоне. Расширенная интеграция с заполнением полей из customData открывается по запросу
-
Кастомные семплы и вложения загружаются отдельно, получают UUID и привязываются и к крашу, и к трейсу — по сессии и времени. Отправить можно сразу, не дожидаясь конца сессии
Поделиться логом с настройкой приватности:
Как подключиться?
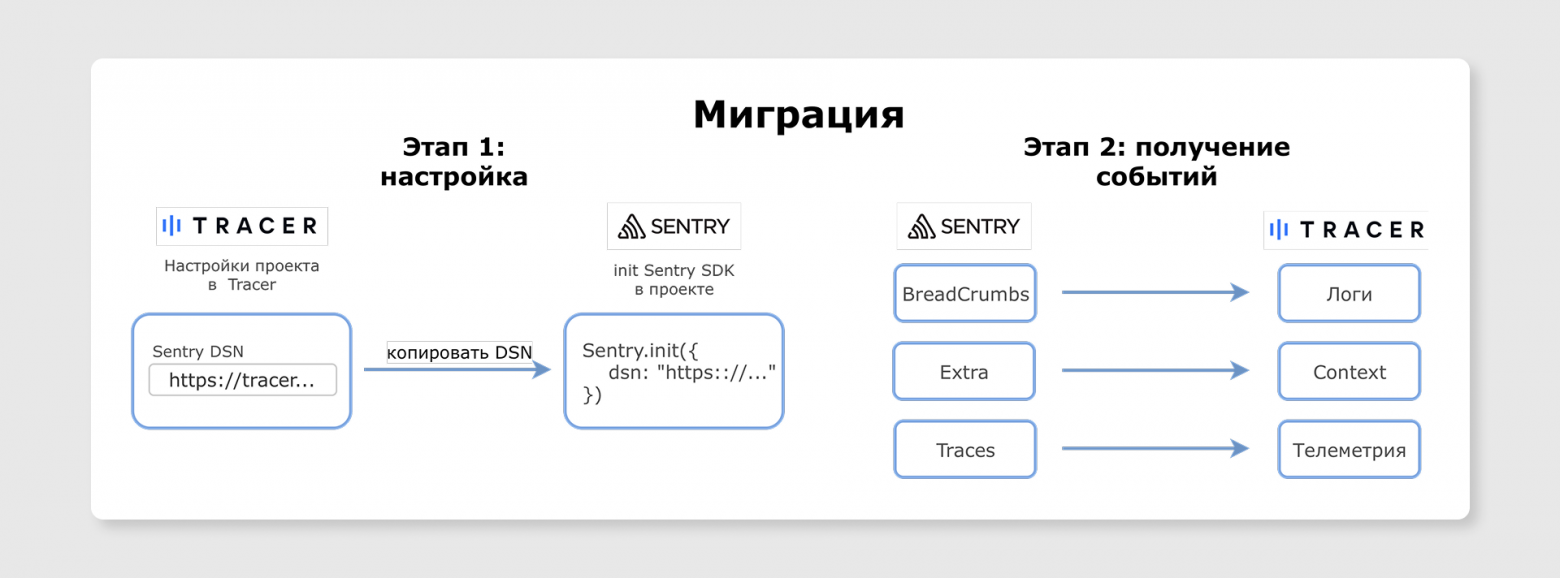
Для миграции из Sentry не нужно переписывать код: копируем DSN из настроек проекта Tracer, вставляем в init Sentry SDK — события идут в Tracer, код не меняется. Breadcrumbs попадают в раздел «Логи», Extra — в Context, а трейсы Sentry SDK появляются в «Телеметрии». Для .NET-команд мы сделали привычное отображение ошибок, для Perl, Ruby и Python добавили правила фильтрации стектрейсов. Для ошибок без стектрейса учитывается fingerprint из Sentry.
Если начинаете с нуля, выбирайте SDK на apptracer.ru: Android, iOS, JavaScript, Java, Native (C/C++), Python и Go. В 2026 добавились PHP и серверный Node.js. Трейсы и логи принимаются по OTLP: слать их можно стандартным коллектором, без привязки к вендору.
Архитектура хранилища представляет из себя мультитенант, развёрнуто оно на ClickHouse, данные лежат в РФ.
Что дальше?
Мы продолжаем развивать Tracer, в ближайшем будущем планируем:
-
добавить карту для поиска узких мест на основе трассировок
-
обеспечить долгожданную поддержку Flutter
-
собрать метаприложение, чтобы можно было выйти за рамки одного проекта в Tracer и удобно работать с тем набором сервисов, который вам нужен, в одном окне
О том, что из этого получится, расскажем в следующих публикациях.
ссылка на оригинал статьи https://habr.com/ru/articles/1097696/