В октябре пострадали три площадки одного из крупнейших российских провайдеров: на первой после пожара остановились все системы, на второй несколько модулей вышли из строя полностью, а третью остановили целиком, и облако перешло в аварийный режим (разбор на Хабре, «Коммерсантъ»). Весь рунет спрашивал когда всё заработает. А вот ИТ-службы куда реже спрашивали себя, что придётся восстанавливать, если такое случится у них.
Всем привет, это команда SimpleOne ITAM и ITSM. Как устроен учёт у тех, кого коснулись эти события, мы не знаем, и он вполне может быть образцовым — для нашего разговора это неважно. Поэтому разбираем вопрос гипотетически, чтобы сообразить план на будущее.
Резерв построен, а что в нём лежит, никто не помнит
Даже если у компании есть резервная площадка, не всегда понятно, что именно на ней стоит, сколько там свободных серверов и какого они поколения, потому что смотреть эту информацию приходится сразу в нескольких местах.
Когда основная площадка выходит из строя, за первые часы нужно понять, что потеряно, что из этого закроют запчасти со склада или поставщик по договору, а что придётся покупать с нуля. Ответ, конечно, уже есть — просто лежит он в таблице у сетевых инженеров, в складской системе бухгалтерии и в договорах у закупщика, и собирать его приходится муторно, вручную, пока услуги стоят. А бизнес теряет деньги.
Звучит, конечно, как преувеличение для особо запущенных случаев — на самом деле для рынка это скорее норма. В исследовании SimpleOne ITAM 2026 участвовали больше сотни российских компаний, и 80% из них оценили зрелость процессов управления ИТ-активами не выше трёх баллов из пяти. Каждая пятая до сих пор ведёт учёт в Excel, специализированную ITAM-систему используют 18%, а о неустановленных потерях оборудования заявили 22% участников.
Чем закрывают потерю площадки
Если площадка не вернётся, у компании остаётся четыре пути, и у каждого свои сроки.
Первый — собственный резерв, и тут многое зависит от его типа. Горячий резерв уже работает: сервисы переключаются на него, и на этом всё. В тёплом оборудование уже стоит в стойках, но не настроено, поэтому сервисы разворачивают из резервных копий. Холодный лежит на складе, и его сначала нужно привезти, смонтировать и настроить, а уже потом разворачивать копии. Но разворачивать нечего, если копии остались на той же площадке: георезервная копия, то есть копия вне основной площадки, нужна любому резерву, кроме горячего.
Второй путь — замена по договору, и здесь нужна трезвость: гарантия вендора обычно закрывает заводской брак и поломки при нормальной работе, но не пожар, перегрев или скачок напряжения, поэтому рассчитывать на неё можно только там, где вендор признал случай гарантийным (если оборудование застраховано, к этому добавляется полис). Еще и время теряется пока вендор признает, что случай гарантийный, пока вышлет замену, пока она доедет, пока ее установишь и настроишь. Третий — докупить железо, но быстро это почти никогда не получается: по оценке аналитика Mobile Research Group Эльдара Муртазина, поставка серверов занимает два-три месяца (разбор на Хабре), а по данным «Коммерсанта», срок доходит до полугода. Четвёртый — переехать к другому облачному провайдеру: это обычно быстрее всего, если размещение сервисов допустимо у облачных провайдеров.
Выбирать приходится из того, что есть, и в первых трёх случаях выбор упирается в качество учёта. Горячий резерв всегда на виду, а тёплый и холодный существуют только пока кто-то знает, что именно стоит в стойках и лежит на складе, в каком это состоянии, подойдёт ли оно к вышедшему из строя узлу и какой контракт на него распространяется.
Что должно лежать в учёте до аварии
В день аварии по записи в учёте должно быть понятно, подойдёт ли запчасть из резерва. Для этого реестру мало перечня устройств, нужен состав каждого (шасси, процессоры, память, диски, блоки питания) и точное расположение: до стойки — для критичного оборудования, до помещения — для остального, потому что чем глубже детализация, тем тяжелее её поддерживать.
У нас в ITAM-системе активом считается любое ИТ-оборудование, а единицей учёта может быть и запчасть. Запчасти, инструменты и аксессуары отмечаются как ЗИП (запасные части, инструменты и принадлежности); после ремонта использованные детали привязываются к обслуженному активу, а неиспользованные возвращаются на склад. Расположение берётся из справочника: страна, регион, город, адрес, помещение, а для активов на хранении по умолчанию указывается склад с точностью до помещения. Номенклатура хранит поставщика и контракт, по которому идёт закупка, а контракты на сами активы (обслуживание, гарантийное обслуживание) привязываются к активам через форму контракта. У контракта есть даты начала и окончания, для гарантии окончание система считает сама по сроку гарантии, а за заданное число дней до конца она уведомляет ответственных и в день окончания переводит контракт в статус «Не действует».
Вручную вести такой реестр тяжело, и одного ручного ввода недостаточно, поэтому его сверяют с дискаверингом. Коннектор (например, к Open-AudIT) по расписанию находит оборудование в сети и записывает его в CMDB, а актив и конфигурационная единица с одинаковыми серийными номерами при включённой настройке связываются автоматически. Если же в CMDB появилась единица, к которой не привязан ни один актив, это повод задуматься, где оборудование потерялось в учёте, и провести инвентаризацию.
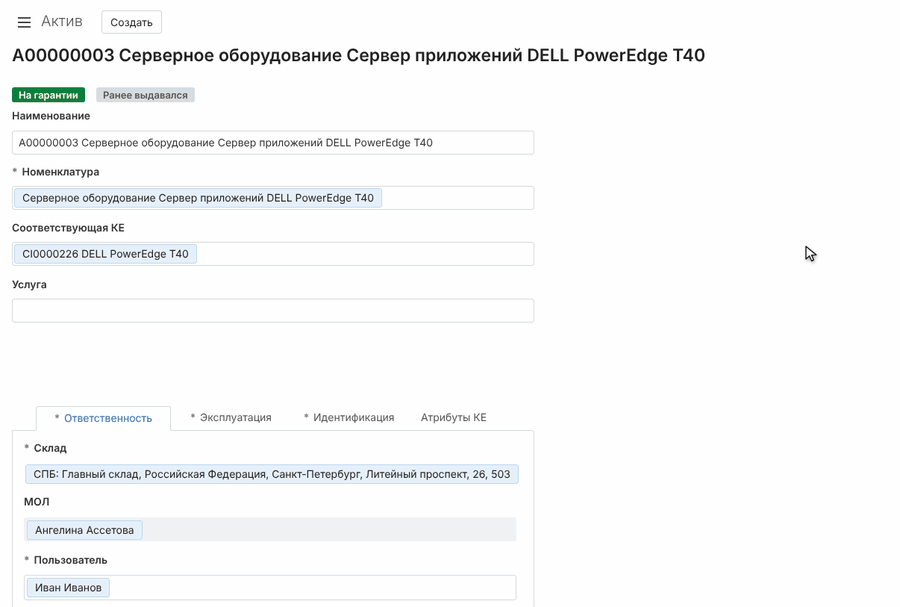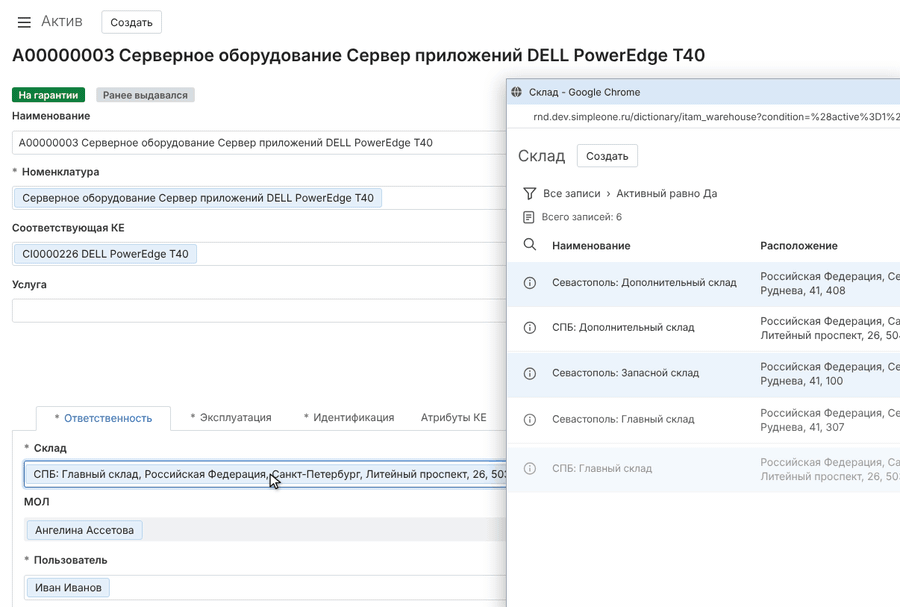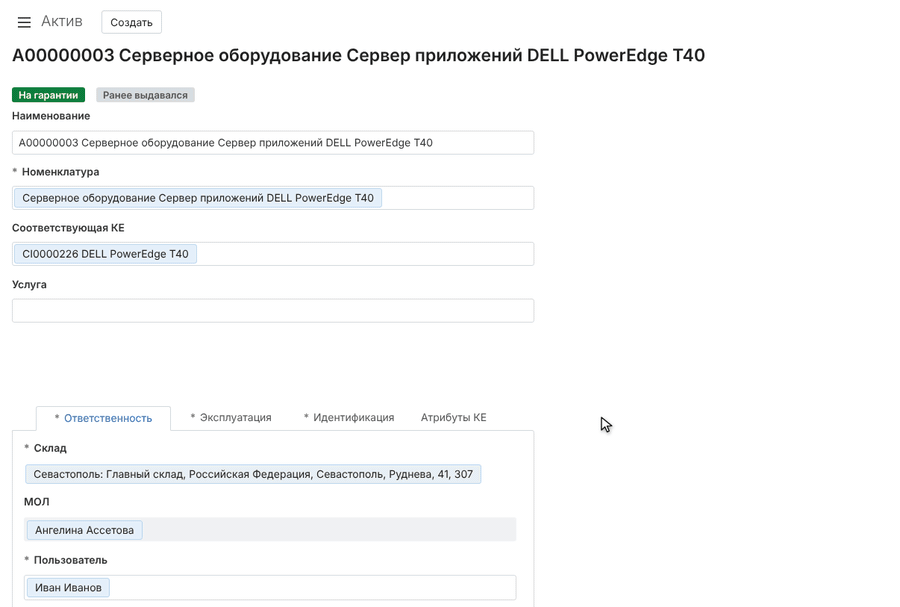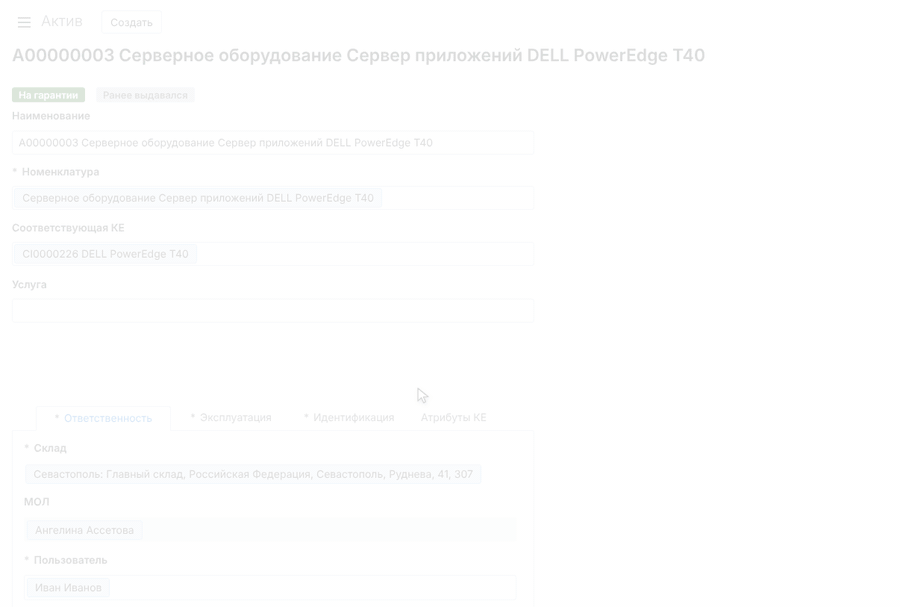
А видно ли, какие услуги затронуты?
Список оборудования покажет, что потеряно, но не скажет, какие услуги от этого остановились. Для этого нужна CMDB, где хранятся связи между услугами и конфигурационными единицами, а сами конфигурационные единицы так же прочно связаны с физическими активами. Кроме связей, каждую услугу нужно описать заранее: на каких адресах и портах она работает, с чем связана, где лежат её резервные копии (и лежат ли они вне основной площадки). Описание должно храниться там, где оно точно не пострадает.
Если же системы живут порознь, ситуация другая. Допустим, дежурит администратор, в три часа ночи ITSM показывает десятки остановившихся услуг. Администратор открывает в соседней вкладке табличку с активами, берёт первую услугу, находит в CMDB сервер, ищет его в таблице — и выясняется, что там он записан иначе, потому что запись когда-то вёл коллега, который давно уволился. Серийный номер приходится сверять глазами, по снимку шильдика из рабочего чата. Какой тогда смысл в безупречной CMDB, если информация о замене лежит в чьём-то файле?
В нашем решении модель из CMDB привязывается к номенклатуре, и если включено автоматическое создание конфигурационных единиц, для каждого нового актива регистрируется единица с атрибутами этой модели. SimpleOne ITSM и ITAM уже интегрированы между собой, поэтому актив можно связать с конфигурационной единицей прямо в системе, а серийные номера в CMDB приходят с самого оборудования через дискаверинг, и сверять их глазами по снимку шильдика не приходится. Дальше всё идёт от услуги: инцидент связан с услугой, которую получает заявитель, и по ресурсно-сервисной модели (она показывает, из каких конфигурационных единиц состоит услуга) сразу видно, какие единицы затронуты и с какими именно активами они связаны. Работы по этим активам (обслуживание, перемещение, списание) оформляются задачами на те же активы и не теряются в общем журнале.
Остаётся решить, с чего начинать, потому что ресурсов на все услуги сразу не хватит. Лучше до аварии провести анализ влияния на бизнес (BIA) и определить, какие услуги останавливают работу компании, а какие могут подождать. Типичная очередность выглядит примерно так: сначала связь, без которой не собрать людей, потом услуги, на которых держатся выручка и разработка (корпоративный сайт, CRM, система контроля версий), и только в самом конце аналитика и отчётность. Если услуги уже описаны в CMDB и размечены по критичности, очередь видна сразу, и спорить о ней ночью не придётся.
Учёт, который остался на сгоревшей площадке
Теперь о неприятном. ITAM, CMDB и ITSM работают на серверах, и если они стояли на той же площадке, что и всё остальное, в нужный момент не откроется ни реестр оборудования, ни связи услуг, ни заявки.
Давайте представим, что ночью дежурному звонят: площадка остановлена, корпоративная связь не работает, мессенджеры молчат. Специалистов нужно срочно собрать, но их номера лежат в справочнике, который недоступен, а план восстановления — в сетевой папке на той же площадке. Реестр оборудования и CMDB лежат там же. Остаётся вспоминать, кому звонить, и надеяться, что нужный номер найдётся в чьём-нибудь телефоне.
Чтобы с вами такого не случилось, нужны три организационные вещи:
-
копия реестра оборудования и связей CMDB, которая лежит вне основной площадки и открывается без неё;
-
план восстановления на носителе, который не зависит от доступности сервисов: распечатка, флешка, сейф;
-
запасной канал связи и список людей, которых нужно поднять первыми.
Для самой системы учёта есть и техническая альтернатива: развернуть её сразу в нескольких ЦОД, так чтобы потеря одной площадки не останавливала её целиком. Так можно устроить любую систему этого класса, в том числе распределённый стенд SimpleOne, который размещают в нескольких ЦОД.
Чек-лист готовности учёта к аварии
1. Состав площадки. Оборудование любой площадки или стойки выгружается за 15 минут, и в выгрузке есть серийные номера.
2. Состав серверов. По каждому серверу и СХД известно, какие в нём диски, модули памяти, блоки питания и контроллеры.
3. Связь с услугами. Каждый актив привязан к КЕ в CMDB, которая уже связана с услугой, поэтому видно, что остановится при его отказе.
4. Склад. Остатки запчастей и подменного фонда видны по всем площадкам сразу, вместе с состоянием каждой единицы (исправна она или только числится).
5. Замена по договору. По каждому активу известны поставщик, срок действия контракта и условия замены, включая то, какие случаи договор считает гарантийными.
6. Закупка. Вы знаете, чего вам не хватит в первую очередь, и сколько в прошлых закупках занимала поставка такого же оборудования.
7. Сверка с реальностью. Записи сверяли с площадкой недавно, и одну площадку можно пересчитать целиком за разумное время (в мобильной инвентаризации SimpleOne ITAM, например, список активов задачи сверяется с результатами сканирования штрихкодов).
8. Учёт переживёт площадку. Копия реестра и CMDB лежит вне основной площадки и открывается без неё.
9. План без сети. План восстановления, список бизнес-критичных услуг и контакты людей, которых нужно поднять первыми, лежат на носителе и в месте, которые не зависят от доступности сервисов.
Резюме
Резерва, которого нет в учёте, для аварии не существует.
Связка ITAM, CMDB и ITSM, конечно, не заменит ни вторую площадку, ни план аварийного восстановления, ни толстые стены — зато в первые часы после аварии команда принимает решения, а не ищет данные, если реестр пережил площадку. Начать можно сегодня: выберите одну площадку, одну стойку или один тип сервера, засеките пятнадцать минут и проверьте, откроется ли реестр без основной площадки.
ссылка на оригинал статьи https://habr.com/ru/articles/1097942/