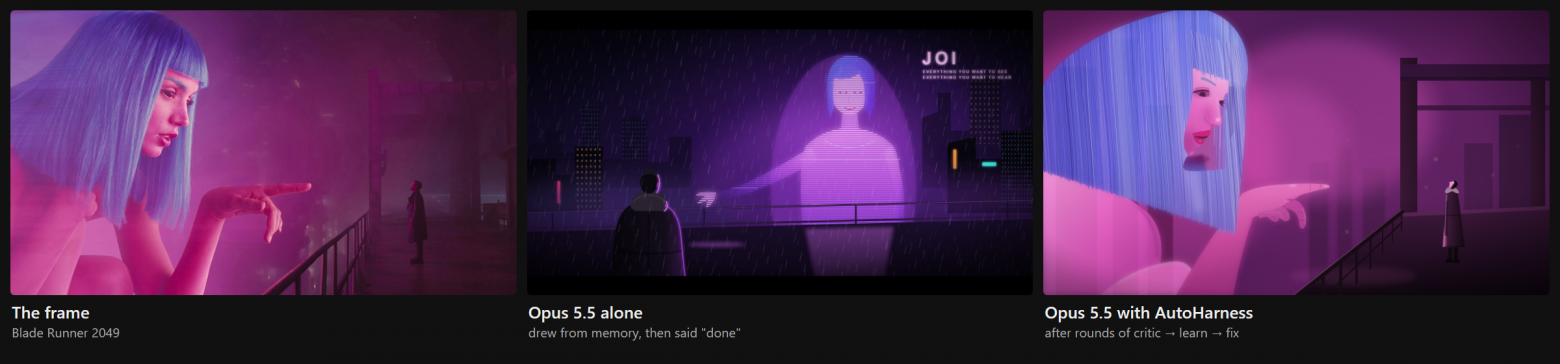
Я дал Claude Code (Opus 5.5) тестовое задание:
Draw a scene from the movie Blade Runner 2049 using SVG graphics, where Ryan Gosling’s character is looking at a hologram of an AI girl in purple light. Don’t use external SVG generators.
Задача выглядит простой, но на деле почти невыполнима. Запрет на внешние генераторы убирает возможность схитрить: модель рисует кодом примерно так, как человек рисовал бы картину, диктуя координаты.
Все агенты, которые я пробовал, провалили её одинаково: на настоящий референс никто не посмотрел и даже не пытался — максимум статья из wiki. Агенты рисовали по памяти и сообщали, что готово. На просьбу «сделай лучше» в одном месте поправляли, в другом ломали.
Вопросы, которые агент себе не задаёт
В какой-то момент я перестал надеяться на лучшее и начал подсказывать агенту вопросы:
-
Есть ли документация?
-
А решал ли кто-то подобное?
-
Какие у меня есть инструменты? Если нужного нет, можно ли его сделать?
-
С чем сравнивать результат? Где референс?
-
Что значит «хорошо»? По каким критериям принять работу?
-
Как не забыть, что уже сделано?
-
Новый результат лучше старого? Когда остановиться?
С этими вопросами картинка становилась лучше. Только задавать их приходилось каждый раз заново, а через пару шагов агент про них забывал. Я решил делегировать всё скиллу, из этого и вырос AutoHarness.
Раньше я работал в авиации. Там никто не строит самолёт в лоб: сначала изучают каждую дисциплину, документацию, а если нужного документа нет, его пишут. От агента я хотел того же, не привязываясь к тестовой задаче.
Как это работает на деле
Перед работой агент разбирает задачу на области знаний. Для кадра из фильма это фигура человека, свет и композиция. По каждой области он ищет готовый скилл или MCP-сервер из доверенных мной источников, например из маркетплейса Anthropic. Скиллы агент ставит сам. Ставить скиллы из публичного каталога страшно, поэтому каждый кандидат получает оценку доверия, скилл сначала скачивается во временную папку и проверяется на опасные вещи вроде чтения ~/.ssh или curl | sh. То, чему нельзя доверять полностью, ставится только после моего «да». Если подходящего нет, агент пишет скилл сам. Ответ «я это и так знаю» не засчитывается, такое знание тоже нужно записать в скилл. В конце выполнения задачи агент удаляет всё, что поставил.
Потом агент достаёт референс. Здесь это сам кадр из фильма. До первой попытки агент измеряет пропорции, положение фигур, цвет, то есть то, по чему потом будет судить результат.
Далее агент пишет себе короткий бриф. В нём три вещи: каким должен быть хороший результат (для кадра — те же пропорции, фиолетовый свет, голограмма на своём месте), мои условия дословно («без внешних генераторов») и как он будет проверять работу. Для кадра из фильма это выглядит так:
-
Посмотреть на свою работу. SVG — это код, и агент его «не видит». Поэтому он открывает файл в браузере и делает скриншот, то есть превращает код в картинку.
-
Положить рядом с оригиналом. Скриншот ставится бок о бок с настоящим кадром из фильма.
-
Сверить по замерам. До начала работы агент измерил кадр: где стоит герой, какого он роста относительно кадра, где голограмма, какой цвет. Теперь он сверяет с этими цифрами свой рисунок.
-
Отдать критику. Отдельный агент, который не рисовал, сравнивает картинки и выносит оценку. Пока брифа нет, агент в Claude Code просто не может создавать и менять файлы: это запрещает хук.
Свою работу агент не оценивает
Самый показательный случай был не с картинкой. Я исправлял в самом AutoHarness несколько проблем с безопасностью. Агент, который писал исправления, пять раз подряд оценил свою работу как «minor». Отдельный агент-критик, который код не писал, в первом же раунде нашёл два способа обойти хук и назвал это блокером. Потом он нашёл ещё три серьёзные проблемы.
Поэтому работу всегда проверяет второй агент, который её не делал. Картинки он сравнивает вслепую: видит две версии под буквами A и B и не знает, какая новая. Отзыв всегда заканчивается строкой с одним словом: blocker, major, minor или none. Первый агент отзыв не пересказывает, иначе blocker легко превратился бы в minor. Вместо этого программа выдаёт к каждой проверке одноразовый id. Второй агент пишет его первой строкой отзыва, первый сохраняет отзыв в файл целиком, а программа сверяет id и сама читает оценку, так что старый отзыв критика за новый не будет принят.
Если критик нашёл серьёзную проблему, агент сначала ищет, как должно быть по правилам, и дописывает это в скилл. Исправлять можно только после этого. Если одна и та же проблема держится три раунда, агент обязан сменить подход.
Кто следит за правилами
Правила из промпта агент пропускает, я видел это много раз. Поэтому в AutoHarness две части. Первая — инструкция для агента. Вторая — скрипт autoharness, который агент сам запускает в терминале. Каждый шаг агент записывает в журнал задачи и проверяет. Например, если в брифе сказано, что скилл нашёлся по такому-то запросу, скрипт сверит это с журналом поисков. Если шаг не сделан, он отказывает, и дальше агент не идёт.
Скилл тоже надо проверять
Скилл, который написал агент, может указать ложный путь. Поэтому его можно прогнать на тестовых задачах: каждую делают два агента, один со скиллом, другой без, а судья сравнивает работы, не зная, где какая.
Что в итоге
На моих задачах Opus 5.5 с AutoHarness работал заметно лучше, чем без него, особенно на визуальных задачах. Честного бенчмарка у меня пока нет. Нормальный прогон стоит дорого и занимает время. По моим ощущениям, результат выполнения задач стал более предсказуемым.
Подготовка съедает время и токены, поэтому для мелочей вроде опечатки есть лёгкий режим без поиска и брифа.
Работает с Claude Code, Codex CLI, Gemini CLI, Antigravity CLI, Qwen Code, GigaCode.
Код: https://github.com/D-Shey/autoharness
Буду рад критике. Может, кто-то делал нечто подобное?
ссылка на оригинал статьи https://habr.com/ru/articles/1098004/