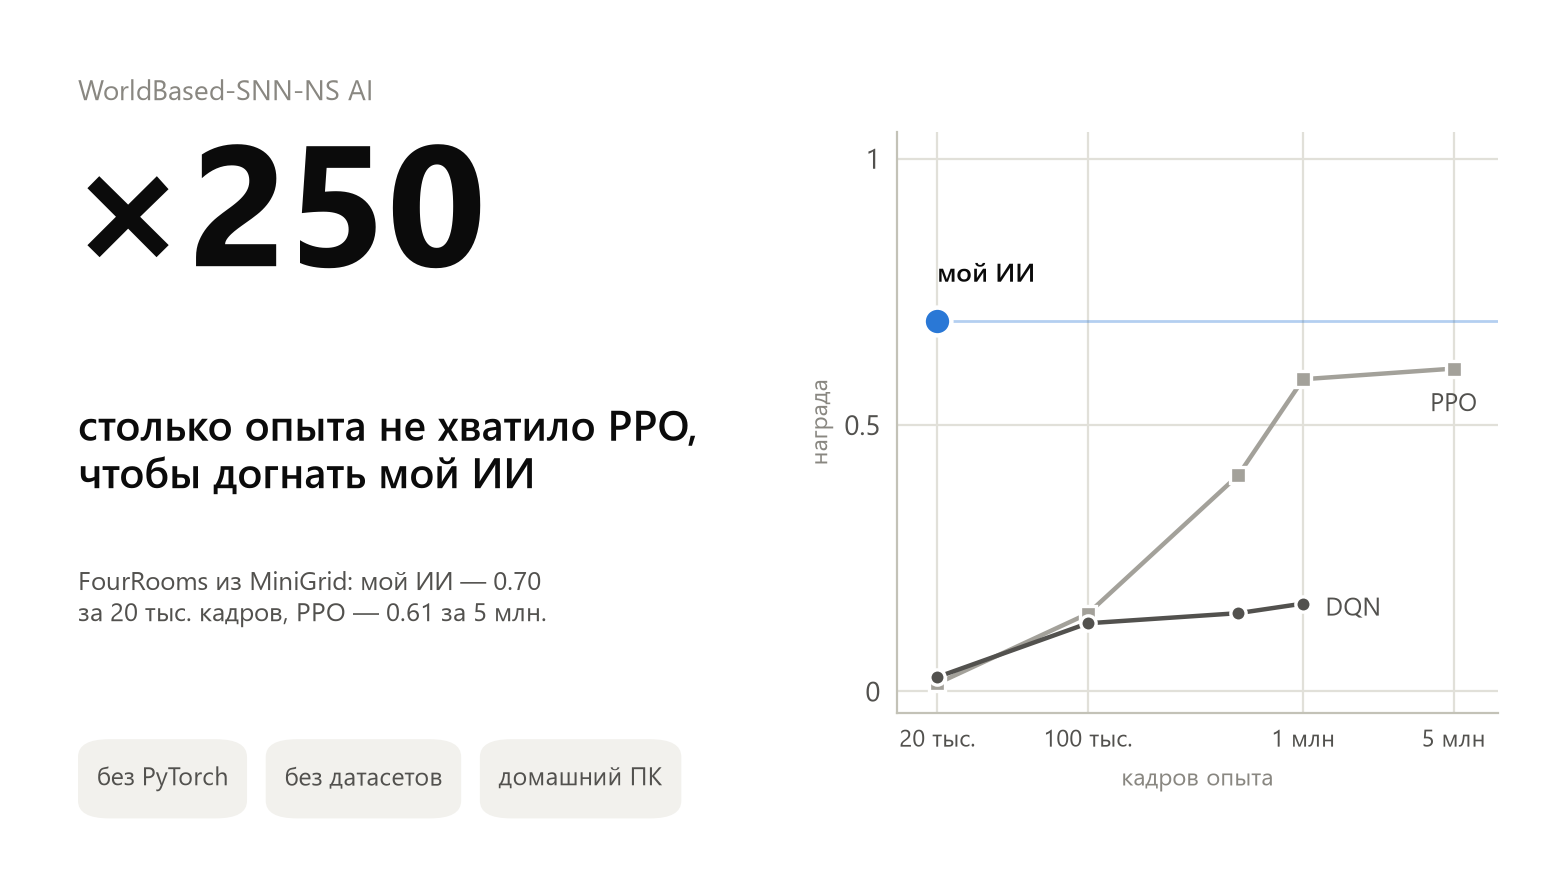
Всем привет, меня зовут Никита, мне 20 лет, я AI-Native разработчик. Сегодня покажу свой главный проект — World Based Spiked Neural Symbolic AI. Это ИИ с моделью мира на спайковой нейросимвольной сети: учится он не на датасете, а на последствиях своих действий в симулированном мире. Спойлер: в одной из задач PPO не догнал его и за 5 миллионов кадров, а моей системе хватило 20 тысяч.
Устройство и план пока не раскрываю, а вот числа покажу. В конце будет просьба: я ищу подработку.
Пара слов о себе:
За последний год меня много раз роняло. Подробности оставлю при себе: жаловаться не хочу, да и пост не об этом. Главное — я не сдался. Каждый раз поднимался и садился обратно за работу.
И сразу признание, чтобы не было иллюзий: базу языков программирования я не знаю. Код за меня пишут ИИ-агенты. Зато я научился выжимать из них всё, на что они способны, и строить работу так, чтобы не обманывать самого себя. Оказалось, этого хватает, чтобы вести исследовательский проект, на который год назад я бы даже не замахнулся.
Лирику на этом заканчиваю. Дальше — мясо.
Что я строю:
Название длинное, но каждая буква в нём по делу:
— WB — World Based. В центре симулированный мир. Система действует, видит последствия и сама выучивает законы этого мира. Любую способность я проверяю не тестом на датасете, а её поступками в мире.
— SNN — Cпайковая нейросеть. Считает только там, куда пришёл сигнал. Обычная плотная сеть на каждом шаге пересчитывает всё целиком.
— NS — Нейро-символьная. Понятия система выращивает сама, из опыта. Руками я их не вписываю, и сколько их будет, заранее не задаю.
И ещё один принцип с первого дня: у системы есть право сказать «не знаю» вместо уверенной догадки.
Чужих моделей здесь нет: ни PyTorch, ни предобученных весов. Сеть написана с нуля — Python, numpy и Rust в горячих местах. Считается всё дома, на Ryzen 7 5700X с RTX 3060. Видеокарта, к слову, нужна в основном соперникам.
Куда проект пойдёт дальше, пока держу при себе. Скажу только, что ставка — на экономию опыта.
Как не врать себе, если не читаешь код:
Это, наверное, главное, чему я научился за год. Если не можешь проверить код глазами, проверяй числами. Но числа тоже умеют врать, поэтому в проекте жёсткие правила:
1. Идея не считается рабочей без воспроизводимого прогона — с соперником (baseline), с отключением детали (ablation), на отложенных данных (held-out) и со списком «чего НЕ доказано». Такой список есть в каждой записи журнала.
2. Экзамен — только на закрытых мирах. Их не видит ни система, ни я. Каждый набор вскрывается один раз.
3. Предрегистрация. До экзамена я записываю, что меряю и какое число будет провалом. Запись и код фиксируются хешем в журнале экзаменов, поэтому задним числом ничего не подгонишь.
4. Перемешанный контроль. Если на перемешанных данных «работает» так же, значит, не работает.
5. Проверки проверяются мутантами. Специально ломаю логику, и проверка обязана упасть. Выжил мутант — проверка слепая, её чинят до записи результата.
6. Соперники — в их пользу, мир — бит в бит. Настройки соперников подбираю в их пользу. Свой мир сверил с официальным MiniGrid: ноль расхождений на 19 200 кадрах.
Что получилось
В 5–250 раз меньше опыта, чем у DQN и PPO
На днях я отдал проект на разбор внешнему ИИ. Делаю так регулярно, чтобы не льстить себе. Один из упрёков был такой: «Твои победы над DQN и PPO — на их маленьком бюджете. 20 тысяч кадров — это мало».
Справедливо. Спорить я не стал. Дал соперникам до 5 миллионов кадров, взял опубликованные настройки из rl-baselines3-zoo и проверил, что мой PPO выдаёт те же числа, что в публикациях. В трёх задачах из пяти выдаёт. Там, где он вышел слабее, я сравниваю с опубликованными числами.
Вот что получилось:
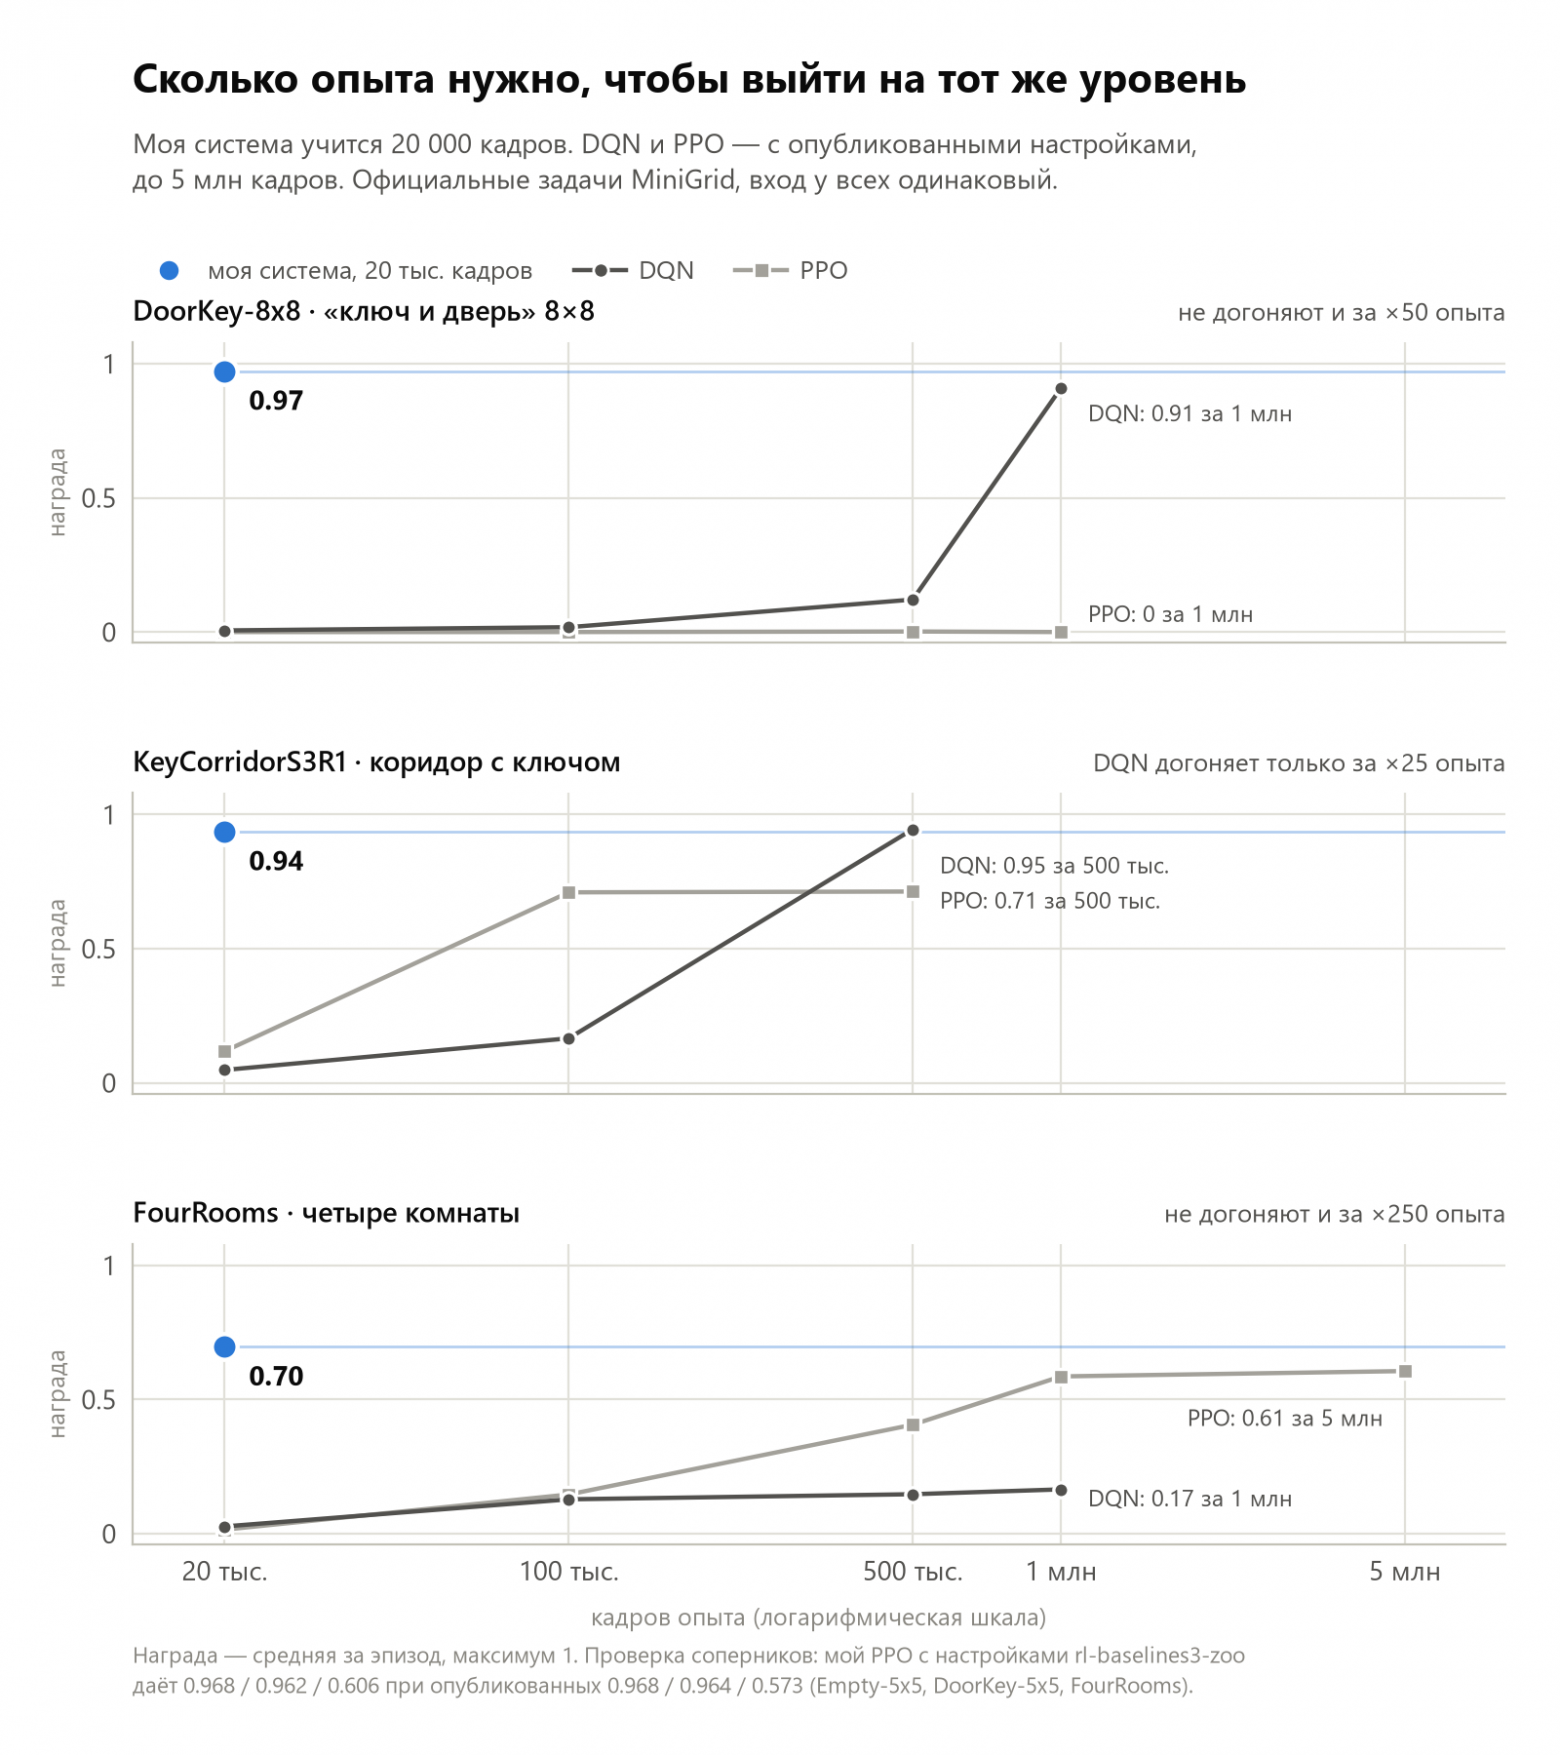
В самой простой задаче, пустой комнате 5×5, выигрыша нет: PPO выходит на тот же уровень за те же 20 тысяч кадров.
И сразу оговорка, чтобы не спорить в комментариях. У моей системы есть модель мира и план, у DQN и PPO их нет. Большая часть выигрыша — от этого устройства, я мерил это отдельно, соперником с теми же подсказками. Поэтому заявлять «мои нейроны умнее» я не буду. Числа показывают другое: при одинаковом входе моей системе нужно в разы, а местами в сотни раз меньше опыта.
Шесть комнат: 50 тысяч кадров против 120 миллионов
Есть задача потруднее — MultiRoom-N6: шесть комнат подряд, и каждый раз новая раскладка. Моя система решает в ней все эпизоды за 50 тысяч кадров, средняя награда 0.58. Для сравнения, по опубликованным числам: специальные методы исследования среды BeBold и RIDE выходят на 0.64 – 0.65 после 120 миллионов шагов, у остальных методов в их таблице — ноль.
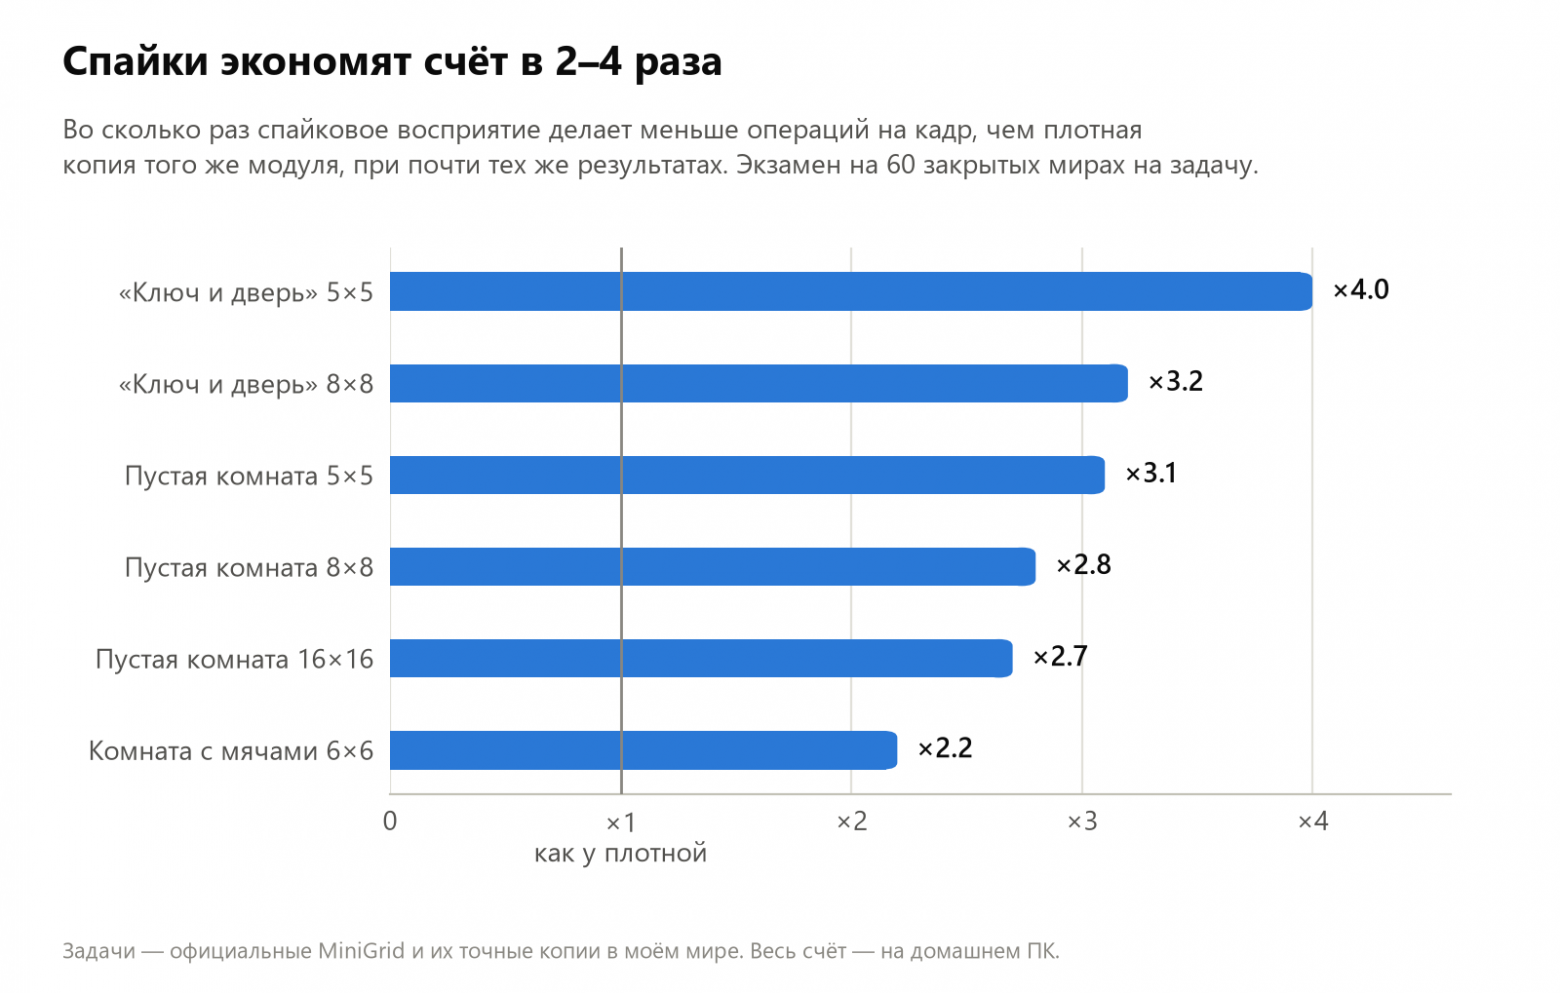
Спайки: в 2–4 раза дешевле
SNN у меня не ради красивого слова в названии. Каждое «спайковое» свойство я меряю против плотной копии того же модуля. Пока спайки дают экономию счёта: спайковое восприятие делает в 2–4 раза меньше операций на кадр, чем плотная копия, при почти тех же результатах. Экзамен — на 60 закрытых мирах на каждую задачу.
Как это выглядит изнутри
Код пишут ИИ-агенты в Claude Code. Моя часть — курс, правила честности и решения: что проверять, что считать провалом, что брать в ядро. В журнале проекта эти решения так и записаны: «слово основателя» и дата.
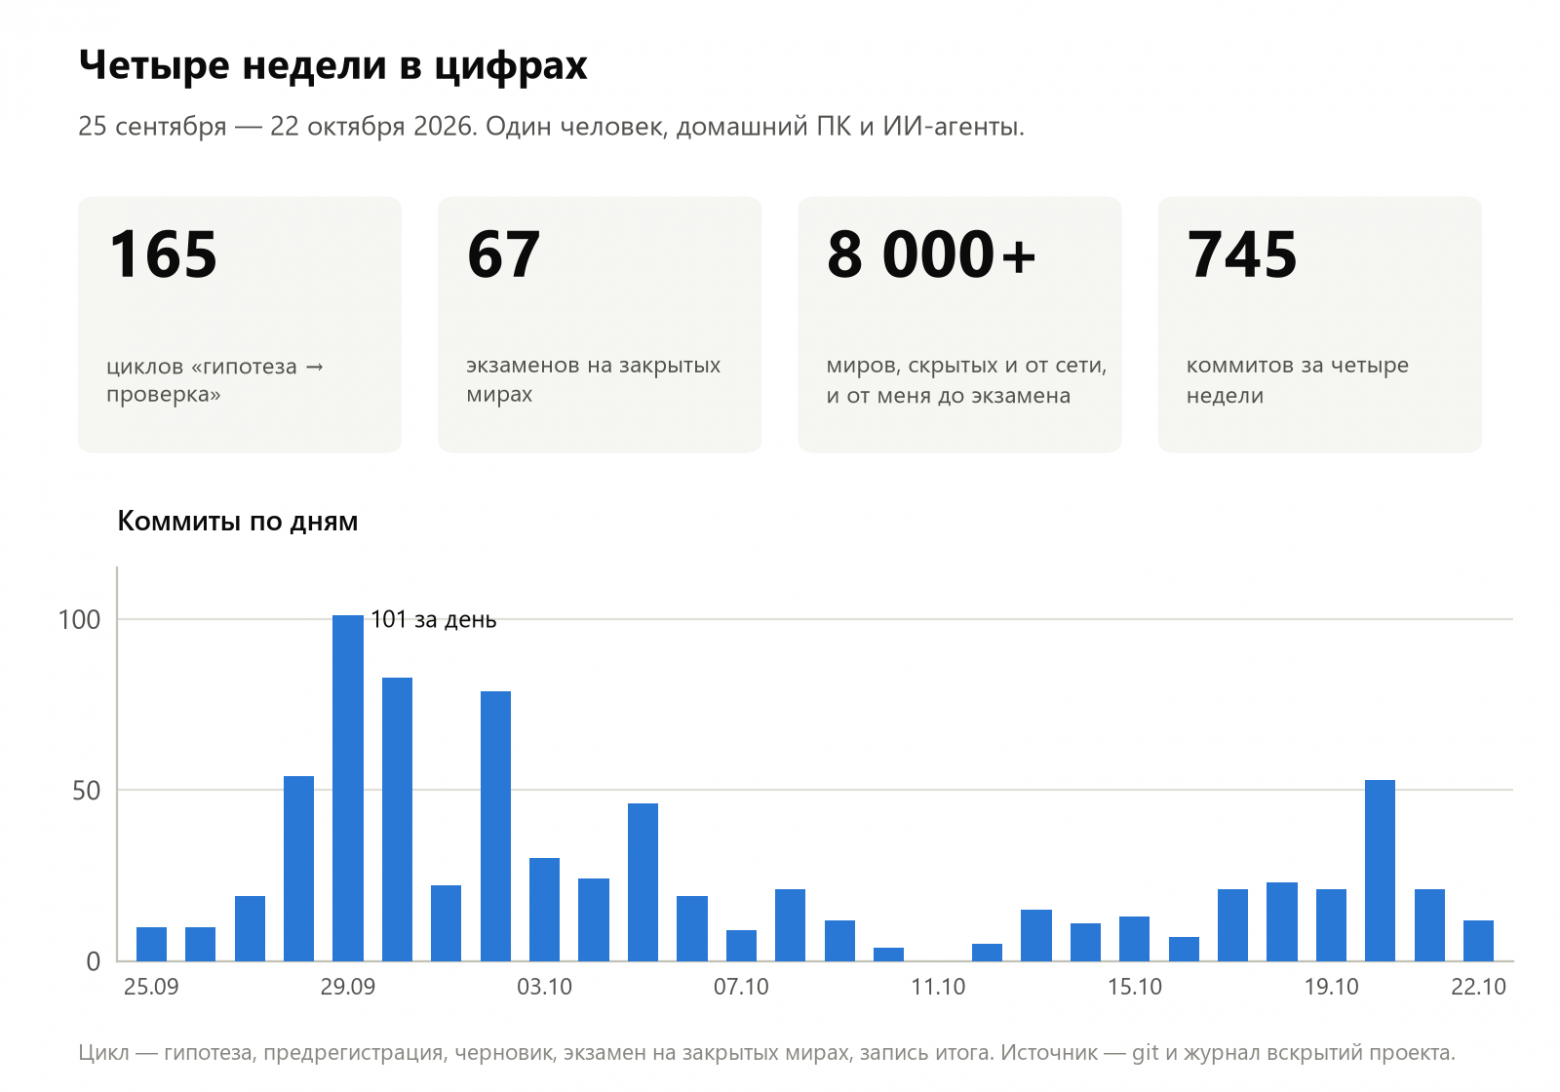
Работа идёт циклами: гипотеза → предрегистрация → черновик на открытых мирах → экзамен на закрытых → запись итога → коммит. Перед экзаменом устройство вопросов разбирает отдельный агент-критик. После цикла агент приходит ко мне с результатом, и следующий начинается только после моего решения. Длинные прогоны идут ночью, утром разбираю итоги.
За четыре недели, с 25 сентября, вышло так:
По сути, я тут прораб, а не каменщик: решаю, что строим, и проверяю, ровно ли легло.
Ищу подработку
Теперь о просьбе. Мне 20, я в Москве, и я ищу подработку AI-Native разработчиком — удалённо или в офисе. Работа ради галочки мне не нужна: ищу задачи, где пригодится то, что я умею.
А умею вот что:
— Собрать с ИИ-агентами рабочий продукт от идеи до деплоя: бота, сервис, автоматизацию, связку агентов. За год так получилось больше десяти проектов. Например, конвейер, который сам пишет, озвучивает и монтирует 30-минутные ролики с себестоимостью около $0.80 за штуку. Или мультиагентный фреймворк на MCP, где действия агентов подтверждает человек в Telegram.
— Наладить разработку на Claude Code: спеки, агенты, проверки — так, чтобы ИИ не врал ни вам, ни себе.
— Поставить честные замеры для ИИ-фич: соперник, контроль, отложенные данные и список «чего не доказано».
Чего не умею: решать задачки на собеседовании без ИИ и рассказывать базу языка по памяти. Если для вас это главное, я честно не ваш кандидат. Если нужен результат, который работает и проверен числами, — пишите.
Telegram: @cherfXcherf
Если знаете, кому это может пригодиться, перешлите им пост. Буду очень благодарен.
—
Проект живёт дальше: новые циклы, новые экзамены и новые списки «чего не доказано». Падать за этот год мне пришлось много, а сдаваться я так и не научился.
P.S. Устройство системы и её план пока закрыты, так что на «а как именно?» отвечу уклончиво, не обижайтесь. Про методику, числа и работу с агентами спрашивайте — отвечу подробно.
P.P.S. Этот текст я собирал вместе с ИИ, как и всё, что делаю. Числа сверены с журналом проекта.
ссылка на оригинал статьи https://habr.com/ru/articles/1098108/