Это статья о том как мы делали модуль автономного выполнения целей в корпоративном ИИ-ассистенте KW-7 AI.
Цель вместо вопроса
Обычно в чате человек задаёт вопрос и получает ответ. В KW-7 AI есть режим целей в котором пользователь ставит задачу крупнее: «Подготовь обзор рынка электромобилей в России: продажи по годам, доля рынка, основные марки, прогноз». Система сама составляет план, ищет в интернете, читает страницы, считает, строит графики и сохраняет отчёт. От пятнадцати минут до часа работы без участия человека.
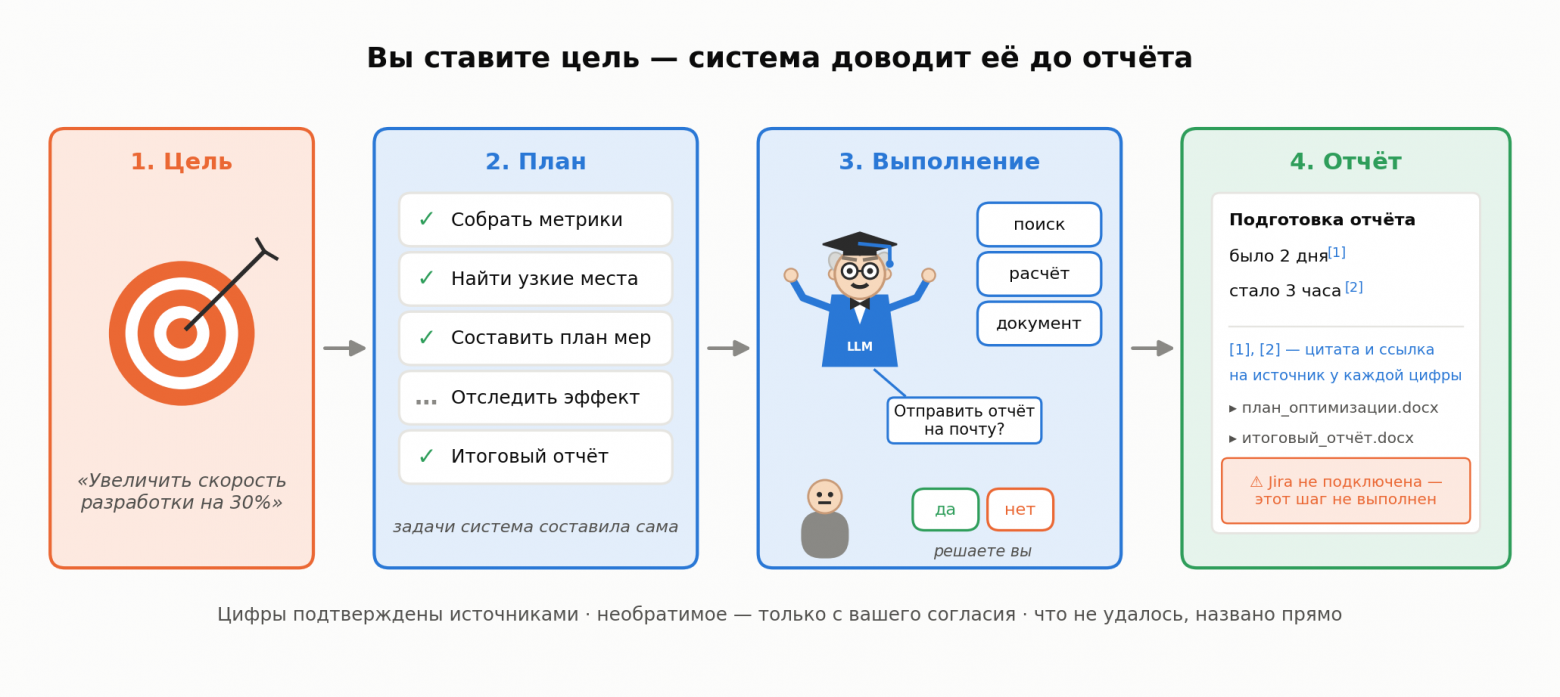
Первые прогоны выглядели отлично. Аккуратный отчёт, таблицы, графики, в конце — список источников. Встроенный в систему проверяющий, вторая модель, которая оценивает ответ, ставил «высокое качество».
А потом я начал сверять цифры с источниками.
Что было не так
Вот пример находок только по одной цели.
Цифры из ниоткуда. Ряд продаж «2019 — 1 118 … 2022 — 2 993» был подписан ссылками на три сайта. Ни на одном из трёх этих чисел не было. Модель их нарисовала на графике и сохранила в файл. Проверяющая модель поставила «высокое качество» поскольку видела развернутый ответ и наличие всех данных.
Не та величина. В другом шаге модель взяла со страницы ряд цифр и выдала его за продажи, посчитав рост «+79% и +62%». Числа на странице были. Только это была информация о том сколько машин ездит, а не сколько продано за год.
Перепутанные источники. Некоторые цифры были на одном сайте, а система сослалась на другой.
Придуманные адреса. В отчете были указаны ссылки на autostat.ru вида /news/2024/12/31/… . Таких страниц не существовало.
Самое неприятное: отчёт при этом читался убедительно. Руководитель, который понесёт такую цифру на совещание, ошибку не заметит.
Попытка первая: проверять после
Логичная мысль — проверять результат. Я написал аудит в котором после выполнения запроса система сверяет каждое число в отчёте с текстом страниц, которые реально открывались. Нет числа на прочитанных страницах — пометка.
Сначала это работало. Потом начались исключения типа: Год «2024» — не данные. Номер в рейтинге — не данные. Строка «Прочие» в таблице — остаток, а не цифра из источника и т.д.
Я провёл десять раундов доводки аудита на одной и той же цели. Каждый раунд закрывал найденную ошибку и добавлял новое правило. А следующий прогон приносил новую ложную тревогу — и правила становились всё более «про электромобили».
Хуже всего было с парком вместо продаж. Это правилами не ловилось в принципе: число на странице есть, оно верное. Неверен смысл. Создание разных ловушек и фильтров улучшало только один конкретный отчет и не работало на других отчетах.
Попытка вторая: цитата у каждой цифры
Следующая мысль была проще: пусть модель сама подкрепляет каждую цифру сноской с дословной цитатой и адресом страницы. Система механически проверяет, что фраза действительно есть на странице, а число — внутри фразы.
Стало заметно лучше. Но корень остался: модель читала страницы, держала прочитанное в истории диалога и потом пересказывала. Длинная работа — это 30–50 вызовов инструментов, история сжимается, и прочитанное в начале теряется. К моменту написания отчёта модель уже не помнила, на какой странице что было, — и восстанавливала «по смыслу».
Аудит ловил последствия. Причину он не устранял.
Попытка третья: система копит факты, модель пишет из них
Я посмотрел, как эту задачу решают в других агентных системах. В Hermes источники регистрирует код при чтении, а модель только ссылается на номер. В OpenClaw отдельный короткий вызов модели извлекает записи по схеме. В Ouroboros результат принимает не автор, а отдельный проверяющий. Из этого сложилась схема, которую я назвал журналом фактов.
Показатели. На этапе планирования модель записывает, что именно нужно найти: «продажи электромобилей, Россия, 2025», «доля рынка, 2026, январь–сентябрь». Это и есть критерий готовности.
Источники получают номера. Каждая открытая страница автоматически попадает в реестр как S1, S2, S3 — с полным текстом. Модель больше не обязана помнить, что где было.
Факты извлекаются отдельным вызовом. После чтения страницы короткий запрос к модели достаёт из неё факты по нужным показателям — с дословной цитатой. Главной модели не нужно помнить, что их надо записать.
Система проверяет каждый факт. Вот её начало, без мелочей вроде поиска дублей:
def record_fact(goal, item: dict, origin: str = "model") -> dict: metric = str(item.get("metric") or "").strip() quote = _strip_outer_quotes(str(item.get("quote") or "")) if not metric: return _reject(goal, item, "не указано, что это за показатель (metric)", origin) src = _resolve_source(goal, item.get("source")) if src is None: return _reject(goal, item, f"источник «{item.get('source')}» не найден: укажи номер S из " "результата чтения страницы", origin) if not quote: return _reject(goal, item, "нет цитаты: скопируй фразу из текста источника дословно", origin) if not _quote_on_page(quote, src.text): return _reject(goal, item, f"фразы нет в тексте {src.key} ({_host(src.url)}): скопируй её " "дословно, без пересказа", origin) value = _parse_value(item.get("value")) if value is not None and not _has_value(value, _values_of(quote)): return _reject(goal, item, f"в цитате нет числа {item.get('value')}: цитата должна " "содержать это число", origin) ...
Отклонённый факт возвращается модели с причиной. Пересказ не проходит: фраза должна стоять на странице дословно, а число — внутри неё.
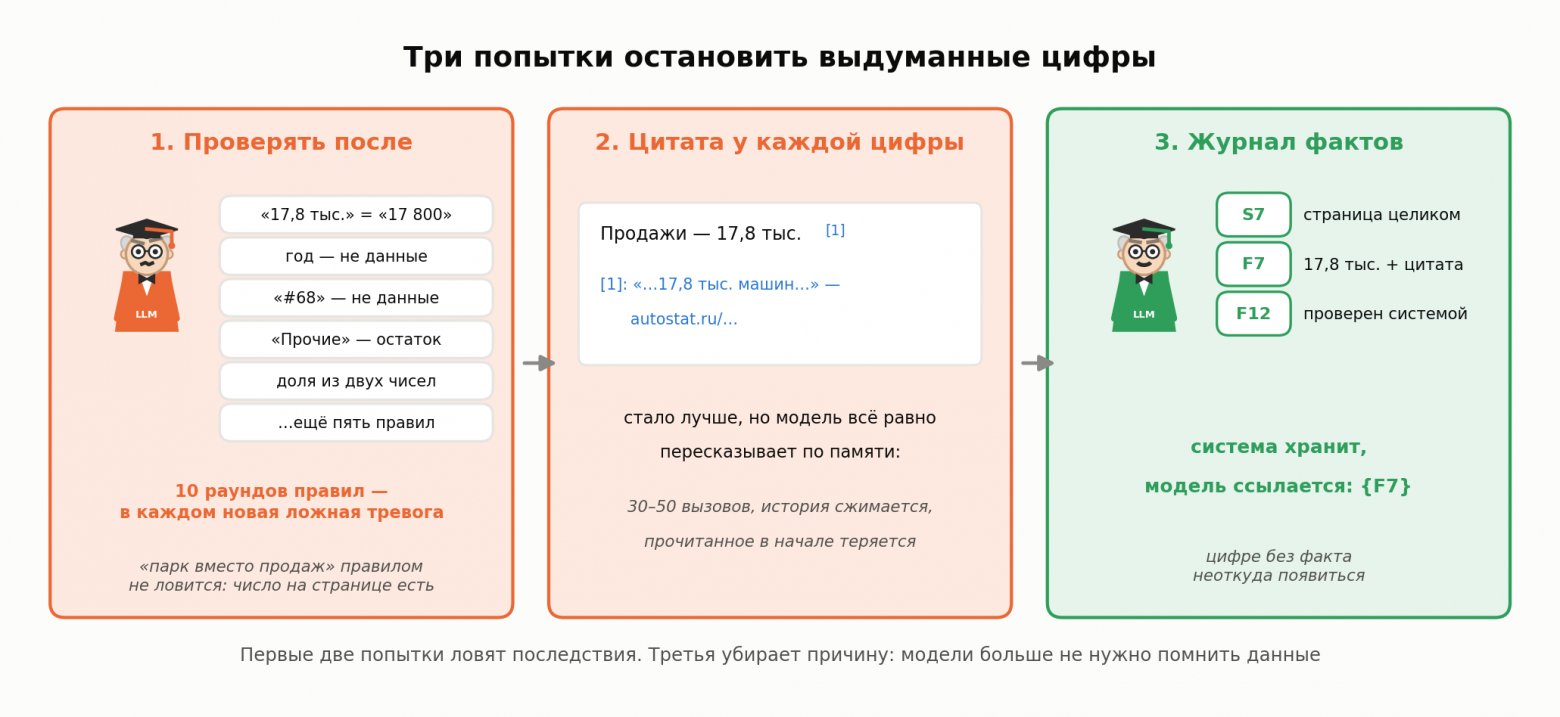
Отчёт пишется ссылками на факты. Модель пишет в тексте не «продажи выросли до 17,8 тыс.», а «продажи выросли до {F7}». Система сама подставляет значение и добавляет сноску с цитатой и адресом. Цифре, которой нет в журнале, просто неоткуда появиться. Расчёты тоже делает система: модель передаёт формулу из номеров фактов, например «(F12 − F7) / F7 × 100», а не считает в уме. Графики строятся из фактов по номерам.
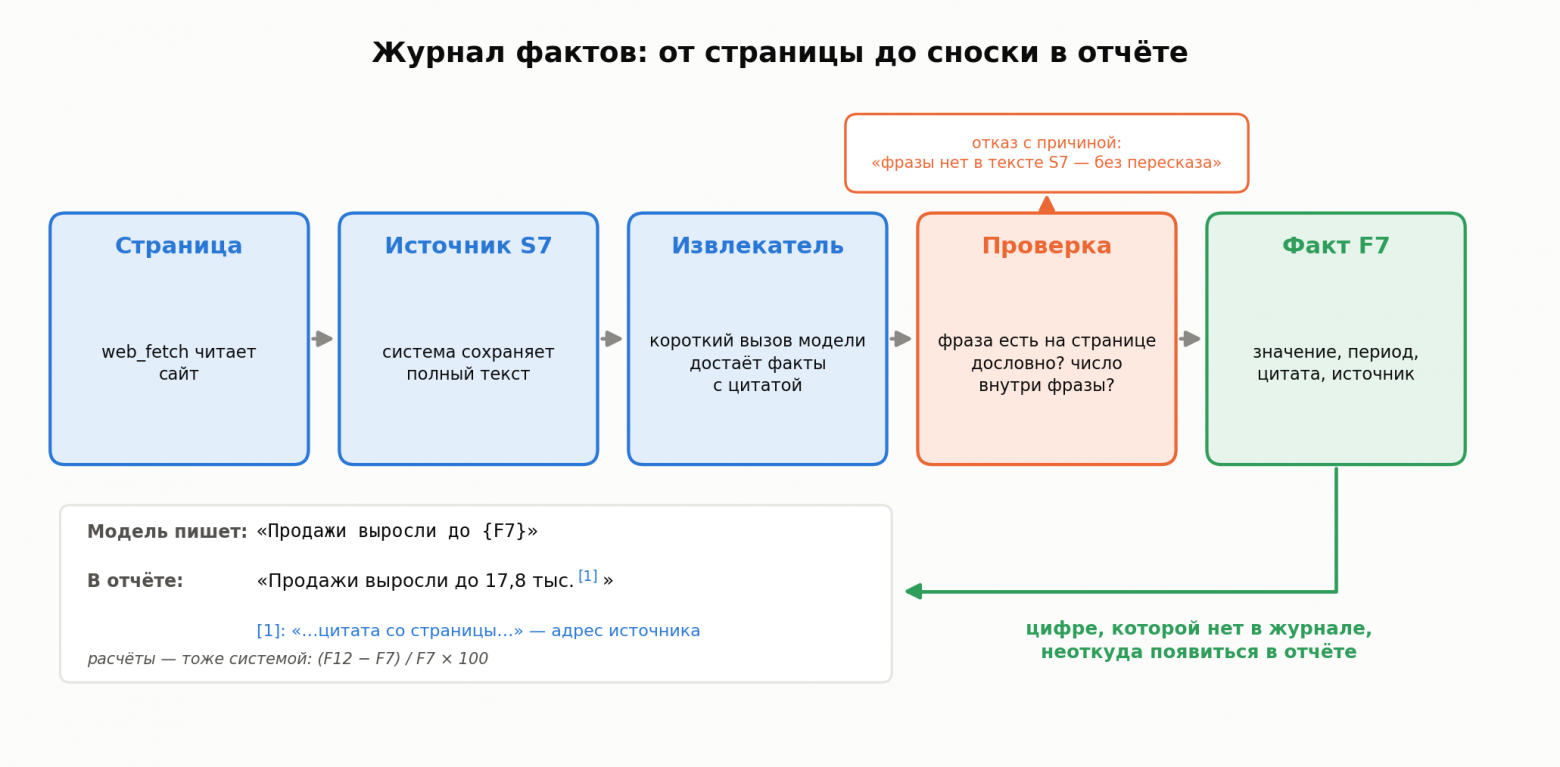
Первый прогон с журналом принял 37 фактов, большую часть нашёл извлекатель, включая данные за 2026 год. А собственную цифру модели, пересказанную «по памяти», система отклонила: такой фразы на странице не было.
Чего журналу не хватало
Журнал закрыл выдуманные цифры. Но прогоны показали ещё три дыры.
«Не найдено» означало две разные вещи. В отчёте стояло «данных нет» — и было непонятно: модель искала и не нашла, или вообще не искала.
Цитата верная, а источник — блог. В журнале фактов была цитата из личного блога на автомобильной платформе. Проверка цитаты сработала правильно: фраза на странице есть. Вопрос был в том, кто её написал. Поэтому у каждого источника теперь есть надёжность, и определяется она только по типу площадки, а не по теме: официальные ведомства и крупные агентства — высокая надежность, блоги, форумы, соцсети — низкая надежность. Факт из низкого источника в отчёте помечается, чтобы пользователь сам решил стоит ли ему доверять.
Смысловые ошибки. Цитата может быть верной, а вывод — нет. Например показатель за 9 месяцев сравнили с целым годом. Это ловит отдельная проверяющая модель — не автор отчёта. Она получает показатели, журнал с цитатами и готовый текст и перечисляет только смысловые ошибки. Каждое её замечание тоже проверяется: цитата из отчёта должна в нём быть, факты тоже должны быть в журнале. Потом у автора есть ограниченный раунд добора: найти подтверждение новым поиском, переформулировать или убрать. Так исправились ошибки из примера выше: долю переподписали верным годом, а сравнение «год против 9 месяцев» заменили на «9 месяцев против 9 месяцев», найдя нужную цифру новым поиском.
Что получилось
Я прогнал двенадцать целей на разные темы: ключевая ставка, ипотека, бензин, рынок труда, налоги для малого бизнеса, туризм, зерно, смартфоны, мировой рынок электромобилей, зарплаты Python-разработчиков, демография, маркетплейсы. Все двенадцать завершились корректно. Показатели закрыты полностью кроме двух, где система честно указала «нет данных» с причиной. Раунд добора сработал в каждой цели.
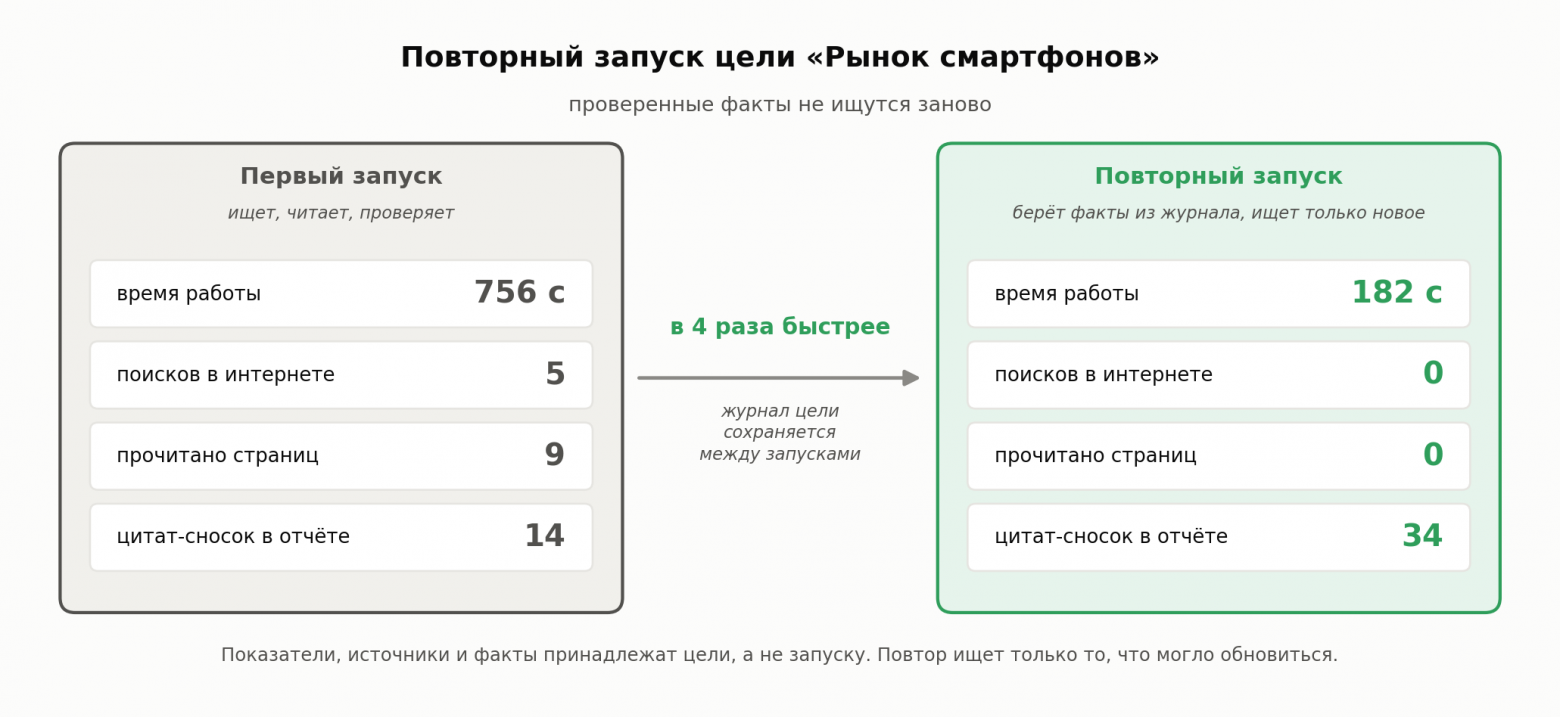
Побочный эффект, которого я не планировал: повторный запуск стал в разы дешевле. Показатели, источники и факты принадлежат цели, а не одному запуску. При доборе система показывает модели уже проверенные факты и просит искать только то, что могло обновиться. Цель «Рынок смартфонов»: первый запуск — 756 секунд, 5 поисков, 9 прочитанных страниц, 14 цитат в отчёте. Повторный — 182 секунды, ни одного нового поиска, 34 цитаты.
Что ещё не так
Конечно еще встречаются огрехи. Например иногда проверяющая модель может сообщить о расхождении между источниками. На цели «Рынок ипотеки» она поставила рядом 21,3% и 8,0% как «источники расходятся». А это две разные ставки: рыночная по новым кредитам и средняя по всему портфелю. Различать такие величины по смыслу система пока не умеет — та же проблема, что «парк вместо продаж», только в мягкой форме: теперь это не ошибка в отчёте, а лишняя строка в списке «что перепроверить». Для слабой модели Qwen3.6 27B_Q5 это простительно.
И главное ограничение: журнал гарантирует, что цифра есть в источнике и источник назван. Он не гарантирует, что цифра верна. Если ведомство опубликовало ошибку, она попадёт в отчёт — со ссылкой, по которой её можно найти. Но это уже другая история.
Выводы
Несколько дней я чинил проверку результата. Каждая заплатка закрывала один случай и открывала другой, а правила становились всё более частными. Сдвинулось дело, когда я перестал проверять, что модель написала, и сделал так, чтобы она не могла написать непроверенное.
Если вы строите похожего агента:
-
Не давайте модели помнить данные. Пусть их хранит система, а модель ссылается на номера.
-
Проверяйте факт в момент записи, а не после. Отказ с причиной модель исправляет лучше, чем пометку в готовом отчёте.
-
Считайте системой, а не моделью. Формула из номеров фактов надёжнее.
-
Требуйте явного завершения по каждому показателю. «Не найдено» без причины — это не ответ.
-
Отдавайте приёмку не автору. Вторая модель, которая видит журнал, находит то, чего автор не заметит.
-
Начинайте с цитаты, а не с правил. Правила под одну тему множатся бесконечно, проверка цитаты одинакова для любой темы.
Систему KW-7 AI можно попробовать в демо-версии : там есть пример цели, который проходит весь путь — от плана до отчёта со сносками. Буду рад вопросам в комментариях. Поделитесь как вы боретесь с выдуманными цифрами у своих агентов?
агентов?
ссылка на оригинал статьи https://habr.com/ru/articles/1098124/