ИИ озвучка текста перестала быть роботизированной: современная нейросеть для озвучки текста держит интонацию, делает паузы на запятых и читает по-русски так, что зритель коротких роликов не замечает синтеза. Но качество результата во многом зависит не от модели, а от того, как подготовлен текст. Озвучку голосом ElevenLabs можно запустить в разделе «Озвучка» сервиса Umnik AI: вписать текст, выбрать голос и скачать готовый файл.
Ниже: что изменилось с выходом Eleven v4, как переписать текст под синтез (ударения, ё, числа, паузы), какие настройки голоса реально остались в новой модели, как попасть в хронометраж ролика и не сбиться с голоса в аудиокниге, что закон и правила ElevenLabs говорят о клонировании голоса. Сквозной пример: Кирилл, автор YouTube-канала о домашнем кофе (персонаж вымышленный), озвучивает ролик на 90 секунд. Все цифры примера пересчитаны, и их легко повторить на своём тексте.
ИИ озвучка текста в 2026 году: что изменилось с Eleven v4
Сейчас в разделе озвучки текста работает модель ElevenLabs v4. Разработчик выпустил Eleven v4 и её быструю версию v4 Turbo 28 сентября 2026 года, об этом писали Unite.AI и DataNorth. Модель поддерживает больше 90 языков (у Eleven v3, по документации ElevenLabs, их больше 70), с ней работают все 17 500 с лишним голосов библиотеки, а на сайте разработчика за одну генерацию можно озвучить до 10 000 символов, это около 10 минут аудио.
Для русскоязычного автора важнее другое. В v4 вернулись профессиональные клоны голоса, которых не было в v3, а аудиотеги вроде [laughs] и [whispers], по данным DataNorth, модель выполняет надёжнее предшественницы. По данным DataNorth, ElevenLabs заявляет первое место в рейтинге синтеза речи Artificial Analysis за сентябрь 2026 года, но это слова самой компании.
Все нейросети из статьи открываются в Umnik AI из одного аккаунта в браузере на компьютере и телефоне, оплата рублями картой российского банка. Подпишись на Telegram-канал Umnik AI и получи 50 токенов бесплатно.
Нейросеть для озвучки текста на русском: ElevenLabs v4 в разделе «Аудио»
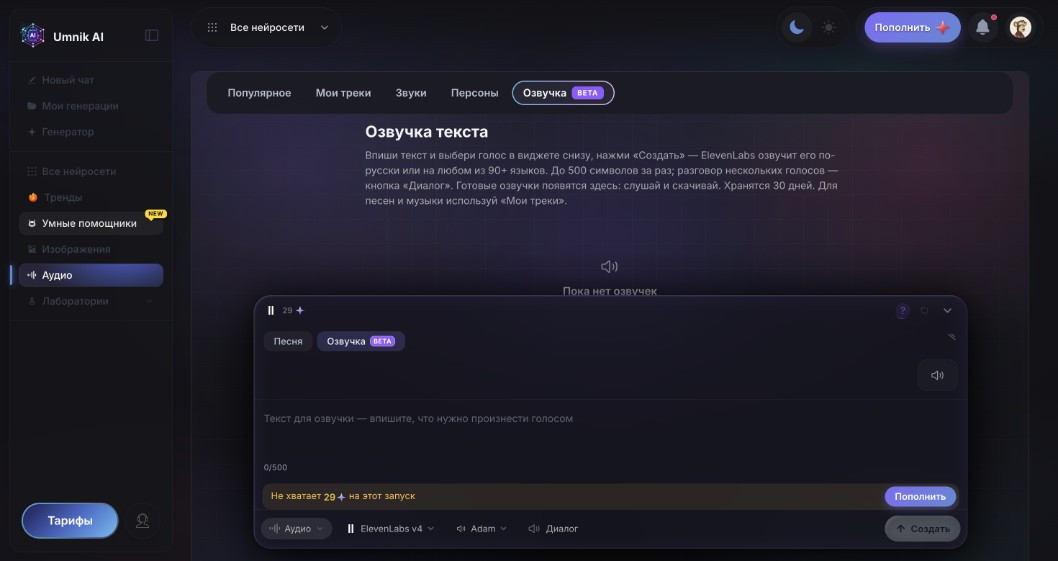
В разделе «Аудио» сервиса Umnik AI пять вкладок: «Популярное», «Мои треки», «Звуки», «Персоны» и «Озвучка» с пометкой BETA. Озвучка текста живёт в последней. Аккаунт ElevenLabs и зарубежная карта не нужны.
Что умеет инструмент.
-
Озвучивать текст по-русски или на любом из 90+ языков, как сказано на странице раздела.
-
Давать выбор голоса: фильтр по языку и подборки «Популярные», «Рассказы», «Анимация», «Разговорные», «Соцсети», «Обучение», «Реклама», «Развлечения», «Стандартные». У каждого голоса есть кнопка прослушивания и короткое описание: возраст, манера, назначение.
-
Строить разговор нескольких голосов кнопкой «Диалог».
-
Хранить готовые озвучки 30 дней: их можно прослушать и скачать.
Ограничение. За один запуск озвучивается до 500 символов. Длинный текст режьте на фрагменты по смыслу, об этом подробно ниже.
Как начать.
-
Откройте вкладку «Озвучка» и войдите в аккаунт.
-
Подпишитесь на Telegram-канал и заберите 50 бонусных токенов.
-
Нажмите на кнопку с именем голоса в виджете, выберите язык «Русский» и прослушайте 3-4 голоса из подборки под вашу задачу.
-
Вставьте первый фрагмент до 500 символов, уже подготовленный по правилам ниже, и нажмите «Создать».
-
Прослушайте результат, поправьте текст в местах ошибок и озвучьте остальные фрагменты тем же голосом.
Как подготовить текст для синтеза речи
Синтезатор читает ровно то, что написано. Документация ElevenLabs прямо советует писать числа, аббревиатуры, даты и символы полностью, словами, особенно в многоязычных моделях. Ниже пять правок, которые убирают большинство ошибок.
Числа, даты и сокращения словами
Модель может прочитать «15%» правильно, а может сказать «пятнадцать процент». Падеж числительного она угадывает по контексту, и в русском это слабое место.
Было: В 2026 г. продажи выросли на 15% и достигли 3,5 млн руб. Стало: В две тысячи двадцать шестом году продажи выросли на пятнадцать процентов и достигли трёх с половиной миллионов рублей.
То же касается сокращений: «т. к.», «и т. д.», «см.», «км/ч», «ООО», «ИП». Разворачивайте их полностью, а адрес сайта пишите так, как его произнесёт человек: «кофе дома точка ру».
Буква ё и омографы
Без ё модель выбирает между «все» и «всё», «ее» и «её» наугад. С омографами («замок», «мука», «стрелки») та же история: контекст помогает, но не всегда.
Было: Он все понял: ее замок на двери был сломан. Стало: Он всё понял: её дверной замок был сломан.
Надёжнее всего переписать фразу так, чтобы двусмысленность исчезла («дверной замок», «пшеничная мука»). Если слово всё равно звучит неверно, попробуйте выделить ударную гласную заглавной буквой («замОк») и прослушайте результат. Учтите: в документации ElevenLabs заглавные буквы описаны как способ усилить акцент, а не как разметка ударения, поэтому срабатывает это не на каждом голосе.
Паузы через пунктуацию
Теги пауз вроде <break time="1s" /> в Eleven v4 и v3 не поддерживаются, это прямо сказано в документации. Темп задают знаки препинания: точка даёт полную паузу, запятая короткую, многоточие, по данным ElevenLabs, добавляет паузу и «вес» фразе. Тире документация называет менее стабильным способом, поэтому вместо него лучше поставить точку или запятую.
Было: Итак, результат (как мы и ожидали) оказался неплохим, хотя и не идеальным, но об этом позже. Стало: Итак, результат оказался неплохим. Как мы и ожидали... Хотя и не идеальным. Но об этом позже.
Длина фраз
Фразу на 20-25 слов синтезатор часто читает на одной интонации, и к концу смысл теряется. Делите такие предложения на два-три по 8-15 слов, а скобки и вводные обороты выносите в отдельные фразы.
Было: Чтобы сварить кофе, который не убежит и сохранит пенку, нужно взять холодную воду, мелкий помол и самый слабый огонь, а турку снимать сразу, как только шапка поднимется. Стало: Кофе не убежит, если соблюсти три условия. Холодная вода. Мелкий помол. Самый слабый огонь. Турку снимаем, как только шапка начнёт подниматься.
Английские слова и аудиотеги
Названия брендов пишите кириллицей так, как их нужно произнести: «айфон», «ютуб», «эппл». Аудиотеги в квадратных скобках ([whispers], [sighs], [laughs]) по документации ElevenLabs работают в v4 и v3. Проверяйте каждый тег на коротком фрагменте: отдельные экспериментальные теги, предупреждает разработчик, срабатывают нестабильно, а символы тега тоже занимают место в лимите 500 знаков.
Совет. Текст под синтез удобно готовить в чате с нейросетями: попросите модель «переписать для озвучки, все числа и сокращения словами, ё везде, фразы не длиннее 15 слов» и сверьте результат глазами.
Настройки голоса в ElevenLabs v4: стабильность, похожесть, стиль и скорость
Советы «поставьте стабильность 30, стиль 50, скорость 1,1» из старых гайдов к новой модели подходят не полностью. Документация ElevenLabs по разделу Text to Speech прямо пишет, что ползунков Style и Speed в Eleven v4 нет, а для обеих версий v4 остаются две настройки: Stability и Similarity.
|
Настройка |
Multilingual v2 |
Eleven v3 |
Eleven v4 |
Что делает |
|---|---|---|---|---|
|
Stability (стабильность) |
есть |
есть |
есть |
ниже значение: живее и эмоциональнее, выше: ровнее, на максимуме почти монотонно |
|
Similarity (похожесть) |
есть |
нет |
есть |
насколько точно повторять исходный голос; на шумном образце копирует и шум |
|
Style exaggeration (стиль) |
есть |
не указано |
нет |
усиливает манеру диктора; разработчик советует держать на нуле |
|
Speed (скорость) |
0,7-1,2 |
нет |
нет |
темп речи; крайние значения портят качество |
|
Clone Strength |
нет |
нет |
только с профессиональным клоном |
сила влияния клона на звучание |
Стартовой точкой для стабильности ElevenLabs называет значение 50. Для рекламы и сторис её опускают, для лекции и аудиокниги поднимают.
Как это выглядит на практике. В виджете озвучки настраиваются модель и голос, ползунков стабильности там нет. Поэтому управляйте результатом тем, что доступно: выбором голоса из подходящей подборки, пунктуацией и длиной фраз. Скорость в v4 тоже задаётся текстом: короткие фразы и точки замедляют подачу, длинные предложения через запятую ускоряют.
Какой ИИ-голос для озвучки текста выбрать под задачу
Подборки голосов в разделе озвучки уже размечены по назначению, и это экономит время на прослушивание. В русском списке, например, есть голоса с описаниями «зрелый, низкий, для ТВ», «молодой, непринуждённый, для соцсетей», «зрелый, непринуждённый, разговорный».
|
Задача |
Голос и приём |
На что смотреть |
|---|---|---|
|
Короткий ролик, Shorts |
подборка «Соцсети», молодой непринуждённый голос, первая фраза до 8 слов |
зацепка в первые 3 секунды, нет провала темпа на склейках |
|
Рекламный ролик |
подборка «Реклама», уверенный голос, название продукта отдельной фразой |
бренд и цифры звучат чётко, оффер укладывается в хронометраж |
|
Обучающее видео, лекция |
подборка «Обучение», ровная подача, термины переписаны словами |
термины и аббревиатуры произнесены верно |
|
Аудиокнига, сказка |
подборка «Рассказы», зрелый спокойный голос, один голос на всю книгу |
одинаковый тембр между главами, ударения в именах |
|
Диалог, подкаст |
кнопка «Диалог», два контрастных голоса |
реплики не путаются, нет наложений |
|
Персонаж, мультфильм |
подборка «Анимация» |
характер голоса не мешает разборчивости |
Ошибка. Выбирать голос по одной фразе из превью. Как правильно. Озвучьте одним и тем же фрагментом на 300-400 знаков 2-3 кандидата и сравните на наушниках и на динамике телефона: на телефоне слышно, «тонет» ли голос под музыкой.
Озвучка видео ИИ голосом: хронометраж, тайминг и монтаж
Главная ошибка в озвучке роликов: сначала написать текст, потом обнаружить, что он не влезает в видео. Хронометраж считают до генерации.
Сколько знаков в минуте речи
По документации ElevenLabs, 10 000 символов в Eleven v4 соответствуют примерно 10 минутам аудио, это ориентир около 1 000 знаков в минуту. Для аудиокниг диктор Павел Константиновский в материале на TenChat берёт 45 000 знаков с пробелами на час прозы, то есть 750 знаков в минуту. Рабочий коридор для планирования: 750-1 000 знаков с пробелами на минуту речи.
|
Хронометраж |
Знаков при 750 в минуту |
Знаков при 1 000 в минуту |
Запусков по 500 знаков |
|---|---|---|---|
|
30 секунд |
375 |
500 |
1 |
|
60 секунд |
750 |
1 000 |
2 |
|
90 секунд |
1 125 |
1 500 |
3 |
|
3 минуты |
2 250 |
3 000 |
5-6 |
Точную скорость конкретного голоса проще замерить, чем угадать: озвучьте один фрагмент, посмотрите его длительность и поделите число знаков на секунды.
Подгонка под тайминг
Если плану нужен кадр на 7 секунд, а голос читает 13 знаков в секунду, на этот кадр приходится около 90 знаков текста. Длинно: сокращайте формулировку, а не ускоряйте звук в монтаже, ускоренный голос звучит неестественно. Коротко: добавьте паузу точкой или многоточием и перегенерируйте фрагмент.
Монтаж
-
Скачайте все фрагменты и разложите их на отдельную дорожку по порядку.
-
Срежьте тишину в начале и конце каждого файла, иначе на стыках будут дыры.
-
Подложите музыку заметно тише голоса и проверьте разборчивость на динамике телефона.
-
Субтитры делайте по готовому тексту: он уже без ошибок, и тайминг строк совпадёт с речью.
-
Видеоряд под озвучку можно сгенерировать в разделе «Видео», а затем собрать всё в монтажной программе.
Пример: ролик на 90 секунд для YouTube
Кирилл (персонаж и канал вымышленные) снимает ролики о домашнем кофе. Новый выпуск: как сварить кофе в турке без «потопа» на плите, хронометраж 90 секунд. По таблице выше ему нужно 1 125-1 500 знаков.
Шаг 1. Текст. Кирилл пишет сценарий сразу по правилам: числа словами, ё на месте, фразы короткие. Получилось три смысловых фрагмента: 406, 394 и 387 знаков, всего 1 187. Каждый укладывается в лимит 500 символов за запуск. Первый фрагмент выглядит так:
Кофе в турке убегает у всех. Сегодня за полторы минуты разберём, как сварить его без потопа на плите. Понадобятся турка на триста миллилитров, восемнадцать граммов кофе мелкого помола и сто восемьдесят миллилитров холодной воды. Именно холодной: чем дольше нагрев, тем больше вкуса успевает раскрыться. Сахар, если любите сладкий, кладите сразу, вместе с кофе. Перемешайте один раз, пока вода ещё холодная.
Шаг 2. Голос. В разделе озвучки Кирилл открывает подборку «Соцсети», прослушивает три голоса на первом фрагменте и оставляет молодой непринуждённый: он звучит как разговор на кухне, а не как диктор новостей.
Шаг 3. Замер. Первый фрагмент в примере звучит 31 секунду. Скорость голоса: 406 знаков за 31 секунду, примерно 786 знаков в минуту. Тогда 1 187 знаков дадут около 90,6 секунды. Текст править не нужно.
Шаг 4. Ошибки. На прослушивании Кирилл помечает два места: в одном месте модель ошиблась с ударением, а фраза «Не мешаем, не отходим и не открываем соседнюю вкладку с сериалом» прозвучала скороговоркой. Первое лечится заменой слова синонимом, второе точками: «Не мешаем. Не отходим. И не открываем соседнюю вкладку с сериалом». Перегенерировать нужно только второй фрагмент.
Шаг 5. Монтаж. Три файла встают на дорожку, тишина на стыках срезана, музыка подложена тише голоса. Итог: 90 секунд, один голос, три запуска.
Аудиокнига нейросетью: главы, единый голос, проверка
Аудиокнига отличается от ролика объёмом. По расчёту TenChat, час прозы занимает около 45 000 знаков, значит, повесть на 300 000 знаков звучит примерно 6 часов 40 минут. При лимите 500 символов за запуск это 600 фрагментов, поэтому книгу планируют как проект, а не как одну задачу.
Разбивка. Сначала главы, внутри глав фрагменты по абзацам. Резать текст посреди фразы нельзя: на стыке голос меняет интонацию. Глава на 12 000 знаков даёт 24 фрагмента и около 16 минут звука.
Единый голос. Один голос на всю книгу, одна и та же модель. Перед стартом составьте словарик: имена героев, топонимы и редкие слова в том написании, в котором модель читает их правильно. Если в главе 3 героиня «Алёна», она не должна стать «Алена» в главе 7.
Проверка ошибок.
-
Прослушайте каждую главу целиком, с текстом перед глазами.
-
Отмечайте время ошибки и номер фрагмента.
-
Перегенерируйте только фрагменты с ошибками, исправив в них текст.
-
Сравните громкость соседних фрагментов: скачки слышны сильнее, чем мелкие огрехи интонации.
Реалистично. В разделе озвучки удобно делать короткие форматы: сказку для ребёнка, главу-пробник, аудиоверсию статьи или поста. Роман на сотни тысяч знаков технически возможен, но займёт сотни запусков и несколько вечеров проверки.
Клонирование голоса нейросетью: закон и правила ElevenLabs
Клонировать можно только свой голос или голос человека, который дал письменное согласие. Это не формальность, а единственный безопасный вариант и по российскому праву, и по правилам разработчика.
Что говорит закон в России
Статья 152.1 Гражданского кодекса охраняет изображение гражданина, отдельной статьи о голосе в кодексе нет. В сентябре 2024 года сенаторы во главе с Андреем Клишасом внесли законопроект N 718834-8 о новой статье 152.3 «Охрана голоса гражданина»: использовать голос, в том числе синтезированный, можно только с согласия человека. Совет при президенте по кодификации гражданского законодательства в октябре 2024 года проект не поддержал (писали «Ведомости» и Sostav), а в январе 2025 года, по данным «Интерфакса», его не поддержало правительство.
Позиция правительства при этом важна для практики: запись голоса уже относится к биометрическим персональным данным, и её обработка по общему правилу требует согласия. В октябре 2025 года Национальная федерация музыкальной индустрии и Союз дикторов направили поправки к проекту, сообщал «Коммерсантъ», а в январе 2026 года, по данным ТАСС в пересказе 78.ru, депутаты предложили запретить роботам в массовых звонках имитировать живой голос. Сообщений о том, что закон об охране голоса принят, мне найти не удалось.
Что требует ElevenLabs
-
Instant Voice Clone. Хватает 10 секунд записи, документация рекомендует 1-2 минуты чистой речи. По данным Unite.AI о запуске v4, для любого клона нужно подтверждённое согласие владельца голоса.
-
Professional Voice Clone. Минимум 30 минут записи, оптимум 2-3 часа. Создать его можно только из своего голоса: в документации прямо сказано, что даже с согласием человека клонировать чужой голос нельзя. Владение голосом проверяют чтением фраз в микрофон.
Если ваш голос использовали без согласия, ElevenLabs принимает жалобы через форму Unauthorized Use of Voice, указанную в правилах использования.
В разделе «Аудио» во вкладке озвучки используются голоса из библиотеки, а свой голос можно записать во вкладке «Персоны»: там он становится вокальным профилем для песен. Голос чужого человека не загружайте туда без его письменного согласия.
ИИ озвучка текста бесплатно: что дают бесплатные синтезаторы
Запрос «озвучка текста нейросеть бесплатно на русском» приводит к трём типам решений: облачные API крупных компаний, открытые модели для запуска на своём компьютере и бесплатные квоты коммерческих сервисов. Лучшие нейросети для озвучки текста отличаются не столько голосом, сколько тем, сколько ручной работы остаётся на вас.
|
Решение |
Что бесплатно или почём |
Ударения и паузы |
Кому подходит |
|---|---|---|---|
|
Яндекс SpeechKit |
платный облачный API, в API v1 1 342 рубля с НДС за миллион символов |
плюс перед ударной гласной ( |
разработчикам: озвучка в приложении, ботах, колл-центре |
|
Silero |
открытые модели, запуск на процессоре без видеокарты |
ударения и ё ставит отдельная модель, вручную плюсом ( |
тем, кто готов запустить Python или читалку в Windows |
|
ElevenLabs напрямую |
10 000 кредитов в месяц на бесплатном тарифе, это около 10 минут, по оценке разработчика; платные тарифы от 6 долларов в месяц (Unite.AI) |
ударение через текст, паузы пунктуацией, аудиотеги |
тем, у кого есть аккаунт на сайте разработчика и способ оплаты в долларах |
|
Раздел «Озвучка» с ElevenLabs v4 |
50 токенов за подписку на Telegram-канал |
как в ElevenLabs v4, до 500 знаков за запуск |
авторам роликов и коротких аудио, оплата рублями |
По SpeechKit данные из документации Яндекса: до 5 000 символов на запрос, а разметка, по её же формулировке, лишь подсказка для синтеза. По Silero данные из статьи разработчика Александра Вейсова на Хабре от 30 декабря 2025 года: модель для 20 языков России и СНГ работает локально под Windows как экранная читалка и в «Балаболке», генерирует до 100 секунд звука в секунду в идеальных условиях.
Вывод. Бесплатные синтезаторы хороши для черновиков и внутренних задач, но требуют разметки или установки. Для ролика, который увидят тысячи людей, решает естественность: озвучка текста голосом нейросети не должна выдавать робота, и здесь нейросеть ElevenLabs с моделью v4 сейчас в числе лидеров.
Пошаговый план озвучки
-
Посчитайте хронометраж. Минуты ролика умножьте на 750-1 000 знаков, это бюджет текста.
-
Подготовьте текст. Числа и сокращения словами, ё везде, фразы 8-15 слов, паузы точками.
-
Нарежьте фрагменты. По смыслу, до 500 знаков каждый, без разрывов посреди фразы.
-
Выберите голос. В разделе озвучки прослушайте 2-3 голоса из подборки под задачу на одном фрагменте.
-
Замерьте скорость. Знаки первого фрагмента поделите на его секунды и сверьте с бюджетом.
-
Озвучьте остальное. Тем же голосом, без смены модели.
-
Проверьте на слух. С текстом перед глазами, исправляйте текст, а не звук.
-
Соберите в монтаже. Срежьте тишину, подложите музыку, сделайте субтитры по тексту. Если понравилось, условия на странице тарифов, оплата рублями в Umnik AI.
Частые вопросы
Есть ли ИИ озвучка текста бесплатно?
Для старта да. За подписку на Telegram-канал Umnik AI начисляют 50 токенов, их можно потратить на пробную озвучку короткого фрагмента.
Нужна ли карта иностранного банка?
Нет. Оплата рублями картой российского банка, аккаунт ElevenLabs не нужен.
Какая модель ElevenLabs работает в разделе озвучки?
В разделе озвучки выбрана ElevenLabs v4. Это последнее поколение моделей синтеза речи разработчика, оно вышло 28 сентября 2026 года.
Сколько текста можно озвучить за раз?
До 500 символов за один запуск. Длинный текст делите на смысловые фрагменты и озвучивайте одним голосом.
Как сделать, чтобы ИИ озвучка на русском звучала без ошибок в ударениях?
Ставьте ё, переписывайте омографы синонимами («дверной замок» вместо «замок»), пишите числа словами. Если слово всё равно звучит неверно, замените его или перестройте фразу.
Можно ли настроить скорость речи?
В Eleven v4, по документации ElevenLabs, ползунка скорости нет. Темп задают текстом: короткие фразы и точки замедляют подачу, длинные предложения ускоряют.
Подходит ли озвучка для монетизируемых роликов на YouTube?
Голос из библиотеки подходит для озвучки ваших роликов, но условия площадки по контенту с синтезом меняются, поэтому перед монетизацией проверьте актуальные правила YouTube.
Можно ли клонировать голос знаменитости?
Нет. Использовать чужой голос без согласия рискованно и по российскому праву о персональных данных, и по правилам ElevenLabs: профессиональный клон разработчик разрешает делать только из своего голоса.
Можно ли озвучить диалог двумя голосами?
Да, в разделе озвучки для разговора нескольких голосов есть кнопка «Диалог».
Заключение: ИИ озвучка текста без студии и диктора
Качество синтеза в 2026 году упирается не в модель, а в текст: числа словами, ё на месте, короткие фразы и паузы точками дают больше, чем любая настройка. В Eleven v4 ползунков стиля и скорости больше нет, поэтому подачу задают выбором голоса и пунктуацией, а хронометраж считают заранее, из расчёта 750-1 000 знаков на минуту.
Для 90-секундного ролика это три запуска и одна проверка на слух, для аудиокниги проект на несколько вечеров. Клонируйте только свой голос или голос с письменного согласия владельца. Начните с одного фрагмента в озвучке текста голосом ElevenLabs v4 в Umnik AI.
ссылка на оригинал статьи https://habr.com/ru/articles/1098128/