Предупреждение
Исследовательский прототип на бесплатной Tesla T4 в Google Colab. Не медицинское изделие.
Коротко
Я обучил модель искать кровоизлияния на КТ головы: 82 пациента, около 2500 срезов, 318 с кровоизлиянием. Разбивал данные по пациентам, проверял на пяти фолдах.
На первом фолде получил AUC 0.963. После полной кросс-валидации осталось 0.931. Первый результат оказался удачным, но нерепрезентативным.
Дальше выяснилось несколько вещей:
-
Модель на одном костном окне даёт AUC 0.86. Откуда она берёт сигнал, до конца разобраться не удалось.
-
Добавление сегментации почти не меняет AUC, зато поднимает AP с 0.70 до 0.80–0.83. Максимум карты чаще попадает в очаг: 72% против 54% у Grad-CAM.
-
При целевой полноте 95% по срезам специфичность составляет 0.70–0.75.
-
На уровне пациентов целевые 95% не выдерживаются: модели пропускают 2–3 пациентов из 36, а ложных тревог получается от 8 до 18 на 46 исследований без кровоизлияния.
Поэтому дальше речь не столько об AUC, сколько о том, что происходит после выбора порога.
Какую задачу я решал
Я рассматривал модель как инструмент сортировки: поднять в очереди исследования, которые стоит посмотреть первыми. Не поставить диагноз вместо врача, а сократить время до просмотра подозрительного снимка.
В такой постановке ошибки неравноценны. Пропущенное кровоизлияние может иметь тяжёлые последствия. Ложная тревога означает лишний пересмотр исследования, хотя при большом числе таких тревог нагрузка тоже становится проблемой. Поэтому меня интересовало, сколько ложных срабатываний придётся принять, чтобы пропускать как можно меньше кровоизлияний.
Сразу оговорюсь: это учебный проект на небольшой выборке. Клинической валидации нет. Оснований использовать его для диагностики тоже нет; для медицинского применения понадобятся отдельная проверка и регистрация, в России в Росздравнадзоре.
Данные
Я взял открытый набор с Kaggle: vbookshelf/computed-tomography-ct-images. Лицензия лежит в LICENSE.txt внутри архива. Полный RSNA на сотни гигабайт для этого эксперимента в Colab был неудобен; кроме того, для доступа нужно принять правила соревнования.
В наборе:
-
82 пациента и 2501 срез.
-
Кровоизлияния у 36 пациентов.
-
318 срезов с кровоизлиянием и масками очагов.
-
Таблица с типами кровоизлияний и отметками о переломах.
Редких типов мало: внутрижелудочковых кровоизлияний 24 среза, субарахноидальных 18. Поэтому я не стал делать многоклассовую модель и ограничился вопросом: есть ли кровоизлияние на срезе.
Изображения сохранены в JPG в двух окнах: brain и bone. Это существенное ограничение. В исходной КТ значения измеряются в единицах Хаунсфилда, а окно переводит выбранный диапазон в яркость. Здесь это преобразование уже выполнено: восстановить исходные значения из JPG нельзя.
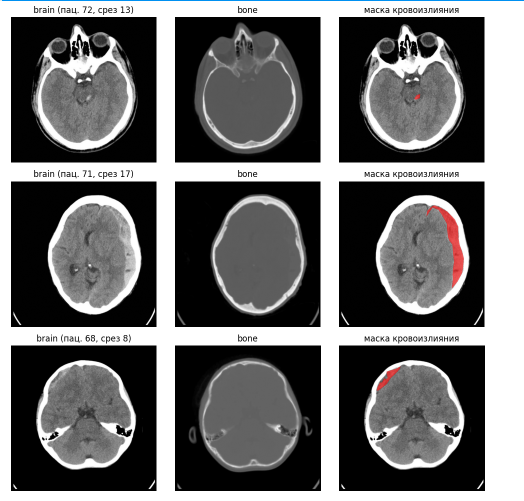
Третий канал я получил растяжением контраста мозгового окна:
def stretch(brain): m = brain > 10 lo, hi = np.percentile(brain[m], [20, 99.5]) return ( np.clip((brain - lo) / (hi - lo), 0, 1) * 255 ).astype(np.uint8)x = np.stack([brain, bone, stretch(brain)])
То есть на входе два готовых окна и контрастная версия одного из них. Называть это «тремя окнами Хаунсфилда» было бы неправильно. Субдурального окна здесь нет.
Как проверял
Соседние срезы одного пациента похожи. Если случайно раскидать их между обучением и валидацией, можно получить хорошую метрику за счёт узнавания пациента, а не кровоизлияния.
Я использовал StratifiedGroupKFold на пять фолдов: каждый пациент целиком попадал в один фолд.
Ещё несколько правил:
-
Не выбирал лучшую эпоху по валидации, использовал последнюю.
-
Подбирал пороги по четырём другим фолдам, не по тому, на котором считал результат.
-
Считал доверительные интервалы бутстрепом по пациентам, а не по отдельным срезам.
Модель и обучение
В основе EfficientNet-B0 из timm, размер входа 320×320. Обучение: BCE с pos_weight, AdamW, OneCycle, fp16. Двенадцать эпох одного фолда занимали около трёх минут на T4.
Из-за взвешенной функции потерь выход модели нельзя считать откалиброванной вероятностью. Порог 0.5 я не рассматривал как клинически осмысленный. Для сравнения использовал AUC, AP и характеристики в выбранных рабочих точках.
Первый фолд выглядел лучше, чем весь эксперимент
На первом фолде получилось AUC 0.963 и AP 0.859. На остальных AUC был в пределах 0.92–0.94, AP от 0.65 до 0.72.
Результаты по всем фолдам:
|
Вход |
AUC по срезам, 95% ДИ |
AP, база 0.127 |
AUC по пациентам |
|---|---|---|---|
|
Brain + bone + растянутый brain |
0.931 [0.902; 0.952] |
0.699 |
0.914 |
|
Только brain |
0.910 [0.876; 0.939] |
0.698 |
0.834 |
|
Только bone |
0.861 [0.817; 0.898] |
0.388 |
0.850 |
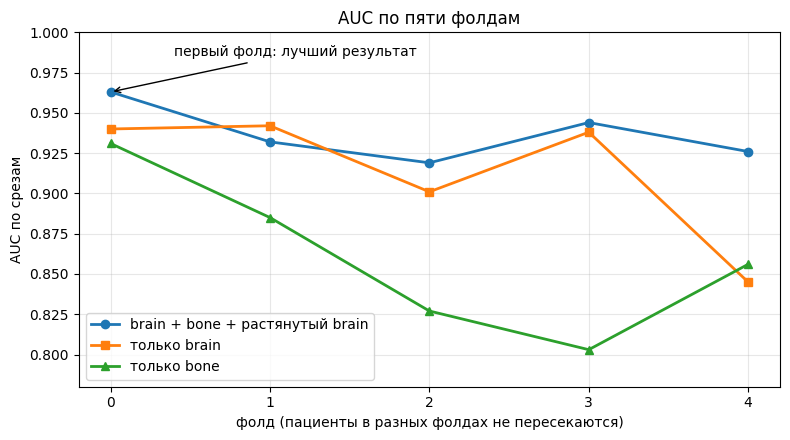
Если бы я остановился после первого запуска, история получилась бы заметно красивее. Но описывала бы она в первую очередь удачное разбиение.
Почему модель работает на костном окне
Результат bone_only меня удивил больше всего. На костном окне мозг виден плохо, а модель всё равно получает AUC 0.861 и AP 0.388 при доле положительных срезов 0.127.
Я проверил несколько возможных объяснений.
Переломы
Кровоизлияние есть в 62% срезов с переломом и в 9% срезов без него. Связь сильная, и модель вполне могла ей пользоваться.
Но после исключения срезов с переломами AUC остался высоким: 0.923 у полной модели и 0.838 у bone_only. Одними переломами результат не объясняется.
Уровень среза
Положение среза внутри исследования само по себе оказалось информативным. Классификатор без изображений, знающий только относительное положение среза, дал AUC 0.753.
При сравнении внутри одного уровня качество полной модели было ниже общего: 0.854 в середине исследования и 0.933 в конце. У bone_only получилось 0.755 и 0.832 соответственно.
Значит, часть результата связана с уровнем среза. Но и этого недостаточно, чтобы объяснить весь сигнал.
Даёт ли кость прибавку к мозговому окну
Разность AUC полной модели и brain_only составила +0.021 с доверительным интервалом [−0.002; +0.049]. Интервал включает ноль. На этих 82 пациентах я не могу уверенно утверждать, что добавление костного окна улучшает результат.
Источник сигнала в bone_only так и остался открытым вопросом. Возможные объяснения: остаточная видимость мягких тканей в JPG, особенности контура головы, различия в укладке или сканировании. Это гипотезы, а не результаты проверки.
Попадает ли Grad-CAM в кровоизлияние
В наборе есть врачебные маски, поэтому тепловые карты можно было оценить не только на глаз.
На первом фолде при пороге 0.5 модель нашла 48 из 72 положительных срезов. Для Grad-CAM получил следующее:
-
Внутри маски находилось 0.02 суммарного тепла карты при случайном уровне около 0.01. Обогащение составило 1.9 раза.
-
Максимум карты попадал в маску с допуском 10 пикселей в 54% случаев.
-
Для мелких очагов попадание составляло 46%, для крупных 62%.ъ
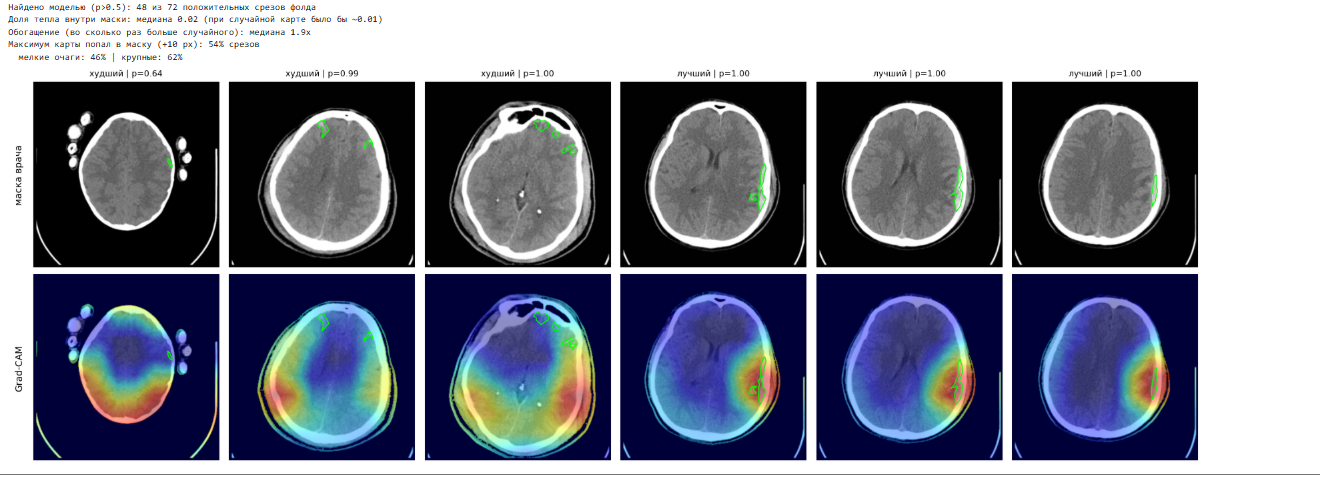
Рисунок 3 — Слева худшие случаи, а зелёный контур означает разметку врача
Связь с очагом есть, но по таким результатам я бы не называл Grad-CAM надёжной локализацией.
Что изменилось после добавления сегментации
К энкодеру я добавил лёгкий FPN-декодер. Модель одновременно решала две задачи: классификацию среза и сегментацию очага. Для сегментации использовал BCE и Dice по врачебным маскам.
По AUC почти ничего не произошло: 0.932 вместо 0.931. Разность +0.001, доверительный интервал [−0.021; +0.022].
По AP разница оказалась заметнее:
|
Оценка |
AP |
Разность с обычной моделью, 95% ДИ |
|---|---|---|
|
Обычный классификатор |
0.699 |
Не применимо |
|
Классификатор мультизадачной модели |
0.795 |
+0.097 [+0.037; +0.168] |
|
Оценка по карте сегментации |
0.826 |
+0.130 [+0.051; +0.223] |
Максимум карты сегментации попадал в очаг у 71% положительных срезов. На том же первом фолде, среди найденных срезов, получилось 72% против 54% у Grad-CAM.
При этом медианный Dice составил всего 0.23. Контуры получались неточными; задача осложнялась тем, что медианная площадь очага составляла около 422 пикселей, примерно квадрат 20×20.
Сегментация помогла лучше ранжировать наиболее уверенные находки и чаще указывать на очаг. Но это ещё не означало, что модель стала лучше для режима «пропускать как можно меньше».
Что происходит при высокой полноте
Для каждого фолда я выбирал порог по другим фолдам и затем измерял специфичность на отложенных данных.
|
Целевая полнота |
Обычная модель |
Мультизадачная: классификатор |
Мультизадачная: сегментация |
Ансамбль трёх оценок |
|---|---|---|---|---|
|
90% |
0.79 |
0.80 |
0.69 |
0.85 |
|
95% |
0.70 |
0.62 |
0.48 |
0.75 |
|
98% |
0.64 |
0.38 |
0.22 |
0.59 |
В таблице указана специфичность; полнота в первом столбце обозначает цель при подборе порога, а не гарантию для новых данных.
Модель с сегментацией выиграла по AP, но в режиме высокой полноты уступила обычному классификатору. Особенно сильно это проявилось у оценки по карте сегментации.
Ансамбль усреднял ранги трёх оценок. Он оказался лучше при целях 90% и 95%, но хуже обычной модели при 98%. Для прибавки примерно в пять процентных пунктов специфичности я не считал доверительные интервалы, поэтому считать её установленным преимуществом рано.
И ещё важен состав потока. Допустим, положительных срезов в нём 5%. Это моё допущение, не оценка реальной распространённости. Тогда при чувствительности 95% и специфичности 75% настоящими будут около 17% тревог. На одну верную придётся примерно пять ложных.
Порог для целевой полноты выбирался так:
def thr_for_sens(t, s, target): pos = np.sort(s[t == 1]) return pos[int(np.floor((1 - target) * len(pos)))]
На данных, по которым выбирается порог, эта процедура обеспечивает полноту не ниже заданной. На новых пациентах она может оказаться ниже, что и произошло дальше.
Ошибка с переходом от срезов к пациентам
Врачу нужно выделить исследование, а не набор отдельных срезов. Я взял максимум оценок по срезам пациента и сначала получил обнадёживающий результат: ни одного пропущенного пациента из 36.
Проблема обнаружилась в специфичности. Она составляла от 0.0 до 0.3.
Я перенёс на пациентов порог, подобранный по срезам. Если в исследовании около тридцати срезов, достаточно одного случайного превышения, чтобы пометить всё исследование. Поэтому «никого не пропустили» в данном случае означало в том числе «пометили почти всех».
После подбора порога на уровне пациентов результаты стали скромнее. Среди проверенных вариантов было от 2 до 5 пропущенных пациентов из 36 и от 8 до 18 ложных тревог на 46 отрицательных пациентов.
Выбирать лучшую строку я не стал: к этому моменту на одной выборке были просмотрены 24 варианта, и такой выбор дал бы оптимистичную оценку.
Для примера: ансамбль с максимумом по срезам при целевой полноте 95% пропустил 3 пациентов из 36. Фактическая полнота составила 91.7%, ложных тревог было 8 из 46. У вариантов с двумя пропусками полнота составила 94.4%.
Таким образом, заявленные 95% на новых пациентах не были достигнуты. При 36 положительных пациентах один пропуск меняет полноту почти на три процентных пункта.
Какие очаги пропускаются
При целевой полноте 95% по срезам модель с сегментацией пропустила:
-
2 из 160 срезов с крупными очагами.
-
19 из 158 срезов с мелкими очагами.
Обычные классификаторы ошибались ровнее: около 10 пропусков среди мелких очагов и 6–7 среди крупных.
У моделей разные ошибки. Это даёт ансамблю возможность улучшить результат, хотя, как видно из таблицы, не на любой рабочей точке.
Демо
Для проверки собрал интерфейс на Gradio. Он принимает пару изображений в мозговом и костном окнах, запускает десять моделей, пять обычных и пять мультизадачных, и показывает предсказанный очаг. Рядом выводятся результаты кросс-валидации для выбранной целевой полноты: 90%, 95% или 98%.
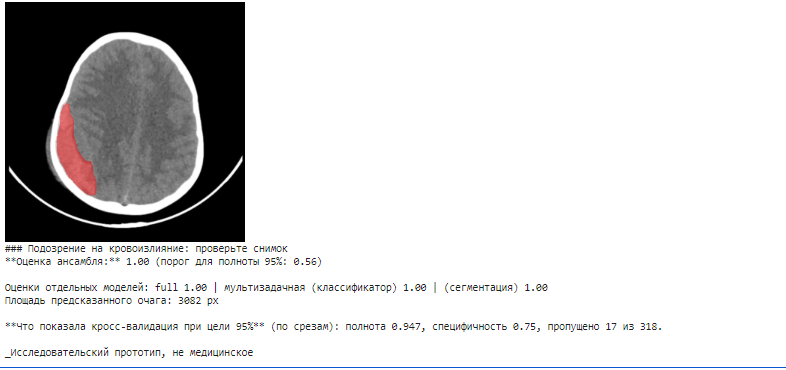
Публичную ссылку я не предоставляю. Демо не предназначено для загрузки реальных снимков пациентов. А примеры из учебного набора не подходят для независимой проверки всего ансамбля: входящие в него модели видели эти данные при обучении.
Чего этот эксперимент не показывает
Главное ограничение связано с размером и происхождением выборки. Здесь 82 пациента из одного набора, из них только 36 с кровоизлиянием. Внешней проверки нет. Поведение на других сканерах, протоколах и окнах яркости неизвестно.
Есть и другие ограничения:
-
Вместо исходных DICOM используются JPG. Единиц Хаунсфилда и субдурального окна нет.
-
Для отдельных редких типов кровоизлияния данных недостаточно: 24 среза с внутрижелудочковыми и 18 с субарахноидальными.
-
В наборе много эпидуральных кровоизлияний: 173 из 318 положительных срезов. Результат нельзя без проверки переносить на другой состав случаев.
-
Качество на мелких очагах хуже, чем на крупных.
-
Не установлено, чем именно пользуется модель на костном окне.
-
Часть вариантов сравнивалась на одной и той же небольшой выборке.
Это исследовательский прототип, а не проверенная система медицинской сортировки.
Что я вынес из работы
Самая полезная часть эксперимента началась после первого AUC 0.963.
Проверка на всех фолдах снизила оценку. Костное окно показало, что модель может находить неожиданные признаки. Врачебные маски позволили проверить карты внимания, а не просто выбрать красивые примеры. Добавление сегментации улучшило AP, но ухудшило часть рабочих точек с высокой полнотой. Переход от срезов к пациентам обнаружил ошибку с порогом.
Для этой задачи я бы в первую очередь смотрел на число пропущенных пациентов и ложных тревог при заранее выбранной процедуре настройки. AUC и AP полезны, но сами по себе на эти вопросы не отвечают.
ссылка на оригинал статьи https://habr.com/ru/articles/1098766/