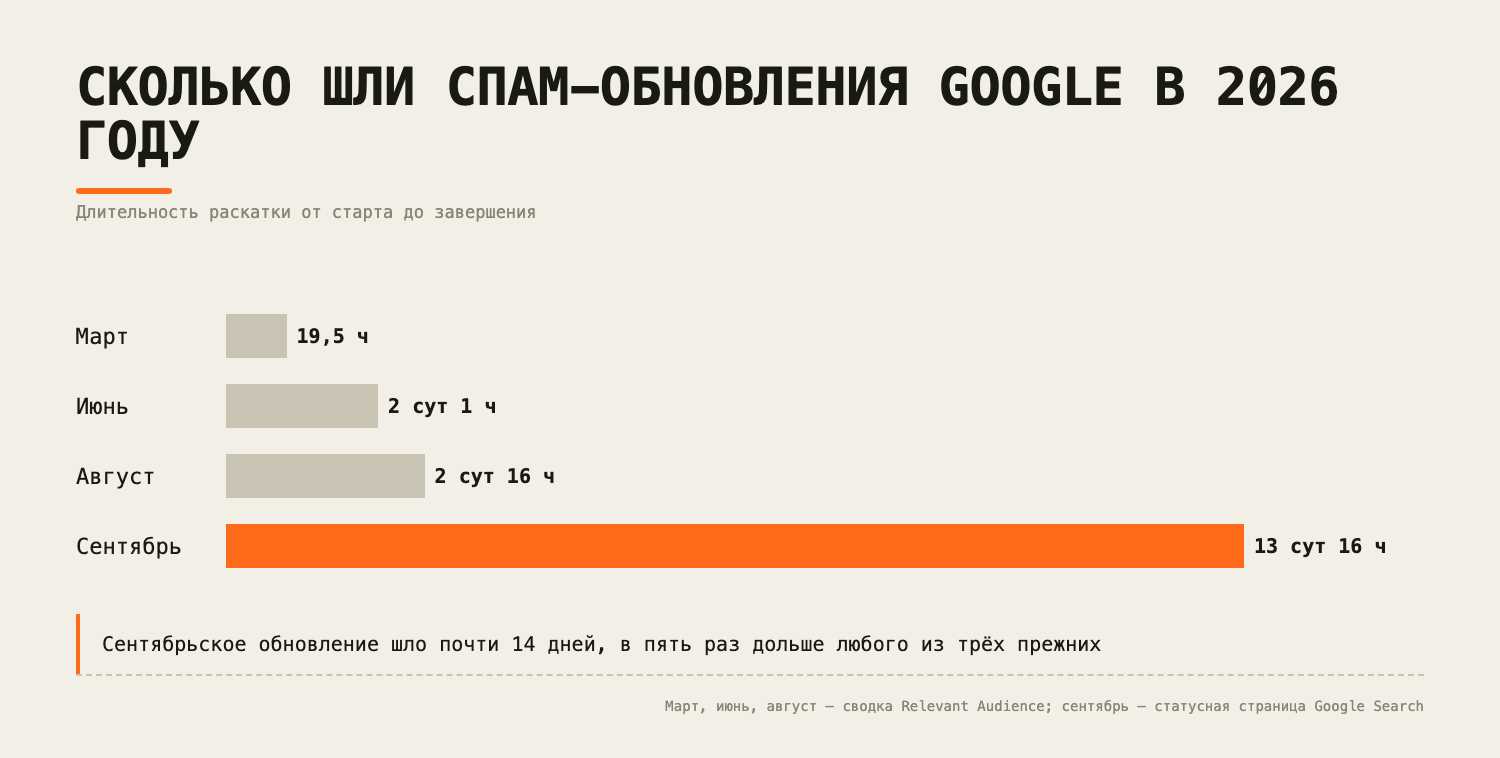
Сентябрьское обновление Google против спама шло с 24 сентября по 8 октября, почти 14 дней, для всех языков. Это в пять раз дольше любого из трёх прошлых спам-обновлений 2026 года (сводка Relevant Audience). Если часть страниц сайта написана нейросетью, вопрос в том, не выглядят ли они массовым производством. Я проверяю это коротким скриптом на Python, а порог похожести выбираю сам: у Google его нет.
Что Google сказал про сентябрьское обновление и сгенерированный контент
Что обновление займёт до двух недель, Google написал в первый же день: на статусной странице стоит «may take up to two weeks». В посте Search Central, как его пересказывает ppc.land, это «normal spam update» без новых правил. Цель обновления Google не назвал; Барри Шварц 28 сентября писал, что она пока не до конца известна.
Связь с ИИ тоньше, чем в заголовках. На Search Central Live в Барселоне Дуй Нгуен из Google сказал (в записи участника): «There have been more spam updates recently because there is so much more new content». Речь о росте нового контента, слова «ИИ» в этой фразе нет. Связку с ИИ сделал заголовок Search Engine Roundtable, то есть это вывод издания.
Правило для сгенерированного контента сформулировано через цель. По политике о спаме нарушение, scaled content abuse, это много страниц, созданных главным образом ради манипуляции выдачей, и способ создания неважен. Нейросети стоят в списке примеров: «generate many pages without adding value for users». Страница о генеративном ИИ обновлена 1 октября и требует вручную проверять факты перед публикацией. Что в ней изменилось, не видно: журнала правок нет.
По исследованию Ahrefs статьи, написанные нейросетью почти целиком, индексируются хуже: 40,35% против 49,28% у страниц с низкой долей ИИ. Но это корреляция: что причина в ИИ, а не в качестве текста, она не доказывает.
Какие признаки массового производства страниц можно измерить кодом
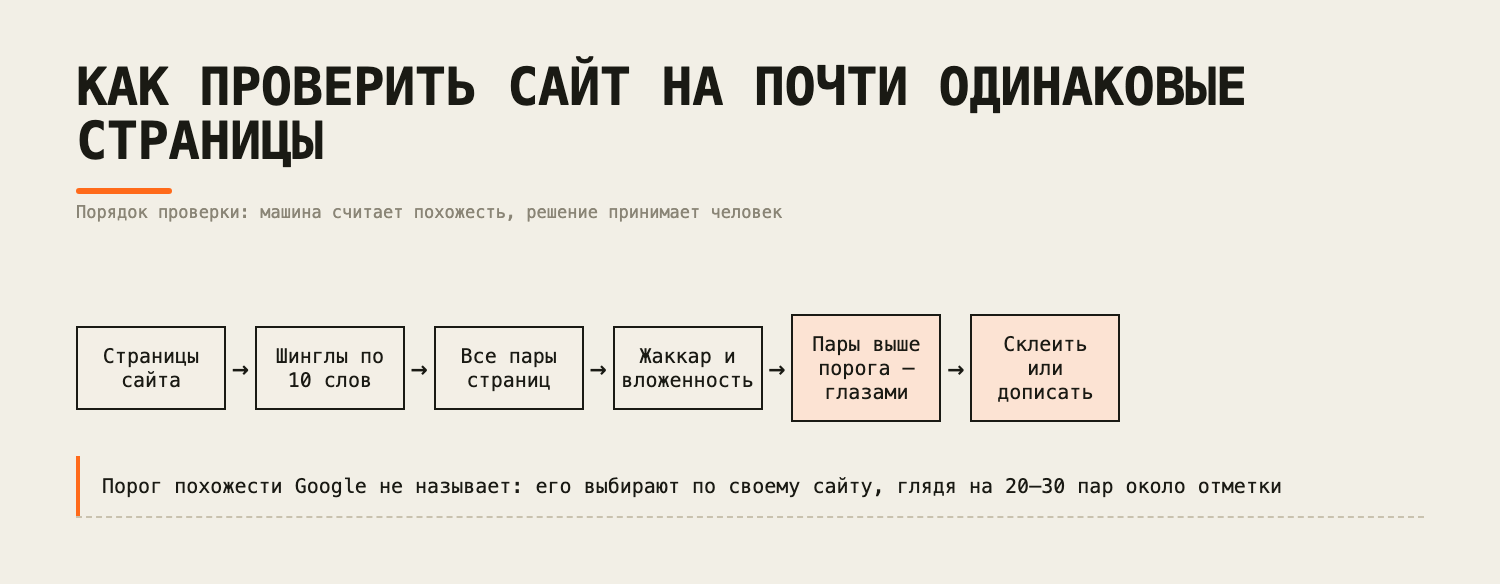
Кодом я измеряю одно: насколько страницы похожи друг на друга. Текст режу на шинглы, перекрывающиеся куски по десять слов подряд. Сами шинглы, сходство и вложенность определены в статье Бродера «On the resemblance and containment of documents», длину в десять слов взяли авторы «Syntactic Clustering of the Web» (ссылка ниже). Множества шинглов двух страниц я сравниваю двумя числами.
Сходство Жаккара: общие шинглы делим на все шинглы обеих страниц. Оно симметрично и годится для сравнения пар. Вложенность: какая доля шинглов страницы A лежит в странице B. Она несимметрична и ловит короткую страницу, целиком спрятанную в шаблоне длинной.
Порога спама нет ни у Google, ни у Бродера. Единственный обоснованный порог, который я нашёл, 0,5: с ним авторы «Syntactic Clustering of the Web» кластеризовали 30 млн страниц AltaVista. Это порог исследователей. У Google шкала почти дубликата есть только в патенте на SimHash, и она про обход сайтов, а не про спам.
Скрипт на Python, который ищет почти одинаковые страницы
import refrom itertools import combinationsdef shingles(text, w=10): words = re.findall(r"\w+", text.lower()) return {" ".join(words[i:i + w]) for i in range(len(words) - w + 1)}def jaccard(a, b): return len(a & b) / max(len(a | b), 1)def containment(a, b): return len(a & b) / max(len(a), 1)sh = {url: shingles(text) for url, text in pages.items()} # pages: {адрес: основной текст}for (u1, a), (u2, b) in combinations(sh.items(), 2): print(f"{u1:18} {u2:18} jaccard={jaccard(a, b):.2f} " f"in={containment(a, b):.2f} out={containment(b, a):.2f}")
Пример синтетический: три страницы доставки по одному шаблону с разными городами (у Омска добавлено одно длинное предложение) и статья про возврат товара.
/delivery/kazan /delivery/perm jaccard=0.69 in=0.82 out=0.82/delivery/kazan /delivery/omsk jaccard=0.46 in=0.82 out=0.52/delivery/kazan /blog/returns jaccard=0.00 in=0.00 out=0.00/delivery/perm /delivery/omsk jaccard=0.46 in=0.82 out=0.52/delivery/perm /blog/returns jaccard=0.00 in=0.00 out=0.00/delivery/omsk /blog/returns jaccard=0.00 in=0.00 out=0.00
Казань и Пермь отличаются одним словом, но Жаккар у них 0,69: название города портит десять окон подряд. Омск получает 0,46, ниже исторических 0,5, хотя 82% страницы Казани лежат внутри омской. Поэтому шаблон я ищу по вложенности, а Жаккар оставляю для сравнения пар.
Как выбрать порог похожести и что делать с найденными страницами
-
Прогоните свои сгенерированные страницы скриптом и посмотрите распределение вложенности, а не одно число. В
pagesкладите только основной текст страницы, без меню, футера и хлебных крошек: сквозные блоки дают общие шинглы всем страницам и завышают вложенность. Достать основной текст можно, например, библиотекой trafilatura. Перебор пар растёт квадратично: на небольшом сайте его хватает, а на тысячах страниц его заменяют подписями MinHash из datasketch. -
Порог берите по своему сайту: откройте глазами 20–30 пар около выбранной отметки и решите, где страницы не несут разного содержания.
-
Для найденных групп спросите о пользе, а не о способе написания: что читатель узнаёт на странице Омска, чего нет на странице Казани. Нет ответа — склеить с соседней или дописать.
Что скрипт не докажет и чего я не знаю про сентябрьское обновление
Шинглы показывают масштаб одинаковости, а не нарушение: Google оценивает цель и пользу, и похожие карточки товаров с разным содержанием могут быть в порядке. Подробных разборов сайтов, пострадавших именно в сентябре, я не нашёл. Лили Рэй 28 сентября, на пятый день после запуска, предполагала удар по шаблонным программным страницам, вероятно сгенерированным ИИ. Diib в своём раннем срезе за первые три дня увидел падение медианной доли визитов из поиска Google с 34% до 31%, но сам называет его «an early read, not a verdict», а Google эти данные не подтверждал. Длительность прошлых обновлений я взял из сводки одного агрегатора, по статусной странице Google сверил только сентябрьское.
ссылка на оригинал статьи https://habr.com/ru/articles/1099640/