В этой статье я расскажу, как устроена звуковая подсистема Nintendo Gameboy, с какими проблемами я столкнулся, пытаясь в реальном времени генерировать звук и синхронизировать с ним картинку. Статья является продолжением моей прошлой публикации (https://habr.com/ru/articles/908752/).
Введение
Сейчас все знают про закон Парето — эмпирическое правило, согласно которому 20% усилий дают 80% результата, в то время как оставшиеся 20% результата требуют 80% времени. Моя работа над эмулятором Gameboy еще раз его подтвердила. После того как довёл до рабочего состояния реализацию CPU и PPU, я взялся за APU — Audio Processing Unit, чтобы наконец‑то можно было играть в тетрис под «Коробейников». В итоге, разобраться в том, как же всё‑таки правильно генерировать звуки, оказалось непростой задачей.
Отдельно стоит сказать про восприятие. Человек ощущает звук быстрее, чем картинку: мозг обрабатывает звуковой сигнал заметно быстрее зрительного. Для эмулятора это оборачивается неприятной асимметрией — требования по реальному времени к звуку оказываются жёстче, чем к видео. Пропуск в звуке слышен сразу и отставание звука от картинки раздражает сильнее, чем подтормаживающий кадр.
Что такое звук?
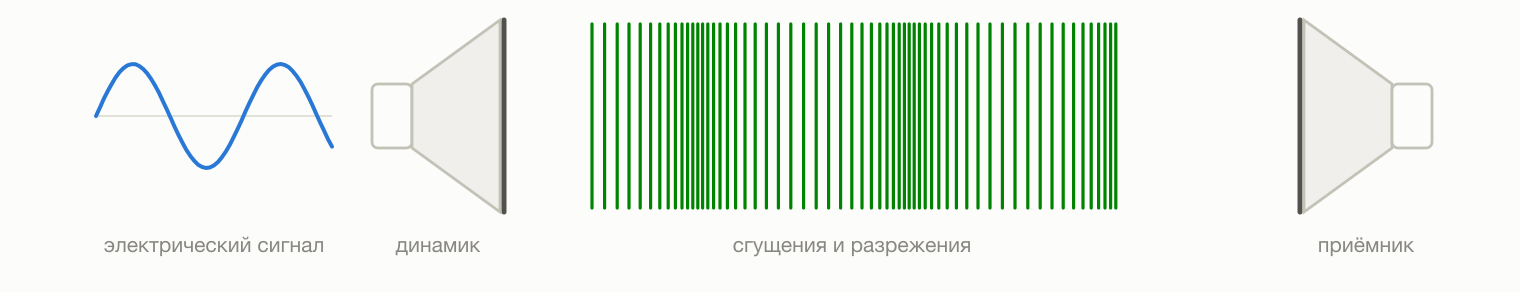
Звук — это механическая волна, распространяющаяся в упругой среде. Колебания среды воспринимаются нами через сложную систему органов слуха — волны, попав в слуховой проход, приводят к колебаниям барабанной перепонки, которая передаёт их через цепочку маленьких костей среднего уха, что приводит к колебаниям жидкости во внутреннем ухе, что, в свою очередь, приводит к нервным импульсам, передаваемым в мозг.
Сейчас для создания звука в электронных приборах используются динамики. Они в общем‑то повторяют строение уха в обратном направлении. Так, электрические сигналы заставляют катушку, прикреплённую к мембране, колебаться в поле постоянного магнита; мембрана, раскачиваясь, создаёт звуковые волны заданных характеристик. Тут еще надо отметить, что этот сигнал имеет аналоговую природу — амплитуда и частота сигнала могут меняться в широких пределах.
Программная архитектура воспроизведения звука на ПК
Благо нам, как разработчикам эмуляторов, не нужно манипулировать электрическими импульсами напрямую — эту задачу берёт на себя звуковая карта. Она получает описание в виде сэмплов — дискретных значений, фиксирующих звук в виде смещения мембраны динамика в конкретный момент времени. Человек слышит звук в ограниченном диапазоне, верхняя граница которого составляет около 20 кГц, и это позволяет уменьшить частоту дискретизации без потери качества. Так, стандарт для Audio CD 44.1 кГц, согласно теореме Найквиста‑Шеннона, способен точно воспроизвести любой слышимый сигнал. Современным эталоном цифрового аудио стали при этом 48 кГц — значение выбрано, потому что оно нацело делится на привычные 24, 25 и 30 кадров в секунду для «плавного» видео, что было важно для ранней цифровой техники.
Из‑за высокой скорости восприятия человеком звука по сравнению с видео — стек воспроизведения должен подчиняться строгим real‑time ограничениям. Если взглянуть на таблицу процессов в Ubuntu, то можно увидеть, что демон PulseAudio будет иметь очень низкий nice и подчиняться real‑time планировщику.
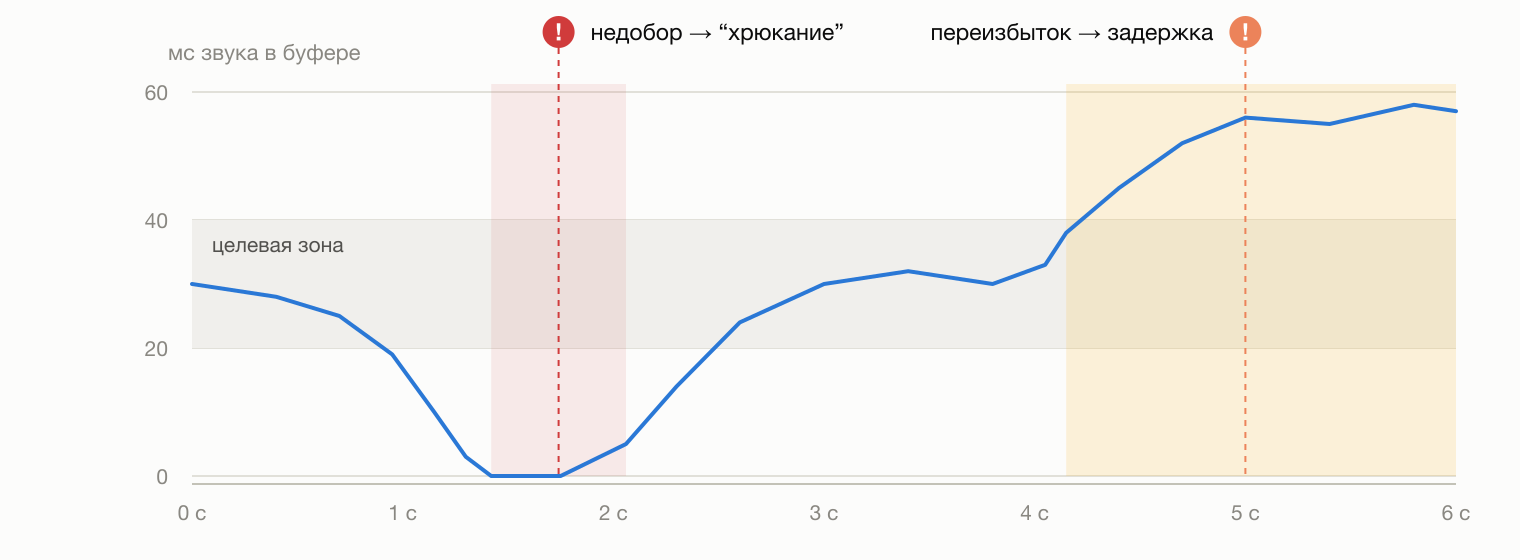
Есть две крайности, которые мы хотим избегать при работе со звуком — недостаток сэмплов и их слишком большое количество. При недостатке сэмплов звук резко обрывается, сигнал на динамик больше не поступает, динамик резко переходит в нейтральное положение, что даёт характерное «хрюкание». При избытке сэмплов аудиокарта не успевает их обрабатывать, из‑за чего появляется запаздывание звука от картинки на экране.
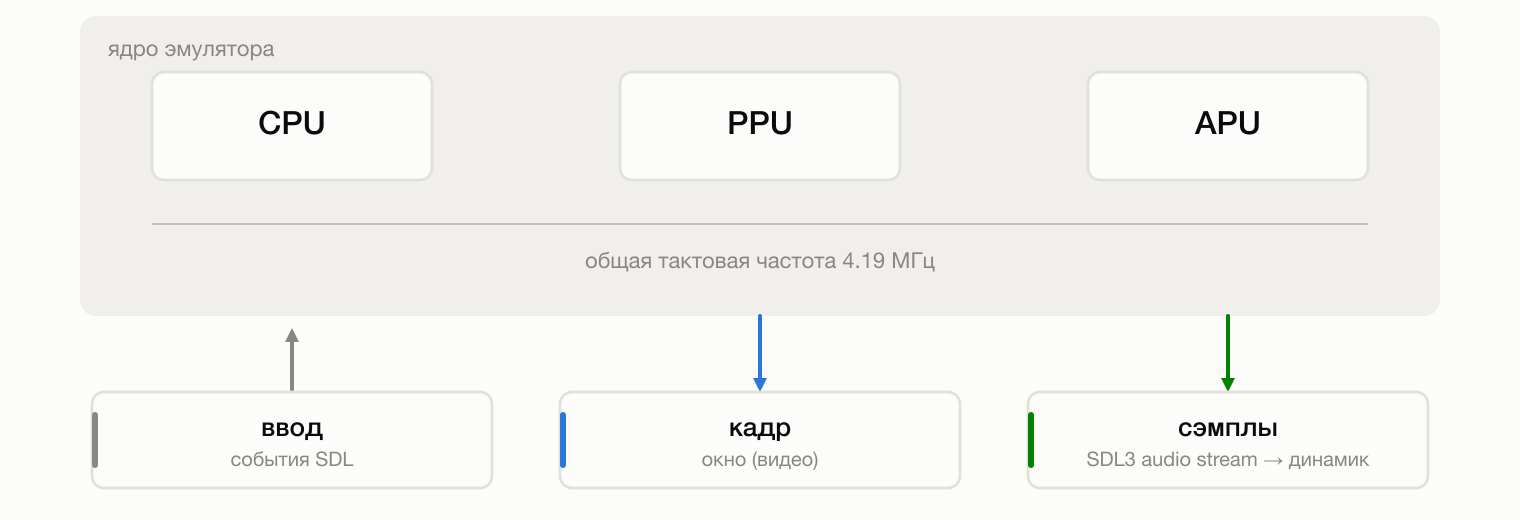
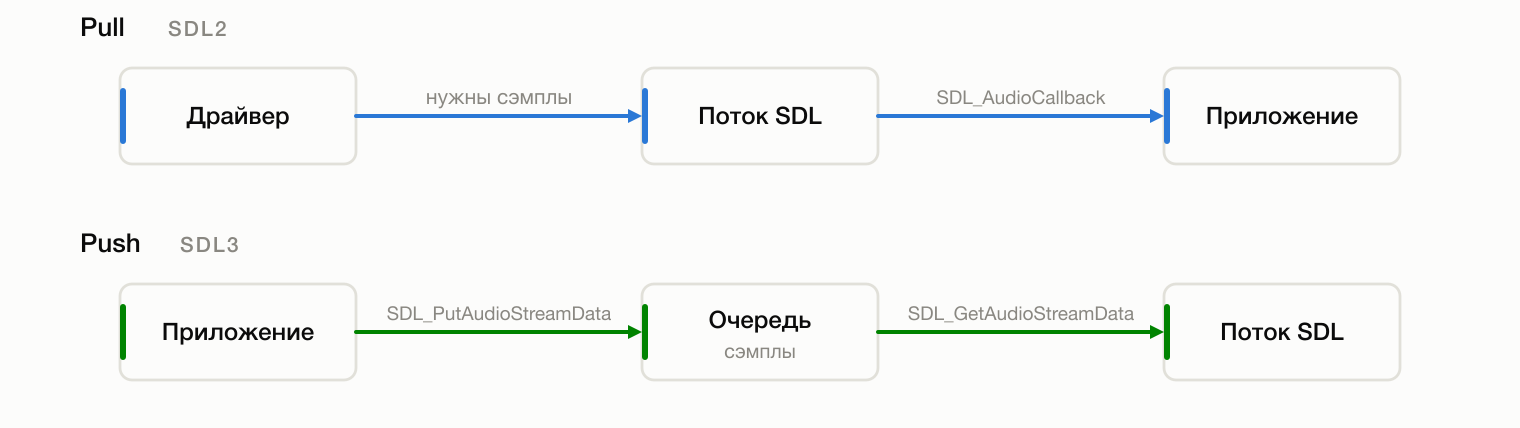
Сколько сэмплов нужно в конкретный момент времени, знает только сама аудиокарта — а она работает асинхронно относительно остального оборудования. На прикладном уровне это проявляется в том, что аудио библиотеки работают либо в pull‑, либо в push‑режиме. При старте библиотека запускает отдельный высокоприоритетный поток, который с одной стороны общается с операционной системой, а та уже передаёт задачи драйверу. С другой стороны — этот поток по мере необходимости пытается откуда‑то получить сэмплы. Так как все приложения имеют разную специфику, а источник сэмплов может быть разным, программист должен передать в библиотеку функцию, которую поток будет вызывать, когда понадобятся новые сэмплы — так работает pull‑модель. Альтернативный вариант: где‑то внутри библиотеки может быть выделена очередь сэмплов. Когда приложению нужно воспроизвести звук, оно отправляет сэмплы в эту очередь, а поток библиотеки забирает нужное количество данных и передаёт дальше — это push‑модель. Детали реализации конкретных библиотек могут отличаться. Например, профессиональные решения типа ASIO обходят ОС и работают с драйвером карты почти напрямую. Или, к примеру, разработчики библиотеки SDL перешли с жёсткой real‑time pull‑модели в SDL2 на более простую push‑модель со встроенным смешиванием в SDL3, оставив возможность привязать callback, вызываемый из звукового потока.
Переход на push‑модель с возможностью создавать несколько звуковых потоков стал важным нововведением в SDL3. Так, библиотека готова к тому, что сэмплы могут кончиться и тогда автоматически начнется «тишина». А от переизбытка сэмплов спасает то, что у нас есть возможность измерить количество сэмплов в очереди функцией SDL_GetAudioStreamQueued. Так с приходом SDL3 работать со звуком стала сильно проще.
Архитектура звукового движка Gameboy (APU)
Теперь перейдём к описанию генерации звука на самом Gameboy. Все компоненты консоли связаны друг с другом крепче, чем в современном ПК. В контексте APU это выражается в том, что все его счётчики тактируются от частоты CPU — 4 194 304 Гц, при этом переключение фаз и смена сэмплов происходят реже: счётчики каналов получаются из деления главной частоты. В общем, если быть точным, то прямоугольные каналы переключаются в диапазоне от 64 Гц до 131 кГц, волновой выдаёт сэмплы от 1 кГц до 2 МГц, а шум тактируется от 4.6 Гц до 524 кГц.
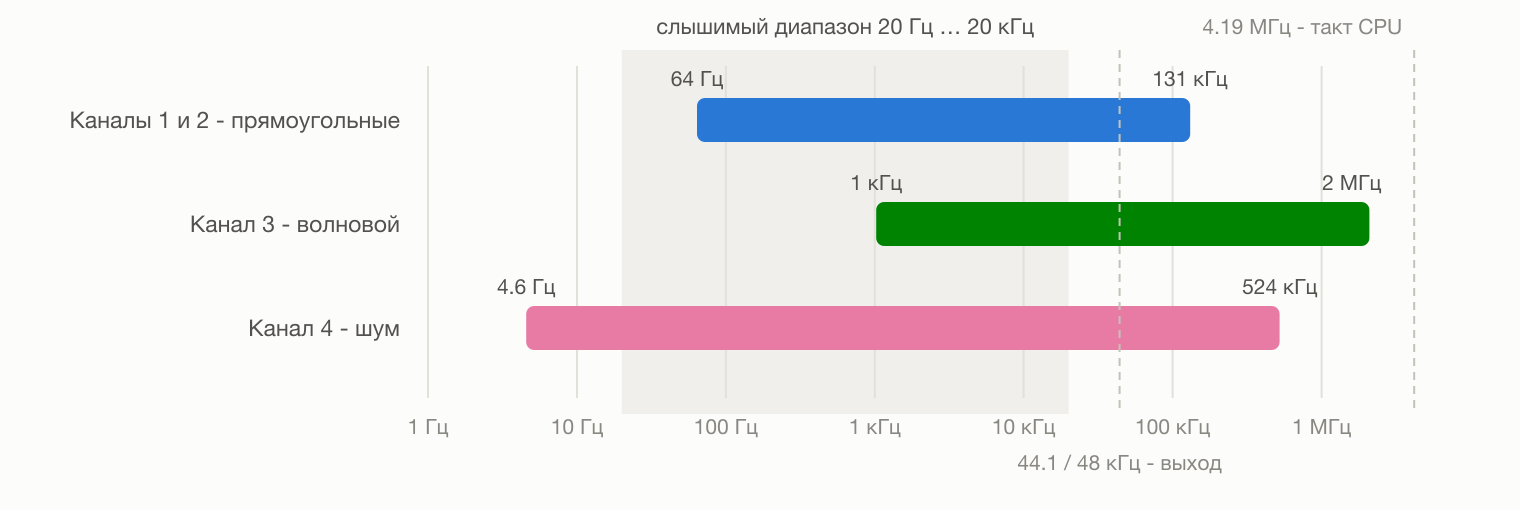
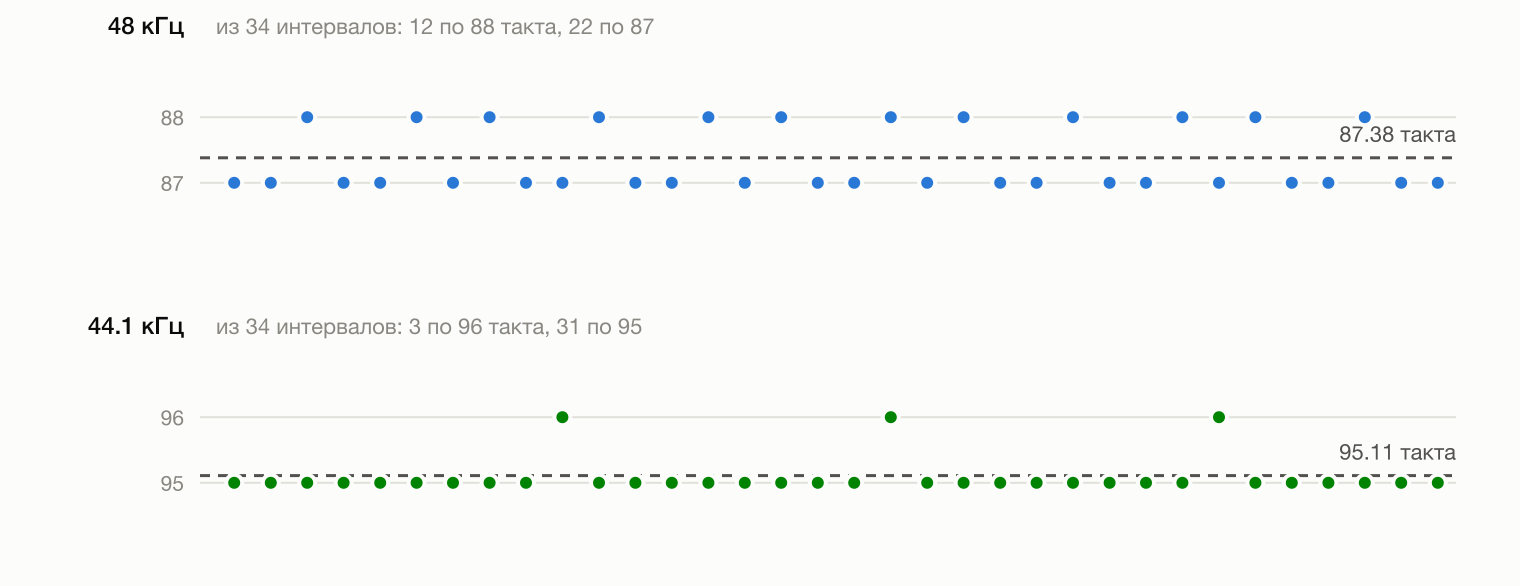
Тут появляется первая проблема — мы не можем на каждом такте просто брать и добавлять сэмплы в очередь; мы должны делать «ресэмплирование», благо нам надо только понижать частоту — а значит, можно просто брать сэмпл каждые N тактов. Но частота CPU 4 194 304 Гц не делится ровно ни на 44.1 кГц, ни на 48 кГц: на один выходной сэмпл приходится 95.11 такта CPU при 44.1 кГц и 87.38 такта CPU при 48 кГц — ни то, ни другое не целое. Сначала я пошёл по простому пути — у меня счётчик тактов для сэмплирования в double. Накопили полных тактов больше, чем 87.38 — взяли сэмпл. Получается ресемплирование по ближайшему соседу. По‑хорошему, надо, конечно же, делать не так, о чём расскажу в другом разделе ниже.
Сам механизм генерации звука в Gameboy основан на четырёх независимых каналах. Каждый канал представляет собой конечный автомат, поведение которого настраивается набором регистров, а переходы между состояниями контролируются таймерами, привязанными к тактовой частоте CPU. В зависимости от состояния на вывод будет подаваться сигнал заданной амплитуды. Амплитуда задаётся 4-битным числом, поэтому варьируется от 0 до 15.
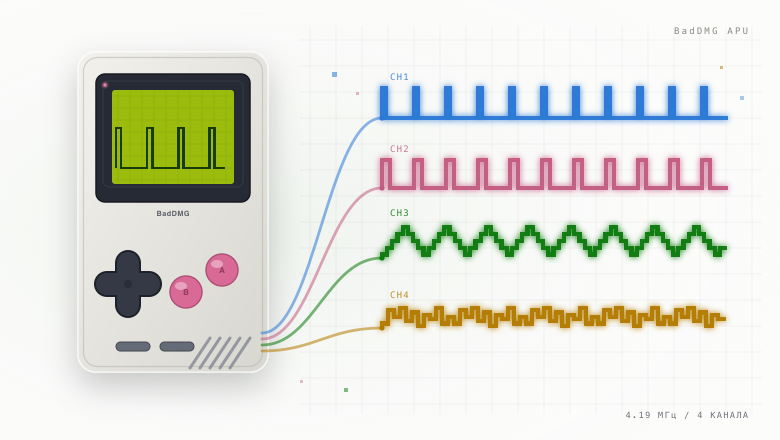
Каждый канал имеет одно жёстко заданное поведение (см. картинку в заголовке статьи для примера):
-
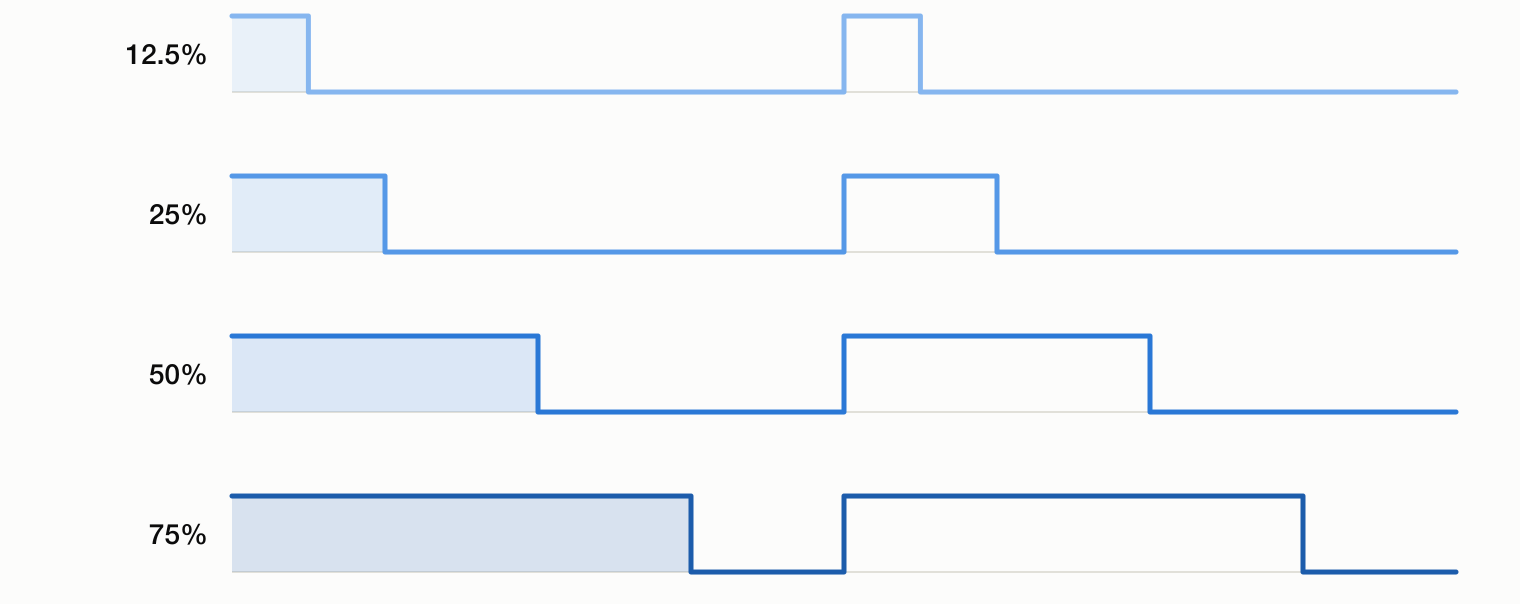
Прямоугольная волна 1 и 2 — первые два канала идентичны по своему устройству. В основе лежит генератор прямоугольного сигнала с изменяемой скважностью (всего 4 — 12.5%, 25%, 50%, 75%). Сигнал осциллирует между 0 и параметром громкости (envelope). Также у первого канала есть возможность настроить изменение частоты во время проигрывания.
-
Волновой канал — произвольная 4-битная волна. Есть специальная область из 16 байт, где в каждом байте лежит по два сэмпла — старший и младший полубайт. Канал берёт амплитуду сигнала и выдаёт её заданный период, после чего переходит на следующий сэмпл.
-
Шум — обычный linear‑feedback shift register генератор. Работает в 15-битном или 7-битном режиме. Производит что‑то похожее на белый шум.
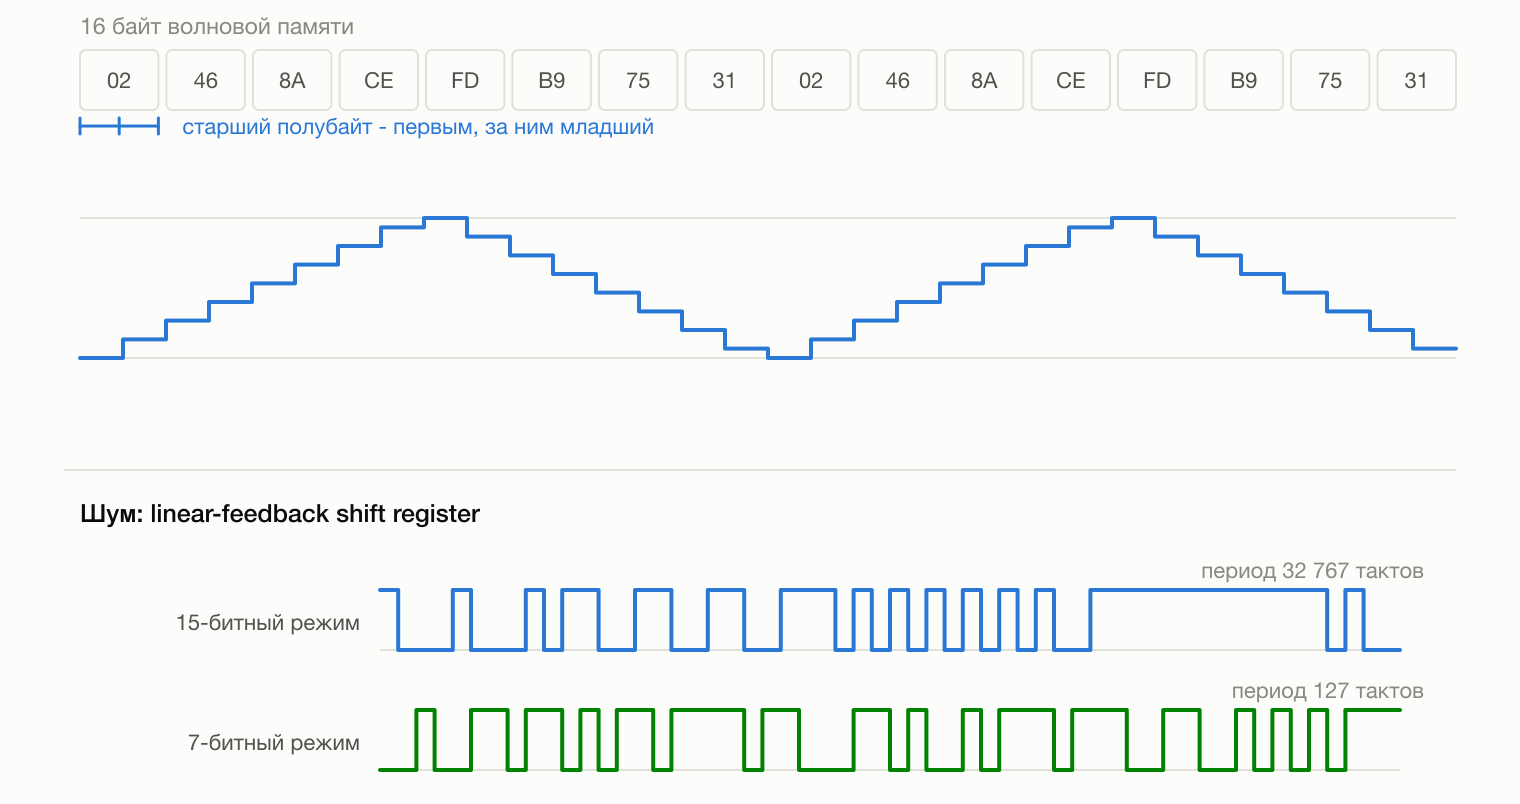
Сигналы с каналов сводятся в простейший «микшер», который собирает сигналы вместе и выдаёт их дальше на динамик. Хоть динамик у Gameboy один, но звук генерируется в стерео. Можно настроить громкость для левого и правого уха отдельно, а также включать каналы для каждого уха по отдельности. Я не буду погружаться в детали реализации. Они хорошо описаны в https://gbdev.io/pandocs/, ресурсе, который я упоминал в прошлой статье. Хочу сосредоточиться на вещах, которые было сложно понять с первого раза.
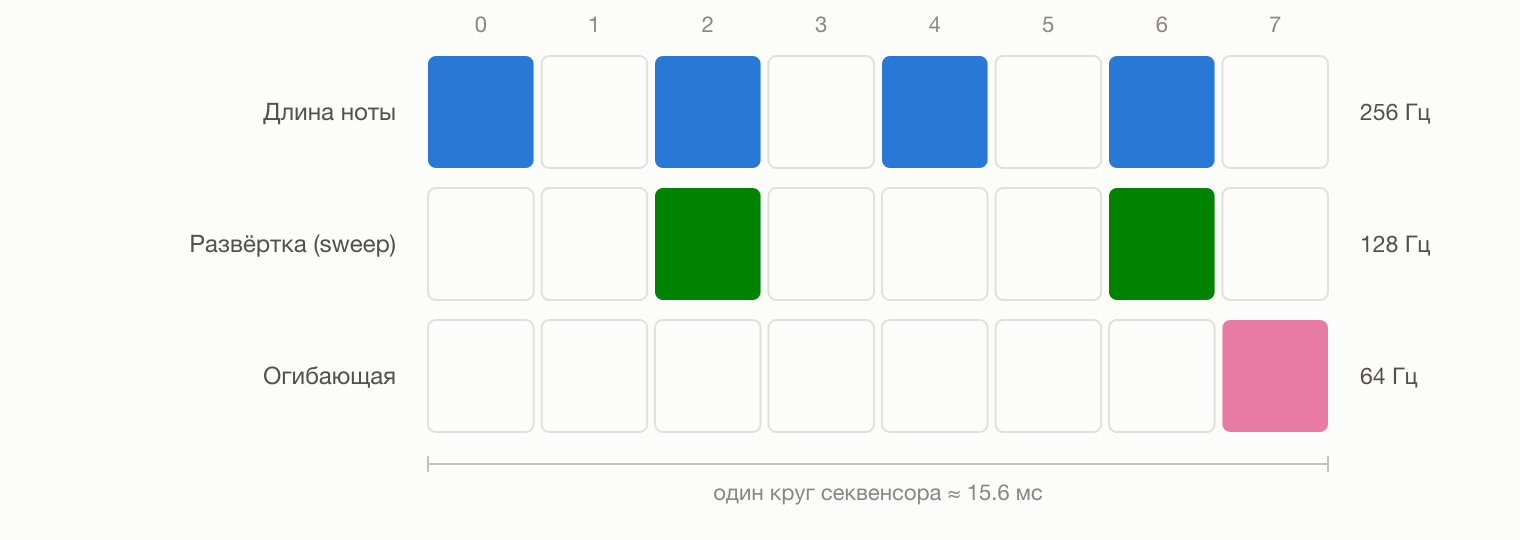
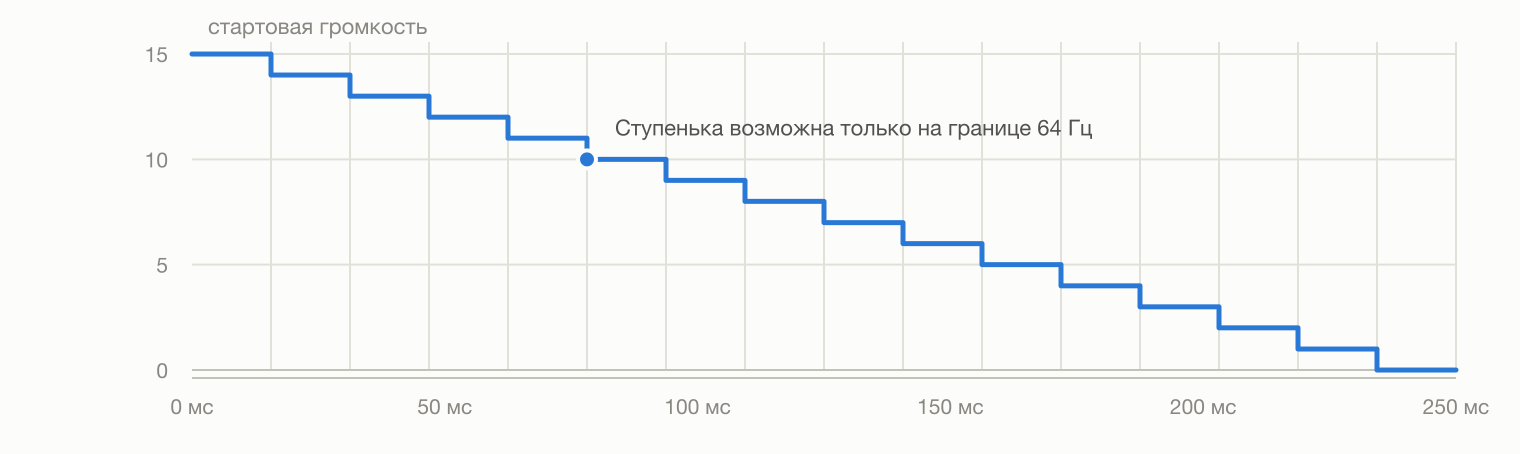
Если помните, в архитектуре Gameboy есть таймер; его можно по‑разному настраивать, после чего он в нужные моменты времени может вызывать прерывания. С секвенсором APU таймер связан только через регистр DIV: запись в DIV сбрасывает секвенсор, дальше он считает такты сам. Прерывания таймера в тактировании каналов не участвуют. Из‑за того, что вся система основана на счётчиках, программист ПО для Gameboy не оперирует частотами — он задаёт длительности. Этот «счётчик секвенсора» срабатывает каждые 8192 такта CPU (512 Гц). Секвенсор сам по себе конечный автомат, который меняет своё состояние на каждом срабатывании, переходя по кругу между 8 состояниями. На каждом чётном шаге (получается 256 Гц) происходит декремент счётчика длительности ноты; когда счётчик дойдёт до 0, канал выключится. В два раза реже (128 Гц) срабатывает счётчик изменения частоты для канала 1 и один раз на круг срабатывает изменение громкости (64 Гц). Это накладывает определённые ограничения на то, какие звуки вообще можно выдавать: изменение громкости происходит достаточно медленно, что чувствуется в мелодиях.
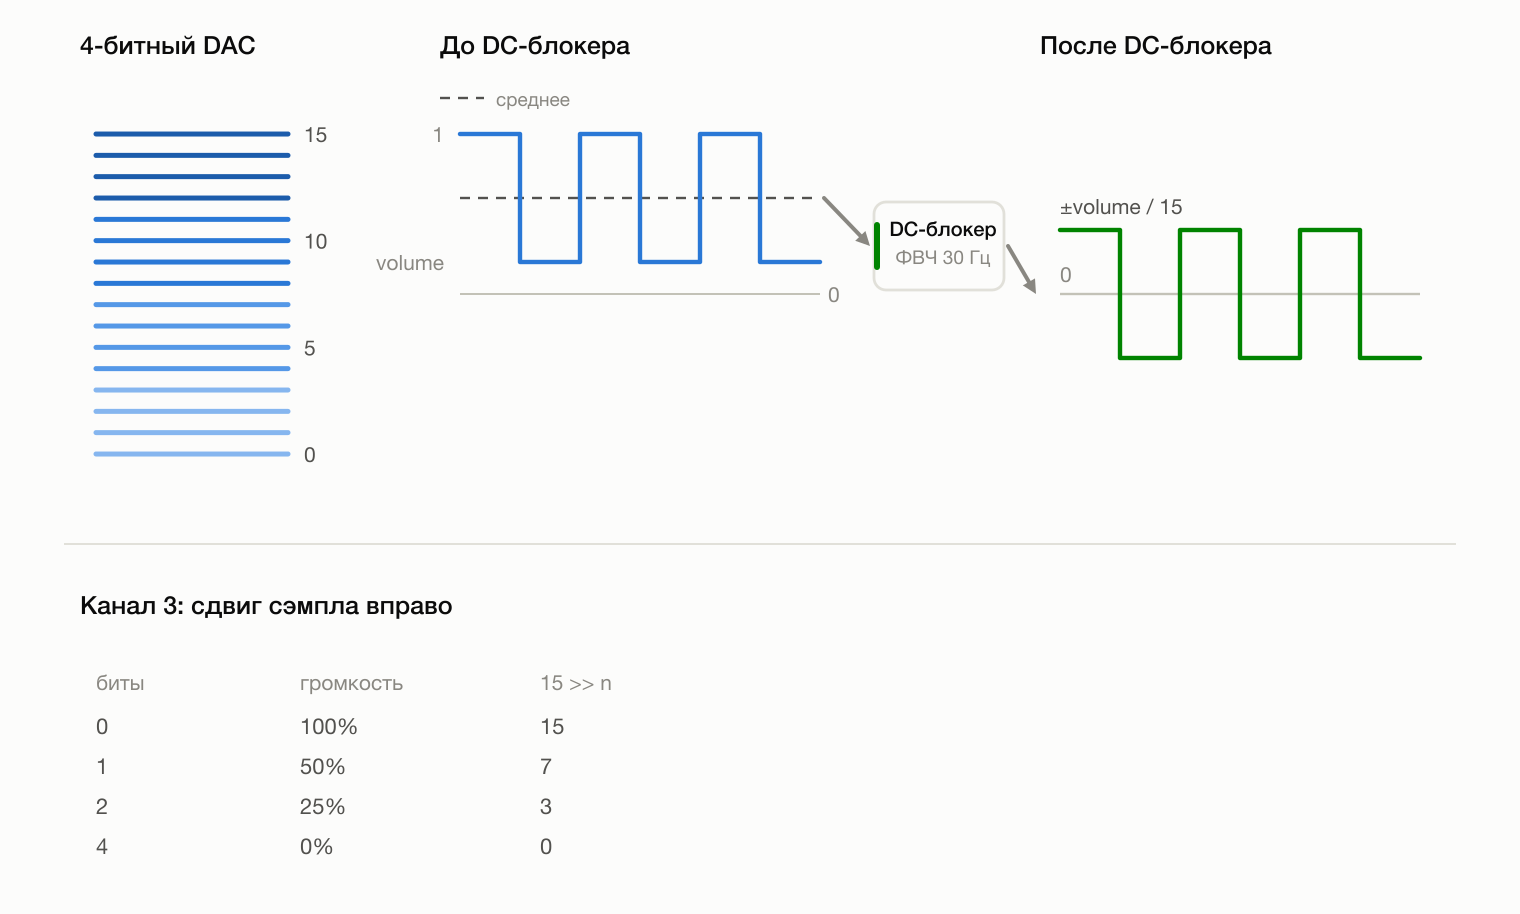
Напомню, амплитуда сигнала в Gameboy задаётся 4-битным числом — получается, громкость меняется от 0 до 15, и такое число подаётся на вход DAC. Нам же хочется нормализованный биполярный сигнал в диапазоне от -1.0 до 1.0, но просто растянуть 0…15 на этот диапазон нельзя. DAC не биполярный: на его вход идут числа от 0 до 15, а не от -15 до +15. У прямоугольных каналов и шума на вход попеременно приходит то текущая громкость, то ноль, поэтому среднее зависит от громкости и скважности. Если сдвинуть всю шкалу так, чтобы 7.5 стало нулём, у «молчащего» канала всё равно останется постоянный уровень (-7.5), а у работающего появится смещение, которое меняется вместе с громкостью и скважностью. Это смещение складывается по всем каналам, и при включении или выключении канала будут получаться щелчки.
Поэтому в эмуляторе на выходе мы ставим «DC‑блокер» — фильтр верхних частот на 30 Гц. Он срезает постоянную составляющую и оставляет переменную: средний уровень становится нулевым независимо от того, какая у канала громкость и скважность. В реальном железе для этого стоит разделительный конденсатор. После него можно не думать о смещении: мы просто считаем уровень DAC для текущего 4-битного значения.
Уровень DAC считается как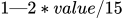 , где value — 4-битное значение на входе (0…15). У каналов 1, 2 и 4 в активной фазе value равно текущей громкости, в пассивной — нулю. При нулевой громкости оба уровня совпадают, и после DC‑блокера сигнал в нуле. При ненулевой остаётся переменная часть — на рисунке (скважность 50%) это ±volume / 15.
У канала 3 нет огибающей: его громкость задаётся выходным уровнем. 4-битный сэмпл сдвигается вправо на 0, 1, 2 или 4 бита (100%, 50%, 25% или 0%) и уже потом идёт в тот же DAC.
Работа с регистрами
Весь APU управляется регистрами по $FF10-$FF26 и шестнадцатью байтами волновой памяти по $FF30-$FF3F. Регистры делятся на две группы: своя группа на каждый канал (NR1x, NR2x, NR3x, NR4x) и три общих. NR50 и NR51 задают громкость и коммутацию каналов по левому и правому уху, NR52 управляет всем APU.
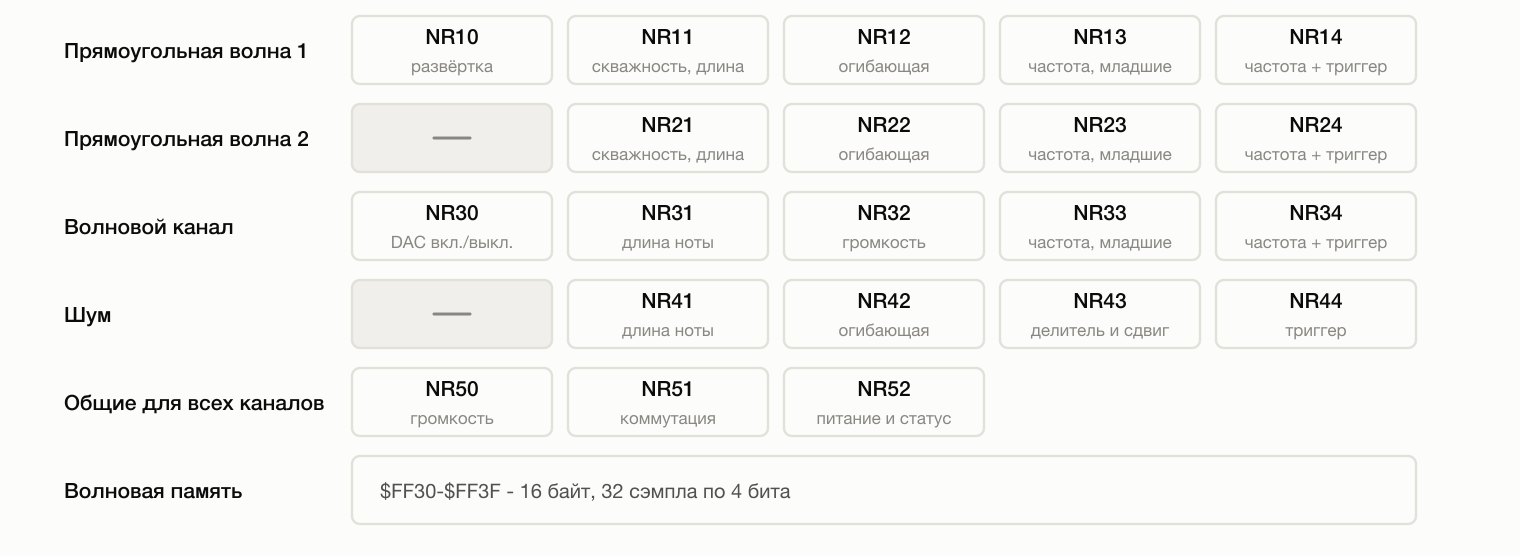
По схеме регистров видно, что каждый из регистров NRx1, NRx2, NRx3, NRx4 отвечает за свой характерный аспект настройки канала (пример NRx4 — хранит триггер запуска). Но, я когда писал код обработки всех этих регистров, не стал заморачиваться и каждый канал реализовал отдельно.
Тестирование
Соответствие поведения реальному железу проверял тестами dmg_sound от Blargg. Добавил автоматизацию — тесты теперь умеют запускать ядро bdmg без вывода картинки, а сами ROM‑ы встраиваю в сегмент данных тестового бинаря.
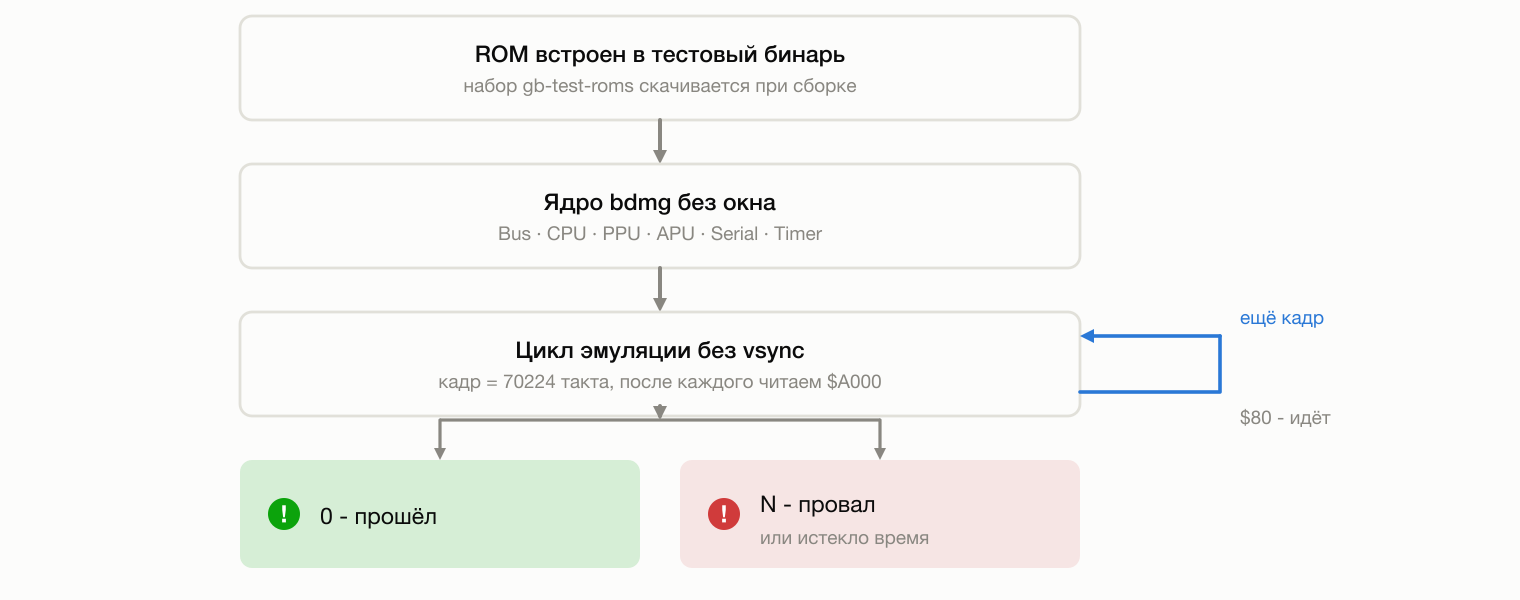
При этом тесты покрывают только цифровую часть — иначе говоря, можно проверить, что эмулятор ведет себя так, как ведет реальное железо с программной стороны, но то, какой получается звук, — это совсем другая история.
Ресемплинг и фильтрация
Вернёмся к ресемплированию, которое я обещал разобрать отдельно. Частота CPU — 4.19 МГц, а для звука это слишком много и не нужно (см. 20кГц). Эмулятор работает M‑тактами: один M‑такт — это 4 такта CPU. На каждом M‑такте берем текущие уровни каналов, складываем их и получаем один сэмпл микшера. Это 1 048 576 сэмплов в секунду, что всё равно — почти в 22 раза больше, чем нужно звуковой карте (48000 Гц). Не смущайтесь, выше в начале статьи я считал в тактах CPU: для 48 кГц на выходной сэмпл приходилось 87.38 такта, теперь используя правильную схему ресемплинга в сэмплах микшера это будет 87.38 / 4 = 21.85.
Наивная схема из начала статьи (см. nearest neighbour) работала не очень хорошо: если выборка не совпала с моментом переключения сигнала — форма искажается, а энергия сигнала оказывается выше или ниже реальной.
Далее для примера, будем использовать часть записи звука из демо gejmboj.
Осторожно, громкие записи!
В записи gejmboj‑naive.mp3 был использован наивный подход к выборке, описанный в начале этой статьи. В целом, мелодия похожа, но по рисунку амплитуды можно видеть, что такая выборка теряет много энергии.
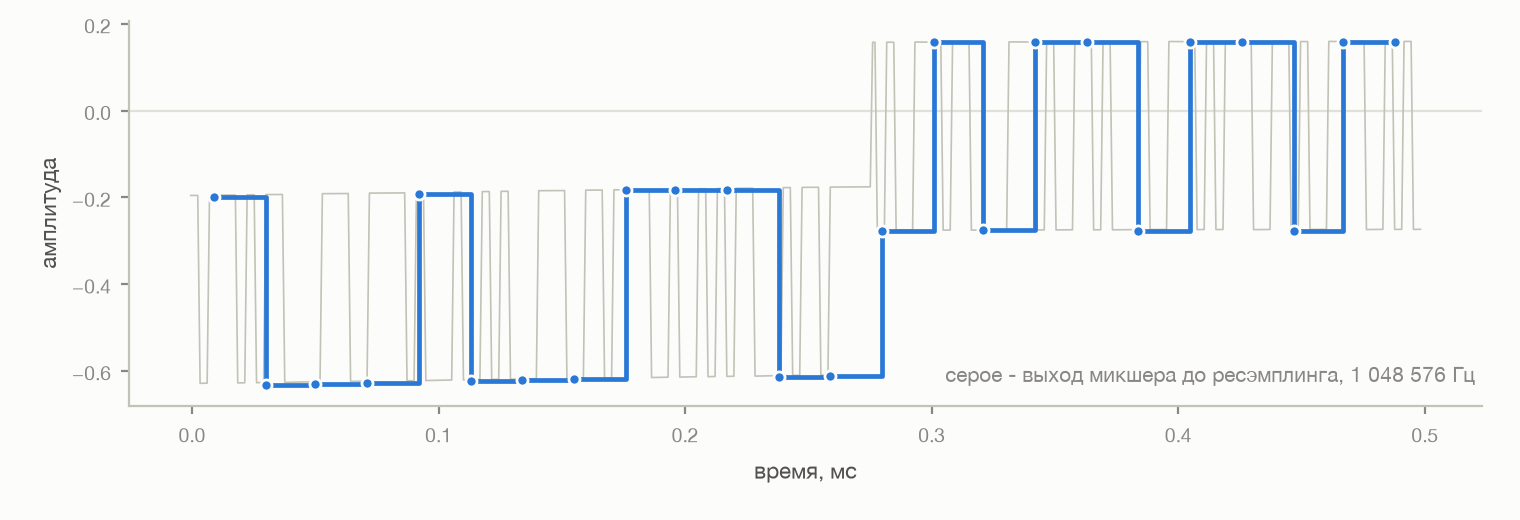
С этим надо было что‑то делать. Просто брать каждый 22-й сэмпл нельзя. Необходимо проинтегрировать сигнал и только потом делать выборку. И вот тут начинаются проблемы — интегрировать можно очень по‑разному. В базовом варианте мы берем просто скользящее среднее по заданному окну.
Веса у всех сэмплов такого окна одинаковые. Тогда:
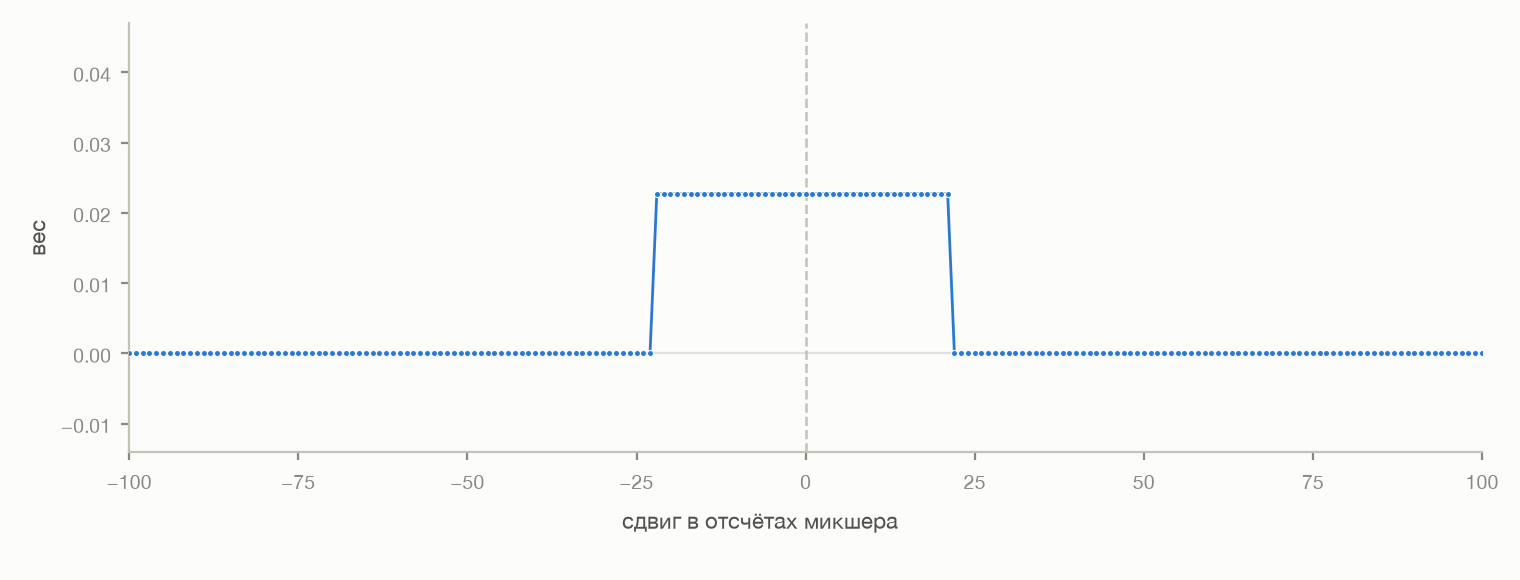
Окно здесь в 44 сэмпла микшера — это два выходных периода. Как раз та ширина, при которой фильтр начинает резать с 24 кГц, и лучшего от такого фильтра уже не добиться. Плох он со всех сторон. То, что должно пройти, он глушит: на 20 кГц уже срезает 15 дБ, так что самые высокие слышимые частоты ослабляются. А высокочастотный писк мы с радостью пропускаем:
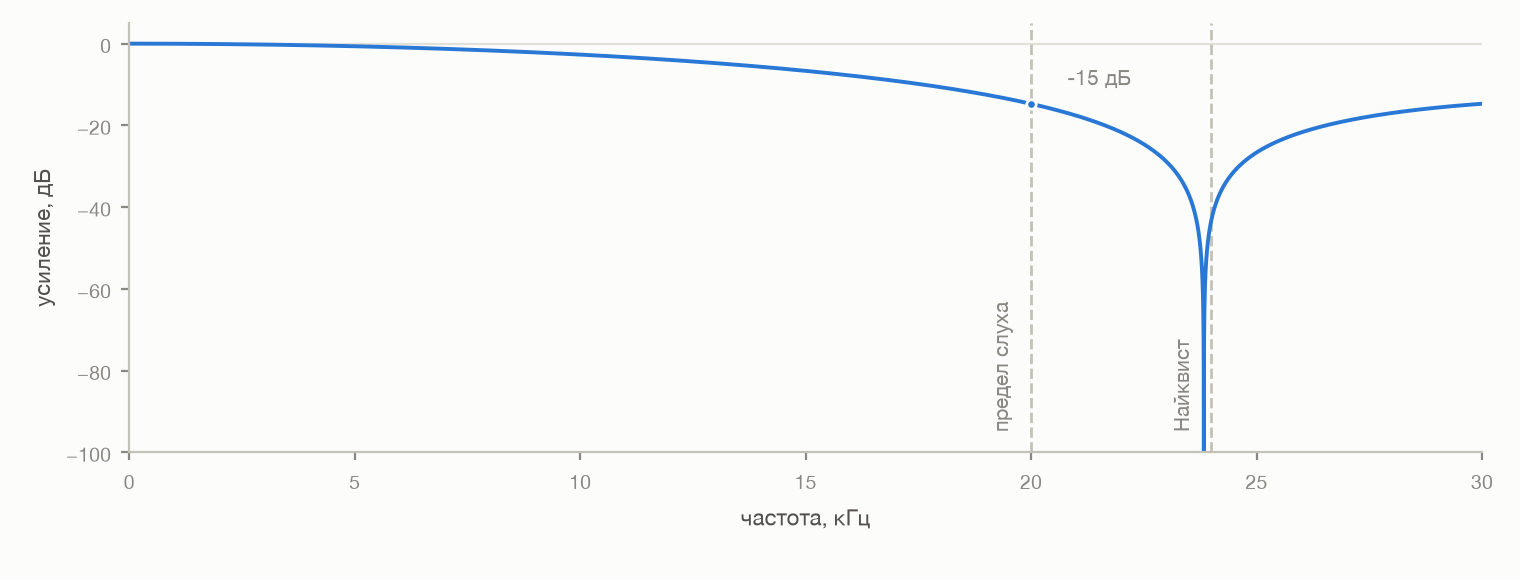
После провала на 24 кГц кривая идёт обратно вверх и к 30 кГц снова пропускает всё, ослабляя лишь в пять раз. Растягивать окно бесполезно: с каждым удвоением ширины АЧХ опускается только на 6 дБ.
В идеале мы хотим увидеть вот такую АЧХ:
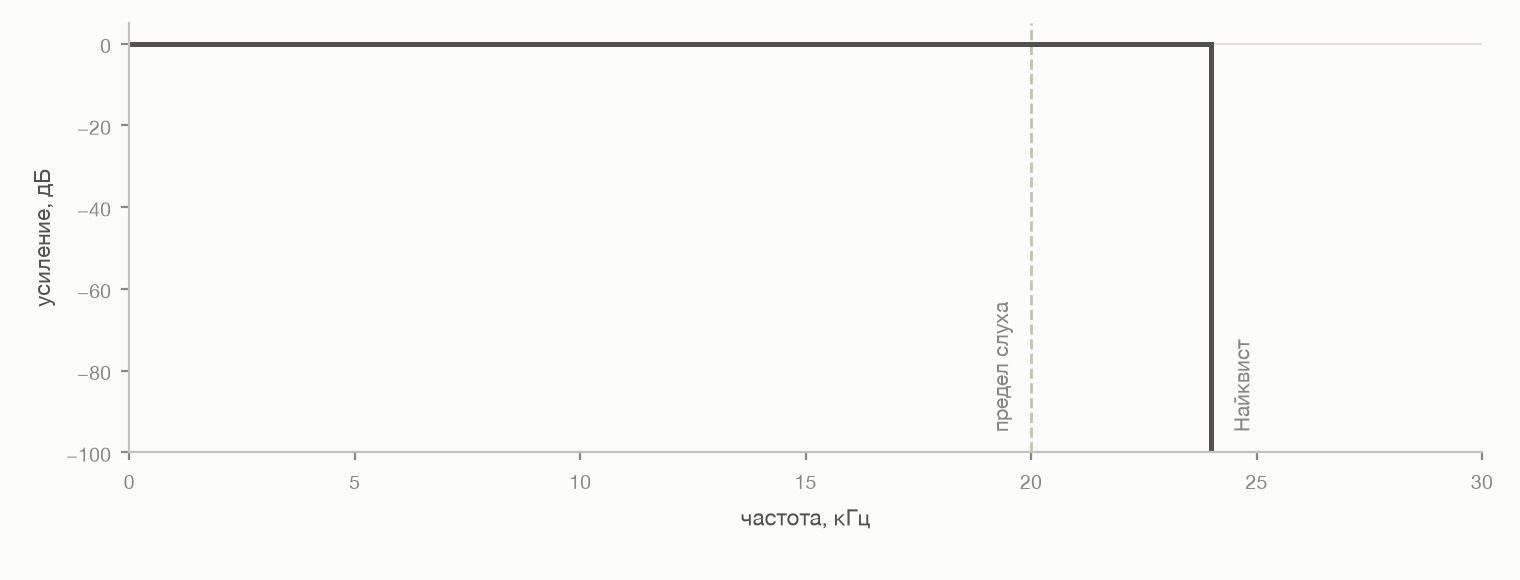
Если сделать обратное преобразование Фурье из такой АЧХ, мы получим функцию, которую называют кардинальный синус aka sinc:
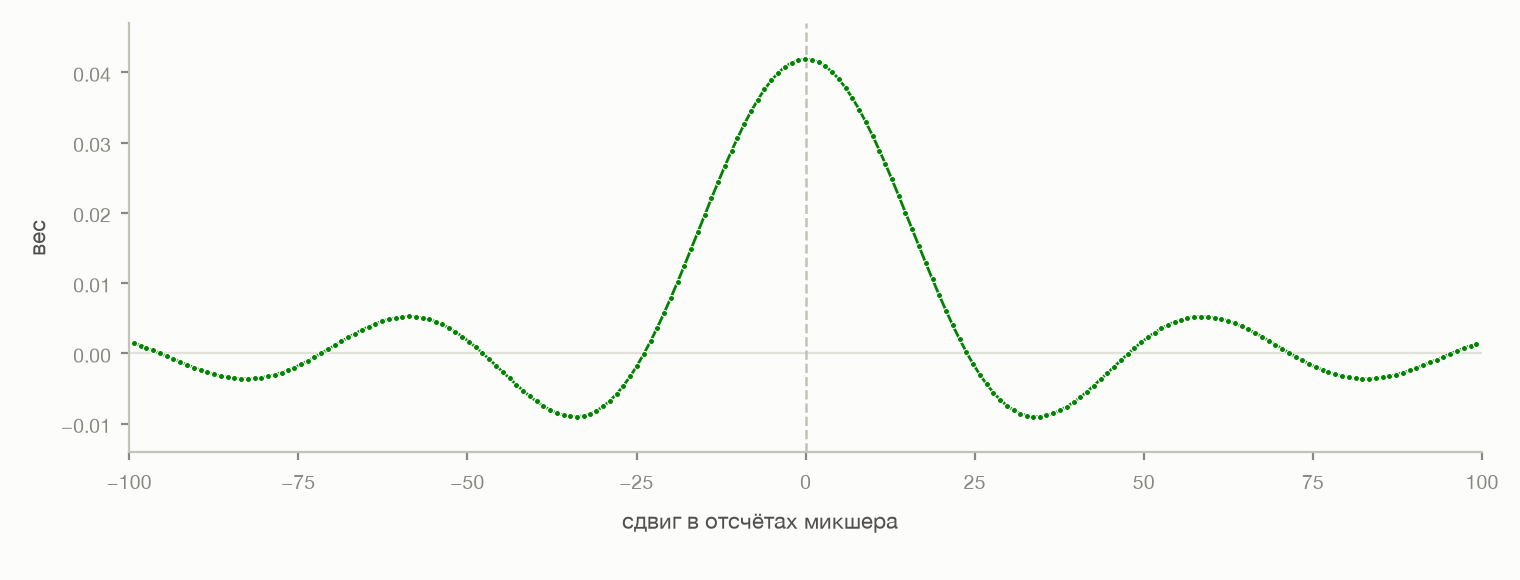
Его проблема в том, что нам надо бесконечное число сэмплов, чтобы преобразование давало идеальную полку. Мы этого себе позволить не можем, звук мы генерируем в реальном времени, чем дольше больше сэмплов надо усреднять — тем больше будет задержка до получения результата. В таком случае, sinc ограничивают с боков. Получается, если фильтр работает примерно с 1700 сэмплами микшера — это 1.6 мс, а задержка выходит вдвое меньше, 0.8 мс. Что это даёт по частоте, видно на АЧХ:
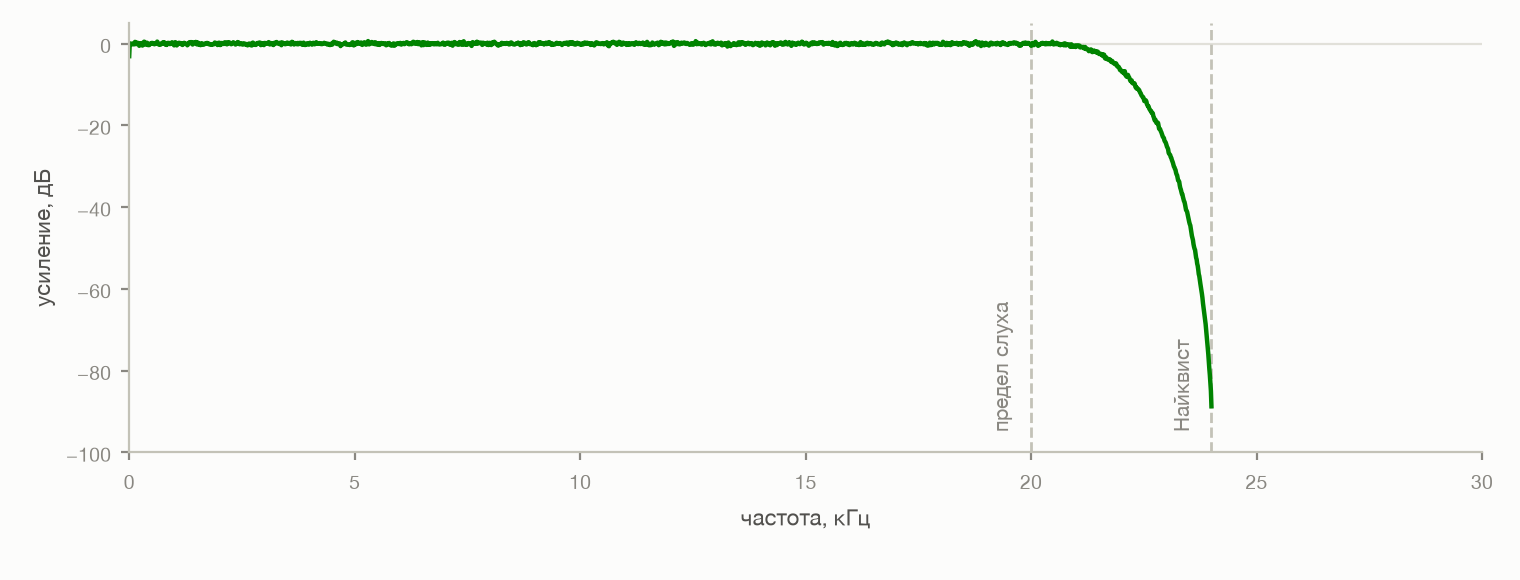
До 20 кГц фильтр пропускает сигнал как есть, далее идет падение и неслышимую часть сигнала мы уже отрезаем. Но тут вылезает другая проблема — в лоб считать такую сумму каждый раз будет очень дорого. На один выходной сэмпл приходится около 1700 умножений, а выходных сэмплов надо 48 000 в секунду. Это под сотню миллионов умножений в секунду, и все — на частоте 1 МГц.
Хочется перед применением такого фильтра как‑то уменьшить количество необходимых вычислений. Есть так называемый полуполосный фильтр (half‑band). С его помощью можно понижать частоту в два раза, одновременно срезая верхние частоты. Интересно то, что ядро фильтра такое, что каждый второй сэмпл зануляется — а значит его можно вообще не брать в расчет. В итоге для получения одного отсчёта нужно около 20 сэмплов и 10 умножений.
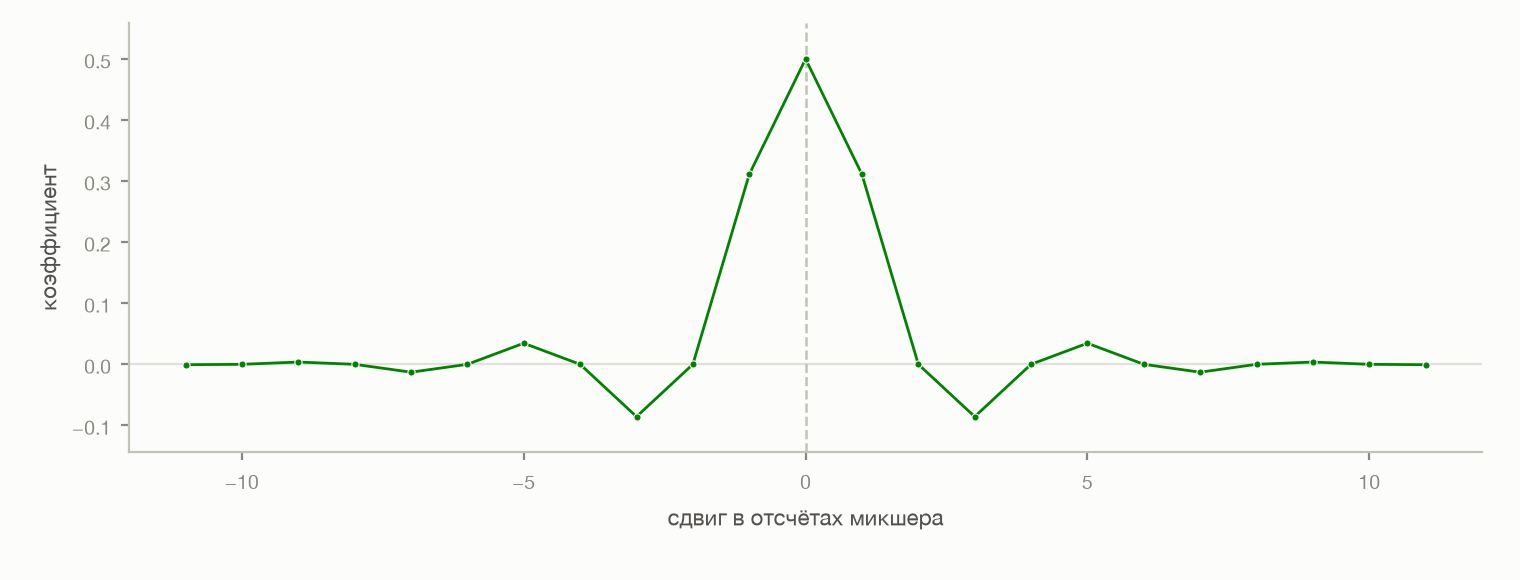
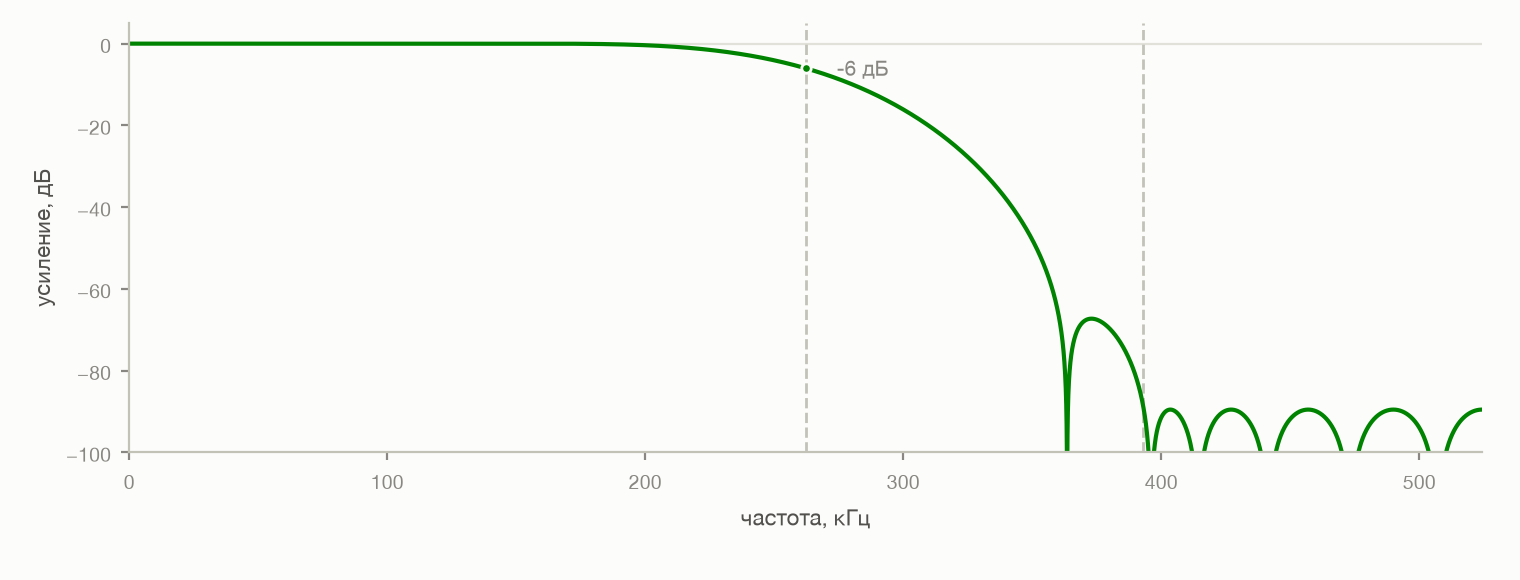
Так мы можем за три каскада понизить частоту с 1МГц до примерно 131кГц. Дальше 131кГц → 48кГц нацело не делится и мы уже можем добрать его через ограниченный sinc. Получая в итоге уже сильно сглаженный сигнал:
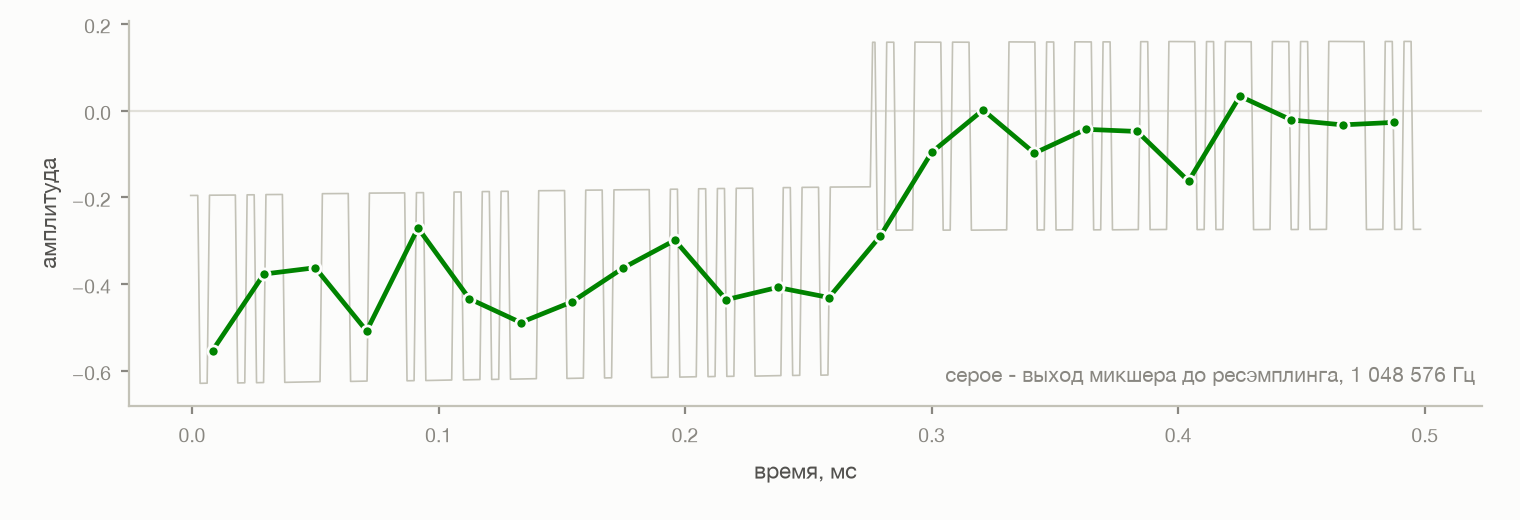
Я пытался закодить всю описанную выше теорию вручную, но результат меня абсолютно не впечатлил по производительности и я не стал погружаться как мне это всё переписать так, чтобы оно работало достаточно быстро на моём железе. Есть вот такая прекрасная библиотека: r8brain‑free‑src, которая реализует весь необходимый функционал и выполняет расчёты очень быстро. Всем её рекомендую.
Вот звук который получается в итоге: gejmboj‑r8brain.mp3 и разница gejmboj‑difference.mp3 двух подходов.
На картинке видно разницу наглядно:
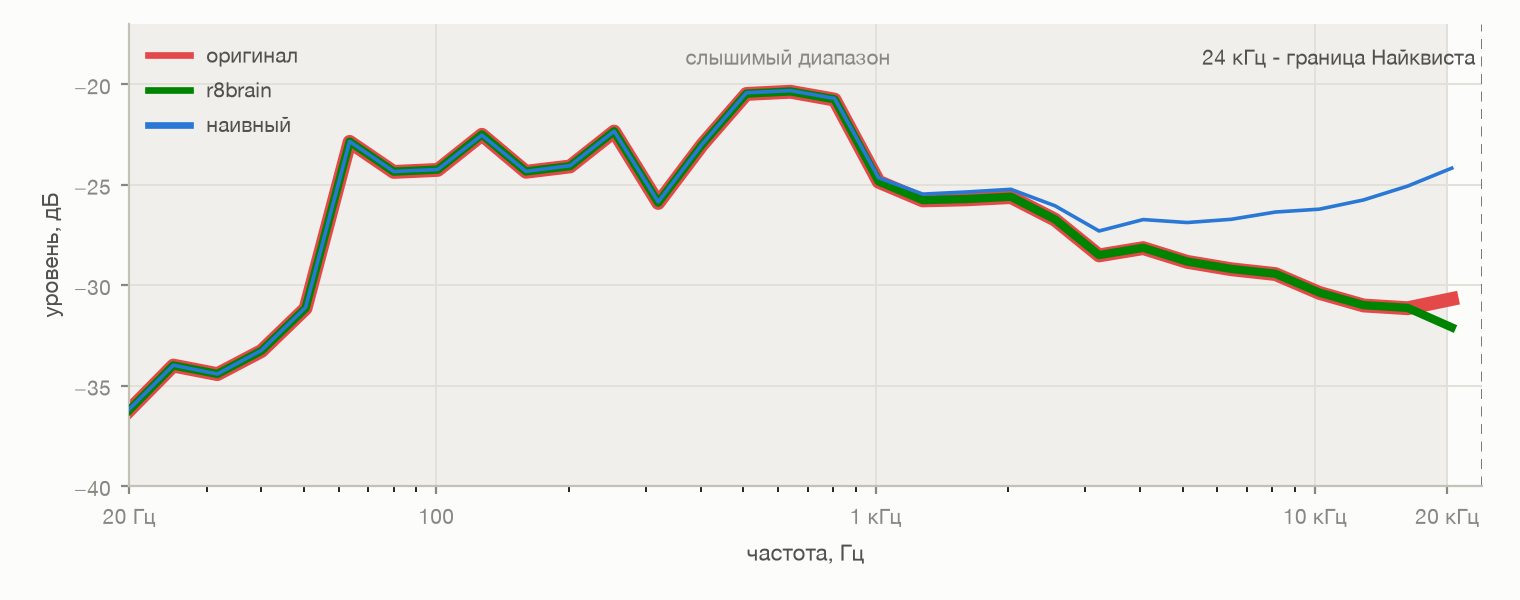
За счёт того, что мелодия задаётся низкими частотами, в общем‑то звук похож. Но лишняя энергия наивной схемы заворачивается в слышимый диапазон треском и писком. Чем ближе к 20 кГц, тем больше высокочастотного писка попадает в слышимый диапазон. Для sinc же только сильно ближе к границе видно, что фильтр срезал немного и начал расходиться с идеалом.
Буферизация и лаги
Как писал выше, в эмуляторе каждые 4 такта CPU считается новый сэмпл микшера и в железе он сразу попадает на динамик, но в эмуляторе звук мы проигрываем через звуковой тракт компьютера, который сильно больше, да и сэмплы надо подготовить. Ведь звуковой фильтр не даёт результат сразу, он обрабатывает массив сэмплов и начинает производить результат с некоторой задержкой, когда заполнится окно фильтра. За секунду у нас должно быть 48 000 сэмплов, обновление экрана происходит примерно 60 раз в секунду — значит за один кадр у нас будет 800 сэмплов, то есть 16 мс звука. Если копить их и отправлять раз в кадр, сэмпл из начала кадра пролежит в ожидании все эти 16 мс — поэтому надо отправлять как можно раньше раньше.
При этом vsync у нас 60 Гц, а реальный Gameboy выдаёт около 59.7 кадров в секунду. Поэтому эмулятор эмулирует чуть больше игрового времени за секунду, и звук играет примерно на 0.46% быстрее — ноты получаются чуть выше.
Чтобы это учесть, надо сделать входную частоту ресемплера чуть выше. При 60 Гц коэффициент ускорения будет speed = 60 / 59.7275 ≈ 1.00456, поэтому на вход идёт не 1048576, а 1 053 360 Гц. Я долго не мог понять, что не так и почему у меня копятся лишние сэмплы, которые приходилось сбрасывать время от времени.
Теперь давайте попробуем проследить за путём, который должен пройти сэмпл:
-
Генерация в ядре эмулятора (задержкой можно пренебречь)
-
Фильтрация и понижение частоты. Сэмплы начинают генерироваться после того как набрался блок из 4096 входных сэмплов. Здесь задержка получается около 4 мс.
-
Очередь SDL. Сэмплы копятся в буфере приложения до 256 штук или до конца кадра, а потом пачкой уходят в очередь SDL, откуда драйвер их забирает. Размер очереди плавает. В замере медиана вышла 15 мс, это около 700 сэмплов.
-
Буфер устройства. Тут всё уже зависит от самой подсистемы звука. Во время тестов на macOS внутри SDL используется CoreAudio, который забирает пачками по 256 сэмплов — один такой буфер занимает 5 мс.
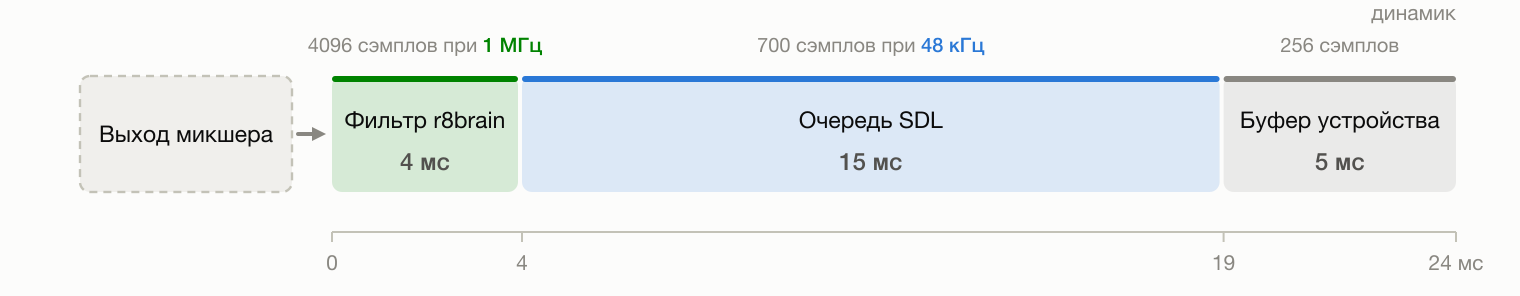
Если сложить с учетом разброса получается звуковой лаг 13–30 мс, которого нет в железе, и в условиях эмуляции не вылечить. На мой взгляд такая задержка не ощущается, но пуристам может сильно мешать мысль о такой несправедливости.
Выводы
В последнее время в эмуляторной сцене бум новых проектов. С помощью LLM можно сделать с нуля эмулятор практически чего угодно за один вечер. Меня это демотивирует в том смысле, что самому сейчас делать что‑либо становится невыгодно. По запросу можно получить конечный продукт, который в общем‑то будет как минимум не хуже, чем то, что сделал бы сам, разобравшись в вопросе. Код и статья лежали у меня в полу-готовом виде очень давно, сегодня понял, что дольше откладывать публикацию нельзя, хотя интерес таких проектов, как BadDMG, теперь представляет только для самого автора. Свой гештальт я закрыл. Звук воспроизводится, лаги не мешают. В эмуляторе еще есть баги в PPU, но мне сейчас лень с ними разбираться, может уже в следующем году исправлю, или попрошу уже LLM разобраться. Код в репозитории (https://github.com/masscry/BadDMG). Всем спасибо, за внимание.
ссылка на оригинал статьи https://habr.com/ru/articles/1099784/