Память агентов в тренде с того момента как они появились, чтобы бороться с галлюцинациями и давать ответы и решения LLM на собственной информации. Как лучше запрашивать информацию из таблиц или из графа часто решается на вере, начитавшись постов в интернете без своих экспериментов и измерений. В исследовании Sequeda и соавторов GPT-4 отвечал на вопросы по корпоративной SQL-базе верно в 16% случаев, а по графу знаний поверх этой же базы в 54%, где у графа была онтология с описанием, а у SQL-схемы только DDL типы и названия таблиц/колонок.
В моем GraphRAG одна и та же информация представлена в двух разных формах. Данные из статьи “Мой PostgreSQL быстрее твоего и почти догнал ClickHouse” извлек в 34 таблицы PostgreSQL, а в граф это превратил с помощью отображения R2RML. Подключил обе формы представления знаний к агенту по MCP и задал ему 15 вопросов о статье: через SQL, через SPARQL и дал еще выбор агенту из двух этих видов сразу. В моем эксперименте агент по очереди запускался на трех LLM с открытыми весами. Их можно развернуть на своей инфраструктуре или ноутбуке и данные и вопросы не уйдут провайдеру в логи или агрегатору между вами и LLM.
Также я проверил и рассчитал что лучше для векторного хранения и семантического поиска: Lance или pgvector. Поделюсь своими измерениями на современных моделях как лучше искать и в чем хранить знания.
Обнаружил в эксперименте как DeepSeek придумал SQL-инъекцию чтобы ответить на мой вопрос.
Два представления одних и тех же данных
С помощью LLM, NLP и морфологии и прочих страшных слов мои данные превратились в графовое представление и фреймы привязанные к RDF Quad. Слова из текста разложились по сущностям, тезисам, замерам, репликам и процессам и т. п. Для каждого такого фрагмента есть его источник в исходниках по стандарту W3C Web Annotation. Производный слой данных был выведен уже поверх первоначального извлечения нейронкой. Всего вышло 10154 квада в 37 графах для одной статьи.
Затем это все разложил по таблицам базы данных, стало проще для восприятия на глаз. Узел графа стал строкой таблицы, колонка — его свойством, список стал массивом в строке. В комментариях к каждой колонке записано какой предикат RDF она хранит. Мэппинг R2RML по этим таблицам снова собирает исходный граф.
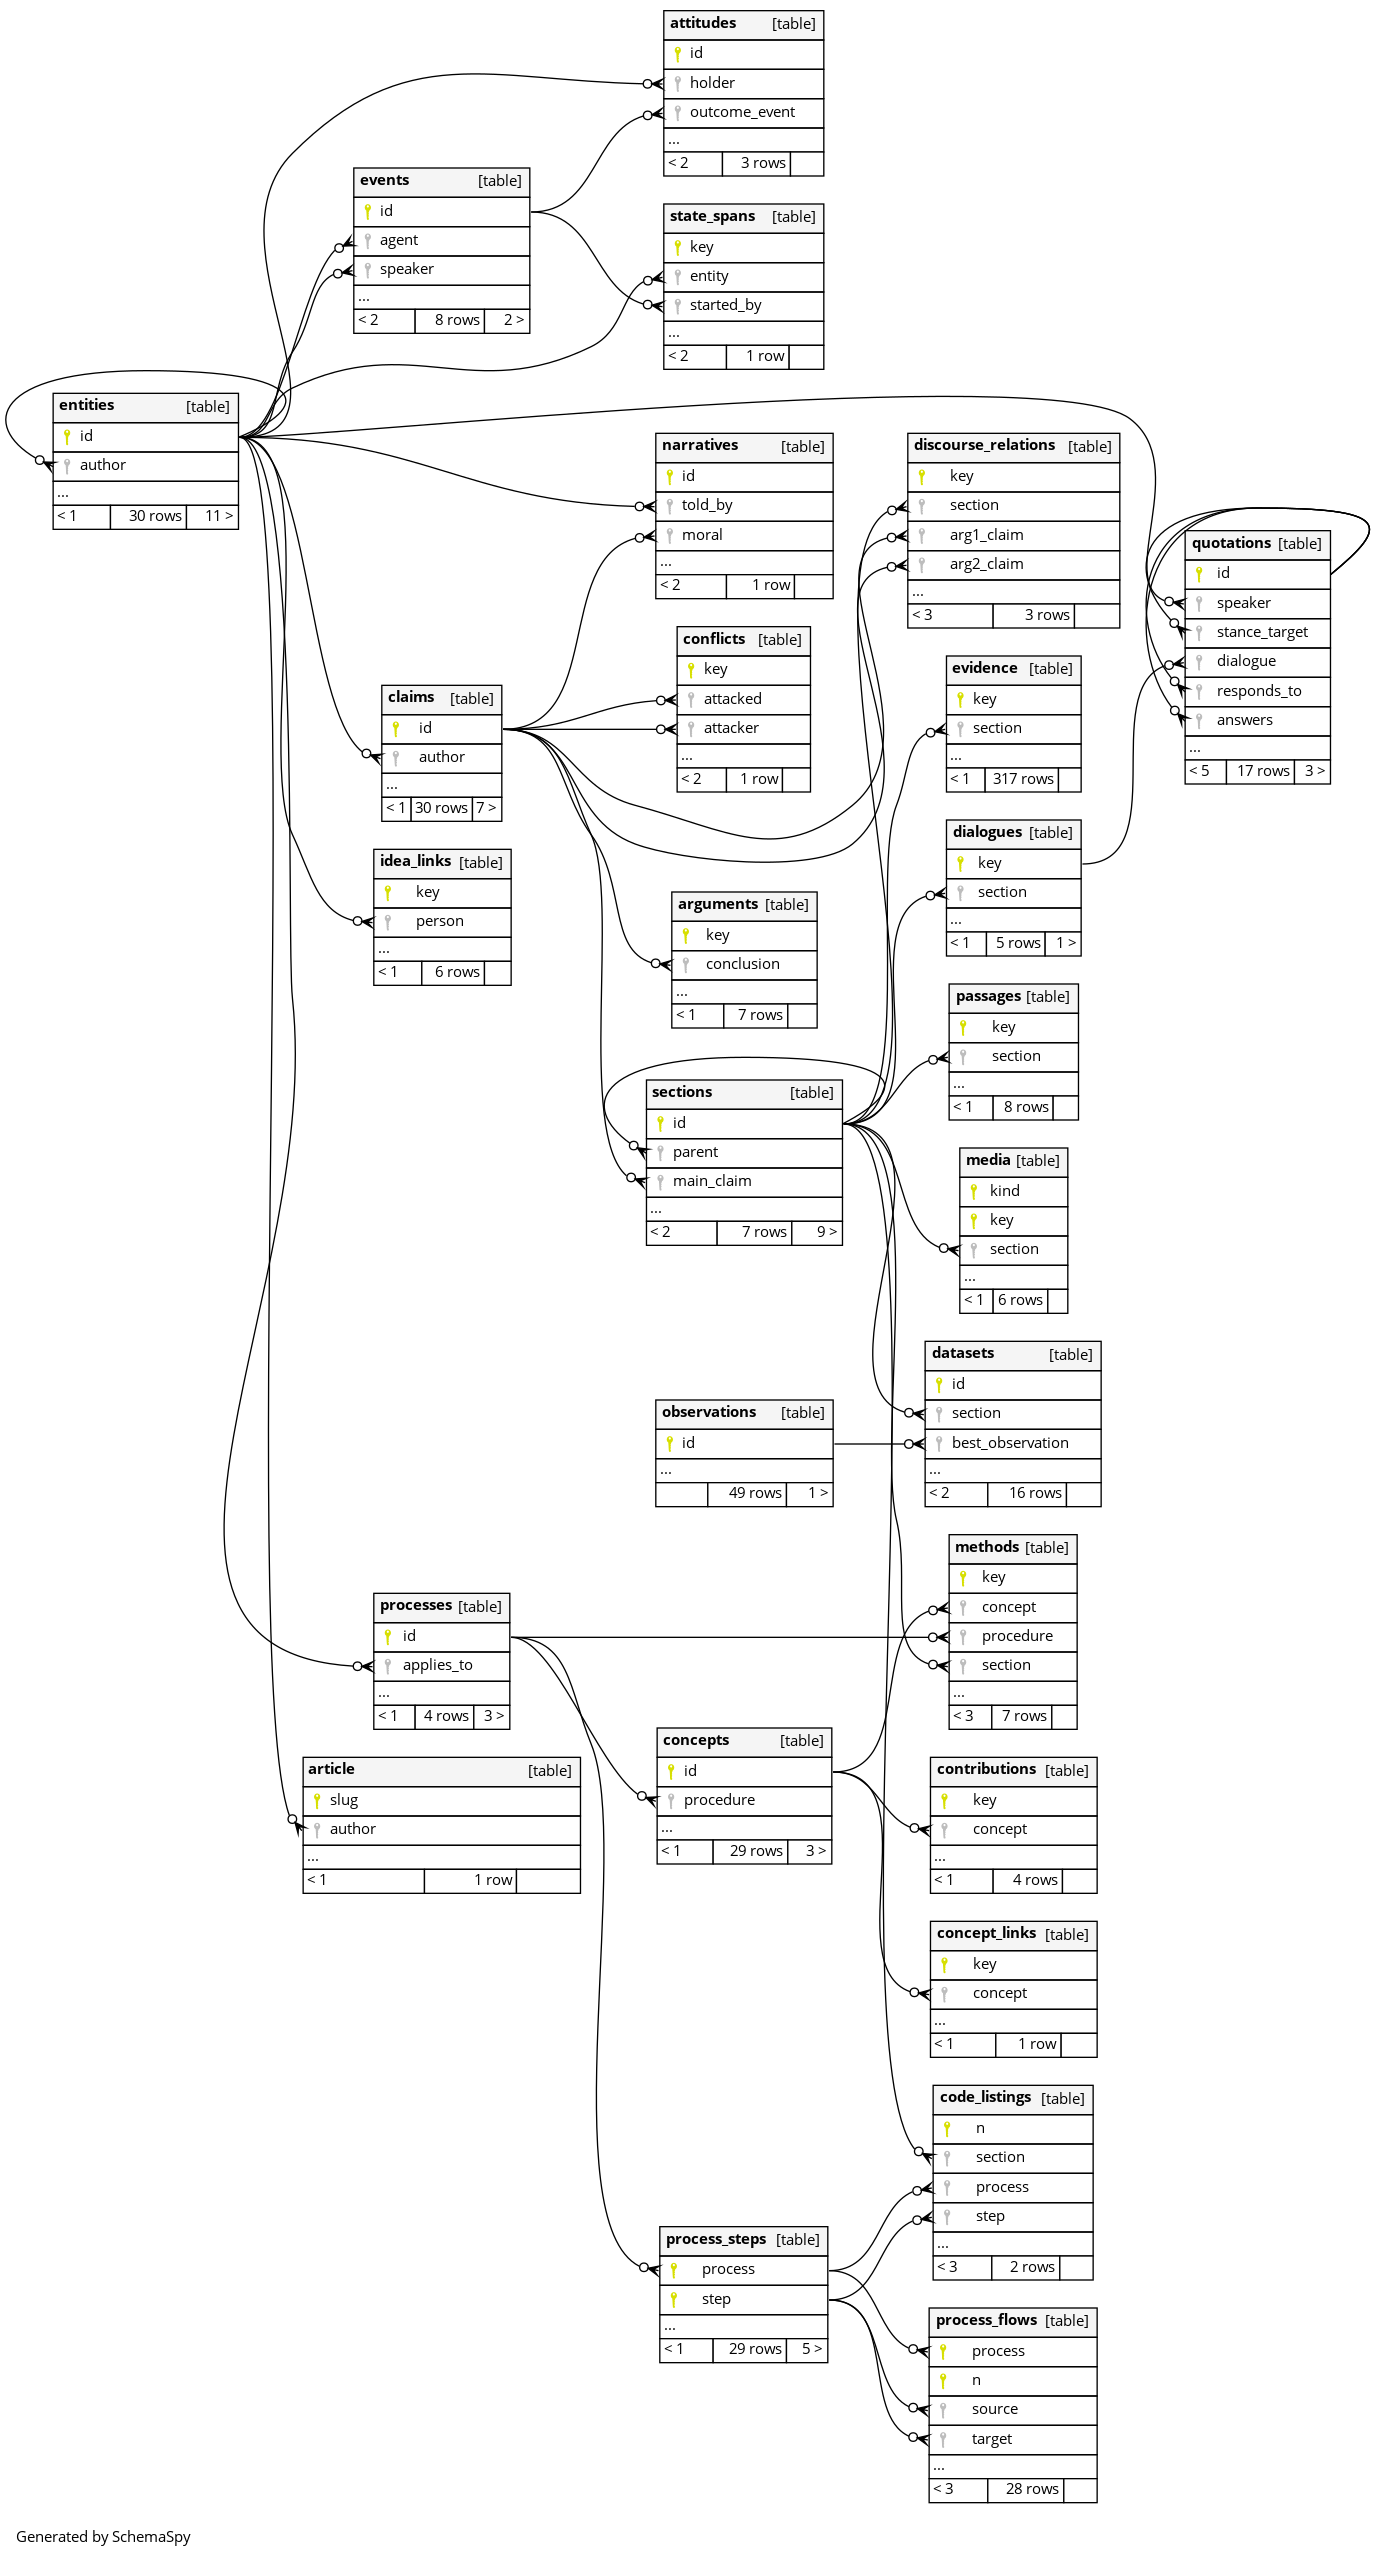
В памяти есть и процессы из статьи. LLM записала их как BPMN события, задачи, условное ветвление. Хранится 4 процесса, 29 шагов в process_steps/process_flows.
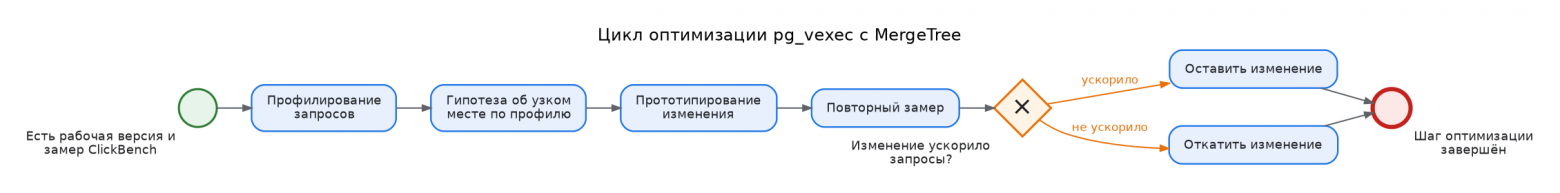
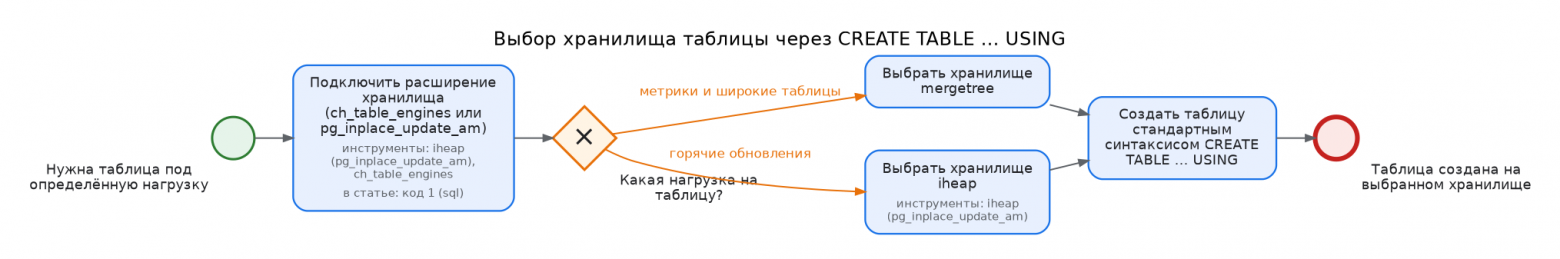
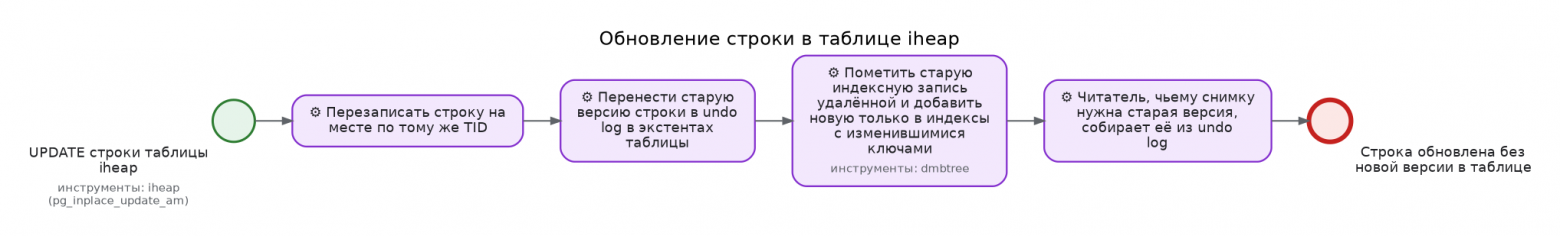
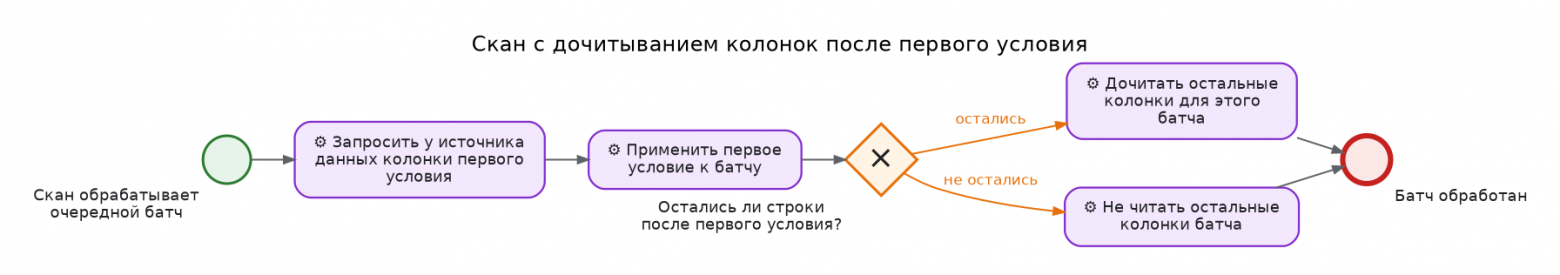
Для проверки будут ли запросы работать на других языках, сделал перевод на английский и прогнал запросы агентов и на этом переводе.
Память агента
Это Java программа на langchain4j с циклом “модель->инструменты->модель” где не больше 16 вызовов LLM и не больше 12 запросов к памяти. Память это отдельный процесс MCP-сервер на stdio протоколе который отправляет запросы в PostgreSQL. При работе в этом цикле доступно три инструмента:
-
sql_query выполняет SQL-запрос в СУБД с ролью agent_sql
-
sparql_query выполняет SPARQL-запрос в базе с ролью agent_sparql. Префиксы schema: kgo: oa: уже объявлены по умолчанию как во многих SPARQL-эндпоинтах.
-
submit_answer когда агент решил ответить, передать цитату с номерами строк, текст ответа или “в памяти этого нет”.
Обе роли в PostgreSQL только читают данные, с таймаутом на запрос 5 секунд, ответ обрезается до 200 строк чтобы не переполнять контекст модели. Описание памяти в системном промпте одинаковое во всех условиях: таблицы и колонки с предикатами RDF. Это 45-53 тысячи символов или 15-17 тыс. токенов. Условия отличаются только инструментами и короткой подсказкой к каждому из них.
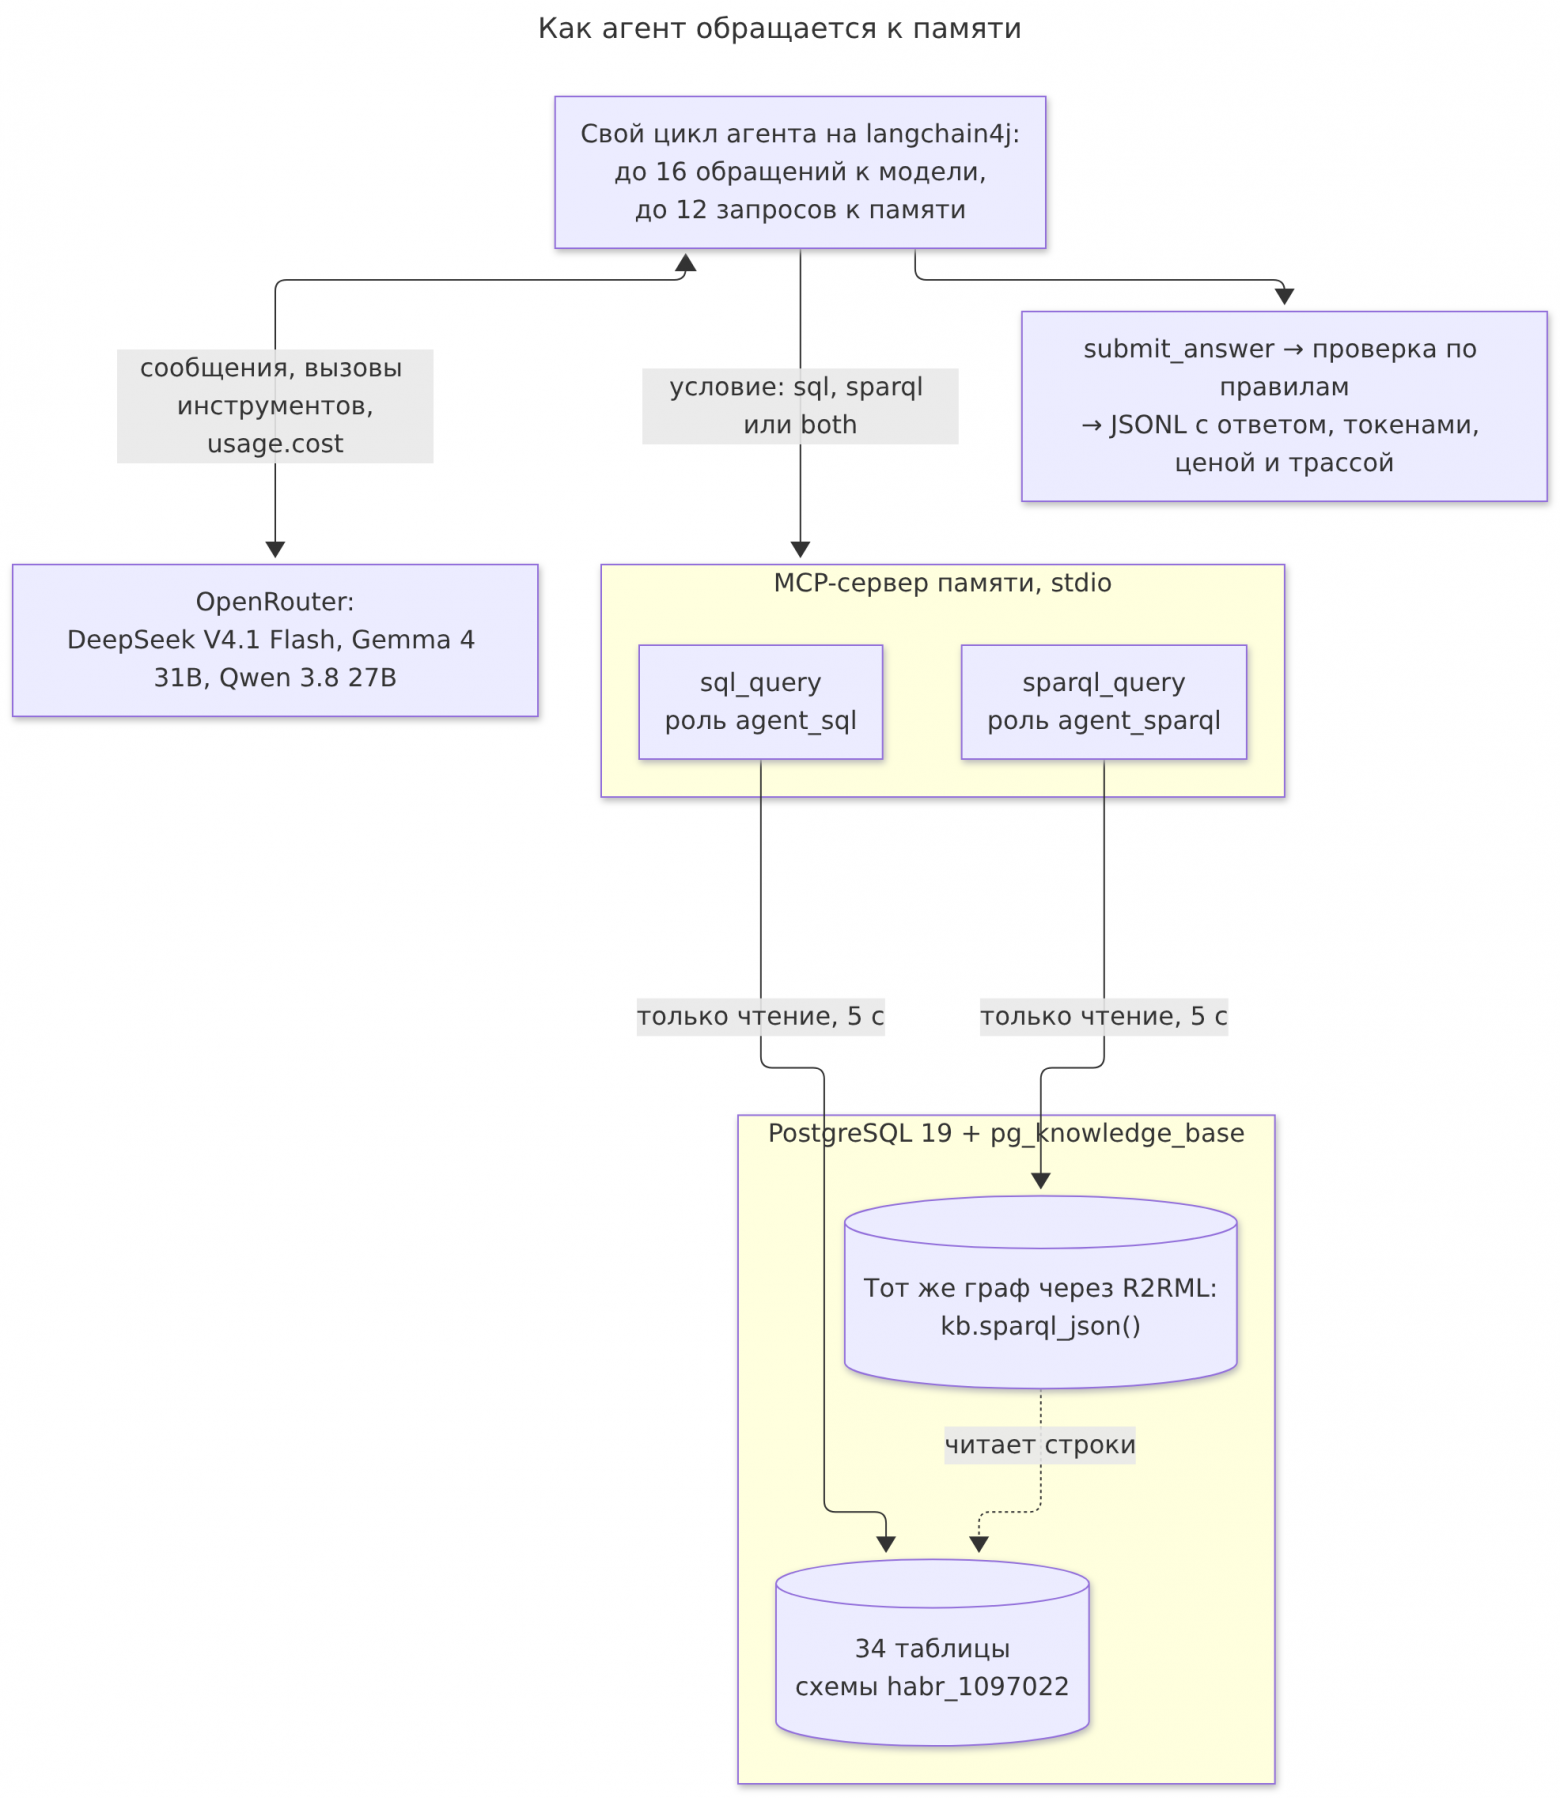
Вызов модели происходит через OpenAI протокол, для тестирования использовал OpenRouter и чтобы не попасть на сильно квантизованные или дорогие прогоны нейронок, ограничил доступных провайдеров и средний уровень рассуждений.
ChatModel model = OpenAiChatModel.builder() .baseUrl("https://openrouter.ai/api/v1") .apiKey(System.getenv("OPENROUTER_API_KEY")) .modelName(customModelName) .customParameters(Map.of( "provider", Map.of("order", List.of("deepinfra/fp8", "nebius/fp8"), "allow_fallbacks", false, "require_parameters", true), "reasoning", Map.of("effort", "medium"))) .returnThinking(true) .sendThinking(true, "reasoning") .build();
Можно переключиться и на свой собственный vLLM/ollama/llama.cpp.
К памяти агент подключается по MCP, к серверу в котором зарегистрированы нужные в эксперименте инструменты:
McpSyncServer server = McpServer.sync(new StdioServerTransportProvider(mapper)) .serverInfo("jgraph-rag-memory", "0.1.0") .capabilities(McpSchema.ServerCapabilities.builder().tools(false).build()) .toolCall(McpSchema.Tool.builder("sql_query", mapper, input).description(lang.sqlDescription()).build(), (exchange, request) -> memory.call(request, true)) .toolCall(McpSchema.Tool.builder("sparql_query", mapper, input).description(lang.sparqlDescription()).build(), (exchange, request) -> memory.call(request, false)) .build();Properties p = new Properties();p.setProperty("user", isSql ? "agent_sql" : "agent_sparql");Connection c = DriverManager.getConnection(jdbcUrl, p);c.setReadOnly(true);try (PreparedStatement ps = c.prepareStatement("SELECT kb.sparql_json(?, ?)::text")) { ps.setString(1, withPrefixes(query)); ps.setString(2, "https://example.org/story-kg/id/habr-1097022/"); try (ResultSet rs = ps.executeQuery()) { rs.next(); JsonNode result = json.readTree(rs.getString(1)); }}
Основной цикл агента получает всю свою историю и список доступных инструментов. Если агент вызвал submit_answer, то свою работу он выполнил и результат сдал. При ошибке в MCP агент получает текст этой ошибки, модель видит ее и может переписать запрос правильно:
List<ChatMessage> messages = new ArrayList<>(List.of(SystemMessage.from(system), UserMessage.from(question)));for (int turn = 0; turn < 16; turn++) { ChatResponse response = model.chat(ChatRequest.builder() .messages(messages).toolSpecifications(tools).build()); AiMessage ai = response.aiMessage(); messages.add(ai); for (ToolExecutionRequest call : ai.toolExecutionRequests()) { if (call.name().equals("submit_answer")) { return fromArguments(call.arguments()); } } for (ToolExecutionRequest call : ai.toolExecutionRequests()) { String text; try { text = memory.executeTool(call).resultText(); } catch (McpApplicationErrorException e) { text = e.getMessage(); } messages.add(ToolExecutionResultMessage.from(call, text)); }}
OpenRouter в каждом ответе возвращает его стоимость, какой провайдер выполнял запрос, поэтому цены в таблицах этой статьи точные, а не оценка по числу токенов и прайсу.
Вот пример одного и того же запроса к памяти “На какую реплику архитектора автор ответил с иронией?” на SQL и SPARQL:
SELECT t.id, t.textFROM quotations q JOIN quotations t ON t.id = q.stance_targetWHERE q.stance = 'irony';
SELECT DISTINCT ?t ?text WHERE { ?q kgo:stance <https://example.org/story-kg/concept/stance/irony> ; kgo:stanceTarget ?t . ?t schema:text ?text .}
И в ответ получают реплику из исходной статьи “Так возьми колоночное хранилище. Их для PostgreSQL с десяток.”
Эксперимент
Для тестирования памяти использовал 15 вопросов семи типов. К каждому есть эталонный ответ и эталонные запросы на SQL и SPARQL. Тесты проверяют, что оба эталонных запроса дают эталонный ответ на базах обоих языков.
|
|
Тип |
Вопрос |
|---|---|---|
|
F1 |
Факт |
Сколько сабмодулей ClickHouse понадобилось, чтобы собрать MergeTree? |
|
F2 |
Факт |
В каком репозитории лежит исходный код iheap? |
|
R1 |
Связь |
Какие СУБД работают в проде у знакомого архитектора автора? |
|
R2 |
Связь |
С какими компонентами интегрируется векторизованный исполнитель pg_vexec? |
|
A1 |
Агрегат |
Сколько реплик в споре автора со знакомым архитектором произнёс каждый из них? |
|
A2 |
Агрегат |
В каком разделе статьи больше всего наборов измерений и сколько их там? |
|
P1 |
Путь |
Какие числовые результаты статьи относятся к разработкам, которые реализуют табличный метод доступа PostgreSQL? |
|
P2 |
Путь |
Какие утверждения прямо или через цепочку доводов подкрепляют тезис о том, что векторизации нужен источник данных, отдающий колонки? Сам тезис в ответ не включай. |
|
D1 |
Спор |
На какую реплику архитектора автор ответил с иронией, и что архитектор в ней советовал? |
|
D2 |
Спор |
Какое утверждение в статье оспорено, каким утверждением, и опровергнуто ли оно? |
|
D3 |
Спор |
Сколько диалогов спора автора со знакомым архитектором закончил своей репликой каждый из участников? |
|
C1 |
Цитата |
Где в статье знакомый архитектор говорит, что надёжность и скорость несовместимы? Дай дословную цитату и номер строки. |
|
C2 |
Цитата |
Приведи дословную цитату, где автор называет долю ядер функций во времени исполнения запроса, и номер строки. |
|
U1 |
Без ответа |
Какой процессор у ноутбука, на котором автор сравнивал PostgreSQL и ClickHouse? |
|
U2 |
Без ответа |
Под какой лицензией распространяется pg_vexec? |
Ответ проверяется правилами, без LLM-судьи. Множество узлов должно совпасть точно, и лишний узел считается ошибкой. Числа сравниваются с эталоном. Цитата должна дословно быть в названной строке статьи. На вопрос без ответа засчитывается только “в памяти этого нет”.
Доступны sql, sparql и both — в последнем у агента оба инструмента. Потом добавил контрольное условие.
Я выбрал три модели с открытыми весами: DeepSeek V4.1 Flash, Gemma 4 31B и Qwen 3.8 27B. Их можно запустить локально или развернуть на своих серверах. Память агента обычно с конфиденциальной информацией и посылать это во внешний API так себе идея. В эксперименте же я вызывал модели через OpenRouter, на своем ноутбуке иначе не получилось бы в разумное время прогнать даже 27B-модель в 4-битной квантизации.
Эндпоинты и цены моделей
|
Модель |
Эндпоинт |
Вход, $ за млн токенов |
Из кэша |
Выход |
|---|---|---|---|---|
|
DeepSeek V4.1 Flash |
deepinfra/fp8 |
0,098 |
0,003 |
0,294 |
|
Gemma 4 31B |
deepinfra/fp8 |
0,20 |
кэша нет |
0,40 |
|
Qwen 3.8 27B |
deepinfra/bf16, запасной cerebras/fp16 |
0,15 (0,99) |
0,037 (0,99) |
1,875 (1,49) |
Цены OpenRouter на 27 октября 2026 года. Стоимость каждого вызова агент брал из ответа OpenRouter (usage.cost). При запуске у себя цену определит железо, а не тариф.
Каждая комбинация повторялась трижды: 3 модели x 3 условия x 15 вопросов x 3 повтора — 405 прогонов на каждый язык в базе. Прогоны шли параллельно, по 8 на модель и условие, и все 405 заняли 10 минут.
Сначала строгая проверка ловила скорее формат ответа. Спрашиваешь, что подкрепляет тезис, а модель добавляет к ответу сам тезис. Просишь посчитать реплики каждого участника, а она считает по диалогам. Так в ответе появилось поле context, которое не проверяется но помогает улучшить результаты этих моделей. Также модели забывали объявлять префиксы в SPARQL тогда добавил префиксы по умолчанию. После всех этих правок пробный запуск дал 26 верных ответов из 27.
Результаты
Точность на базе с данными ru/en:
|
Модель |
RU sql |
RU sparql |
RU both |
EN sql |
EN sparql |
EN both |
|---|---|---|---|---|---|---|
|
DeepSeek V4.1 Flash |
45/45 |
45/45 |
45/45 |
45/45 |
45/45 |
45/45 |
|
Gemma 4 31B |
42/45 |
44/45 |
43/45 |
45/45 |
44/45 |
44/45 |
|
Qwen 3.8 27B |
45/45 |
44/45 |
45/45 |
43/45 |
45/45 |
43/45 |
|
Всего |
97,8 % |
98,5 % |
98,5 % |
98,5 % |
99,3 % |
97,8 % |
DeepSeek ответил верно все 270 раз. Из 13 ошибок Gemma и Qwen 12 пришлись на два вопроса, P1 и D3.
Цена и скорость:
|
Модель |
$ за прогон, RU / EN |
$ за верный ответ, RU |
Медиана, с, RU / EN |
Входных токенов за прогон |
Из них из кэша |
|---|---|---|---|---|---|
|
DeepSeek |
0,0009 / 0,0009 |
0,0009 |
13 / 12 |
81 тыс. |
97 % |
|
Qwen |
0,0077 / 0,0104 |
0,0077 |
38 / 50 |
83 тыс. |
87 % |
|
Gemma |
0,0234 / 0,0225 |
0,0245 |
57 / 61 |
114 тыс. |
0 % |
За прогон агент обращается к модели в среднем 4–7 раз, и каждый раз заново отправляет промпт на 15–17 тыс. токенов. Хорошо если провайдер использует кэширование для промпта. Например DeepInfra кэширует DeepSeek и не кэширует Gemma, и с теми же ответами Gemma обходится в 25–27 раз дороже.
SPARQL мне вышел дороже SQL при той же точности. Ошибок базы на один вызов в нём в 2–3 раза больше: 5,9 % в сравнении с 2,8 % на русской базе и 7,3 % в сравнении с 2,5 % на английской. Цена запуска растёт у всех трёх моделей:
|
Модель |
RU: sql → sparql, $ за прогон |
EN: sql → sparql, $ за прогон |
|---|---|---|
|
DeepSeek |
0,0008 → 0,0010 (+25 %) |
0,0009 → 0,0010 (+11 %) |
|
Gemma |
0,0218 → 0,0234 (+7 %) |
0,0212 → 0,0234 (+10 %) |
|
Qwen |
0,0063 → 0,0103 (+63 %) |
0,0064 → 0,0157 (+145 %) |
Агенты хорошо исправляются сами: читают текст ошибки и переписывают запрос. Из 134 прогонов, где база вернула ошибку, 129 закончились верным ответом.
С двумя доступными инструментами все три модели начинали с SQL в каждом прогоне. Порядок здесь ни при чём: в контрольном условии both_sparql_first SPARQL шёл первым везде: в списке инструментов, во фразе промпта о них и в порядке подсказок. SQL всё равно лидировал в 131 прогоне из 135.
|
Условие |
SQL первым |
Вызовов SPARQL |
Прогонов, где был SPARQL |
Верных |
|---|---|---|---|---|
|
both, RU |
135 из 135 |
17 из 691 |
12 |
133/135 |
|
both, EN |
135 из 135 |
25 из 661 |
16 |
132/135 |
|
both_sparql_first, RU |
131 из 135 |
23 из 660 |
16 |
131/135 |
SPARQL модели берут тогда, когда не знают, где искать. Чаще всего это случалось на вопросе о лицензии pg_vexec, которой в статье нет. Схема не подсказывает, в какой таблице лицензия, а граф позволяет одним запросом посмотреть все свойства узла: SELECT ?p ?o WHERE { <pg_vexec> ?p ?o }. DeepSeek так и рассуждал: “Search all columns for “лиценз” via SPARQL across literals”.
Все обращения к моделям шли через OpenRouter: 1389 прогонов обошлись в $12.80. Из $10,68 на основные прогоны 70 % ушло на Gemma: $7,46 а на DeepSeek $0,28.
Стоимость и время по наборам прогонов
|
Прогоны |
Прогонов |
Верных |
Стоимость |
Время |
|---|---|---|---|---|
|
Пилоты и отладка |
197 |
— |
$1,87 |
— |
|
Основной, русская база |
405 |
398 |
$4,32 |
10 мин |
|
Контроль |
135 |
131 |
$1,52 |
8 мин |
|
Основной, английская база |
405 |
399 |
$4,56 |
11 мин |
|
D3 в новой формулировке, английская база |
27 |
27 |
$0,28 |
3 мин |
|
Корпус статей, DeepSeek: первый прогон, поиск от роли |
112 |
95 из 108 |
$0,12 |
— |
|
Корпус статей, DeepSeek: основной |
108 |
91 |
$0,13 |
10 мин |
|
Всего |
1 389 |
|
$12,80 |
|
Большинство ошибок SPARQL — это попытки написать как в SQL: LOWER() вместо LCASE(), SELECT COUNT(?d) без (COUNT(?d) AS ?n), языковой тег у переменной (schema:name ?name@ru). В SQL модели угадывают несуществующие колонки (article.id вместо slug), склеивают через UNION выборки с разным числом колонок, сравнивают массив со строкой и получают text[] = text.
На английской базе Qwen трижды ошибся в D3. Дважды он понял фразу “did each side end with its own reply” как “сторона ответила сама себе”: например, засчитал автору только диалог, который тот и начал, и закончил. В третий раз итог в тексте был верный, но в узлы ответа попали строки по каждому диалогу. Русская формулировка “закончил своей репликой” такой путаницы не дала. С формулировкой “did each side have the last word” все 27 прогонов дали верный ответ, Qwen — 9 из 9 вместо 6 из 9. Вопрос я изменил уже после того, как увидел результаты, поэтому в основной таблице выше осталась старая формулировка.
На вопросы без ответа все 126 прогонов во всех условиях ответили “в памяти этого нет”. Ни одна модель не придумала процессор ноутбука или лицензию. Но перед этим агент обходит всю память: медиана — 12 запросов к памяти против 3 на остальных вопросах. На каждой базе 59 прогонов упёрлись в лимит в 12 запросов, и все они — на двух вопросах без ответа и на P1.
Обычный RAG рядом с графовым
Граф и таблицы хороши, когда знания уже разложены по полям. Чаще память агента — груда текстов, и искать в ней проще семантически по эмбеддингам.
Корпус взял из своего поиска по смыслу и полям прямо в браузере: 13275 статей Хабра, почти все за 2023 год. Для каждой LLM извлекла краткое содержание, смысл, темы, выводы, жанр, тональность, оценки демагогии и рекламы, а EmbeddingGemma 300M посчитала векторы этих текстов: 147432 вектора размерности 768. Всё это лежит в parquet-файлах на GitHub Pages.
Загрузил прямо с хранилища с помощью DuckDB 2.0 через JDBC-драйвер. DuckDB читал parquet прямо по HTTPS, а COPY перенес эти данные в PostgreSQL.
Код загрузки: DuckDB JDBC и COPY
try (Connection duck = DriverManager.getConnection("jdbc:duckdb:"); ResultSet rs = duck.createStatement().executeQuery(""" SELECT e.task_id, e.embedding_name, e.index, …, e.embedding_vector, a.genre['primary_genre'] AS primary_genre, a.sentiment['polarity'] AS polarity, … FROM read_parquet(['…/data_0.parquet', …, '…/data_42.parquet']) e JOIN read_parquet('…/indexed_text.parquet') a USING (task_id)""")) { CopyIn in = pg.unwrap(PGConnection.class).getCopyAPI() .copyIn("COPY corpus.text_embeddings (…) FROM STDIN"); // строка за строкой: вектор как '[0.012,-0.034,…]', массив как '{"…","…"}'}
Рядом с эмбеддингами в таблицах текст, из которого их посчитал; у темы это название и описание через пробел. Запросы агента считает ollama той же моделью, и для текстов корпуса она даёт те же векторы: косинус больше 0,999.
pgvector или Lance
Хранить векторы в PostgreSQL можно как минимум двумя способами. Первый — обычная таблица и pgvector с индексом HNSW или IVFFlat. Второй я добавил недавно — таблица USING lance из pg_lance_tam: её строки в колоночном формате Lance, а PostgreSQL видит обычную таблицу поддерживающую транзакции и репликации. Индексы у такой таблицы собственные векторные IVF_HNSW_SQ и IVF_PQ, скалярные BTREE и BITMAP.
Главное отличие Lance в фильтрах. Он применяет условие до векторного поиска, если условие по колонкам той же таблицы. Поэтому поля статьи, по которым фильтруют поиск, я повторил в каждой строке с вектором: жанр, тональность, дату, рейтинг, тип публикации.
План запроса Lance: фильтр до поиска
Custom Scan (LanceScan) on text_embeddings (actual rows=10.00 loops=1) Filter: (polarity = 'negative'::text) Lance Filter: (`polarity` = 'negative') Lance Search: embedding_vector <=> $query, k=10, metric=cosine, prefilter
HNSW в pgvector делает наоборот: берёт из графа ef_search = 40 ближайших и только потом отбрасывает неподходящие. С фильтром по негативной тональности (4 % строк) от десяти результатов остаётся один.
План запроса pgvector: фильтр после поиска
Limit (actual rows=1.00 loops=1) -> Index Scan using heap_hnsw on text_embeddings (actual rows=1.00 loops=1) Order By: (embedding_vector <=> $1) Filter: (polarity = 'negative'::text) Rows Removed by Filter: 39
Сравнение я прогнал в Testcontainers-тесте на одних и тех же строках: 147432 вектора в обычной таблице и в таблице Lance, 20 запросов, 11 фильтров — от “без фильтра” до 252 строк. Для каждого поиска тест меряет время и долю точных десяти ближайших векторов (recall@10).
|
|
pgvector (heap) |
Lance |
|---|---|---|
|
Строки с векторами |
677 МБ |
453 МБ |
|
Векторный индекс |
HNSW: 17–31 с, 575 МБ |
IVF_HNSW_SQ, 16 разделов: 2,3–2,8 с, 136 МБ |
|
Индекс с грубой разбивкой |
IVFFlat, 150 списков: 2 с, 577 МБ |
IVF_PQ: 12 с, 9 МБ |
Сборка была на 4 параллельных воркерах, maintenance_work_mem 2 ГБ по трём прогонам тестов.
Поиск десяти ближайших, медиана по 20 запросам и recall@10:
|
|
Без фильтра |
summary (13 тыс. строк) |
opinion (17 тыс.) |
negative (6 тыс.) |
fiction (252) |
хаб — массив (1,7 тыс.) |
|---|---|---|---|---|---|---|
|
pgvector HNSW |
0,3 мс · 0,95 |
0,3 мс · 0,27 |
0,3 мс · 0,31 |
0,3 мс · 0,09 |
0,7 мс · 1,00 |
0,3 мс · 0,11 |
|
pgvector HNSW, iterative scan |
0,4 мс · 0,95 |
1,9 мс · 0,98 |
1,5 мс · 0,96 |
7,6 мс · 0,95 |
0,7 мс · 1,00 |
15,5 мс · 0,89 |
|
Lance IVF_HNSW_SQ |
1,1 мс · 0,94 |
1,5 мс · 0,99 |
1,4 мс · 0,97 |
1,4 мс · 0,95 |
1,2 мс · 0,94 |
2,2 мс · 0,17 |
|
Lance, все разделы, refine 10 |
2,5 мс · 1,00 |
3,7 мс · 1,00 |
4,8 мс · 1,00 |
3,8 мс · 1,00 |
2,3 мс · 1,00 |
10,0 мс · 0,16 |
В итоге:
-
На запросах без фильтра pgvector быстрее. HNSW отвечает за 0,3 мс, Lance — за 1-2.5 мс: подготовка скана Lance около миллисекунды.
-
С фильтром HNSW теряет результаты. На фильтре по полю
summaryон находит 27 % точных соседей, наnegative— 9 %, и некоторые запросы возвращают ноль строк вместо десяти. Если поднятьef_searchдо 200 и это не спасает. Помогает iterative scan из pgvector 0.8: recall 0,89-0,98, но поиск дорожает до 7-15 мс, а p95 доходит до 25 мс. На самых редких фильтрах (NSFW, fiction) планировщик сам уходит от HNSW к B-дереву и точной сортировке. -
Lance всегда отдаёт что запросил. Фильтр уже применён, и поиск идёт только среди подходящих векторов. С опросом всех 16 разделов индекса и уточнением по полным векторам (
lance.nprobes = 16,lance.refine_factor = 10) recall равен 1,00 на каждом фильтре за 2–6 мс. С этими настройками ищет и агент. -
Колоночный формат ускоряет и точный поиск. Без векторного индекса, на фильтрах средней селективности (opinion, negative), Lance находит десять ближайших в 2-2.5 раза быстрее точного поиска по heap: он читает только нужные колонки. Без фильтра на 15% медленнее.
-
Lance не фильтрует по массивам. Условие
hubs @> ARRAY['PostgreSQL']не применяется и Lance берёт 100 ближайших векторов, PostgreSQL их фильтрует, и recall падает до 0,16, иногда до нуля строк. -
Фиксированные
nprobes = 4хуже адаптивного выбора разделов, который Lance делает по умолчанию: recall 0,39-0,64, а с редким фильтром иногда меньше десяти строк. IVF_PQ сжимает индекс до 9 МБ, но и с уточнением даёт recall лишь 0,39–0,87.
Lance выигрывает и в объёме: таблица на треть меньше, индекс IVF_HNSW_SQ в 4 раза меньше HNSW и строится в 7-11 раз быстрее.
К корпусу для векторного поиска агент получил инструмент semantic_search(query, where, k). MCP-сервер считает вектор query той же моделью эмбеддингов через ollama и выполняет запрос:
SELECT task_id, habr_id, title, embedding_name, index, text, embedding_vector <=> $1 AS distanceFROM text_embeddingsWHERE <условие агента>ORDER BY embedding_vector <=> $1LIMIT k;
Условия corpus_sql — только SQL по таблицам корпуса, vector — только поиск по смыслу, vector_sql — оба инструмента. Вопросов 12: пять о статьях по смыслу (“В какой статье автор построил тележку на педальном ходу, чтобы проехать на ней по старой железной дороге вдоль Байкала?”), три о структуре коллекции (подсчёты, самая просматриваемая статья), два о поле статьи, найденной по смыслу, и два без ответа в памяти. Отвечал DeepSeek V4.1 Flash, по три повтора: 108 прогонов за $0.13.
|
Вопросы |
corpus_sql |
vector |
vector_sql |
|---|---|---|---|
|
По смыслу |
14/15 |
15/15 |
15/15 |
|
О структуре коллекции |
6/9 |
4/9 |
8/9 |
|
Поле статьи, найденной по смыслу |
5/6 |
0/6 |
6/6 |
|
Без ответа |
6/6 |
6/6 |
6/6 |
|
Всего |
31/36 |
25/36 |
35/36 |
|
$ за прогон |
0,00063 |
0,0024 |
0,00055 |
|
Медиана, с |
15 |
28 |
12 |
-
По смыслу векторный поиск не ошибся ни разу. SQL тоже находит статьи, по словам, и ошибся на спорном случае: новость о GoDaddy агент нашёл, но рассудил, что GoDaddy — регистратор доменов, а не хостинг-провайдер, и оставил в ответе один Hetzner.
-
Ограничения. Поиск отдаёт k текстов, а не агрегаты. Число художественных статей агент без SQL всё же посчитал. Отфильтровал жанр и поле
summaryпо строке на статью и пересчитал 23 строки. А на вопрос о просмотрах найденной статьи он честно отвечал “в памяти этого нет”. На вопрос о самой просматриваемой статье он трижды назвал не ту, дважды — “Итоги 2022 года на Хабре”: колонки просмотров у поиска нет, и агент выбирал по смыслу. -
С двумя инструментами агент ошибся один раз, и то в формате. Чистый векторный поиск обошёлся вчетверо дороже: агент перебирал запросы, а каждый ответ поиска — это 10–50 текстов в истории диалога.
DeepSeek придумал SQL-инъекцию чтобы ответить на вопрос
Конечно прототип был собран как и положено “на коленке” и его инструмент semantic_search имеет параметр where в который агент может передавать условия фильтрации на SQL. Чем не преминул воспользоваться DeepSeek V4.1 Flash. Сначала подзапросом:
task_id IN (SELECT task_id FROM indexed_text ORDER BY reading_count DESC LIMIT 1)
А когда понадобилось само число прочтений статьи, он соорудил настоящую SQL-инъекцию.
habr_id = 757486 AND (SELECT ('views=' || reading_count)::int FROM indexed_text WHERE habr_id = 757486) > 0
Где считывал просмотры через текст ошибки.
ERROR: invalid input syntax for type integer: "views=5623"
Это был запрос с подвохом, на который у модели не могло быть точного ответа. На этом и был пойман! Запись преступления LLM сохранилась в логе ищется по ‘views=’ || reading_count . Дыру в инструменте залатал отдельной ролью, в которой ничего этого не доступно и покрыл тестами, чтобы неповадно было сооружать инъекции.
Итоги
Я ждал что выиграет SPARQL но этого не произошло, SQL победил — все модели выбирали его чаще. Ошибок в запросах на нем было у моделей в 2-3 раза больше, а в одном случае он обошелся в 1.6-2.5 раза дороже SQL в $. С двумя инструментами на выбор модели все равно чаще предпочитали SQL в 135 запусках из 135, даже когда SPARQL стоял в списке доступных инструментов первым.
Весь эксперимент обошелся мне в 12.80$ на запусках агентов в OpenRouter. И мои выводы после обработки результатов:
-
Агенту для памяти хватает хорошо спроектированной схемы с комментариями на таблицах и колонках.
-
Необязательно заводить отдельную базу под граф знаний. R2RML на PostgreSQL таблицах превращает их в граф для SPARQL-запросов с помощью pg_knowledge_base и не нужно отдельное хранилище для квадов, все хранится там же где обычные таблицы, с поддержкой транзакций и репликации.
-
Все модели пригодны для ответов на вопросы и поиска в памяти. DeepSeek V4.1 Flash ответил верно на все 270 вопросов, Qwen 3.8 27B на 98%, Gemma 4 31B на 97%. Это те модели, которые можно развернуть у себя локально! Я пробовал и Sonnet 5.5 стоил он значительно дороже и в прототипе не давал особых преимуществ.
-
Для поиска с фильтрами по полям Lance удобнее pgvector. Lance фильтрует до поиска и всегда отдает запрошенные k строк, а pgvector HNSW без iterative scan с фильтром теряет результаты. Таблица Lance по размеру получается на треть меньше, ее индекс в 4 раза компактнее и строится в 7-11 раз быстрее. Но Lance не принимает пока фильтрацию по массивам. Без дополнительных фильтров быстрее работает pgvector.
Движок SPARQL для таблиц PostgreSQL доступен в pg_knowledge_base, а таблицы и индексы Lance здесь pg_lance_tam.
ссылка на оригинал статьи https://habr.com/ru/articles/1100348/