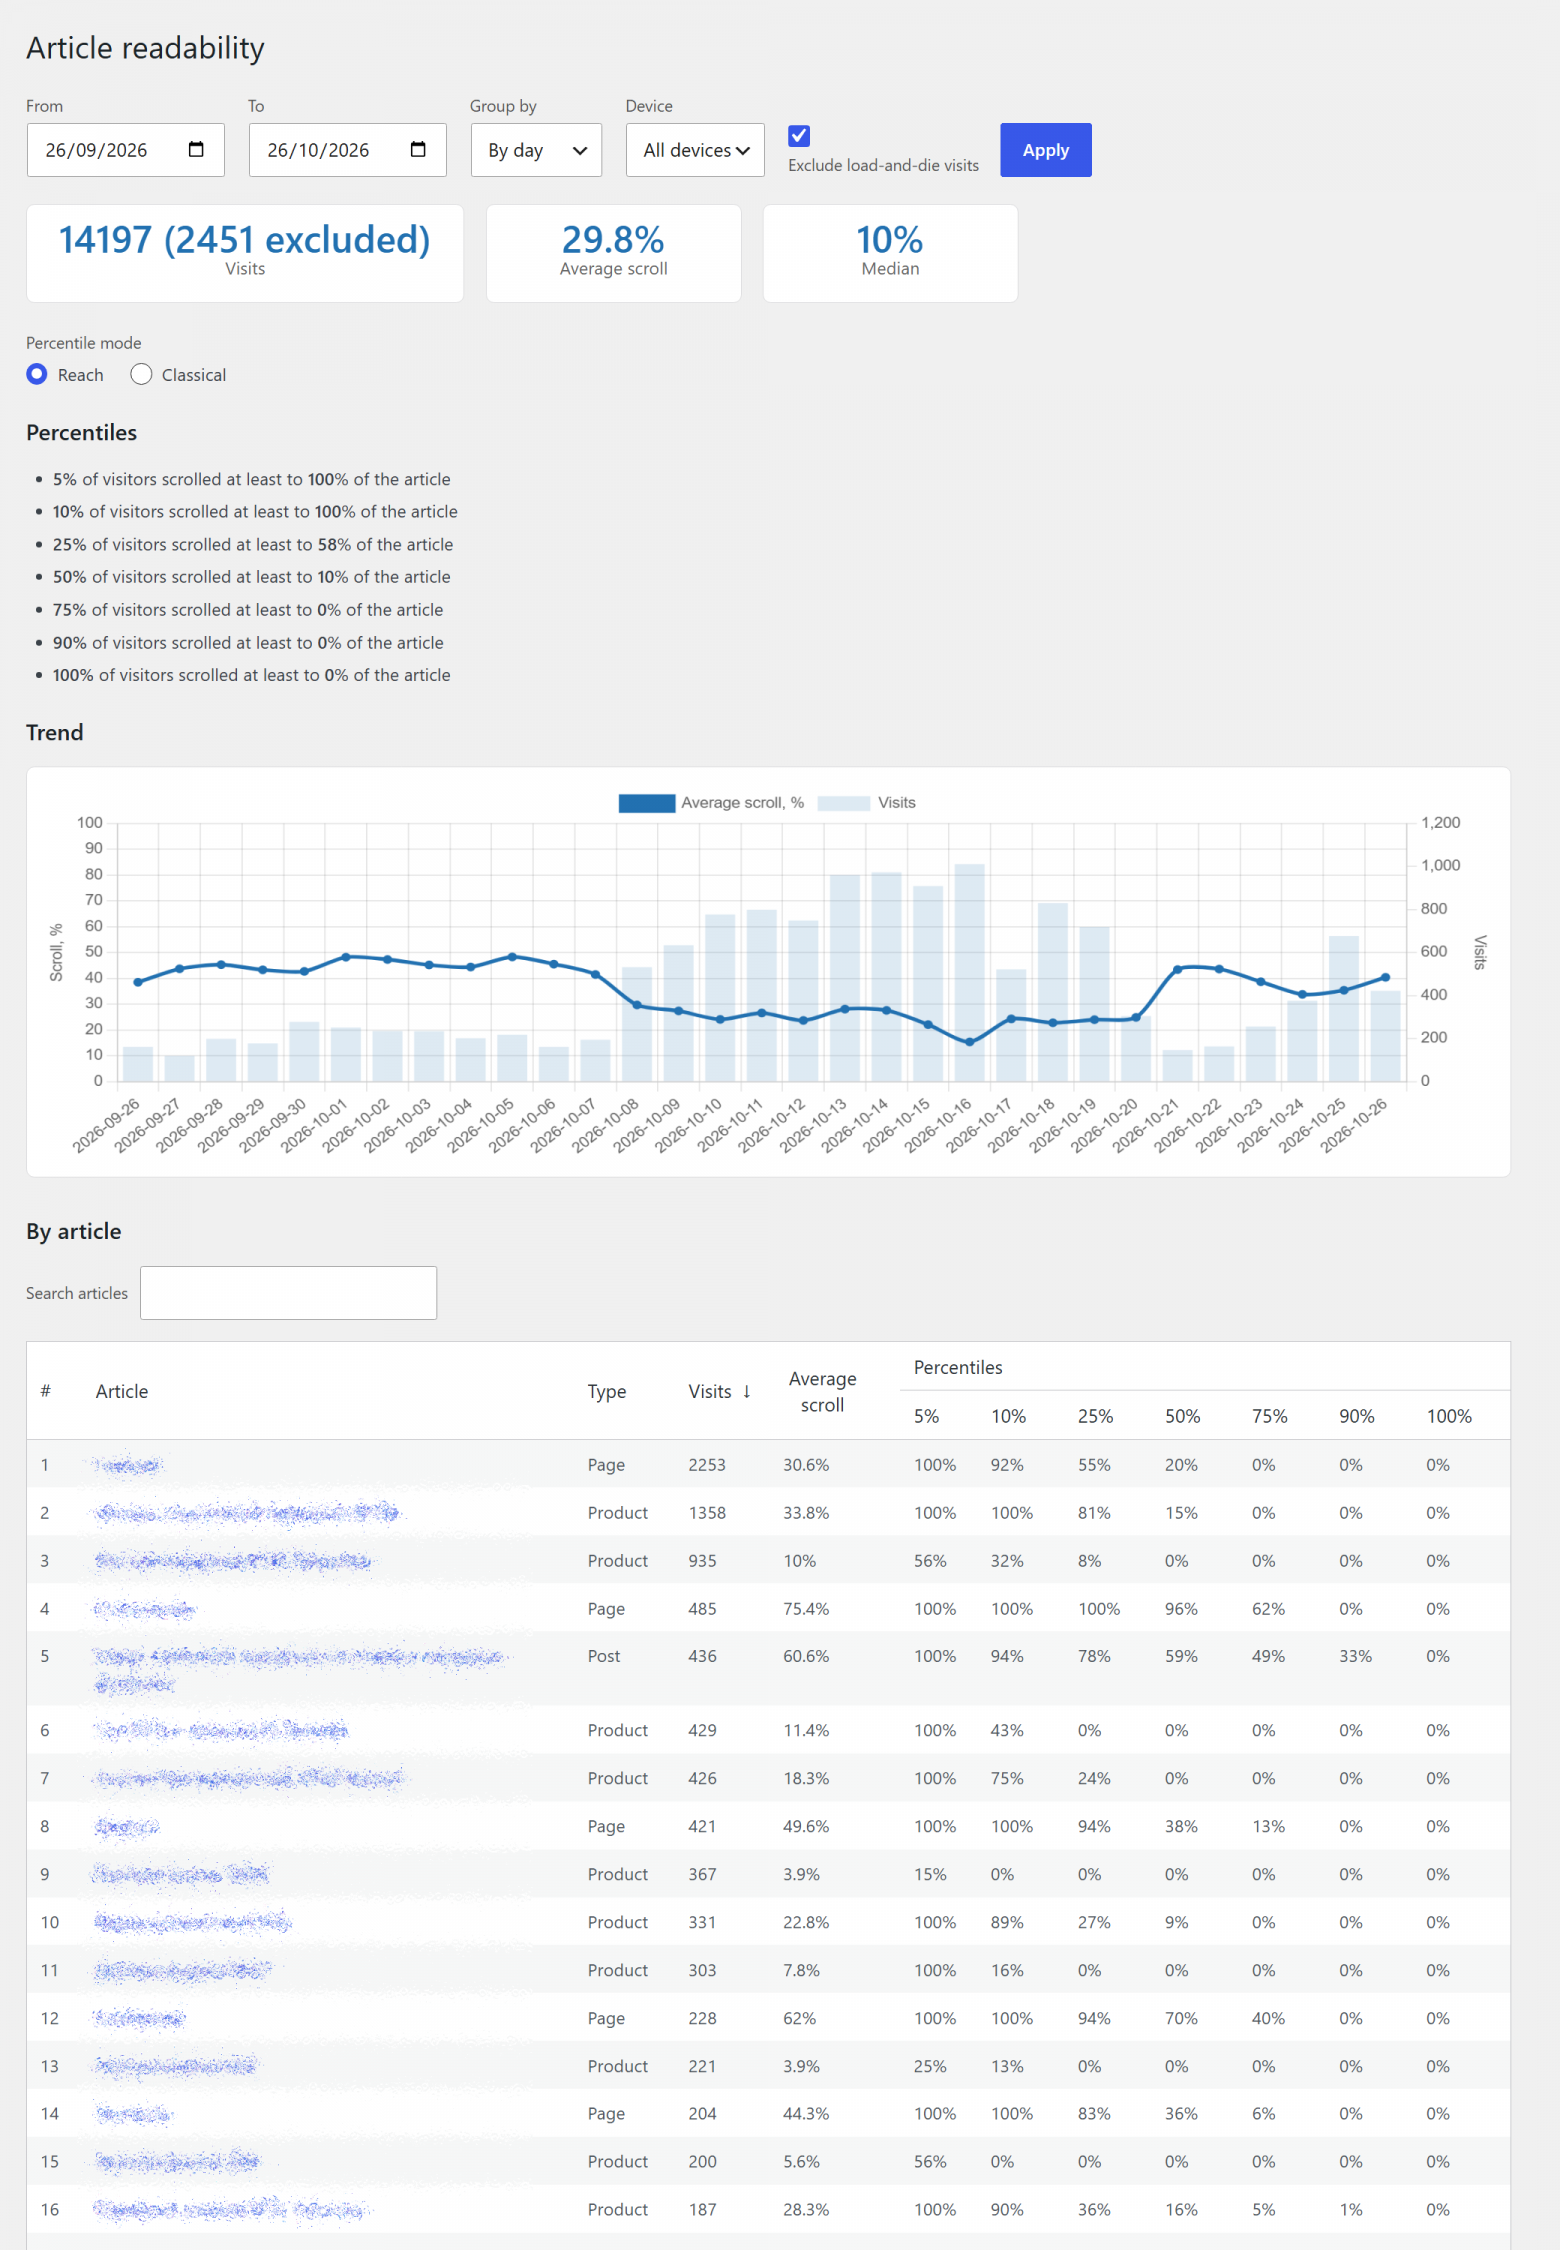
Вы опубликовали статью. Счётчик показывает пару тысяч просмотров. Но кто-нибудь её на самом деле прочитал? Обычная аналитика на этот вопрос не отвечает: человек, закрывший вкладку через три секунды, и человек, дочитавший до последней строки, для счётчика одинаковы — «1».
Хуже того, ответа не даёт и «средняя глубина прокрутки», которая есть почти в каждом сервисе веб-аналитики. О том, почему она врёт и как я решал обе задачи в бесплатном плагине AnGo Scroll Analytics для WordPress, — эта статья. Внутри: процентили вместо среднего, трекер на чистом JavaScript, отправка данных через sendBeacon, upsert с GREATEST() и принцип «клиент враждебен».
Почему средняя глубина врёт
Сравните две статьи. У обеих средняя глубина просмотра — 30%:
-
Статья №1. Большинство посетителей читают примерно треть материала и уходят — интерес затухает равномерно.
-
Статья №2. 90% посетителей уходят почти сразу, зато оставшиеся 10% дочитывают до конца.
Среднее одинаковое, проблемы противоположные. Первой, возможно, нужно резать длину; второй — переписывать вступление и сверять заголовок с содержанием. Одно число эти ситуации не различает, поэтому любое действие по средней глубине — лотерея.
Два режима процентилей
Вместо одной цифры плагин считает процентили 5, 10, 25, 50, 75, 90 и 100 в двух режимах.
Reach отвечает на вопрос «насколько далеко дошли лучшие читатели?» — это значение глубины, которого достигли минимум p% визитов.
Classical — привычный процентиль с семантикой Excel (PERCENTILE.INC): глубина, ниже которой лежат p% визитов, с линейной интерполяцией между соседними наблюдениями.
Оба режима считаются из одного отсортированного набора, но независимо: reach берёт значение по индексу на убывающем массиве, classical интерполирует на возрастающем. Числа могут расходиться на доли процента — это намеренно: тот, кто сверяет дашборд с Excel, должен получать число Excel.
Условный пример — пусть по статье видно следующее:
|
Процентиль |
Reach |
Classical |
|---|---|---|
|
5 |
100% |
0% |
|
10 |
100% |
0% |
|
25 |
64% |
0% |
|
50 |
12% |
12% |
|
75 |
— |
64% |
Читается так:
-
Classical P25 = 0% — четверть аудитории не сделала ни одного скролла. Вообще.
-
Classical P50 = 12% — половина посетителей уходит после первых 12% прокручиваемой высоты.
-
Classical P75 = 64% — три четверти аудитории не проходят дальше 64%: до призыва к действию в конце добирается меньше людей, чем кажется автору.
-
Reach P25 = 64% — зато лучшая четверть дочитывает минимум до двух третей материала.
Reach P25 = 64% и Classical P75 = 64% — это одно и то же поведение, увиденное с двух сторон: режимы зеркальны. Совместно они говорят: ядро статьи работает (есть заинтересованная группа читателей), но начало теряет массу. Проверять стоит соответствие содержания заголовку, длину вступления, отвлекающие блоки до основного текста и положение призыва к действию.
Зачем нужны низкие процентили
Классический набор 50/75/90 на аудитории с большим числом отказов вырождается: три строки из четырёх читаются как ноль и не сообщают ничего. «25% посетителей дошли минимум до 64%» остаётся информативным, даже когда 75% визитов — отскоки. Поэтому 5, 10 и 25 лежат в таблице рядом с классическими 50–100.
Трекер: шесть килобайт без зависимостей
Скрипт — около шести килобайт чистого JavaScript, без библиотек. Подключается только на одиночных страницах публичных типов контента: записи, страницы, товары WooCommerce, произвольные типы — всё, что зарегистрировано с public => true, кроме attachment. Список подрезается фильтром ango_trackable_post_types.
Идентификатор визита живёт в sessionStorage: новая вкладка или сессия — новый визит. Обращение к хранилищу обёрнуто в try/catch: браузер, блокирующий site data, бросает SecurityError и не должен убивать трекер. Визит всё равно запишется — просто перезагрузка в той же вкладке посчитается отдельным визитом.
Глубина считается по прокручиваемой высоте документа:
function calcScrollPercent() { var doc = document.documentElement; var scrollTop = window.scrollY || doc.scrollTop || 0; var winHeight = window.innerHeight; var fullHeight = Math.max( doc.scrollHeight, document.body.scrollHeight ); var scrollable = fullHeight - winHeight; if ( scrollable <= 0 ) { return layoutSettled ? 100 : 0; } var percent = Math.round( ( scrollTop / scrollable ) * 100 ); return Math.min( 100, Math.max( 0, percent ) );}
Тонкость здесь — ветка scrollable <= 0. До события load она неоднозначна: либо страница действительно помещается в один экран, либо «ниже первого экрана» ещё не отрендерилось (ленивые изображения, веб-шрифты) и высота схлопнулась. Записать 100 на ранней догадке нельзя: максимум никогда не уменьшается, и ошибка застрянет навсегда. Поэтому до load возвращаем 0 и переспрашиваем на каждом следующем бейконе, а после load раскладка считается финальной.
Отправка данных:
function sendData( useBeacon, force ) { // Максимум пересчитывается синхронно: скролл, сразу за которым пришёл // pagehide, иначе ушёл бы со значением на кадр устаревшим. var current = calcScrollPercent(); if ( current > maxScroll ) { maxScroll = current; } if ( ! force && maxScroll <= lastSent ) return; lastSent = maxScroll; var payload = JSON.stringify( { visit_uid: visitUid, post_id: postId, max_scroll: maxScroll, time_on_page: Math.round( ( Date.now() - startTime ) / 1000 ), referrer: document.referrer || '', device: deviceClass } ); if ( useBeacon && navigator.sendBeacon ) { navigator.sendBeacon( url, new Blob( [ payload ], { type: 'application/json' } ) ); } else { fetch( url, { method: 'POST', headers: { 'Content-Type': 'application/json' }, body: payload, keepalive: true } ).catch( function () { lastSent = -1; // значение не записалось — повторим на следующей проверке } ); }}
Схема такая:
-
обработчик скролла троттлится через requestAnimationFrame;
-
проверка прогресса идёт раз в пять секунд, но запрос уходит только если максимальная глубина выросла — простой читателя не порождает ни одного запроса;
-
уход со страницы ловят visibilitychange и pagehide: sendBeacon, а там, где его нет, — fetch с
keepalive: true; -
первый бейкон уходит сразу при загрузке: визит без скролла — всё равно визит. Процентили описывают все заходы, включая отскоки; иначе метрика молча измеряет выживших.
Сервер: клиент враждебен
Публичный эндпоинт — POST /ango/v1/depth. Пространство имён и путь нарочно нейтральные: «tracker» или «track» в URL — стандартная цель generic-правил блокировщиков, а заблокированный скрипт теряет данные молча.
С входом обращаются так:
-
max_scrollзажимается в диапазон 0–100,time_on_page— 0–86400; -
referrer прогоняется через
esc_url_rawи обрезается до 2000 символов: колонка TEXT, но 60 КБ на каждый бейкон нам не нужны; -
deviceсверяется с белым списком mobile/tablet/desktop; неизвестное значение — в том числе пустое от страницы, ещё сидящей в кеше со старым трекером, — сохраняется как «неизвестно», а не отбивает запрос ошибкой; -
post_idобязан существовать,visit_uid— не быть пустым.
Залогиненные пользователи по умолчанию не считаются (фильтр ango_track_logged_in включает подсчёт, если мультиавторский блог хочет видеть авторов в статистике). Проверка стоит в двух местах: при подключении скрипта и в обработчике эндпоинта. Второй раз — потому что конфигурации «кэшировать всё» отдают анонимную закешированную страницу, вместе со скриптом, и залогиненным читателям: отсутствие скрипта в HTML ничего не гарантирует. Решение о том, кого считать, вообще не должно жить на клиенте.
Троттлинг — 60 запросов в минуту на IP (лимит меняется фильтром ango_rate_limit). Ключ транзиента — md5 от IP и соли, сам IP не хранится. Без валидного IP троттлинг fails open: это спам-тормоз, а не фаервол. За реверс-прокси REMOTE_ADDR — адрес прокси, и все посетители делят одно ведро; в такой конфигурации лимит нужно поднимать.
Одна запись вместо двух
Первая версия хранилища писала визит в два шага: SELECT по ключу (visit_uid, post_id), затем INSERT или UPDATE. У схемы было окно: два пересекающихся бейкона оба не находили строку, оба делали INSERT, и проигравший гонку за уникальный ключ молча терял свою глубину.
Правильная форма — один upsert:
INSERT INTO wp_ango_visits ( visit_uid, post_id, max_scroll, time_on_page, referrer, device, created_at, updated_at )VALUES ( %s, %d, %d, %d, %s, %s, %s, %s ) -- prepare() опущен для краткостиON DUPLICATE KEY UPDATE max_scroll = GREATEST( max_scroll, VALUES( max_scroll ) ), time_on_page = GREATEST( time_on_page, VALUES( time_on_page ) ), updated_at = VALUES( updated_at )
GREATEST() гарантирует, что никакой писатель не может уменьшить уже записанное: бейконы могут приходить в любом порядке и дублироваться — рекорды глубины и времени переживут всё.
Две детали, о которые обычно спотыкаются:
-
Синтаксис
VALUES(), а не row-alias из MySQL 8.0.19+ (INSERT ... AS new ...). Alias-форма на MariaDB не работает, а WordPress живёт и там;VALUES()работает на обеих СУБД — в свежих ветках MySQL он помечен как deprecated, но рабочей альтернативы, покрывающей одновременно MariaDB, нет. -
referrer и
deviceзаписываются только первой вставкой. Для referrer причина очевидна: источник перехода — свойство начала визита. Дляdeviceто же самое: класс описывает устройство, на котором визит начался, — поворот телефона посреди чтения не должен переклассифицировать уже записанную строку. GREATEST для категориального значения не имеет смысла, поэтому этих колонок в UPDATE просто нет.
Уборка данных: роботы, пояса, устройство
Визиты «загрузил и ушёл»
Строка, у которой max_scroll = 0 и time_on_page = 0, — это визит, от которого пришёл только первый бейкон. На живом сайте такие строки почти всегда оставляют не люди, а обходы краулеров и рендереры превью ссылок; живой отскок почти всегда несёт обновление из visibilitychange/pagehide с ненулевым временем. «Почти» — честно: гарантий нет, поэтому фильтр отключаемый.
Из статистики такие строки исключаются по умолчанию, но с тремя оговорками: сколько исключено — написано на карточке (ничего не исчезает молча); галочка возвращает сырую картину; строки остаются в базе. Это display-фильтр, а не правка данных. Применяется он в PHP, а не в WHERE: запросы остаются плоскими литералами, которые принимают sniff’ы Plugin Check, и тот же проход бесплатно считает исключённое.
Можно спросить: почему бы вообще не считать нулевые визиты? Потому что визит без скролла — всё равно визит, и метрика, меняющая определение задним числом, перестаёт сравниваться сама с собой. Процентили по определению описывают всех пришедших.
Часовые пояса
created_at хранится в UTC. Группировка по дням и месяцам делается в PHP через wp_date(): делать её в SQL нельзя без загруженных таблиц часовых поясов, которых на типичном хостинге нет. Даты фильтра дашборда — дни по времени сайта; их границы конвертируются через get_gmt_from_date(), который учитывает и смещение, и переход на летнее время.
Класс устройства
Мобильный/планшет/десктоп вычисляется в браузере: matchMedia('(pointer: coarse)') отделяет тач-указатель от мыши, ширина вьюпорта делит тач на телефон и планшет. Значение вычисляется один раз за визит.
Почему не на сервере: конфигурация «кэшировать всё» заморозит серверное решение в HTML, который потом получат все посетители. Почему не User-Agent: строка заморожена, спуфится и сообщает больше, чем нужно для вопроса. А связка pointer+ширина описывает опыт чтения: окно десктопа, суженное ниже брейкпоинта, честно читается как mobile — раскладка-то мобильная.
Что в итоге
На дашборде Readability: карточки (визиты, средняя, медиана), семь процентилей в обоих режимах, тренд по дням и месяцам, таблица по материалам с поиском и сортировкой по любой колонке процентилей, фильтр по классу устройства, сужающий всю страницу разом. Chart.js лежит в комплекте плагина — админка не делает запросов наружу. Удаление плагина убирает таблицу, опцию версии схемы и транзиенты; деактивация данные не трогает.
Ограничения, о которых стоит знать заранее:
-
visit_uid— это сессия, а не человек: один читатель в двух вкладках будет двумя визитами; -
глубина считается по прокручиваемой высоте документа, а не по доле текста на экране — страница, целиком помещающаяся в один экран, записывается как 100%;
-
процентили не отличают «дочитал» от «быстро промотал до конца»; время на странице стоит рядом, но и оно не доказательство чтения;
-
нейтральное имя эндпоинта снижает шанс блокировки generic-правилами блокировщиков, но не до нуля.
Плагин бесплатный, GPLv2+, в официальном каталоге WordPress.org: AnGo Scroll Analytics. Нужны WordPress 6.8+ и PHP 7.4+.
А как вы измеряете дочитываемость у себя? И чего не хватает в процентильной таблице — от p99 до тепловой карты по абзацам?
ссылка на оригинал статьи https://habr.com/ru/articles/1100670/