Однажды дашборд показал, что багов в одном модуле стало на 65% больше. Объяснение лежало на поверхности: разработчики расслабились, пора закручивать гайки на ревью. Оно было удобным, понятным и неверным. Настоящая причина нашлась в другом месте, и до неё я бы не дошёл, если бы смотрел на эту цифру отдельно от остальных.
Примерно два года я пользуюсь дашбордом метрик, который собрал на досуге сам, и за это время понял простую вещь: почти любая метрика по отдельности может соврать. Не потому что данные плохие, а потому что одна цифра не знает контекста. Ниже расскажу, какие метрики я смотрю, какие пары из них читаю вместе и как за минуту проверить, не обманывает ли вас собственный дашборд. В конце будет небольшой чек-лист.
TL;DR
-
Метрики читаются парами: скорость ревью с размером MR и дефектами, Cycle Time с WIP, «зелёная» доля с числом событий.
-
Слова «Lead Time» и «Cycle Time» в разных источниках означают разное. Пока границы не записаны, цифры несравнимы.
-
Закон Литтла проверяет дашборд на честность за минуту.
-
Метрика по конкретному человеку для меня повод поговорить один на один, а не строчка в рейтинге.
Что у меня за дашборд
Это не продукт и не SaaS, а мой рабочий инструмент. Сначала он собирал данные из Яндекс Трекера, Notion и GitLab, сейчас к нему добавилась джира. Изменения попадают в отдельную базу через CDC (change data capture) и нескольких воркеров, и уже из неё считается всё остальное. Сверху работают скрипты анализа, сам дашборд и ИИ-агент, которому я задаю точечные вопросы вроде «почему поехал этот релиз» и который использует базу как RAG.
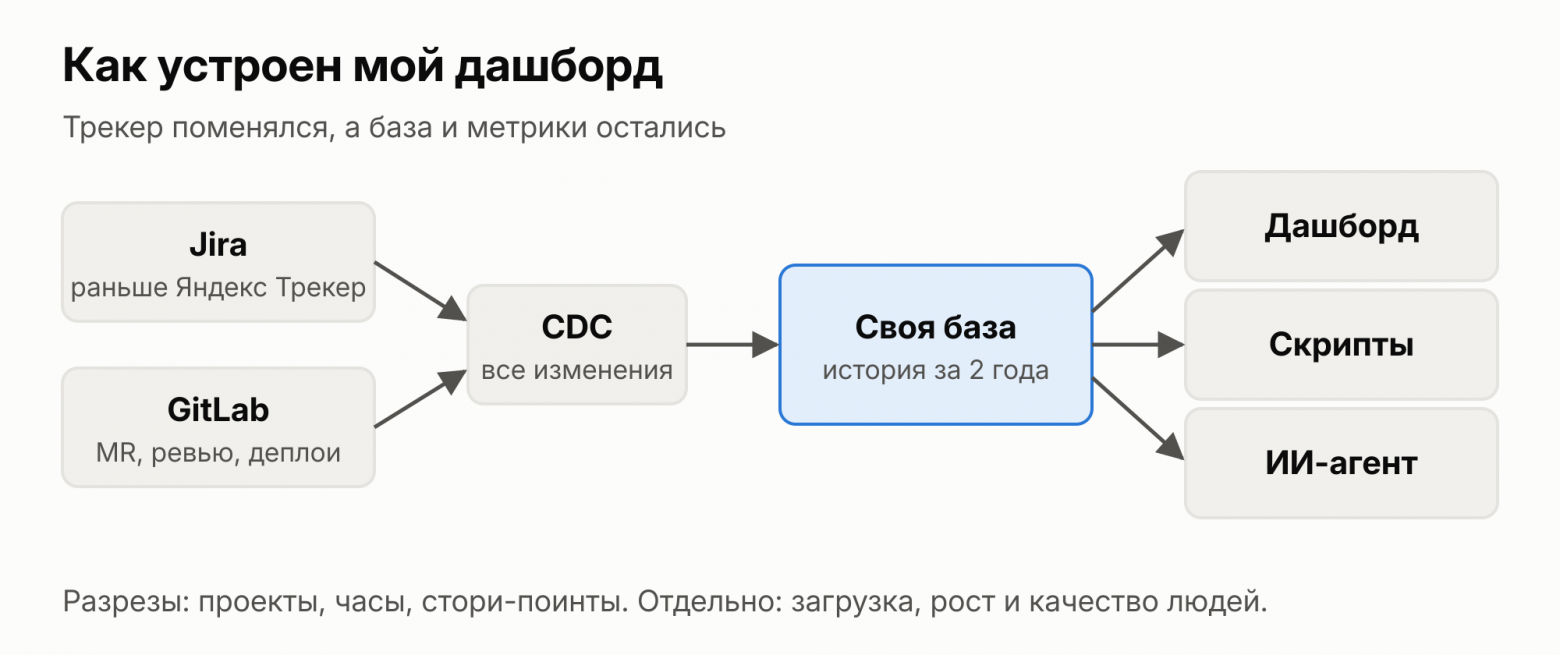
Метрики сгруппированы в четыре блока: планирование и оценки, скорость потока, качество, ревью и релизы. Набор сам по себе обычный, похожие списки есть у Альфы и SimpleOne. Интересное начинается, когда метрики начинают спорить друг с другом.
Сразу оговорка. Все числа в статье, кроме ссылок на исследования, условные. Подход я применял в нескольких компаниях, часть из них под NDA, и не все они есть в моём резюме. Поэтому реальные данные команд я не показываю, а примеры подобраны так, чтобы была видна только общая логика.
Как дашборд соврал мне при переезде
Самый полезный урок случился, когда я переносил дашборд в другую компанию. Код тот же, формулы те же, данные свежие. А метрики начали показывать ерунду.
Причина оказалась банальной. Процессы в новой компании были настроены иначе, и те же формулы считали уже другие отрезки работы. Название статуса совпадало, а смысл нет. Дашборд пришлось адаптировать под процесс. До этого Cycle Time честно показывал число, только это было число про что-то другое.
После этого я перестал верить метрикам, у которых не записаны границы. И выяснилось, что путаница есть не только у меня. В Kanban Guide Cycle Time означает время от начала работы над задачей до её завершения. У DORA есть Change Lead Time, и он считается от коммита до продакшена. Слово «lead» одно, отрезки разные. Теперь у меня так:
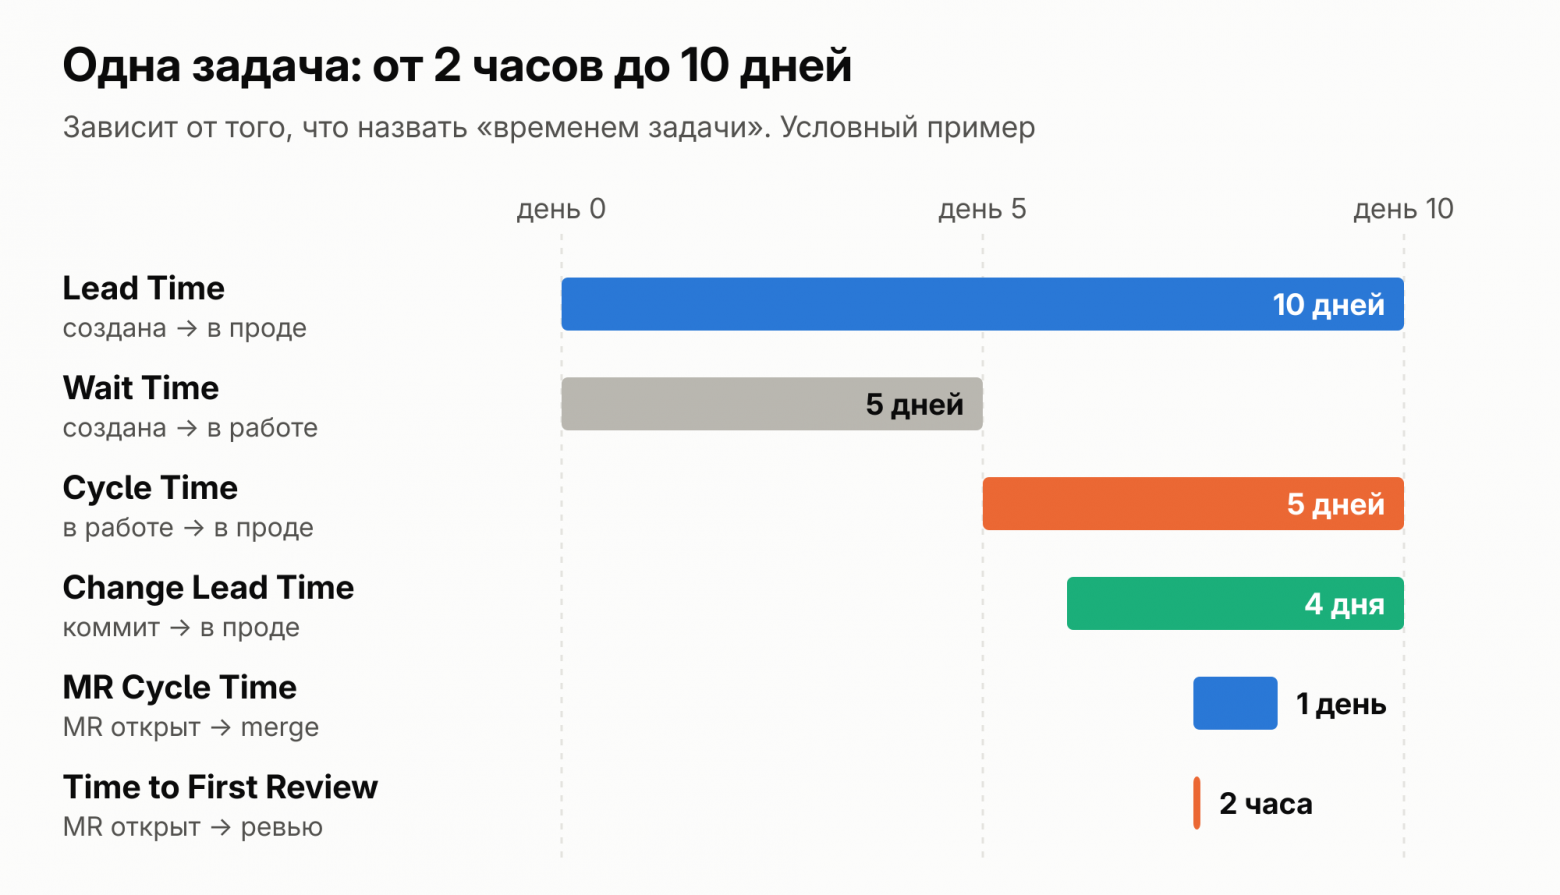
Wait Time это разница между Lead Time и Cycle Time.
Все метрики потока я считаю в календарном времени, а рабочие часы оставил только для точности оценок. Звучит как мелочь, но следующий раздел покажет, во что она обходится.
Тест на враньё за одну минуту
Есть закон Литтла: средний Cycle Time равен среднему WIP (числу задач в работе), делённому на Throughput (пропускную способность, число задач, закрытых за день). Работает он на исторических данных и при стабильном потоке, когда задачи не копятся бесконечно (Vacanti, Scrum.org). Для лида это бесплатный детектор лжи.
Как пример: в работе в среднем 40 задач, за четыре недели закрыто 280.
wip, closed, days = 40, 280, 28throughput = closed / days # 10 задач в деньcycle_days = wip / throughput # 4.0 дняprint(cycle_days * 24) # 96 часов
Литтл говорит: в среднем 96 часов на задачу. А дашборд показывает Cycle Time 32 часа. Кто-то из них врёт, и обычно это не математика.
Я проверяю три вещи. Сначала единицы: 32 рабочих часа и 32 календарных часа это разные сроки. Потом окна: WIP и Throughput должны быть посчитаны за один период. И наконец, что считается «в работе»: если в WIP попала очередь, он ближе к Lead Time, чем к Cycle Time. Почти всегда расхождение находится на одном из этих шагов.
Закон Литтла полезен и для прогноза. Если Throughput стоит на месте, а WIP растёт, каждая задача будет идти дольше. Это не «команда стала медленнее», это арифметика.
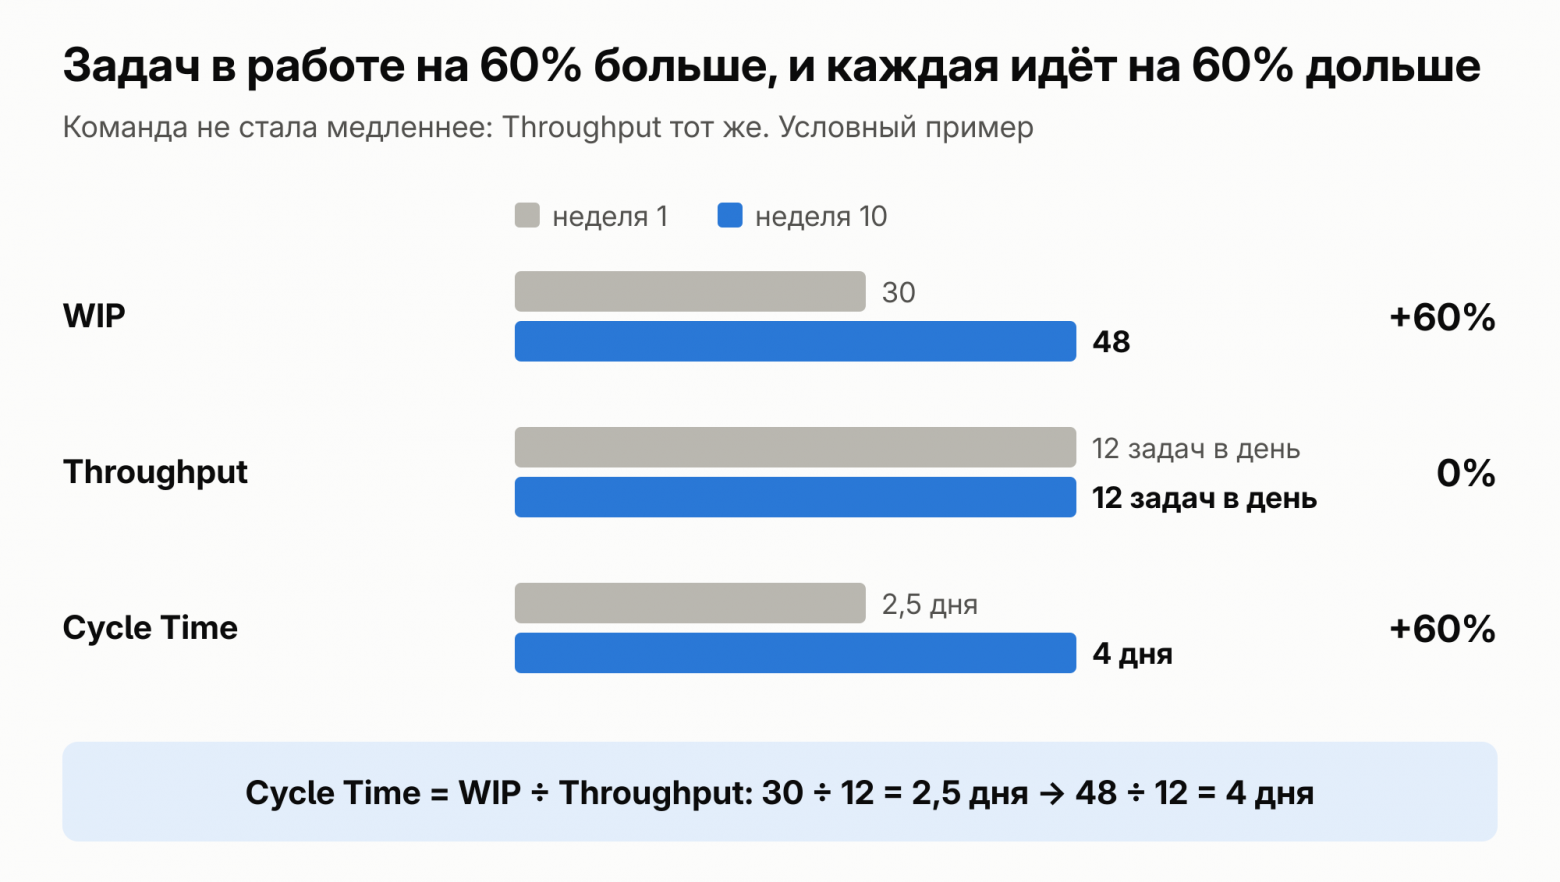
Команда работает с той же скоростью, задачи просто стоят в очереди дольше.
Поэтому рост Cycle Time я никогда не читаю сам по себе. Сначала смотрю на WIP. Если он вырос в полтора раза, лечить надо число одновременных задач, а не скорость людей.
Пары, без которых я не открываю дашборд
Time to First Review, MR Size и Escaped Defects
Быстрое ревью радует глаз. Но представьте график, где время до первого ревью за квартал упало с шести часов до 36 минут. Хочется похвалить команду. А теперь положите рядом размер MRа в строках и дефекты, найденные после релиза.
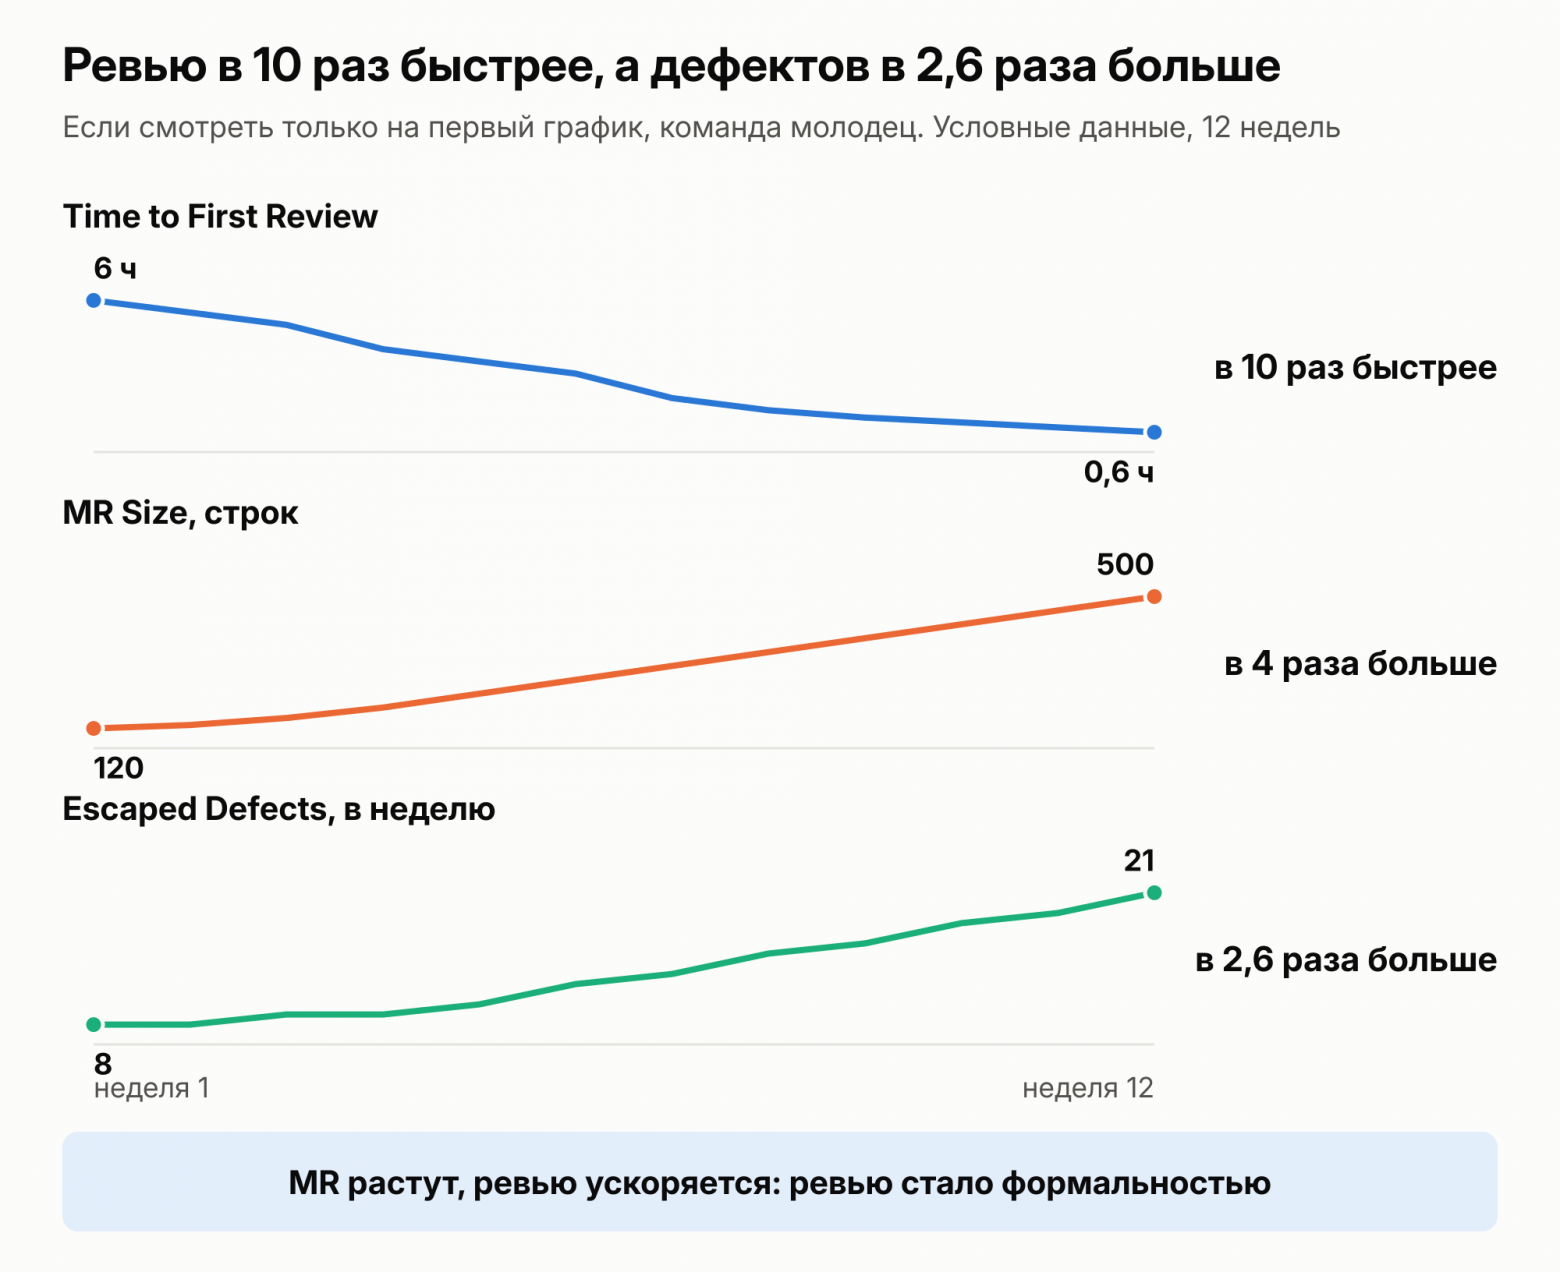
Верхний график без двух нижних выглядит как успех.
Если колличество MR’ов растёт, а ревью ускоряется, ревью почти наверняка превратилось в формальность. Это подтверждают и исследования. Kemerer и Paulk на данных 371 и 246 учебных программ показали: при скорости ревью до 200 строк в час находится больше половины дефектов в коде, медленнее лучше уже не становится, а быстрее эффективность падает (IEEE TSE, 2009). MR на 500 строк, одобренный за десять минут, это не скорость, а пропуск. И учитывая реалии слопа который нас сейчас окружает, в репозиторий могут попасть очень интересные вещи.
При этом быстрое ревью само по себе не зло. В Google медиана ожидания первой реакции меньше часа для маленьких изменений, а медианное изменение всего 24 строки(с оговоркой, что это было до бума нейросетей) (Sadowski и др., 2018). Быстро там потому, что изменения маленькие. DORA в отчёте 2023 года связывает быстрое ревью с более высокой производительностью поставки, но предупреждает: если ревью уже быстрое, ускорять его бессмысленно (DORA 2023).
Зелёная метрика и число событий
За месяц 12 деплоев, ни один не откатили, Change Failure Rate 0%. Отличный результат? На самом деле 0 из 12 почти ничего не доказывает. Один неудачный деплой в следующем месяце даст 8%, и команда при этом не станет хуже.
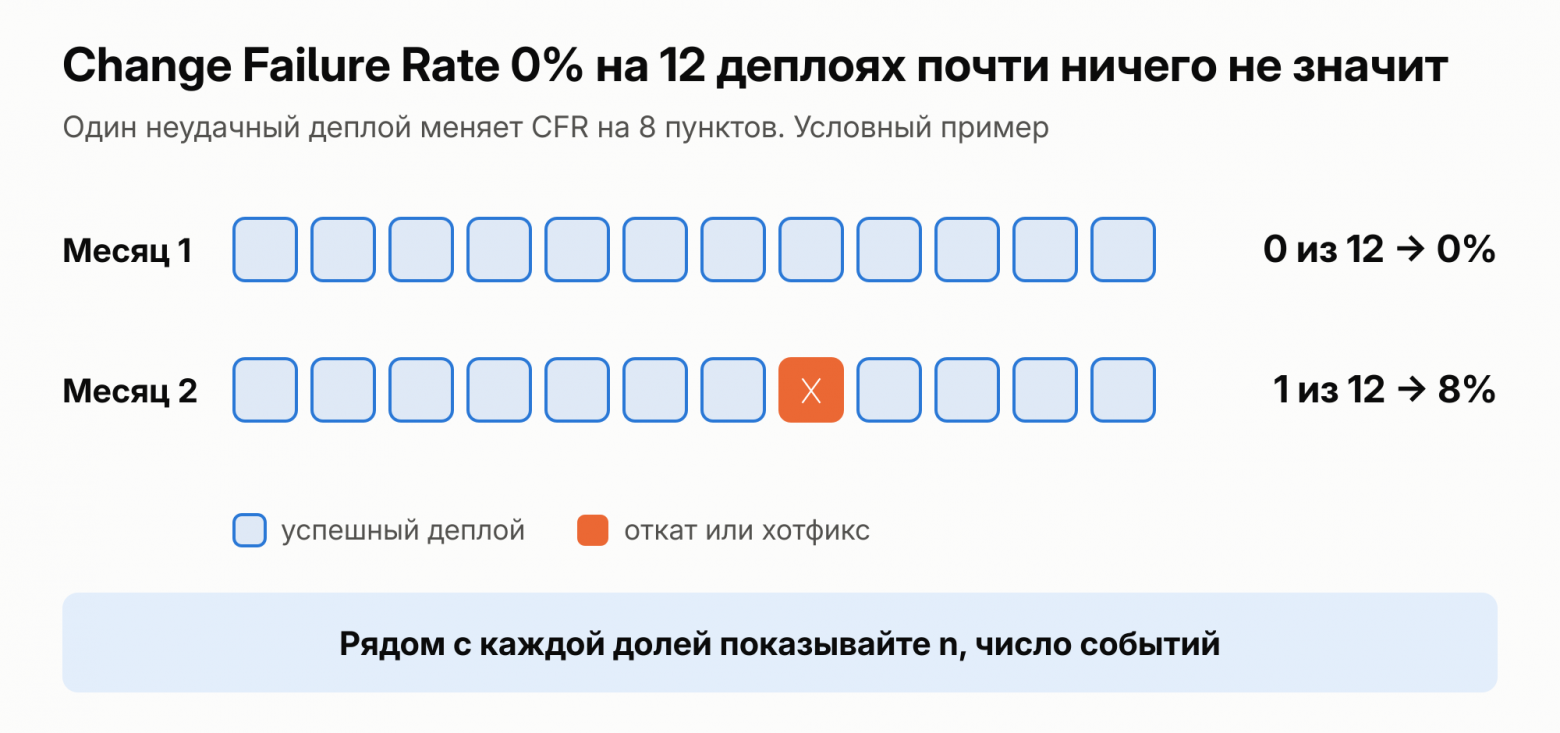
С MTTR ещё смешнее: нет инцидентов, нет и метрики. Поэтому у меня рядом с каждой долей стоит n, число событий, а метрики с маленькой выборкой помечены «мало данных». Скучно, зато спасает от радости по пустому месту.
Возвраты задач и дефекты
Процент переоткрытых задач низкий, и это выглядит как качество. Но если найденный баг заводят новой задачей, а не возвращают старую, reopen его просто не видит. Низкий reopen при большом числе дефектов значит одно: баги обходят этот счётчик стороной.
Точность оценок и сроки
Команда может точно оценить задачу в восемь часов или 3sp и сдать её через неделю. Потому что три дня она ждала в очереди, а ещё два лежала на ревью. Хорошие оценки при плохих сроках означают проблему в потоке, а не в оценках. Для калибровки ожиданий: по обзору опросов, в 60–80% проектов есть перерасход трудозатрат или сроков, в среднем на 30–40% (Moløkken, Jørgensen, 2003).
Перегруженный релиз видно заранее
Самая практичная пара для лида: ёмкость команды и план релиза. Ёмкость считается из людей и их капасити, план из оценённых задач. Когда запланировано больше, чем есть, или один человек загружен вдвое, это видно до старта релиза, а не на ретро после него. У меня такие случаи были, и перегрузку было видно по дашборду заранее.
Есть подвох: задачи без оценки в оценку не попадают. Значит, реальная загрузка выше той, что на экране. Поэтому рядом с загрузкой я всегда вывожу число неоценённых задач.
Метрика человека это повод поговорить
На дашборде есть разрез по каждому разработчику. Это самая спорная его часть, и я понимаю почему. DORA прямо предупреждает: метрики работают на уровне команды или сервиса, а когда их превращают в цели, начинается подгонка (DORA). Люди быстро учатся дробить задачи, брать простые и откладывать сложные. Метрика растёт, работа нет.
Поэтому людей по этим цифрам я не сравниваю. Для меня это сигнал. Упала выработка или выросло число багов, значит, пора поговорить один на один и спросить, что беспокоит. По моему опыту, падение выработки часто связано не с работой, а с тем, что происходит у человека вне её. Это мнение, а не исследование. Но обычный разговор 2х людей всегда показывает намного больше, чем любой график.
Чем закончилась история с модулем
Вернёмся к 65% багов. Ситуация с которой мне кажется сталкивались на деле все и во всех командах. Гайки на ревью я закручивать не стал. Оказалось, что задачи по модулю приходили сырыми. ПМ торопил команду под дедлайн, который изначально спланировали плохо, и требования прорабатывались наспех. Код ревьюили, но ревью не лечит плохую постановку.
Лечили вход. Стали прорабатывать требования вместе с аналитиками и ПМ до того, как задача попадает в работу. И сознательно замедлили разработку, чтобы фичи успевали продумать до кода. Условно это выглядело так: через два месяца багов в модуле стало примерно на 40% меньше, а средний срок задач по модулю вырос примерно на 15%. Меня такой обмен устроил.
Вывод для меня простой. Багогенность модуля это метрика не только разработки. Часто она показывает проблемы планирования, и разговаривать по ней нужно не только с разработчиками.
Какие были изменения
Если коротко, то такой дашборд корпората помог уменьшить число багов и перегрузку людей, ускорить исправление продовых багов, сократить time-to-market и поднять Throughput. Реальные данные под NDA, поэтому ниже условный порядок изменений за год в одной из команд:
|
Метрика |
Было |
Стало |
|---|---|---|
|
Defect Rate (доля задач с найденными дефектами) |
43% |
18% |
|
Людей с загрузкой выше ёмкости в релизе |
8 из 15 |
2 из 15 |
|
Медиана исправления продового бага |
3+ дня |
<1 день |
|
Lead Time (от создания задачи до прода) |
14 дней |
7 дней |
|
Throughput (задач в неделю) |
32 |
115 |
Числа в таблице иллюстративные и показывают направление изменений, а не результат конкретной команды.
Где я могу ошибаться
Исследования, на которые я опираюсь, не окончательные. McIntosh и коллеги нашли связь между покрытием ревью и дефектами после релиза, но повторный анализ не смог её подтвердить. Kemerer и Paulk работали с учебными данными PSP, а не с командным ревью в GitLab. Отчёты DORA построены на опросах и показывают связь, а не причину.
Популярная цифра «эффективность потока у большинства команд 5–15%» взята из опыта консультантов, а не из исследования. Есть хорошая критика на данных 63 команд, поэтому такие ориентиры я не превращаю в цели. Самое главное, что в командах мы всегда ведь хотим делать крутые штуки, а данная история показывает как мы используя один из инструментов можем сделать жизнь всех немного лучше.
И главное: мои выводы получены в моих командах и с моим опытом, и моими определениями которые дают повторяемый результат.
Чек-лист: проверьте свой дашборд за десять минут
-
Для Lead Time, Cycle Time и Change Lead Time записано, от какого статуса до какого идёт отсчёт.
-
Все метрики потока в одних единицах, без смешения рабочих и календарных часов.
-
Закон Литтла сходится: WIP, делённый на Throughput, примерно равен среднему Cycle Time.
-
Рядом с каждой долей видно число событий, маленькие выборки помечены.
-
Time to First Review показан вместе с MR Size и Escaped Defects.
-
Доля переоткрытий сверяется с общим числом дефектов.
-
Загрузка релиза показана вместе с числом неоценённых задач.
-
Индивидуальные метрики используются для разговоров, а не для рейтингов.
Если три пункта из восьми не выполнены, дашборд скорее успокаивает, чем помогает. Метрики стоит читать как систему, где одна цифра объясняет другую. Табло с зелёными лампочками приятно, но правды на нём меньше, чем кажется.
ссылка на оригинал статьи https://habr.com/ru/articles/1101014/