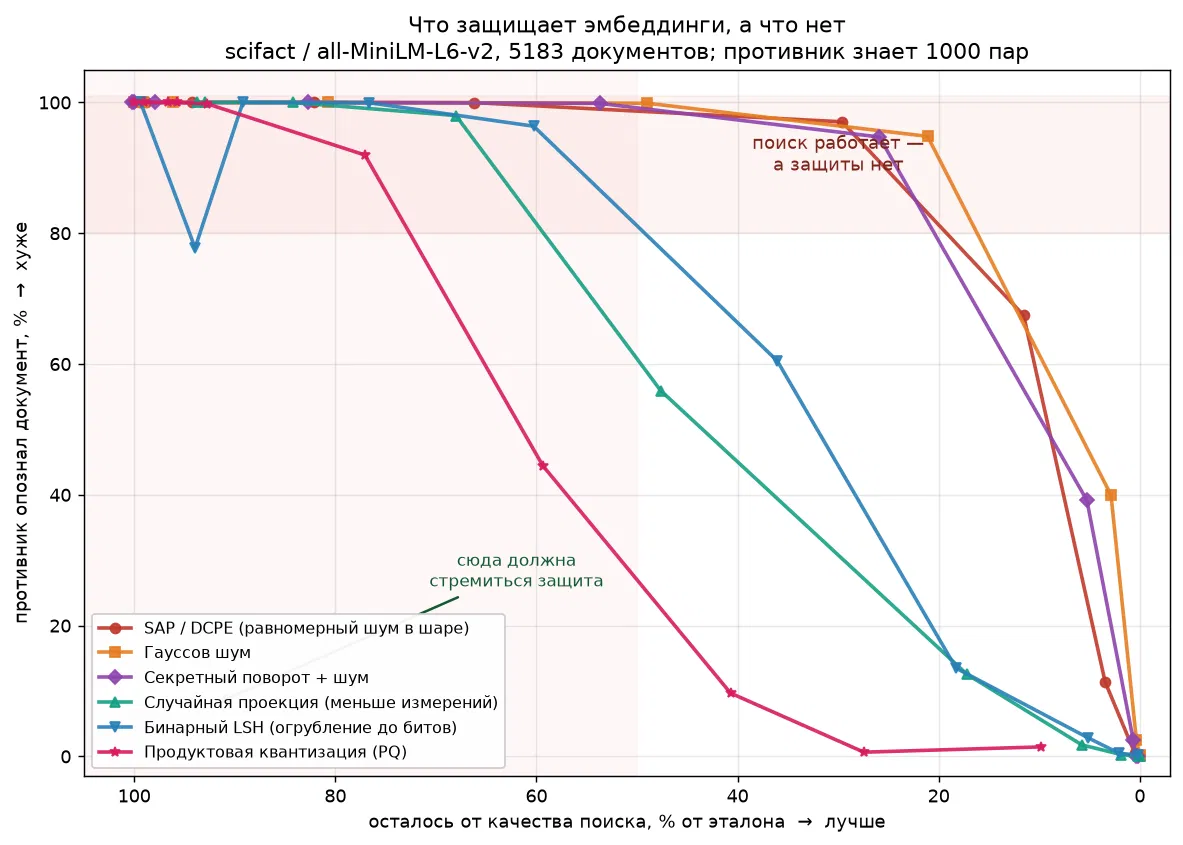
Коротко. Если хранить эмбеддинги с добавленным шумом, текст по ним восстановить трудно, но это не значит, что данные защищены. Я измерил, можно ли по защищённой записи узнать, какому документу она принадлежит, если атакующий знает часть соответствий (для основного сравнения 1000 из 5183 документов, ~19%). Для шума узнаётся 99% записей, даже когда качество поиска упало вдвое. При 100 известных парах (2% корпуса) узнаётся около 90%.
С чего всё началось
Векторные базы для RAG и поиска хранят эмбеддинги документов. Если утекла такая база, возникает вопрос: что можно узнать по векторам? Есть работа про vec2text (Understanding and Mitigating the Threat of Vec2Text to Dense Retrieval Systems), где показали: из эмбеддинга можно восстановить текст. Её авторы предложили защиты: добавить шум, сжать векторы (product quantization) или применить секретное линейное преобразование. По их данным, шум сводит точное восстановление текста к 0%, а качество поиска почти не страдает (0,748 → 0,730 по top-10).
Но восстановить текст и узнать, какому из известных документов принадлежит запись, это разные задачи. Защита может пройти первую проверку и полностью провалить вторую. Для публичных или частично утёкших корпусов (документация, научные статьи, ранее утёкшие базы) вторая задача реальна: атакующему нужны не неизвестные тексты, а сопоставление записи с текстами, которые он уже знает.
Я написал стенд, который не оценивает цену защиты, а запускает атаку и смотрит, что она реально предотвращает.
Как проверял
-
8 схем: гауссов шум, шум после секретного поворота, SAP/DCPE (шум, равномерный в шаре), бинарный LSH, случайная проекция, product quantization (PQ), секретная нелинейность, k-анонимное квантование.
-
Две коллекции BEIR (SciFact, 5183 документа; NFCorpus, 3633) и две модели эмбеддингов (all-MiniLM-L6-v2, bge-small-en-v1.5). Всё на английском.
-
Для каждой схемы менял силу защиты и на каждом шаге смотрел две вещи: сколько качества поиска осталось и может ли атакующий понять, какому документу принадлежит каждая защищённая запись.
-
SAP/DCPE я реализовал сам по алгоритму 2 из статьи Fuchsbauer, Ghosal, Hauke, O’Neill (SCN 2022). Проверялась научная схема, а не какой-либо коммерческий продукт.
-
Самопроверки: при нулевой силе защиты качество, соседи, кластеры и узнаваемость должны быть ровно 100%, иначе замер прерывается. Эти проверки поймали две реальные ошибки: k-means менял разбиение при масштабировании, а 2,2% NFCorpus оказались дубликатами, которые по построению неразличимы (я исключил их из подсчёта).
Условия замера: коллекция SciFact (5183 документа), модель all-MiniLM-L6-v2, атакующий знает 1000 пар «документ — защищённая запись» и подбирает линейное отображение обратно в пространство эмбеддингов.
Результат 1. Шум, который побеждает восстановление текста, не побеждает узнавание
Доля узнанных записей в точке, где качество поиска упало вдвое:
|
Схема |
Узнано |
|---|---|
|
Гауссов шум |
99,9% |
|
Секретный поворот + шум |
99,2% |
|
SAP / DCPE |
98,7% |
|
Бинарный LSH |
81,1% |
|
Случайная проекция |
60,8% |
|
Product quantization |
27,0% |
|
Секретная нелинейность |
100% при всех настройках |
|
k-анонимное квантование |
меньше 1%, но до 50% качества не доходит |
Порядок схем одинаков на всех четырёх сочетаниях «коллекция × модель», абсолютные числа плавают. Вид шума ничего не меняет: равномерный в шаре (как задуто в DCPE), обычный гауссов и гауссов после поворота дают почти одинаковые кривые.
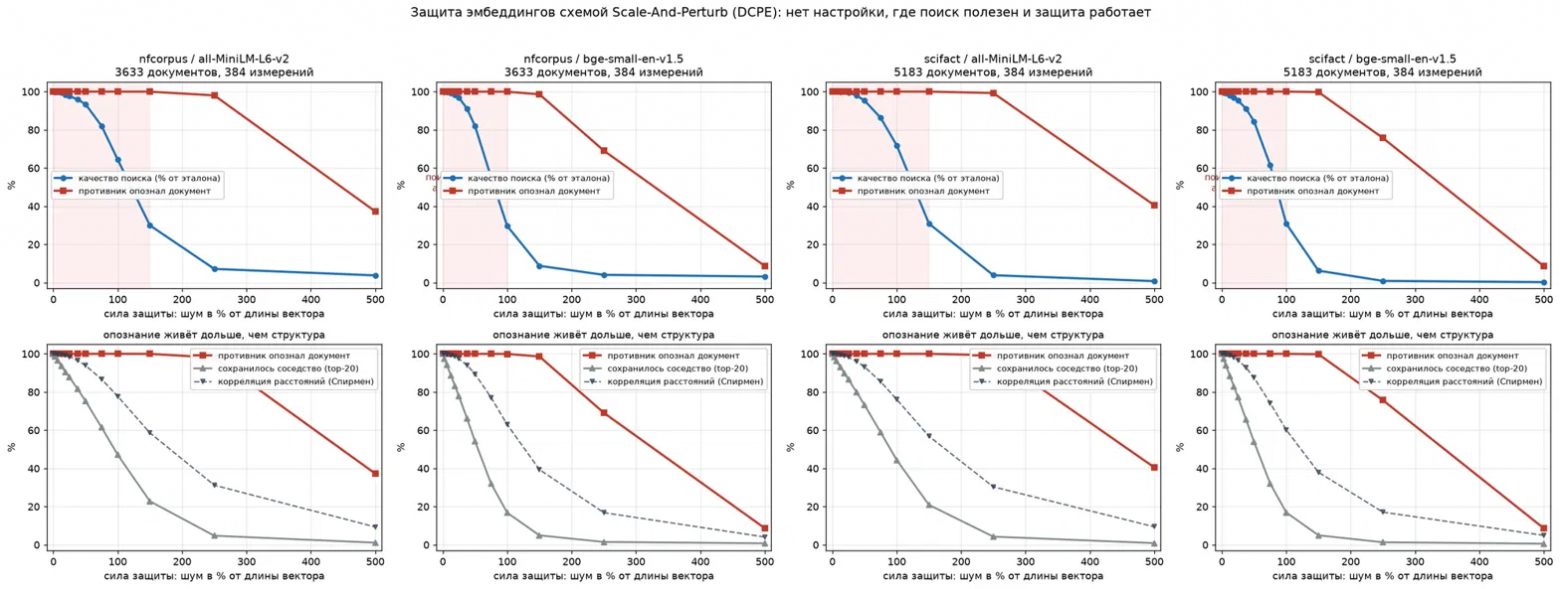
Вывод: если подбирать шум по метрикам восстановления текста, в таблице оценки будут нули, а узнаваемость при этом будет 99%.
Результат 2. Секретное преобразование не спасает, если у атакующего есть пара сотен известных пар
Секретный поворот полностью побеждает наивную атаку: сопоставление по косинусу с публичным корпусом падает со 100% до 0,0%. Но атака с линейным выравниванием (метод наименьших квадратов) по-прежнему даёт 100%.
Чтобы найти, где ломается моя линейная атака, я добавил секретную нелинейность tanh(gain · Qv). Она не сломалась: узнаваемость 100% на всём диапазоне параметра gain (разброс в 2000 раз, от почти линейной до насыщенной), а качество поиска не падало ниже 90%. Нелинейность одинаково бесплатна и для защитника, и для атакующего.
Сколько нужно знать атакующему. Ему нужно около 100–200 известных пар «документ — защищённая запись» из 5183, то есть 2–4% корпуса. Доля узнанных записей при настройке, оставляющей ~80% качества:
|
Известных пар |
% корпуса |
SAP |
Гауссов |
Поворот |
Проекция |
LSH |
PQ |
|---|---|---|---|---|---|---|---|
|
25 |
0,5% |
2% |
2% |
2% |
1% |
1% |
0% |
|
50 |
1% |
38% |
34% |
34% |
22% |
15% |
8% |
|
100 |
2% |
91% |
89% |
88% |
72% |
61% |
37% |
|
200 |
4% |
100% |
98% |
98% |
96% |
92% |
67% |
|
1600 |
31% |
100% |
100% |
100% |
100% |
100% |
91% |
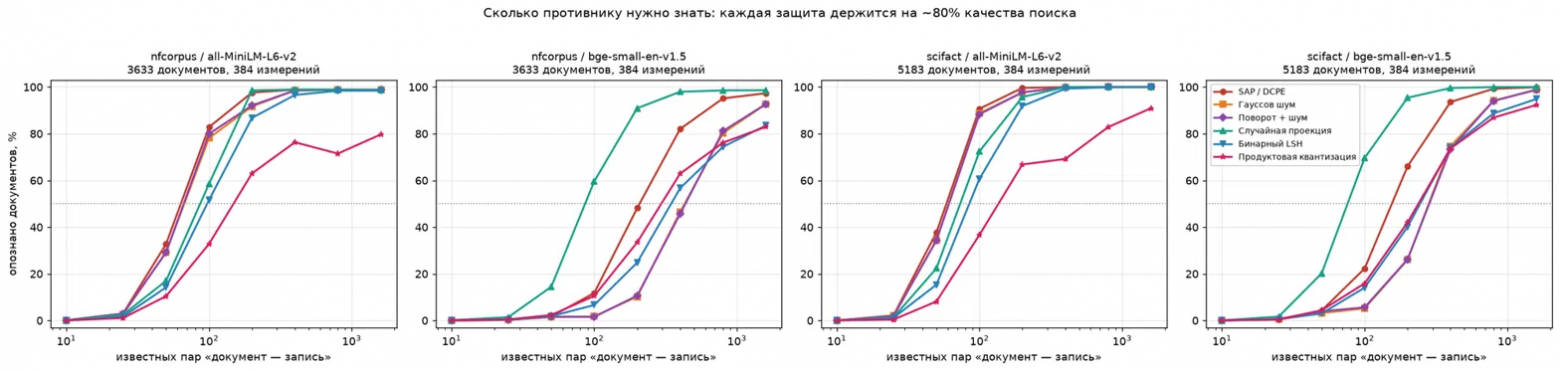
Это важно, потому что секретное линейное преобразование, зависящее от пользователя, как раз то, что предлагает работа про vec2text. Против атакующего с ~100 известными парами оно не даёт защиты от узнавания вообще.
Результат 3. Помогает только потеря информации, и PQ здесь лучший, но не бесплатный
Проекция, LSH и PQ двигают кривую, потому что выбрасывают информацию, а не добавляют шум. PQ даёт 27,0% узнаваемости при половине качества против 60,8% у проекции и ~99% у шумовых схем.
Но настройка решает. В работе про vec2text PQ «полностью защищает» от восстановления без потери качества (0,748 → 0,749). Это режимы высокой точности, и в них узнаваемость почти полная:
|
Подвекторов |
Байт на вектор |
Осталось качества |
Узнано |
|---|---|---|---|
|
192 |
192 |
100% |
100% |
|
48 |
48 |
96% |
100% |
|
32 |
32 |
93% |
99,8% |
|
16 |
16 |
77% |
92,0% |
|
8 |
8 |
59% |
44,5% |
|
4 |
4 |
41% |
9,7% |
Чтобы опустить узнаваемость ниже 50%, нужно сжать до ~8 байт на вектор и потерять около 41% качества поиска. Возможно, такая цена подходит. Но это цена, а не бесплатный обед.
Ещё одно предостережение: защита PQ зависит от корпуса. При тех же 50% качества узнаваемость составила 27,0% и 25,4% на SciFact, но 1,6% и 1,7% на NFCorpus, разброс в 17 раз. Моё объяснение: NFCorpus тематически однороден (питание и медицина), грубое квантование склеивает похожие документы в одинаковые коды, и различать их уже нечем. Если это так, защита PQ получается побочным эффектом однородности корпуса, а не свойством схемы. Меряйте на своём корпусе.
Результат 4. Доказуемая граница возможна, но моя реализация хуже обычного PQ
Всё выше эмпирика: число, которое умная атака может сдвинуть. Я захотел границу, которую сдвинуть нельзя, и построил k-анонимное квантование: документы намеренно собираются в группы не меньше k, и хранится один общий вектор на группу. Если у k документов запись побайтно одинакова, никакая атака их не разделит, узнаваемость не выше mean(1/размер группы) ≤ 1/k до всякого запуска.
Граница выполняется: при k=2 граница 29,8%, измерено 8,3%; при k=3 граница 16,5%, измерено 0,5%. Но моя конструкция проигрывает PQ:
|
|
Осталось качества |
Узнано |
|---|---|---|
|
k-анонимность, k=2 |
34% |
8,3% |
|
PQ, m=4 |
41% |
9,7% |
Причина в том, что я собирал группы через k-means с последующим слиянием мелких, и размеры получились перекошены (минимум 2, медиана 3, среднее 6,2, длинный хвост). Граница задаётся самой маленькой группой, а цена по качеству берётся со средней, поэтому крупный хвост тратит качество и ничего не покупает. Будет ли лучше честное сбалансированное назначение, я не проверял и не утверждаю.
Что здесь не измерено
Это важнее всего. Мой стенд проверяет узнавание: по защищённой выгрузке и набору известных текстов можно ли сказать, какая запись какому документу принадлежит. Он не проверяет, можно ли восстановить текст неизвестного документа. Это разные утверждения, и вторым чаще торгуют производители защит.
-
Атаке нужны тексты-кандидаты. Это реалистично для публичных или частично утёкших корпусов (RAG по открытой документации, научные статьи, ранее утёкшие базы) и нереалистично для корпуса, к которому у атакующего нет доступа вообще.
-
Все 8 схем геометрические: на сервере лежит что-то, пространственно связанное с исходным вектором. Поэтому атака работает: где есть геометрия, есть отображение назад, и я его подбираю. Схемы вне геометрии (гомоморфное шифрование, PIR, многосторонние вычисления, ORAM) мой стенд атаковать не может, и пустой результат против них ничего бы не значил. «Восемь защит провалились» не значит «ничего не работает». Работающее дорогое и вне этой работы.
-
Две коллекции, две модели, всё на английском, по меркам продакшена мало.
-
Только «снимок»: одна выгрузка. Без наблюдения за запросами и активного воздействия.
-
Линейная атака даёт нижнюю оценку возможностей атакующего: более сильная сделала бы числа хуже. Но секретное преобразование, разработанное специально против выравнивания, возможно, прошло бы.
-
Восстановление текста целиком (GTR-base + vec2text) я пробовал, но эксперимент неубедительный: потолок на чистых эмбеддингах получился 45,9% по token-F1 и 0% точных совпадений при 92% в статье про vec2text, так что различать условия было нечем. Причины, которые я нашёл: обрезка до 32 слов вместо 32 токенов, выключенный beam search и инвертор, обученный на Natural Questions, а не на научных аннотациях. Пока это не переделано, считайте восстановление текста по восстановленным векторам открытым вопросом, а не результатом.
Что из этого следует
-
Не оценивайте защиту эмбеддингов только по восстановлению текста. Проверяйте узнавание на корпусе, похожем на ваш.
-
Секретное преобразование без остального не защита, если у атакующего может оказаться несколько сотен известных пар.
-
Если защита нужна, платите качеством поиска: quantization даёт реальный эффект, но на высоких настройках его нет, и результат зависит от корпуса.
-
Данные, которые нельзя отдавать, проще не отдавать вовсе: держать модель и базу у себя.
Побочное наблюдение. Более сильная модель оказалась хрупче: bge-small-en-v1.5 (nDCG@10 = 72,0 на SciFact) теряет половину качества при 100% относительного шума, а более слабая all-MiniLM-L6-v2 (64,5) доживает до 150%. Узнаваемость от этого не зависит. Преимущество хорошей модели в тонких различиях, шум стирает их первыми, а узнавание грубая задача.
Как повторить. Всё считается на обычном процессоре, без видеокарты, самый долгий шаг, векторизация коллекций, около 5 минут на коллекцию на двух ядрах. Код и результаты: github.com/makltd123/semantic-cryptography. Если у вас получились другие числа, пришлите: для этого стенд и написан.
ссылка на оригинал статьи https://habr.com/ru/articles/1101548/