Интернет-магазину нужен отчёт по заказам в разрезе клиентских сегментов. Заказы лежат в системе продаж, сведения о клиентах — в CRM. Вы соединяете таблицы. Запрос выполняется, но сумма заказов оказывается выше исходной. Откуда разница? Можно ли соединять клиентов по одинаковым номерам? Что делать с неизвестным статусом?
Привет, Хабр!
Мы — Karpov Courses, онлайн-школа, где учат аналитике, программированию и работе с данными. Разберём маппинг на учебном примере: пройдём путь от сбора источников до спецификации, SQL-запроса и проверки результата.
Что такое маппинг данных простыми словами
Маппинг данных (англ. data mapping) — это определение того, какие данные из исходной системы попадут в каждое поле итоговой таблицы и как их нужно преобразовать. Например, номер заказа переносим без изменений, сумму переводим из копеек в рубли, а код статуса P заменяем на «Оплачен».
|
Источник |
Целевое поле |
Правило |
|
order_id |
Перенести без изменения |
|
|
orders.total_kopecks |
amount_rub |
Разделить на 100 с сохранением копеек |
|
orders.status_code |
order_status |
Найти значение в справочнике |
Чтобы предметно разобраться, что такое мэппинг данных, надо выяснить: откуда берётся значение, куда попадёт и как изменится.
Почему сопоставить названия полей недостаточно
В двух системах может быть поле amount, но в одной это стоимость заказа, а в другой — отдельный платёж. Если покупатель платил частями, одному заказу соответствуют несколько платежей.
Или client_id и customer_id обозначают клиента, но присваиваются независимо. Клиент № 42 в магазине не обязательно является клиентом № 42 в CRM. Поэтому сопоставление учитывает смысл, тип, единицы измерения и связи данных. Похожее название не доказывает, что поля можно объединить.
Как связаны маппинг, преобразование данных и ETL/ELT
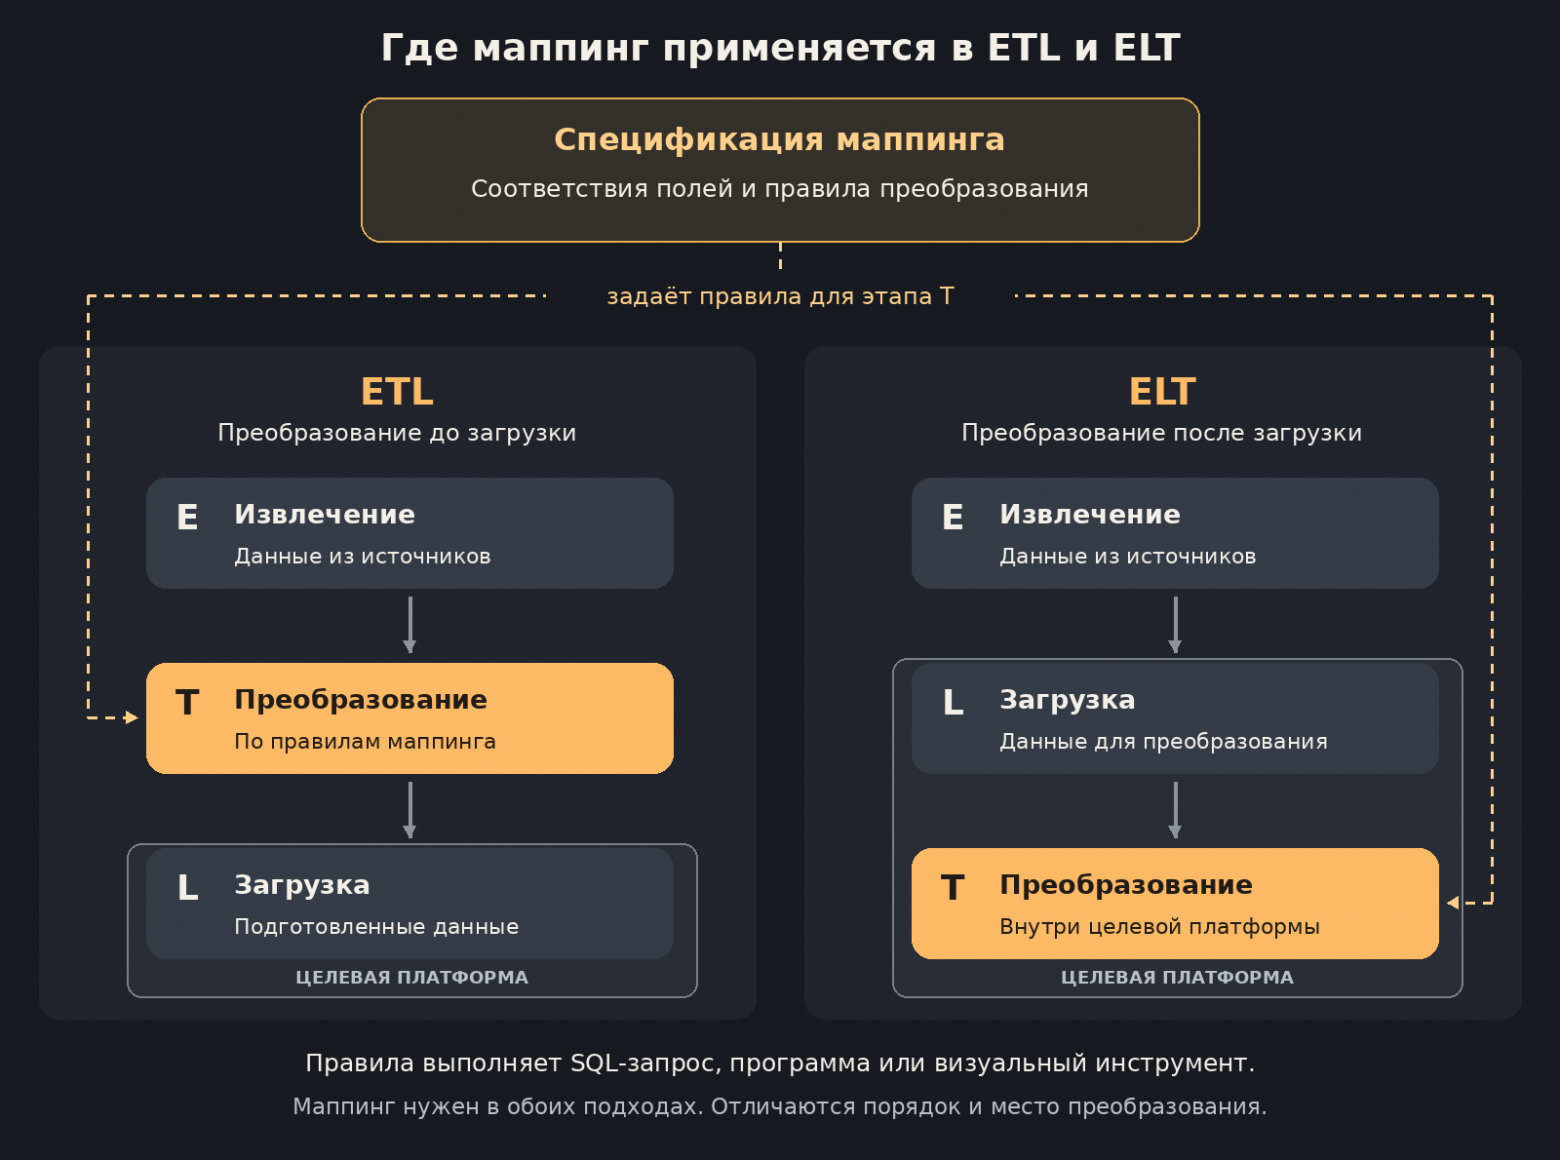
Спецификация маппинга фиксирует правила, а SQL-запрос, программа или визуальный инструмент применяет их к данным. ETL охватывает извлечение, преобразование и загрузку. В ELT данные сначала загружают в целевую платформу, затем преобразуют внутри неё.
Что такое маппинг в программировании
В разработке сопоставление помогает переносить данные между разными представлениями одного объекта. Например, в ответе API имя пользователя записано под ключом first_name, а в коде приложения для него предусмотрено свойство firstName. Правило маппинга указывает, куда поместить полученное значение. Для таких задач используют, например, AutoMapper в .NET и MapStruct в Java.
При подготовке данных для аналитики нужно также разобраться, что означают поля в каждом источнике, как связаны записи и чему должна соответствовать одна строка итоговой таблицы.
Где применяется маппинг данных
Данные из разных систем редко можно объединить без подготовки. Разберём три сценария, в которых нужно согласовать их структуру и содержание.
Миграция из одной системы в другую
Компания меняет CRM. В старой системе имя хранится одной строкой, в новой предусмотрены отдельные поля. Отличаются статусы сделок и идентификаторы клиентов. До переноса определяют, какие значения куда попадут и какие записи потребуют ручного разбора. Например, разделение полного имени по пробелам не гарантирует правильного выделения имени и фамилии.
Объединение источников для отчётов и витрин
Заказы находятся в одной базе, сегменты клиентов — в CRM. Для отчёта нужно согласовать ключи, справочники и детализацию. На выходе может получиться витрина — подготовленный набор данных для определённых аналитических задач. Маппинг объясняет, как её поля связаны с источниками.
Подготовка данных для машинного обучения
К клиентам добавляют историю покупок для прогноза повторного заказа. Нужно связать идентификаторы и согласовать категории. Дополнительно проверяют, какие сведения были доступны на момент прогноза: покупки из будущего не должны попасть в признаки для прошлого.
Как выполнить маппинг данных: пошаговый разбор
Возьмём две небольшие таблицы и подготовим данные для отчёта. На каждом шаге будем фиксировать решения: какие записи связываем, что преобразуем и как поступаем с неизвестными значениями.
Шаг 1. Определить задачу и структуру результата
Магазину нужна таблица с суммами, статусами заказов и текущими сегментами клиентов из CRM.
Договоримся: одна строка результата соответствует одному заказу. Это гранулярность данных. У клиента может быть несколько заказов, но один заказ не должен повторяться.
Целевая структура включает номер заказа, клиента, сегмент, сумму и статус. Добавим признаки отсутствующих соответствий. Имена и телефоны для задачи не нужны.
Сумма заказа — стоимость после скидок. Возвраты не моделируем. Для отчёта по выручке нужны отдельные правила и данные.
Шаг 2. Изучить источники и проверить качество данных
Определяем содержание, владельца и актуальность каждого источника. Работаем с согласованными снимками. При регулярной загрузке нужно учитывать задержки: заказ может появиться раньше клиента в CRM.
В системе продаж есть таблица orders:
|
id |
client_id |
total_kopecks |
status_code |
|
101 |
A7 |
125000 |
P |
|
102 |
B4 |
80000 |
C |
|
103 |
A7 |
250000 |
P |
|
104 |
X9 |
60000 |
H |
По документации системы P означает оплаченный заказ, C — отменённый. Код H пока не описан: его значение нужно уточнить у владельца источника.
В таблице crm_customers есть идентификатор клиента магазина — shop_client_id:
|
customer_id |
shop_client_id |
segment |
|
501 |
A7 |
retail |
|
502 |
B4 |
business |
Проверяем содержимое — проводим профилирование.
-
Уникальны ли номера заказов?
-
Есть ли пропуски?
-
Какие статусы встречаются?
-
Повторяется ли shop_client_id в CRM?
В наших данных четыре заказа, три разных клиентских идентификатора и три статуса. Для X9 клиента в CRM нет. Сумма total_kopecks равна 515000, то есть 5150 ₽. Эти наблюдения станут исходными условиями для проверок.
Уникальность ключа CRM можно проверить запросом:
SELECT shop_client_id, COUNT(*) AS row_countFROM crm_customersGROUP BY shop_client_idHAVING COUNT(*) > 1;
Если запрос вернул строки, выясняем причину: это дубли или, например, история изменений? Если удалить повторяющиеся записи, не выяснив причину их появления, можно потерять нужные данные.
Шаг 3. Согласовать ключи и правила преобразования
Связываем orders.client_id с crm_customers.shop_client_id. Справа ожидаем не более одной записи на клиента. Ключи проверяем до соединения.
Затем согласуем правила с владельцами данных:
-
Все четыре заказа сохраняем, включая отменённый: отбор для конкретного показателя будет отдельным действием.
-
Сумму переводим из копеек в рубли, сохраняя два знака после запятой.
-
Статусы P и C преобразуем в paid и cancelled.
-
Неизвестный статус обозначаем как unknown и сохраняем исходный код для разбора.
-
Если клиента нет в CRM, оставляем customer_id и segment пустыми и выставляем признак отсутствия соответствия.
Заказ № 104 остаётся виден. Пока H не расшифрован, показатели по статусам нужно сопровождать информацией об исключении.
Сегмент берём текущий. При его смене группировка старых заказов изменится. Если нужен сегмент на дату заказа, потребуется история и другое правило соединения.
Шаг 4. Составить спецификацию маппинга
Перед написанием кода правила сопоставления и преобразования данных описывают в спецификации (mapping specification). Для небольшой задачи подойдёт таблица:
|
Целевое поле и тип |
Источник |
Правило и обработка исключений |
|
order_id, целое |
Перенести; значение обязательно и уникально |
|
|
customer_id, целое |
crm_customers.customer_id |
Найти по клиентскому ключу; без соответствия — NULL |
|
segment, строка |
crm_customers.segment |
Перенести из найденной карточки; без соответствия — NULL |
|
amount_rub, decimal(12,2) |
orders.total_kopecks |
Разделить на 100; пропуск не заменять нулём |
|
source_status_code, строка |
orders.status_code |
Сохранить исходный код |
|
order_status, строка |
orders.status_code |
P → paid, C → cancelled, остальное → unknown |
|
customer_matched, целое |
Результат соединения |
1, если клиент найден; иначе 0 |
|
status_mapped, целое |
orders.status_code |
1 для известных кодов P и C; иначе |
Рядом фиксируем ключ соединения, уникальность CRM, отсутствие фильтрации и проверки. Все суммы здесь в рублях. Диапазон decimal(12,2) в рабочей системе сверяют с допустимыми суммами.
Добавляем владельца правил, дату согласования и версию.
Шаг 5. Реализовать правила в SQL
Таблицы загружены в PostgreSQL, total_kopecks — целое число. Идентификаторы заполнены, уникальность ключей проверена. Создадим представление:
CREATE VIEW mapped_orders ASSELECT o.id AS order_id, c.customer_id, c.segment, CAST(o.total_kopecks / 100.0 AS DECIMAL(12, 2)) AS amount_rub, o.status_code AS source_status_code, CASE o.status_code WHEN 'P' THEN 'paid' WHEN 'C' THEN 'cancelled' ELSE 'unknown' END AS order_status, CASE WHEN c.customer_id IS NULL THEN 0 ELSE 1 END AS customer_matched, CASE WHEN o.status_code IN ('P', 'C') THEN 1 ELSE 0 END AS status_mappedFROM orders AS oLEFT JOIN crm_customers AS c ON o.client_id = c.shop_client_id;
LEFT JOIN сохраняет заказы без найденного клиента. Но сам по себе он не защищает от размножения строк: если справа несколько совпадений, в результат попадут все. Поэтому проверка ключа CRM обязательна.
Для двух известных статусов достаточно CASE. Если справочник большой и часто меняется, соответствия удобнее хранить в отдельной таблице с уникальным исходным кодом.
Результат, упорядоченный по order_id:
|
order_id |
customer_id |
segment |
amount_rub |
order_status |
|
101 |
501 |
retail |
1250.00 |
paid |
|
102 |
502 |
business |
800.00 |
cancelled |
|
103 |
501 |
retail |
2500.00 |
paid |
|
104 |
NULL |
NULL |
600.00 |
unknown |
У заказа № 104 оба служебных признака равны 0, у остальных — 1. Запрос обработал данные по заданным правилам, но значение неизвестного статуса и причину отсутствия клиента в CRM ещё нужно выяснить.
Шаг 6. Проверить результат
Мы не исключаем заказы и не объединяем их в группы, поэтому в итоговой таблице должны остаться те же четыре заказа с общей суммой 5150 ₽. .
|
Проверка |
Ожидаемый результат |
|
Количество строк и уникальных заказов |
4 и 4 |
|
Множество order_id |
Совпадает с исходным, нет потерянных и лишних заказов |
|
Общая сумма |
5150 ₽, как в источнике после перевода в рубли |
|
Заказы без клиента |
Только № 104 |
|
Неизвестные статусы |
Только № 104 с исходным кодом H |
|
Сумма заказов со статусом paid |
3750 ₽ |
Сводные значения получим одним запросом:
SELECT COUNT(*) AS rows_total, COUNT(DISTINCT order_id) AS unique_orders, SUM(amount_rub) AS amount_total, SUM(CASE WHEN customer_matched = 0 THEN 1 ELSE 0 END) AS missing_customers, SUM(CASE WHEN status_mapped = 0 THEN 1 ELSE 0 END) AS unknown_statusesFROM mapped_orders;
Ожидаем 4, 4, 5150.00, 1, 1. Две ошибки могут компенсировать друг друга, поэтому совпадения итогов недостаточно. Отдельно сверяем идентификаторы и значения по заказам.
Мы отметили неизвестный статус, но пока не знаем, как учитывать заказ на 600 ₽ в отчёте. Прежде чем использовать результат, нужно выяснить значение статуса или договориться с заказчиком, как поступить с этим заказом.
Какие ошибки маппинга искажают аналитику
В нашем примере важно сохранить каждый заказ, правильно определить клиента и расшифровать статус. Посмотрим, что произойдёт, если нарушить эти условия.
Соединение таблиц размножает строки и суммы
Допустим, в CRM появились две записи с shop_client_id = A7. После соединения заказы № 101 и № 103 повторятся. Вместо четырёх строк получим шесть, а сумма вырастет с 5150 до 8900 ₽: повторно прибавятся 1250 и 2500 ₽.
Запрос остаётся синтаксически правильным. Ошибка в предположении о связи: мы ожидали одну карточку, а получили две. Если это история сегментов, выбираем запись по согласованному правилу. Если технические дубли — исправляем источник или применяем подтверждённое правило очистки. DISTINCT не заменяет такого решения: различающиеся карточки могут остаться.
Похожие поля имеют разный бизнес-смысл
5150 ₽ — стоимость всех заказов, включая отменённый. Даже 3750 ₽ по статусу paid — пока сумма заказов с этим статусом, а не автоматически согласованная выручка. Для отчёта по поступлениям нужны платежи; для других определений могут понадобиться возвраты. Аналогично дата создания заказа не заменяет дату оплаты.
Неизвестные значения превращаются в корректные
Если написать ELSE ‘cancelled’, код H незаметно попадёт в отмены. Замена отсутствующей суммы на ноль создаёт похожую проблему: неизвестная стоимость выглядит как бесплатный заказ. Лучше сохранить исходное значение и обозначить исключение. Строку можно оставить с признаком проблемы, отправить на разбор или остановить публикацию результата — по согласованному правилу.
Источник меняется, а правила остаются прежними
В справочнике появляется новый статус или сумма начинает приходить в рублях вместо копеек. Запрос выполняется, но результат уже неверен. Поэтому при обновлении проверяют новые коды, типы, пропуски и дубли ключей. При изменении правил сохраняют их версию и решают, нужно ли пересчитать старые данные.
Инструменты для маппинга данных: что выбрать под задачу
Правила преобразования можно реализовать в SQL, написать на Python или настроить через визуальный интерфейс. Выбор зависит от источников, сложности задачи и того, кто будет поддерживать решение.
SQL и Python для подготовки аналитических данных
Если таблицы доступны в одной БД, с помощью SQL можно объединить записи, преобразовать значения и проверить результат. В нашем примере для этого понадобились соединение таблиц, условные выражения и агрегатные функции.
Отработать эти приёмы можно в бесплатном симуляторе SQL. В нём вы будете решать задачи аналитика сервиса доставки: писать запросы к PostgreSQL, объединять таблицы и рассчитывать показатели. Решения проходят автоматическую проверку.
Python удобен для обработки файлов, ответов API и преобразования данных. При объединении таблиц в pandas параметр validate=’many_to_one’ проверяет уникальность ключей справа, а indicator=True помогает выявить строки без соответствия. Важно учитывать различия с SQL: pandas может сопоставить пропуски в ключах друг с другом.
Если вы пока не работали с Python, начать можно с бесплатного курса «Основы Python». В нём разбирают типы данных, списки, словари, условия, циклы и функции. Закрепить материал помогут более 50 задач. Это база для дальнейшего изучения pandas.
Power Query и визуальные инструменты подготовки данных
Power Query позволяет получать данные и задавать преобразования через интерфейс. Это удобно для повторяющихся выгрузок в Excel или Power BI. Но визуальная настройка не отменяет проверок: ошибочное соединение размножит заказы так же, как SQL-запрос.
Инструменты интеграции и специализированные редакторы
Перенос данных и бизнес-преобразования могут выполнять разные средства. Например, Airbyte поддерживает интеграцию с dbt Cloud для преобразований после синхронизации. Для визуального задания соответствий между форматами и источниками существует Altova MapForce.
Выбирая инструмент, проверьте доступные подключения, сложность правил, способы запуска и контроля ошибок. Затем выясните, кто будет поддерживать решение и как хранить версии. Для нашего примера достаточно SQL и проверок результата.
Кто отвечает за правильность маппинга
Один специалист может выполнять несколько функций, но обязанности стоит разделить.
|
Участник |
Зона ответственности |
|
Аналитик данных |
Задача отчёта, определения показателей и проверка результата |
|
Системный аналитик |
Структуры и правила обмена данными между системами |
|
Инженер данных |
Реализация загрузок, преобразований и технических проверок |
|
Владелец данных или предметный эксперт |
Подтверждение смысла полей и бизнес-правил |
Инженер может обнаружить код H, но его значение подтверждает тот, кто знает обработку заказов. Аналитик оценивает влияние на отчёт. Затем команда обновляет правила и реализацию.
От подготовки данных к анализу: какие навыки нужны аналитику
Заказы сопоставлены с клиентами, суммы проверены, исключения отмечены. Следующий шаг — понять, что эти данные говорят о работе магазина. Здесь технические навыки соединяются с пониманием бизнеса.
SQL и Python: получить, объединить и проверить данные
Нам понадобились соединения таблиц, условные выражения, агрегаты и типы данных. До запроса пришлось изучить ключи, пропуски и детализацию.
Для практики возьмите две таблицы. Добавьте отсутствующий ключ, неизвестный статус и дубль клиента. Опишите ожидаемое поведение, реализуйте преобразование и проверьте, обнаруживаются ли нарушения.
Бизнес-показатели и визуализация: ответить на исходный вопрос
После подготовки нужно рассчитать показатели и объяснить результат заказчику. Красивый график не исправит смешение суммы заказов с платежами.
Анатолий Карпов, CEO Karpov Courses и бывший ведущий аналитик VK, в интервью об A/B-тестировании обращает внимание начинающих специалистов на важное:
«Многие новички зацикливаются на статистике и забывают о бизнес-логике. Не повторяйте эту ошибку».
При маппинге похожая проблема возникает до расчёта показателей: правильный синтаксис не поможет, если не разобраться в смысле полей и связей.
Как освоить полный цикл работы с данными
Весь процесс от получения данных до выводов можно освоить на курсе «Аналитик данных». В программе есть SQL, Python, Git, теория вероятностей, статистика, продуктовая аналитика и A/B-тесты, BI-системы и визуализация. SQL помогает получать и объединять данные, Python — обрабатывать и исследовать их, а следующие блоки — переходить к показателям, проверке гипотез и представлению результатов.
Программа подходит для обучения с нуля. Практические задания помогают закрепить навыки, а финальный проект — связать их в самостоятельную работу: от исследования данных до оценки A/B-тестов.
Заключение: с чего начать первый маппинг
Прежде чем соединять таблицы, определите, что означает одна строка результата и для какого решения нужны данные. Затем изучите источники, согласуйте ключи и запишите правила вместе с обработкой исключений.
В нашем примере мы сохранили четыре заказа и общую сумму, но обнаружили неизвестный статус и отсутствующего клиента. Успешный запрос помог выявить эти проблемы, но не объяснил их причину.
Сохраните рядом с кодом происхождение полей, правила обработки исключений и проверки. Они понадобятся при изменении источников и передаче задачи другому специалисту.
ссылка на оригинал статьи https://habr.com/ru/articles/1101560/