Продолжаем изучать особенности взаимодействия PostgreSQL и 1С. Эта связка нередко становится источником неочевидных проблем с производительностью. В ходе анализа инцидентов у наших заказчиков мы регулярно сталкиваемся с тонкими нюансами работы СУБД, которые существенно влияют на стабильность системы. Сегодня акцентируем внимание на «зависших» сессиях Postgres в состоянии idle in transaction – безобидном, на первый взгляд, но способном спровоцировать серьёзную деградацию работы базы.
Что мы знаем о зависших транзакциях в 1С системах?
Если система работает под управлением классического блокировочника типа MS SQL, и долгая транзакция зависла по причине неправильной работы информационной системы с транзакциями или в следствие каких-то взаимодействий с внешними системами внутри транзакции, то такая ситуация достаточно легко диагностируется и не менее легко проявляет себя. У пользователей возникают ошибки с конфликтами блокировок, сессии могут отваливаться по таймауту, сессии вызывают ожидания у других сессий, а администраторы это легко диагностируют и прекрасно видят деревья блокировок (кто кого заблокировал). Т.е. можно сказать, что это «громкая» проблема – все всё видят и понимают. Вот пример классического дерева блокировок в MS SQL:
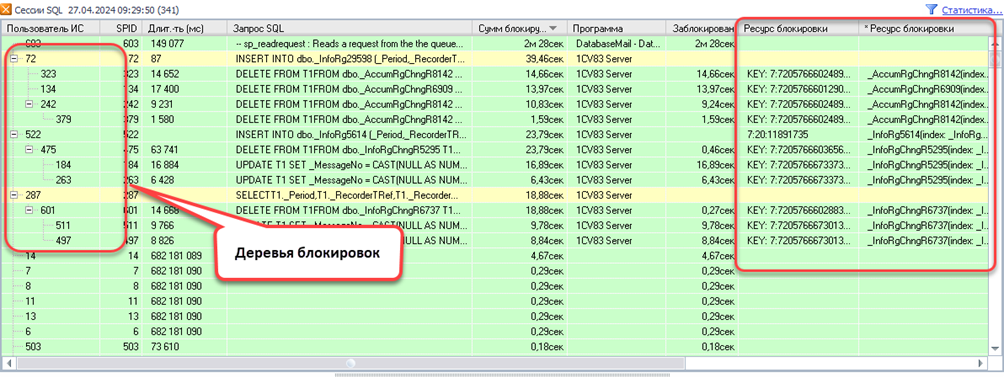
Блокировки могут быть на ключе индекса, страничными и табличными. B СУБД, руководствуясь собственной логикой, может эскалировать блокировки, например, со страничной до табличной, если посчитает, что издержки на ее обслуживание будут меньше. В общем, в классической модели MS SQL Server долгая открытая транзакция чаще всего проявляется как блокировки.
Про блокировки в MS SQL у нас есть целый цикл статей. Рекомендую.
А вот в версионнике (MVCC) Postgres «зависшая» транзакция ведет себя совсем по-другому:
-
нет массовых блокировок и классические деревья блокировок не формируются;
-
удерживает снимок данных (snapshot) и, возможно, блокировки;
-
мешает автовакууму удалять старые версии строк;
-
симптомы проявляются не сразу: рост занимаемого места на диске, увеличение времени выполнения запросов, лаги репликации, риск исчерпания XID (wraparound). Всё это постепенно – часы и даже дни.
Такие сессии с зависшими транзакциями имеют в PG статус idle in transaction (idle in tran или IIT) – это специфический статус сессии в PostgreSQL, который возникает, когда клиентское приложение инициировало транзакцию (явно через BEGIN или же неявно), но в данный момент не отправляет серверу новых команд и не завершило транзакцию вызовом COMMIT или ROLLBACK.
В отличие от просто idle (сессия свободна, транзакция не начата), idle in transaction означает, что серверный процесс удерживает открытую транзакцию и все связанные с ней ресурсы, ожидая следующего указания от клиента.
В отличие от обычной активной транзакции, Idle in transaction (IIT) может не завершиться никогда без внешнего вмешательства.
Влияние Idle In Transaction (IIT) на производительность 1C
С точки зрения производительности состояние idle in transaction представляет собой скрытую угрозу. Сессия, находящаяся в idle in transaction, не выполняет полезной работы, но при этом может удерживать блокировки, сохранять «снимок» данных (snapshot) и занимать соединение из пула. В условиях высокой нагрузки или при наличии ошибок в коде приложения такие «спящие» транзакции способны приводить к каскадным блокировкам, раздуванию таблиц (bloat) и даже к исчерпанию пула соединений, что в конечном итоге вызывает деградацию или полную остановку сервиса.
Почему это особенно коварно при работе с 1С:
-
1C активно использует фоновые/регламентные задания, которые могут прерваться, а сессию sql оставить с открытой транзакцией.
-
1С часто открывает транзакции «по умолчанию» при записи/чтении.
-
Интеграции с внешними системами могут выполняться внутри транзакции (HTTP-запросы, ожидание ответа, внешние очереди).
-
Ожидание ввода пользователя или сетевой задержки внутри транзакции – очень распространенная и болезненная ситуация.
PostgreSQL хранит старые версии строк в тех же файлах таблицы (in-place, в куче).
UPDATE = вставка новой версии + пометка старой. Удаление мусора – это работа VACUUM.
VACUUM обязан соблюдать правило: нельзя удалить версию строки, которую теоретически может увидеть любая живая транзакция в кластере. Граница называется xmin horizon – самый старый XID/снапшот, ещё используемый где-либо. Если его удерживает забытая транзакция, autovacuum запускается, честно сканирует таблицу, тратит I/O и не удаляет ничего.
Рассмотрим подробнее влияние на производительность 1С таких вот idle in transaction сессий.
Цепочка деградации производительности
-
Долгая сессия в статусе idle in transaction удерживает горизонт xmin – границу, за которой VACUUM может безопасно удалять мёртвые версии строк (dead tuples).
xmin — минимальный номер транзакции, чьи изменения ещё могут быть видны активным сессиям; пока он не продвинется, старые версии строк нельзя удалять.
-
VACUUM не может очистить страницы за пределами горизонта: мёртвые кортежи остаются, растёт n_dead_tup, страницы не помечаются в Visibility Map как all_visible. В результате возникает bloat.
Bloat – избыточное «раздувание» таблиц и индексов из‑за накопленных мёртвых строк и неэффективного использования места. Приводит к тому, что на диске хранится много неиспользуемых данных, а в оперативной памяти помещается меньше полезных страниц.
n_dead_tup – оценка числа мёртвых (невидимых для текущих транзакций) версий строк в таблице. Растёт, если VACUUM не успевает или не может их удалить.
Visibility Map – вспомогательная структура, которая помечает страницы, где все строки видны всем транзакциям. Флаг all_visible означает, что на странице нет строк, которые могли бы быть невидимы для какой‑либо активной транзакции. Это позволяет, например, выполнять Index Only Scan без обращения к таблице. -
Bloat и блокировка очистки вызывают каскад эффектов:
-
Рост физического размера и падение эффективности кэша. Мёртвые строки занимают место, таблица и индексы распухают, буферный кэш (shared_buffers) вынужден держать больше «мусорных» страниц, снижая долю полезных данных в памяти, растёт I/O и число дисковых чтений.
-
Потеря эффективности Index Only Scan. Из‑за отсутствия флага all_visible в Visibility Map PostgreSQL вынужден делать Heap Fetches – проверять видимость строк в таблице. Index Only Scan остаётся в плане, но фактически превращается в почти Index Scan (план с чтением индекса и обращением к таблице) с дополнительными обращениями к таблице.
Index Only Scan – режим чтения только по индексу, когда все нужные данные есть в индексе и не требуется обращение к таблице за исключением проверки видимости.
Heap Fetches – число обращений к страницам таблицы для проверки видимости строк. Высокий показатель означает, что преимущество Index Only Scan почти утрачено. -
Накопление длинных HOT‑цепочек. При долгом отсутствии очистки HOT‑цепочки не обрезаются, и при чтении приходится проходить по длинной цепочке версий – это увеличивает стоимость чтения.
HOT, Heap‑Only Tuples – оптимизация PostgreSQL: если обновление не затрагивает индексированные колонки и на странице есть место, новая версия строки создаётся на той же странице, без обновления индексов. Длинные HOT‑цепочки возникают, когда VACUUM долго не чистит страницу: вместо одной актуальной строки приходится читать несколько её версий подряд. -
Низкая эффективность автовакуума и каскадное влияние на другие таблицы. Воркеры автовакуума регулярно запускаются на заблокированные горизонтом таблицы, тратят ресурсы на бесплодные попытки очистки и не успевают обслуживать другие таблицы. При наличии нескольких таких таблиц все воркеры (по умолчанию 3) могут быть заняты, что усиливает эффект.
-
Устаревание статистики и ошибки планировщика. Планировщик использует reltuples (оценка числа живых строк) и relpages (оценка числа страниц по 8 кБ, которые реально занимают данные таблицы) из pg_class. Они обновляются при VACUUM/ANALYZE и в активно меняющихся таблицах быстро устаревают.
-
relpages растёт из‑за bloat: мёртвые строки занимают место, свободное место на страницах не переиспользуется, и PostgreSQL выделяет новые страницы, даже если полезных строк почти не прибавилось. Планировщик считает таблицу больше, чем она есть по полезным данным, и может избегать Seq Scan (последовательного сканирования всей таблицы) там, где он был бы эффективен.
-
reltuples устаревает из-за IIT: после массовых DELETE он остаётся завышенным (мёртвые строки ещё не убраны, а живых стало меньше), после массовых UPDATE живых строк примерно столько же, но таблица распухла. Планировщик может строить планы по старому значению количества строк, например, выбрать Hash Join там, где Nested Loop был бы эффективнее.
-
-
-
Избыточное потребление памяти и ресурсов сервера. Каждая сессия — это отдельный backend‑процесс, который занимает память (структуры каталога, буферы, потенциальный work_mem). В масштабе сотен или тысяч IIT‑сессий это создаёт значительную нагрузку на память сервера.
-
Риск исчерпания XID (wraparound). Каждая IIT-сессия занимает слот в пуле соединений (connection pool), быстро заполняя лимит max_connections (предельное число одновременных соединений). Транзакция не возвращает соединение в пул, пока не завершится и XID накапливается. В ванильных версиях Postgres XID – это 32‑битное число: когда оно приближается к пределу (порог autovacuum_freeze_max_age, по умолчанию 200 млн.), база переходит в защитный режим и перестаёт принимать новые транзакции, чтобы избежать путаницы «старых» и «новых» идентификаторов. Это уже даже не деградация, а полная остановка записи, причём на уровне всего кластера (пространство XID общее для всех баз).
У некоторых вендоров XID уже стал 64-битным и проблема переполнения счётчика (wraparound) практически исчезает для большинства реальных сценариев.
Все эффекты взаимосвязаны и проявляются постепенно: деградация часто бывает «тихой», без явных ошибок, но с ростом времени отклика и нагрузки на I/O. Самое неприятное, что страдают другие, обычные sql-запросы, которые вроде бы никак и не связаны с проблемными сессиями, и страдают именно в части деградации длительности. Плавно, не всегда заметно. Сначала запрос выполнялся 10 сек, потом 20 сек, через день он уже выполняется минуту. И, не понимания природу этой деградации, можно принять неверные управленческие решения – оптимизировать код запроса, перепутав причину и следствие.
По сути Idle in transaction – это некий аналог блокировки, который очень нелегко обнаружить, т.к. видимых или ярко выраженных симптомов нет, но день ото дня система плавно деградирует в части производительности, если с такими сессиями ничего не делать.
Как увидеть и идентифицировать события Idle in transaction?
В отличии от MS SQL, проблема не особо явная – вот так вот сразу её не увидеть, если специально не искать. Состояние Idle in transaction видно в системном представлении pg_stat_activity в столбце state.
Важные метрики:
-
tx_age — сколько живёт транзакция;
-
idle_age — сколько сессия находится именно в состоянии простоя;
-
application_name — какое приложение держит транзакцию;
-
client_addr — откуда пришло подключение;
-
last_query — последний запрос, который может подсказать причину (но в 1С это маловероятно).
Но для глубокого анализа пользоваться pg_stat_activity в чистом виде не особо удобно, т.к. в моменте мы информацию, конечно, увидим, но всего масштаба проблемы – нет. Поэтому для этого стоит использовать мониторинг Perfexpert.
Впервые в отрасли в мониторинге производительности PerfExpert мы разработали ряд метрик и трасс для диагностики таких событий (их не существовало до сих пор), чтобы можно было не только видеть картину здесь и сейчас, но и с любой исторической глубиной.
Добавлены новые счетчики производительности Perfexpert:
-
Количество активных автовакуумов при большом количестве idle in tran.
-
Счетчик XID
-
Активные сессии и количество транзакций с IIT
Введена отдельная трасса для сбора событий вида idle in transaction, чем-то напоминающая трассу Locks в MS SQL. В ней можно получить информацию: насколько этих событий много, у кого и во сколько они происходят, и какие длительности. Анализируя эту трассу и используя сведения о пользователях 1С, журнале регистрации – можно выйти на операции, которые приводят к таким событиям.
Приведу парочку примеров для наглядности. Начну со счетчиков производительности.
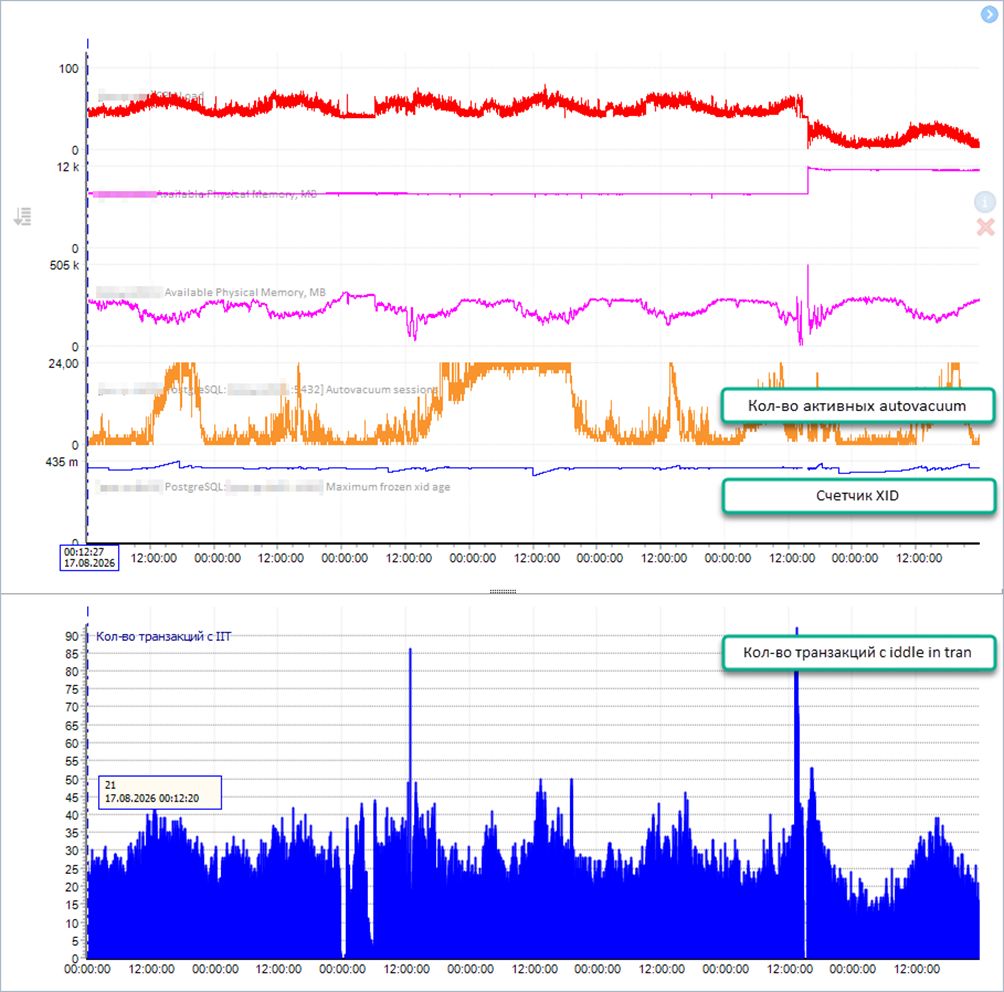
На рисунке выше видна характерная горизонтальная полка воркеров с автовакуумом (оранжевый график), когда длительный запрос не позволял на протяжении суток отрабатывать автовакуумам, причем этот запрос выполнялся на реплике, а не на этом сервере.
Или, например, вот такая картина, которая помогает увидеть причины роста кол-ва транзакций с Idle in transaction:
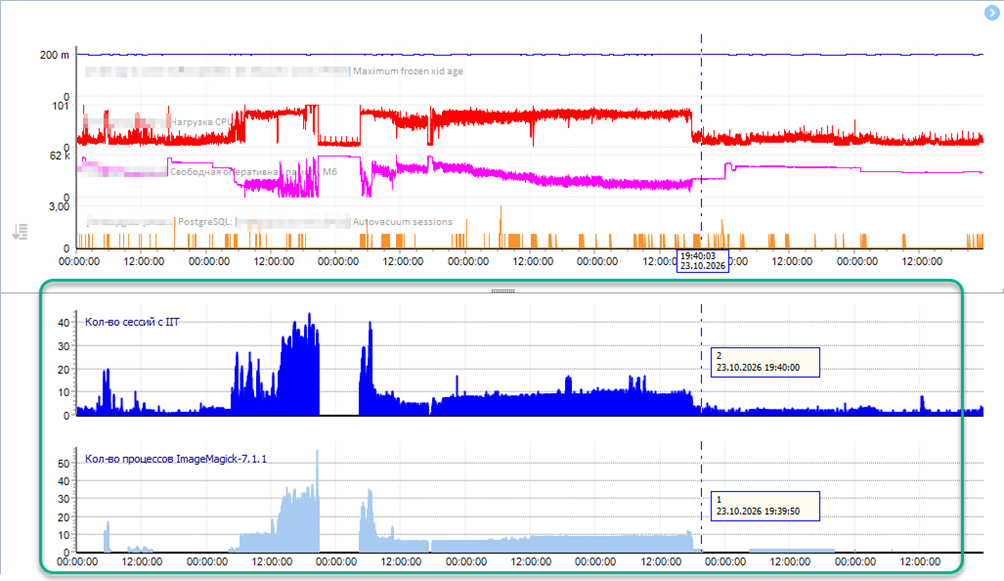
Рост сессий с idle in transaction провоцирует процесс, ImageMagic, запускаемый с сервера 1С. Чем больше процессов ImageMagic, тем больше сессий в статусе IIT.
Чаще всего, кстати, рост сессий IIT провоцируют именно фоновые и регламентные задания.
Можно раскрутить ситуацию и увидеть подтверждение этому. Построим в Perfexpert трассу запросов событий вида idle in transaction за этот же период и сгруппируем их по виду запроса:
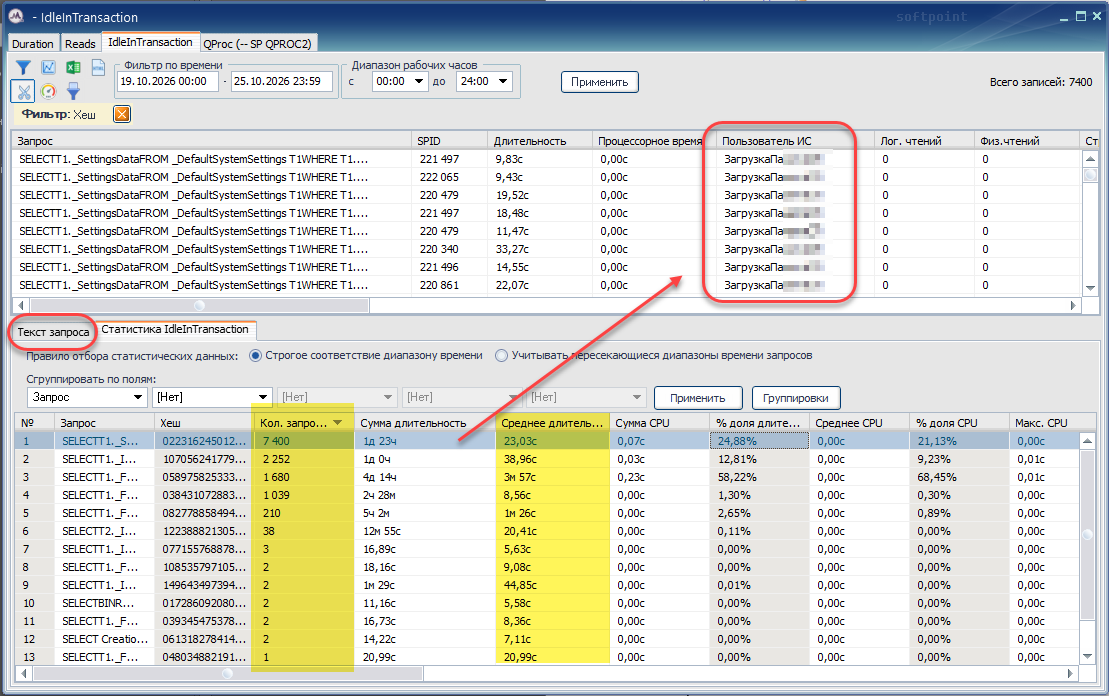
Все самые популярные запросы выполняются пользователем «ЗагрузкаПа…». Для подсказки можно посмотреть последний запрос, который выполнялся в этой транзакции (на закладке «Текст запроса»).
Если вернуться в основное окно мониторинга, то в сессиях 1С хорошо видно, что это действительно фоновое задание, запускаемое от имени пользователя «ЗагрузкаПа…» и которое работает практически непрерывно.
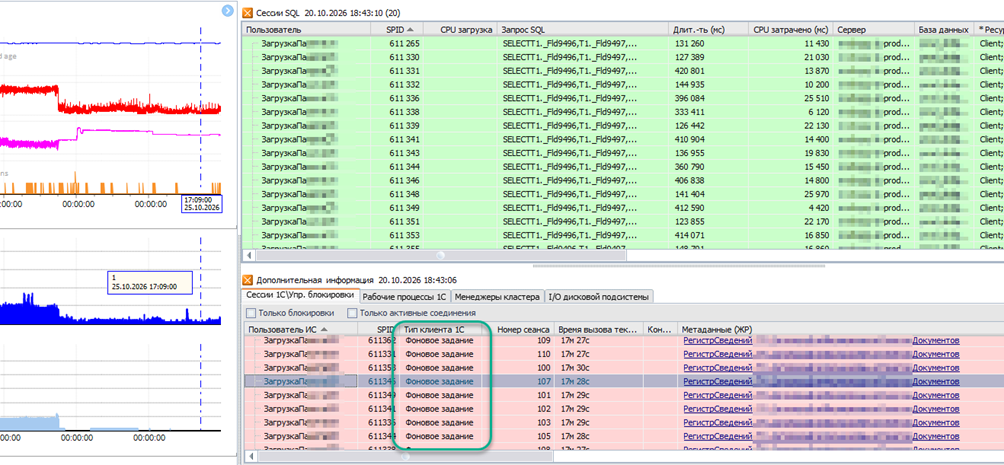
Соберу в кучу несколько распространенных сценариев или, если угодно, примеров в 1С-системах, которые связаны с ростом количества сессий с IID или с неконтролируемым ростом XID, что, в свою очередь, приводит к возможной деградации производительности. Примеров на самом деле очень много и почти все они связаны с неаккуратным использованием транзакций в коде 1С.
-
Зависшие или некорректно завершенные фоновые и регламентные задания
Это одна из самых распространенных причин и вызвана скорее неоптимальным кодом по работе с транзакциями.
Фоновое задание 1С прерывается (ошибка, зависание на внешнем http-вызове, рестарт рабочего процесса, тайм-аут), но его соединение с PostgreSQL не закрывается корректно. Сессия остаётся с открытой транзакцией в состоянии idle in transaction и может висеть неограниченно долго — вплоть до перезапуска сервера приложений 1С. -
Работа с явными транзакциями — ошибки обработки исключительных ситуаций в коде 1С
Клиентский код 1С открыл транзакцию НачатьТранзакцию(), далее начал выполнять какие-то запросы к СУБД, заблокировал строки, но дальше происходит исключительная ситуация, сессия 1С прерывается, оставив транзакцию на СУБД зависшей. -
Взаимодействие с внешними системами внутри транзакции
Тоже довольно распространенная проблема. В клиентском коде открываятся явная транзакция, внутри которой происходит вызов и ожидание ответа либо от внешнего приложения/веб-сервиса, либо от клиентского диалога. Соответственно, если с внешними соединениями что-то пошло не так – сессия прервалась, ответ не получен, то транзакция так же осталось зависшей в состоянии IIT. -
Нагрузка фоновых процессов
В высоконагруженных системах, где идут интенсивные изменения по таблицам (по тем же регистрам накопления, например) чтобы не допустить wraparound, autovacuum начинает активнее сканировать таблицы для «заморозки» старых XID. Это потребляет ресурсы CPU и I/O, из-за чего обычные операции 1С (проведение документов, формирование отчётов) начинают тормозить. -
Тяжелые запросы, которые возвращают очень много строк
Если пользователь запустил отчёт (=запрос), который извлекает миллионы строк из большой и популярной таблицы, например, регистра бухгалтерии или накопления для последующей обработки на стороне 1С (вся математика выполняется на сервере приложений), то такая неявная транзакция также приводит к состоянию IIT. Пока 1С переваривает этот массив данных, SQL-сессия остаётся в статусе idle in transaction со всеми вытекающими последствиями: рост XID, накопление мёртвых кортежей, блокировка работы autovacuum.
Как решать такие проблемы
1. Диагностика — понять масштаб и причины
В первую очередь нужно понять масштаб этих проблем: одиночные, множественные, постоянные, длительные, суммарная длительность и т.д. Так длительность сессии, измеряемой в минутах и часах – это уже проблема и стоит заняться анализом.
Именно для этого идеальным образом подойдет Perfexpert со своим инструментарием анализа трасс с событиями idle in transaction, метрик производительности типа количества активных автовакуумов, количества и длительности таких транзакций, счетчика XID. Звучит, конечно, как реклама, но это не так. Это новый функционал, которому пока нет аналогов и хочется поделиться этой новостью.
Сопоставляя эти данные с другими счетчиками и трассами, можно понять критичность проблемы и выйти на ее источник.
2. Изменить настройки Postgres – параметр idle_in_transaction_session_timeout
Это основной встроенный инструмент Postgres для автоматического решения проблемы. Задаёт время в миллисекундах, по истечении которого сессия, находящаяся в idle in transaction, будет принудительно завершена. По умолчанию значение равно 0, что означает отключение тайм-аута.
Настройка подойдет далеко не всем, т.к. слишком низкое значение может привести к ложным срабатываниям.
Способы настройки:
-
Глобально (в postgresql.conf): idle_in_transaction_session_timeout = ’60s’
-
Для конкретной роли: ALTER ROLE app_user SET idle_in_transaction_session_timeout = ’60s’;
-
Для конкретной сессии: SET idle_in_transaction_session_timeout = ’30s’; (или SET LOCAL в рамках транзакции).
3. Исправление на уровне приложения
Никакие серверные тайм-ауты не устранят причину, если код приложения продолжает оставлять транзакции открытыми. По мониторингу производительности PerfExpert можно найти пользователей и операции 1С, проверить качество кода для работы с явными транзакциями.
Кроме того, в Perfexpert можно настроить алерты (оповещения) которые срабатывают при появлении сессий в idle in transaction дольше заданного порога. Это позволяет обнаруживать проблему до того, как она приведёт к инциденту.
Резюме
Состояние idle in transaction (IIT) в связке 1С:Предприятие и PostgreSQL является не редким экзотическим сбоем, а типовой и частой проблемой, обусловленной как архитектурными особенностями платформы (автоматическое управление транзакциями, длинные бизнес-операции, специфика сеансовой модели и блокировок), так и небрежной работой с явными транзакциями в коде 1С. Крайне важно не просто фиксировать факты замедления, а понимать первопричины таких состояний: чаще всего за ними стоят неоптимизированные запросы, неверные настройки таймаутов или ошибки в логике завершения транзакций.
Поэтому важна точная диагностика. Хотя базовые системные представления PostgreSQL (pg_stat_activity, pg_locks, pg_stat_user_tables) дают общую картину, наилучшим и наиболее эффективным вариантом для комплексной диагностики в экосистеме 1С является использование специализированного мониторинга PerfExpert. Этот инструмент позволяет удобно и быстро сопоставить события на уровне СУБД с конкретными сеансами, пользователями, регламентными заданиями и даже строками кода 1С, сокращая время поиска виновника с часов до минут.
Понимание механизмов возникновения IIT и наличие налаженного контура мониторинга дают возможность не только оперативно устранять текущие инциденты, но и выстраивать проактивную защиту от деградации производительности: за счёт оптимизации кода, настройки параметров базы и контроля длительных сессий.
Ссылки на остальные части Записок оптимизатора 1С:
-
Записки оптимизатора 1С (ч.1). Странное поведение MS SQL Server 2019: длительные операции TRUNCATE
-
Записки оптимизатора 1С (ч.2). Полнотекстовый индекс или как быстро искать по подстроке
-
Записки оптимизатора 1С (ч.3). Распределенные взаимоблокировки в 1С системах
-
Записки оптимизатора 1С (ч.4). Параллелизм в 1С, настройки, ожидания CXPACKET
-
Записки оптимизатора 1С (ч.5). Ускорение RLS‑запросов в 1С системах
-
Записки оптимизатора 1С (ч.6). Логические блокировки MS SQL Server в 1С: Предприятие
-
Записки оптимизатора 1С (ч.7). «Нелогичные» блокировки MS SQL для систем 1С предприятия
-
Записки оптимизатора 1С (ч.8). Нагрузка на диски сервера БД при работе с 1С. Пора ли делать апгрейд?
-
Записки оптимизатора 1С (ч.9). Влияние сетевых интерфейсов на производительность высоконагруженных ИТ‑систем
-
Записки оптимизатора 1С (ч.10): Как понять, что процессор — основная боль на вашем сервере MS SQL Server?
-
Записки оптимизатора 1С (ч.11). Не всегда очевидные проблемы производительности на серверах 1С
-
Записки оптимизатора 1С (ч.12). СрезПоследних в 1C:Предприятие на PostgreSQL. Почему же так долго?
-
Записки оптимизатора 1С (ч.13). Что не так в журнале регистрации 1С в формате SQLitе?
-
Записки оптимизатора 1С (ч.14.1). Любите свою базу данных и не забывайте обслуживать
-
Записки оптимизатора 1С (ч.14.2). Пересчет индексов на SSD‑дисках. Делаем или игнорируем?
-
Записки оптимизатора 1С (ч.14.3). Отличия в обслуживании статистик в MS SQL и в PostgreSQL
-
Записки оптимизатора 1С (ч.15). Параллелизм запросов 1С в PostgreSQL
-
Записки оптимизатора 1С (ч.18.1). Ошибки 1С в части производительности и стабильности ИС
-
Записки оптимизатора 1С (ч.18.2). Ошибки 1С из‑за конфликта блокировок
ссылка на оригинал статьи https://habr.com/ru/articles/1101748/