Привет, Хабр! Меня зовут Виталий, я руководитель команды инженеров данных в группе компаний, которая занимается разработкой и поддержкой В2В финтех-платформы. Два года назад мы получили в свое распоряжение Oracle — с часами ожидания запросов и legacy процедурами на тысячи строк кода.
Сейчас у нас StarRocks, Airflow, dbt и 25 аналитиков, которые самостоятельно собирают витрины через Git. Основные витрины, которые раньше строились десятки минут, теперь отдаются за секунды: по статистике за последнюю неделю 99% всех запросов укладываются в 14 секунд. При этом мы не покупали dev-кластер и не нанимали новых инженеров данных.
В статье поделюсь опытом, как мы к этому пришли.
Будет полезно тем, кто хочет организовать производительную аналитическую платформу без увеличения инфраструктурных затрат и расширения штата.
Проблема и выбор стека
Два года назад наша инфраструктура еще не была рассчитана на текущие объемы: запросы Oracle могли выполняться от 20 минут до часа. Версионирование и документацию предстояло выстроить — процедуры создавались без регламента и контроля, история изменений не сохранялась, а код аналитиков жил только на локальных машинах.
При этом большими темпами росло количество продуктов и клиентская база компании. Нужно было выстроить инфраструктуру, которая бы поддерживала темп роста бизнеса. По мере роста команды и объёма задач стало понятно, что процессы нужно менять.
Мы выбирали стек для новой инфраструктуры данных по трём критериям: масштабируемость, производительность и разумная стоимость владения. К OLAP-движку было два обязательных требования: открытый исходный код и горизонтальное масштабирование. Поэтому проприетарные Vertica и Redshift отпали сразу. У них закрытый код, привязка к вендору и стоимость, которая растёт вместе с объёмом данных и числом узлов.
Среди open source-решений самым неоднозначным оказался Greenplum. В 2024 году Broadcom заархивировал его открытый репозиторий, и на основе кода появились форки: Greengage от Arenadata и Apache Cloudberry, который с октября 2024 года находится в инкубаторе Apache Software Foundation. Формально это open source, но нас остановили две причины.
Первая – стоимость владения. Под Greenplum обычно выделяют отдельный парк серверов. Сегмент-хосты должны быть одинаковыми, потому что кластер работает со скоростью самого медленного сегмента, а для хранения рекомендуют RAID-массивы из быстрых дисков. К тому же поддерживать такой кластер без DBA с опытом именно в Greenplum тяжело.
Вторая – неясное будущее технологии. Оба форка молодые, и развитие каждого во многом зависит от одной компании: Greengage — от Arenadata, Cloudberry — от HashData.
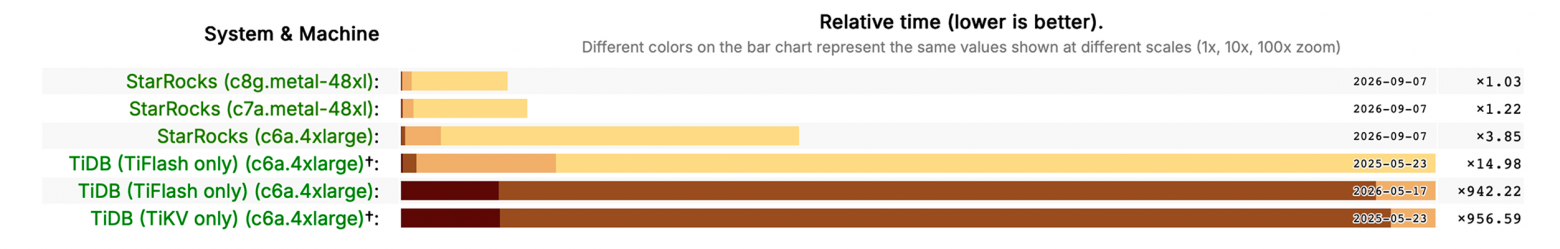
В финал вышли StarRocks, ClickHouse и TiDB. Победил StarRocks: только он выполнил наш типичный аналитический запрос с десятками JOIN. ClickHouse тогда плохо работал с многотабличными соединениями и упал на этом тесте с OOM, а TiDB оказался медленнее. Приятным бонусом оказалась совместимость StarRocks с протоколом MySQL: аналитики подключаются привычными клиентами и BI-инструментами, так что переучиваться им почти не пришлось.
Кроме собственных тестов, мы смотрели на открытый бенчмарк ClickBench. На скриншоте видно, что на большинстве конфигураций железа TiDB работает медленнее StarRocks.
Архитектура и ключевые решения
На текущий момент мы работаем на кластере StarRocks в режиме shared-nothing. Оркестрируем через Airflow с плагином Cosmos, поверх этого dbt для трансформаций. Для визуализации выбрали DataLens, каталог данных ведем в OpenMetadata.
А теперь подробнее расскажу, как все устроено:
Ресурсные группы
Для разграничения ресурсов мы используем стандартные средства — ресурсные группы, которые позволяют ограничивать квоты на CPU, RAM и Disk space. Ресурсы CPU в рамках стенда делятся по принципу «коммуналки»: пока аналитики работают, им отдаются все мощности, но как только запускается продовый пайплайн, приоритет (через параметр cpu_weight) смещается в пропорции 1:2 в пользу прода. Установлен лимит на потребление RAM: при достижении порогов происходит сброс промежуточных результатов на диск, чтобы запрос не падал, а продолжал выполняться, пусть и медленнее. На тяжелые запросы настроены лимиты, при превышении которых запрос автоматически останавливается.
Ролевая модель
Аналитики могут создавать и удалять таблицы только в единой общей песочнице. В продовых слоях — только чтение. Так пользователи могут свободно экспериментировать, не рискуя повредить данные в основных слоях хранилища. Каждое изменение проходит ревью кода и аппрувится кем-то из команды инженеров данных.
Если для конкретной роли требуются дополнительные права (например, доступ к определенной таблице в схеме с сырыми данными), они описываются в YAML-файлах dbt-проекта. Это позволяет управлять правами как кодом — с версионированием и возможностью ревью.
Доработка dbt: разделяем среды на одном кластере
Здесь начинается самое интересное — наш подход к средам. Обычно в dbt dev и prod разводят по разным target-ам в profiles.yml, а часто и по разным кластерам. У нас один кластер StarRocks.
При этом разработка и тестирование должны идти изолированно от прода, а копировать продовые данные в dev мы не хотели. Нужно было, чтобы dbt читал данные из продовых схем, а результат записывал в другую.
Стандартный механизм —target эту задачу не решает. dbt формирует зависимости динамически через Jinja-функцию ref(). Если сменить target, ref() начинает указывать на dev-схему не только для изменяемой модели, но и для всех её предков. В итоге в dev приходится пересобирать всю цепочку upstream-моделей, то есть фактически дублировать прод.
Решение проблемы — макрос, который выбирает целевую схему в зависимости от окружения:
-- Псевдокод логики макроса если: переменная окружения задана и (модель явно указана в списке на выполнение либо указан проект): → возвращаем схему из переменной окружения (схема_1, схема_2, ...)иначе: → используем схему по умолчанию из конфига модели (схема_1, схема_2, ...)
Ключевой момент: модели, которые не попали в текущий запуск (не выбраны в dbt run --select ...), остаются в продовой схеме, поэтому ref() указывает на исходные таблицы. В результате запускаемая модель собирается в песочнице, а данные читает из прода.
Дальше достаточно указать макрос в конфигурации:
schema: "{{ имя макроса(model) }}"
В итоге модель автоматически попадает в нужную схему — будь то песочница при локальной разработке, cicd при прогоне в пайплайне или продовая схема (схема_1, схема_2) при запуске на продовом Airflow.
CI без данных: флаг —empty
Для CI нам нужно было проверить, что изменения не ломают проект. Полноценно пересобирать слой витрин на реальных данных при каждом merge request слишком долго и дорого.
Поэтому мы используем флаг —empty, который появился в dbt 1.8. С ним dbt подставляет вместо каждого ref() и source() пустой подзапрос вида (select * from <таблица> where false limit 0). Модели выполняются по-настоящему: SQL компилируется и отправляется в StarRocks, таблицы создаются с правильной структурой. Но данных в них нет, поэтому прогон целого слоя занимает минуты, а не часы.
Чтобы это заработало, понадобились две доработки:
-
Все обращения к таблицам только через ref() и source(). —empty подменяет только их. Если имя таблицы захардкожено в SQL, запрос пойдёт в реальную таблицу со всеми данными. Поэтому мы прописали зависимости во всех моделях без исключения.
-
Патч relation.py. К пустому подзапросу dbt добавляет собственный алиас. Когда в модели после ref() уже стоит свой алиас, например
from {{ ref('orders') }} o, получается двойной алиас и синтаксическая ошибка. Мы отключили автоматический алиас в relation-классе адаптера.
Проверка влияния на зависимости устроена так: в CI мы собираем с флагом —empty весь слой витрин в схему cicd. Если изменённая модель потеряла колонку, переименовала её или сменила тип так, что это ломает потребителей, упадёт какая-нибудь downstream-модель, а вместе с ней и общий пайплайн.
Мониторинг качества данных
На уровне данных мониторинг реализован через тесты в dbt. Зачастую мы проверяем: пустые значения, дублирование строк, уникальные ключи, правильные значения. Все это логируется с помощью библиотеки dbt-elementary и далее отрисовывается в дашбордах, где удобно посмотреть, все ли в порядке. За виртуальными машинами следим через Grafana и Prometheus.
Оркестрация
Когда мы разобрались с хранением и моделями данных, появилась задача выбрать оркестратор, который сможет прозрачно и надежно запускать пайплайны, управлять зависимостями и не требовать ручного вмешательства при каждом сбое. В итоге остановились на связке Airflow и Astronomer Cosmos. Cosmos читает dbt-проект и сам строит из него граф задач в Airflow, так что зависимости между моделями не нужно прописывать вручную.
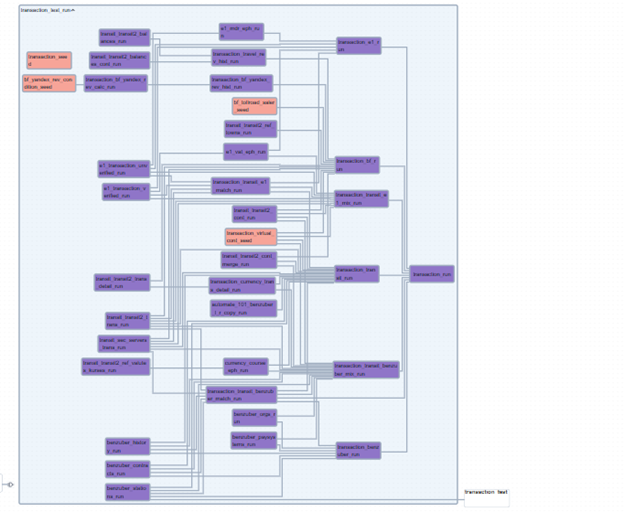
Код DAG-ов хранится в Git, а в прод они попадают через CI/CD.
При появлении нового DAG права на его запуск в продакшене выдаются не конкретному пользователю, а команде. Это упрощает онбординг и управление доступами.
Как мы перестали быть «службой исполнения желаний»
Помимо задачи построить новую аналитическую инфраструктуру, у нас стояла вторая, не менее важная: найти способ работы, при котором не нужно будет масштабировать команду инженеров при росте числа аналитиков.
Поэтому при переходе на StarRocks мы сразу целились не просто в новый движок, а в self-service как культуру.
Мы провели серию обучающих встреч для аналитиков, где показывали процесс от и до. Собрали базу знаний объемом порядка 100 страниц в Confluence. И ввели режим консультаций: любой мог записаться на 30 минут, мы помогали пройти путь первый раз. Энтузиазма у аналитиков было достаточно: они понимали, что умение самостоятельно работать с современным стеком повышает их ценность на рынке.
Но некоторые коллеги все-таки не захотели осваивать self service, и мы оставили им возможность заводить задачи в Jira с ТЗ на создание нужной таблицы или витрины. Эти запросы выстраиваются в бэклог, и все довольно быстро понимают, что самостоятельно работать с данными быстрее.
У аналитиков была понятная мотивация перехода на новую систему работы: автономность, профессиональный рост и скорость выполнения задач. Поэтому за 1,5 года перехода мы не столкнулись с сильным сопротивлением.
Стандартный порядок работы аналитика теперь таков:
-
Находит нужные таблицы и поля через OpenMetadata — каталог данных с описаниями и lineage. Аналитик видит, какие таблицы есть, откуда они взялись, куда ведут.
-
Пишет SQL-код витрины и оформляет его как dbt-модель — с конфигурацией, описанием и тестами. Всё как код: версионируется, тестируется и документируется в Git.
-
Отправляет MR в репозиторий dbt-проекта. Команда данных проверяет код на соответствие стандартам, корректность логики и нейминга. Для снятия рутинных проверок мы готовим проект по AI ревьюеру. При этом до мерджа изменения проходят проверку через CI, которая не тратит ресурсы на полную сборку.
-
Создает DAG на тестовом Airflow, проверяет, что модель корректно собирается и отрабатывает. Отправляет второй MR — уже в репозиторий с DAG’ами.
-
После мерджа обоих MR DAG автоматически появляется на продовом Airflow, запускается по расписанию и создаёт витрину в одной из продовых схем.
Сложности внедрения
Переход на новый стек, конечно, не обошелся без подводных камней. Расскажу про основные:
Коробочное подключение через DBeaver с LDAP не заработало. Совместно с ИБ мы пересобрали коннектор, адаптировав его под нашу инфраструктуру и требования нашей ИБ-политики.
DataLens: подключение к StarRocks. DataLens подключается к StarRocks через штатный MySQL-коннектор, потому что StarRocks совместим с протоколом MySQL. Но из коробки эта связка не заработала, и коннектор в бэкенде DataLens пришлось дорабатывать:
-
адаптировали коннектор под требования нашей ИБ-политики;
-
исправили работу некоторых функций, например DAYOFWEEK;
-
убрали ESCAPE из LIKE: DataLens генерирует условия вида LIKE … ESCAPE …, а StarRocks такой синтаксис не поддерживает.
DataLens: аутентификация и управление доступом. В open source версии DataLens нет ни SSO, ни ролевой модели. Для аутентификации и управления доступом в DataLens мы разработали свое решение: используем корпоративный Identity Provider, который обеспечивает единый вход (SSO) и централизованное управление пользователями и ролями. Пользователи входят под своими доменными учётными записями, а доступ к DataLens выдаётся и отзывается в IAM, без изменений в самом DataLens.
Настройка CI/CD потребовала много времени. Мы сделали так, что при создании Merge Request’а сборка запускается с «нулем данных». Это позволяет проверить синтаксис и зависимости, не тратя ресурсы кластера на прогон по полным данным.
Переписывание и рефакторинг легаси процедур — это настоящая боль, на которую потратили больше всего времени.
Считаем эффекты
-
Сокращение time-to-market. Раньше запрос от бизнеса мог обрабатываться днями, теперь большая часть запросов — от ad-hoc до дашбордов и комплексных анализов — закрывается в течение дня.
-
Ускорение адаптации новых сотрудников. Раньше новый аналитик порядка трех месяцев пытался разобраться в том, что было. Сейчас, с хорошо выстроенной системой, новый сотрудник выходит на эффективность уже в первый месяц.
-
Команда инженеров данных больше фокусируется не на рутинной обработке задач, а на развитии инфраструктуры. Рост нагрузки не требует пропорционального роста команды.
-
Аналитикам интереснее работать с быстрой и удобной базой, где есть нормальная документация, чем часами ждать выполнения запросов и разбираться в legacy. Это влияет и на удержание, и на качество работы.
-
Немаловажно, что мы уложились в заложенный бюджет, получив нужный нам эффект. При выборе стека мы просчитывали и альтернативный вариант — классический, с двумя кластерами. Второй dev-кластер стоил бы примерно как продовый, то есть инфраструктурные расходы и нагрузка на команду выросли бы 1,5-2 раза.
В итоге мы получили быструю, документированную и экономичную платформу — и уложились в бюджет без расширения команды.
ссылка на оригинал статьи https://habr.com/ru/articles/1102082/