Итак, резервные копии готовы, инфраструктура восстановлена, приложение снова отвечает на запросы. Но можем ли мы доверять его ответам? После сбоя ИИ-помощник рискует использовать устаревшие документы, возвращать отозванные права доступа и повторно выполнять действия, которые уже совершил. Разберемся, как избежать таких ошибок при восстановлении RAG-приложения.
Привет, Хабр! На связи Михаил Витко, менеджер PaaS-продуктов Рег.облака. В первой части статьи мы разобрали, какие данные ИИ-помощника нужно включать в резервные копии, что можно восстановить заново и как организовать бэкапы в S3, PostgreSQL и Kubernetes.
Теперь обсудим, как собрать из этих копий работоспособное приложение. Даже если хранилища успешно восстановлены, их данные могут не соответствовать друг другу: поисковый индекс будет содержать старую редакцию документа, а база — уже новую. При откате могут вернуться отозванные права доступа или повторно выполниться действия ИИ-агента.
В этой части соберем согласованный набор для восстановления RAG, проверим документы и индексы, разберем защиту от возврата отозванных прав и покажем, как тестировать восстановление на практике.
Навигация по тексту:
Как не получить сломанный RAG после восстановления из разных копий
Как возникает рассогласование
В 12:00 документ doc-42 имел редакцию 1 со сроком возврата 14 дней. В 12:03 загрузили редакцию 2 со сроком 30 дней. В 12:04 база переключила активную редакцию, а в 12:05 обработчик завершил обновление индекса.
Если взять базу за 12:04 и индекс за 12:00, поиск вернет старый текст. Если взять ещё и файл за 12:05, ссылка на источник откроет новый регламент, который противоречит ответу. Все три хранилища при этом могут успешно проходить собственные проверки целостности.
Другой вариант опаснее: после резервирования у сотрудника отозвали доступ. Откат таблицы разрешений вернул ему прежние права. Восстановление прошло без ошибок, но конфиденциальные документы снова доступны.
Фиксируем идентичность документов и фрагментов
Нужны идентификаторы, которые переживают отказ. Для каждого исходника сохраняем организацию, документ, редакцию, точный ключ или версию S3 и SHA-256. Для фрагмента дополнительно сохраняем chunk_id, хеш текста и pipeline_id — идентификатор конвейера обработки.
В pipeline_id должны однозначно разрешаться версии парсера, правила разбиения, токенизатор, модель эмбеддингов и ее revision, размерность, нормализация и метрика расстояния. Название вроде «модель v1» годится только в том случае, если рядом хранится ее неизменяемая спецификация и доступны все нужные артефакты.
Эти поля записываем в PostgreSQL как каталог ожидаемых фрагментов, а в Qdrant — в payload каждой точки. Хеш текста связывает вектор с конкретным фрагментом. Сами байты векторов защищает контрольная сумма снимка или отдельного экспорта.
В примере вводим поколение корпуса g42: опубликованный набор редакций документов и соответствующая ему коллекция kb_g42. После публикации ее содержимое не меняем. Новые редакции собираем в следующее поколение. Это упрощает восстановление, но требует места под несколько поколений и процедуры их удаления.
Создаем один набор восстановления
Для начала выберем понятную схему с паузой изменений. Это ограничение приложения, а не настройка S3 или PostgreSQL. Без него независимые снимки не становятся согласованными просто потому, что сделаны рядом по времени.
-
Приостанавливаем загрузку и редактирование документов, публикацию поколений и фоновые записи в корпус, включая интеграции в обход API. Отзывы доступа и удаления продолжаем фиксировать в независимом сервисе политик: запрет начинает действовать сразу, а физическое изменение замороженного корпуса можно завершить после копирования. Остальные новые изменения явно отклоняем либо надежно журналируем до подтверждения приема.
-
Дожидаемся завершения уже принятых операций во всех хранилищах. Нельзя считать систему остановленной, пока очередь пуста, но обработчик ещё выполняет запись. Неопубликованные поколения исключаем из активного корпуса и отмечаем для повторной сборки.
-
Фиксируем активное поколение g42, точные редакции документов и каталог фрагментов. Проверяем, что коллекция содержит именно их и все записи завершены.
-
Создаем дамп PostgreSQL и штатный снимок kb_g42, сохраняем файлы и артефакты в резервном контуре. Снимки могут создаваться последовательно: пауза сохраняет неизменность связанного состояния. История диалогов, если запись в нее разрешена, восстанавливается на момент снимка PostgreSQL.
-
Проверяем наличие всех частей и их SHA-256. Последним публикуем манифест со статусом complete. Незавершенный набор не допускаем к восстановлению. После этого снимаем паузу.
Для какой нагрузки подходит пауза и что делать с RPO 15 минут
Схема с паузой подходит для пакетно обновляемой базы знаний, если бизнес допускает окно без новых загрузок и публикаций. Ее предел задается измеренным временем осушения очередей, дампа, снимка, передачи копий и проверки. Универсального порога в гигабайтах нет: одинаковый объем из PDF и коротких текстовых файлов создает разную нагрузку.
Для оценки возьмем только передачу данных: 5 ГиБ при устойчивых 50 МиБ/с — около 1 минуты 43 секунд; 100 ГиБ при той же скорости — примерно 34 минуты. Создание снимка и валидация добавятся сверху. Это расчет, а не замер Рег.облака. Первую схему разумно проверять на корпусе, который помещается в разрешенное окно, и при обновлениях пакетами, например один-два раза в день. При постоянной загрузке документов окно паузы становится отдельным ограничением доступности.
Для RPO важна дата последней завершенной копии в независимом контуре, а не время старта текущей задачи. Если при продолжающихся изменениях запускать копии каждые 10 минут, а их создание и доставка занимают 40 минут, возраст последней защищенной точки перед отказом может приблизиться к 50 минутам даже при параллельных заданиях. Такая схема не обеспечивает RPO 15 минут.
Полная пауза уменьшает число новых принятых изменений, но ценой недоступности загрузки. Ее нельзя выдавать за непрерывную работу с гарантированным RPO. Нельзя и объявлять набор complete, пока его части остаются только на исходной площадке.
Если длинный снимок нужно совместить с RPO до 15 минут, разделяем базовую копию и поток изменений. Опубликованное поколение и его снимок остаются неизменными, а новые документы и диалоги принимаются в журнал с сохранением исходных байтов вне рабочего контура до подтверждения клиенту. Журнал содержит устойчивые ID, порядок изменений, ссылки на редакции и версии конвейера; его операции должны безопасно повторяться. PostgreSQL восстанавливаем подходящим механизмом PITR или воспроизведением прикладных событий, а индекс доводим из сохраненных исходников и эмбеддингов. Один WAL не заменяет сохранение файлов S3.
Тогда отдельно контролируем задержку защищенного журнала и цепочки WAL, последнюю точку, до которой можно воспроизвести все зависимые данные, и время догонки индекса. Если журнал отстает от допустимых 15 минут, система перестает подтверждать новые изменения либо явно теряет заявленную гарантию. Длительность фонового снимка влияет прежде всего на объем последующего воспроизведения и RTO. В этой статье базовая схема проще; журналирование всех изменений — отдельное усложнение для непрерывно обновляемого сервиса.
Манифест — обычный машинно-читаемый каталог набора. Сокращенный пример с условными именами:
{
«backup_id»: «b42»,
«state»: «complete»,
«generation»: «g42»,
«postgres_dump»: «postgres.dump»,
«index_snapshot»: «kb_g42.snapshot»,
«objects_catalog»: «objects.jsonl»,
«chunks_catalog»: «chunks.jsonl»,
«pipeline_id»: «embed-v1-chunk500-overlap50»,
«embedding_dimension»: 768,
«distance»: «cosine»,
«policy_checkpoint»: «policy-98.json»,
«checksums»: «SHA256SUMS»
}
В полном наборе также фиксируем версии серверов, схему БД, digest образов, хеш спецификации конвейера и время снимка базы. Каталоги содержат точные ссылки на версии исходников и полный состав фрагментов. Манифест защищаем от подмены теми же независимыми правами, что и копии. Контрольная сумма рядом с файлом обнаруживает повреждение, но не защищает от атакующего, который может заменить оба.
Статус complete означает, что набор собран и проверен по каталогу. Возможность запустить из него сервис подтверждает отдельное тестовое восстановление.
Проверяем восстановленное состояние до открытия доступа
Сначала разворачиваем приложение без пользовательского трафика, фоновых обработчиков и внешних действий. Восстанавливаем базу и исходники из одного набора, затем соответствующую коллекцию. Последовательность загрузки не создает согласованность — ее задает состав выбранного набора.
Проверяем, что каждый опубликованный документ указывает на существующие байты нужной версии, а SHA-256 совпадает с каталогом. Проверка одного бакета через список текущих ключей недостаточна: может требоваться старая версия объекта. Затем сопоставляем ожидаемые фрагменты в базе с полным экспортом payload восстановленной коллекции.
Например, экспортируем payload всех точек коллекции с пагинацией во временную таблицу restored_index_export. В обеих таблицах колонки ниже имеют одинаковые типы; rag_chunks — каталог фрагментов приложения. Поколение g42 берем из манифеста выбранного набора. Запрос ищет пропуски и лишние записи:
WITH expected AS (
SELECT generation, tenant_id, doc_id, revision,
chunk_id, text_sha256, pipeline_id
FROM rag_chunks WHERE generation = ‘g42’
), actual AS (
SELECT generation, tenant_id, doc_id, revision,
chunk_id, text_sha256, pipeline_id
FROM restored_index_export
)
SELECT ‘missing’ AS problem, FROM (
SELECT FROM expected EXCEPT SELECT FROM actual
) AS missing
UNION ALL
SELECT ‘extra’ AS problem, FROM (
SELECT FROM actual EXCEPT SELECT FROM expected
) AS extra;
Ожидаемый результат — ноль строк. Проверяем и повторы логического ключа фрагмента: EXCEPT работает с множествами и сам по себе дубликаты не выявляет. Сравнение одного количества точек тоже недостаточно. Старые и новые редакции могут содержать одинаковое число фрагментов.
Дополнительно сверяем размерность и метрику коллекции, версию конвейера и модель, которой API векторизует запрос. Даже полностью восстановленный индекс будет искать неправильно, если запросы кодирует другая модель. После структурных проверок запускаем контрольные вопросы с ожидаемыми источниками. Проверять только текст ответа LLM ненадежно: формулировка может измениться без поломки поиска.
Не возвращаем удаленные документы и отозванные права
После отката используем независимый сервис политик. В простом варианте это отдельный небольшой сервис и транзакционная БД вне исходной площадки, с собственными доступами и резервированием. Он хранит текущие запреты и упорядоченный журнал для каждой организации. Событие удаления или отзыва сначала надежно фиксируется здесь; только затем API подтверждает изменение. Асинхронный экспорт раз в час не обеспечивает такой гарантии.
Каждое событие содержит event_id, tenant_id, возрастающий seq, тип запрета, субъект и ресурс. Дополнительно сохраняем хеш события и хеш предыдущего. Сервис выдает доверенную контрольную точку head с последним зафиксированным seq и хешем цепочки. Доступ к журналу и его контрольным точкам отделяем от доступа приложения. Хеши проверяют целостность выгрузки; компрометацию самого сервиса они не устраняют.
Сокращенный пример отзыва доступа:
{
«event_id»: «evt-100»,
«tenant_id»: «tenant-a»,
«seq»: 100,
«type»: «access_revoked»,
«subject_id»: «user-2»,
«resource_id»: «doc-11»
}
В копии b42 применены события по seq=98. При восстановлении запрашиваем доверенный head=101, получаем события 99–101 и проверяем непрерывность последовательности, цепочку хешей и совпадение конечного хеша с head. Поэтому ловим и пропуск события 100 внутри выгрузки, и обрезанный хвост, который заканчивается на 100 вместо 101.
Событие evt-100 добавляет запрет для user-2 на doc-11 в таблицу ограничений поверх восстановленных прав. Применение события и обновление позиции журнала выполняем одной транзакцией, повторный event_id не создает второй эффект. Событие document_deleted аналогично блокирует документ для всей организации. На время открытия доступа ещё раз сверяем актуальный head; последующие запросы используют действующую политику. Удаленные исходники и фрагменты затем очищаем по принятой политике хранения.
Если журнал, доверенный head или его резервная копия недоступны, открывать доступ по старым разрешениям нельзя. Закрываем затронутую организацию до сверки; если область изменений неизвестна, закрываем весь ее корпус. Последовательные номера без независимой конечной контрольной точки не доказывают полноту: последняя часть выгрузки тоже могла потеряться. Срок хранения журнала должен покрывать возраст самой старой допустимой копии и время восстановления.
Проверка прав должна происходить до передачи фрагментов в LLM. Если права продублированы в payload индекса, их также актуализируем; одной старой фильтрации в Qdrant недостаточно. Кэши поиска и ответов очищаем либо переводим в новое пространство ключей, учитывающее поколение и версию прав.
Только после этих проверок переключаем приложение на проверенное поколение. Каждый запрос использует один и тот же идентификатор поколения для метаданных и поиска. Фоновые задания восстанавливаем из авторитетного состояния базы: старую очередь нельзя слепо запускать на новом корпусе. Операции обработки должны выдерживать повторное выполнение, а внешние действия агентов требуют отдельной сверки.
Проверяем восстановление на практике
Проверку разделим на два уровня. Для статьи выполнены 14 локальных проверок логики на Python 3.12.14, SQLite 3.53.1 и файловых фикстурах. Каталог индекса представлен payload-записями без векторов, а внешний исполнитель — отдельной SQLite-базой с уникальным ключом операции. PostgreSQL, Qdrant, облачный S3 и LLM в этом прогоне не запускались. Ниже приведены фактические результаты этих проверок; полноценное восстановление в Рег.облаке требует отдельного прогона.
Что уже проверено локально
Все 14 проверок завершились успешно, включая отрицательные случаи: для них успех означает обнаружение ошибки и запрет публикации состояния. Код и results.json приложены к материалу; повторный запуск — python3 test_recovery.py.
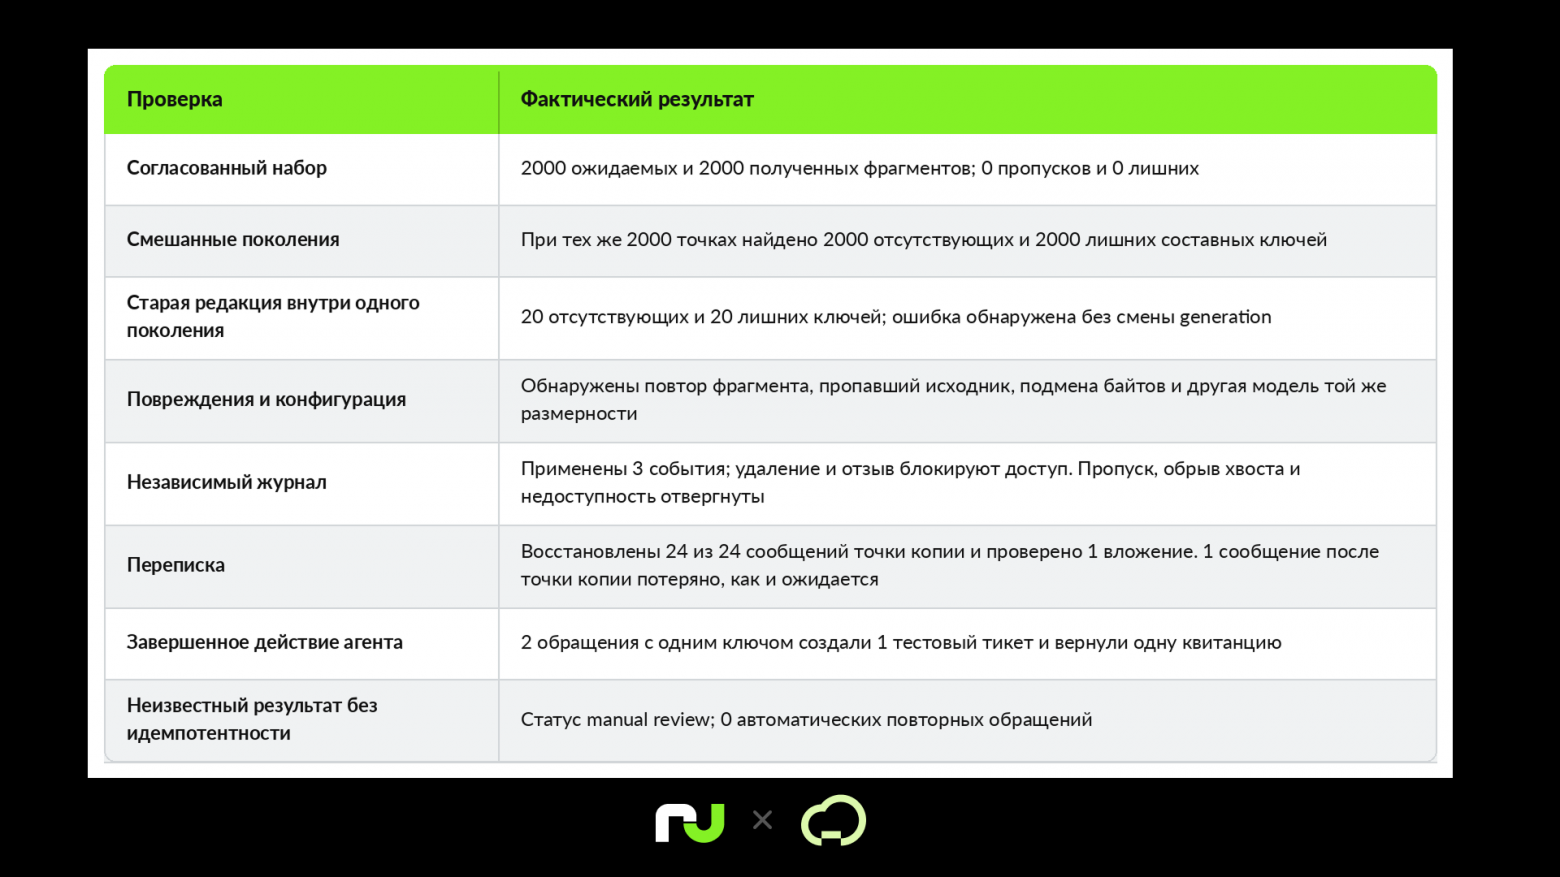
Из этого следует конкретный вывод: равенство количества записей не подтверждает согласованность RAG, а откат прикладного статуса не требует повторять внешний эффект, если сохранен ключ и исполнитель поддерживает идемпотентность. Тест переписки также показывает границу копии: сообщение, подтвержденное после нее, логический дамп не вернет. Эти выводы относятся к проверенной модели; задержки сети, WAL и загрузку настоящего индекса нужно измерять отдельно.
Далее — сценарий интеграционного отказа для Рег.облака, с ожидаемыми результатами. Исходный стенд должен быть недоступен восстановленному приложению, а новое окружение получает только независимые копии и доступ к действующему сервису политик.
Подготовка
Создаем 100 тестовых текстовых документов двух организаций, по 50 каждой. Для воспроизводимой проверки каталога заранее задаем по 20 фрагментов на документ: всего 2000. В нескольких документах размещаем уникальные контрольные факты. Для вопросов фиксируем ожидаемые doc_id и редакции в top-10 результатов поиска; сам набор сначала должен пройти эти проверки до отказа.
Публикуем g42 и создаем набор b42. Затем в первой организации меняем срок возврата в doc-42 с 14 на 30 дней, сохраняя 20 фрагментов. Удаляем doc-7, добавляем doc-101 с 20 фрагментами и отзываем у пользователя доступ к doc-11. Удаление и отзыв записываем также в независимый журнал.
Публикуем g43 и создаем полный набор b43. Число активных документов и фрагментов остается прежним: 100 и 2000. Поэтому проверка только количества записей не отличит эти поколения.
Отказ и два варианта восстановления
Восстанавливаем стенд с нуля, используя только сохраненные артефакты и инструкции. Исходные сервисы должны быть недоступны: иначе тест может незаметно прочитать недостающие данные из старого окружения. Обработчики и исходящие действия выключены.
В первом прогоне намеренно смешиваем дамп PostgreSQL из b43 и снимок коллекции из b42. Задача проверки — заблокировать публикацию этого состояния. Во втором прогоне восстанавливаем все компоненты из b43 и допускаем сервис к функциональным тестам только после проверки согласованности.
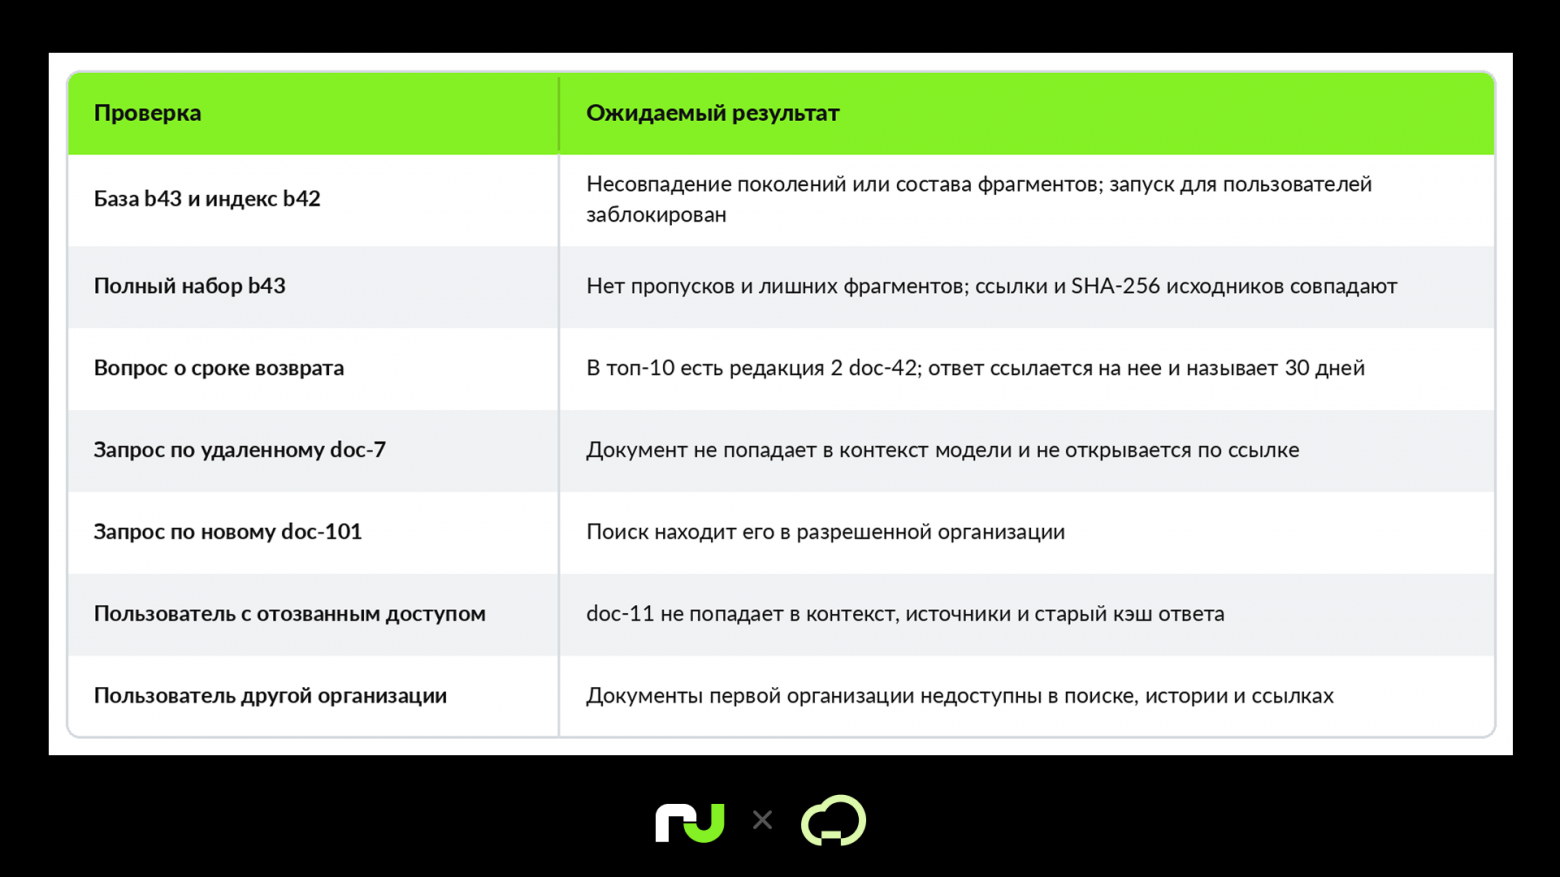
Добавляем отрицательные прогоны: удаляем один объект из тестовой восстановленной копии, подменяем редакцию файла при том же ключе, включаем другую модель эмбеддингов той же размерности. Каждый прогон должен завершаться ошибкой соответствующей проверки, а не открытием частично исправного сервиса.
Отдельно восстанавливаем старый согласованный набор b42. Его каталог и контрольные суммы могут пройти проверку, но независимый журнал всё равно должен заблокировать doc-7 и отозванный доступ к doc-11. Отсутствие doc-101 и старую редакцию doc-42 учитываем как откат содержимого; допустимость такого состояния определяется RPO и требованиями продукта.
Проверка переписки
До резервирования создаем три диалога по восемь сообщений, одно — со ссылкой на вложение. Сохраняем ID, организацию, роли, порядок, текст и SHA-256 вложения. После точки копии добавляем ещё одно подтвержденное сообщение и восстанавливаем базу из этой копии. Проверяем точное совпадение 24 исходных сообщений, порядок и доступность вложения; запрос другой организации не должен вернуть переписку. Последнее, 25-е сообщение, отсутствует: для его сохранности нужны более свежая точка PITR или независимый журнал сообщений. В локальном прогоне получен именно этот результат.
Проверка завершенного действия агента
До копирования записываем намерение создать тикет с ключом tenant-a:act-007 и статусом pending. После копирования исполнитель создает тикет и возвращает квитанцию ticket-1; затем имитируем отказ. Восстановленная база снова видит pending, но обращается к исполнителю с тем же ключом. Он возвращает ticket-1, не создавая второй тикет. В локальном тесте при двух обращениях эффект был один.
Этот результат зависит от контракта внешнего API. Срок хранения ключей у исполнителя должен покрывать возраст восстановленной копии и возможные повторы. Если ключ потерян, его срок истек или исполнитель не поддерживает идемпотентность, автоматически повторять действие нельзя: сначала сверяем квитанцию или внешний статус, иначе переводим операцию в ручную проверку. В локальном отрицательном тесте такой случай дал manual_review и ноль повторных обращений.
Что измеряем
Записываем момент отказа и момент, когда восстановленный сервис прошел проверки и готов принять трафик. Между ними учитываем обнаружение, получение доступа к копиям, развертывание, передачу данных, загрузку индекса, сверку прав и тесты. Отдельно фиксируем время каждого этапа, чтобы понимать причину задержки.
Для RPO сверяем журнал принятых изменений с восстановленным состоянием: какие документы и сообщения потеряны и какой период они покрывают. Интервал между запуском резервных заданий сам по себе этого не доказывает. Цель вроде «RPO до 15 минут, RTO до часа» становится подтвержденной только после успешного прогона с подходящим объемом данных.
Стенд из 100 документов проверяет корректность процесса. По его времени нельзя обещать RTO для миллиона фрагментов. Для такой оценки нужен отдельный прогон на сопоставимом объеме, с теми же ограничениями API, сети и дисков.
Чек-лист: готов ли ИИ-помощник к восстановлению
-
Определены RPO и RTO для документов, диалогов и состояния агентов.
-
У каждого документа есть точная редакция исходника, у каждого фрагмента — устойчивый идентификатор и связь с ней.
-
Сохранены версии парсера, разбиения, моделей, промптов, схемы базы и образов приложения.
-
Есть полный набор восстановления с защищенным манифестом, каталогами и контрольными суммами.
-
Жизненный цикл объектов не удаляет данные раньше, чем истечет срок хранения связанных копий.
-
Копии, ключи расшифрования и доступ к ним переживают выбранный сценарий отказа; права приложения не позволяют удалить копии.
-
Восстановление блокируется при несовпадении поколений, версий, файлов или фрагментов.
-
Актуальные удаления и отзывы прав применяются до передачи документов в LLM.
-
Кэши и фоновые задания не возвращают старые ответы, доступы или уже выполненные действия.
-
Сервис восстановлен на отдельном стенде; проверены источники ответов, границы организаций и фактическая потеря данных.
-
Возраст последней завершенной копии и защищенного журнала укладывается в RPO; длительность снимка не подменяет эту проверку.
-
Журнал политик проверен до доверенного head; при пропуске или недоступности доступ закрывается.
-
Переписка сверяется по содержимому и порядку; действия агента сверяются по устойчивому ключу и квитанции.
Начать можно с инвентаризации данных, измеренной пересборки и одного согласованного набора. Затем провести отказ на отдельном стенде и проверить, что приложение отказывается работать со смешанными версиями. Именно этот тест показывает, достаточно ли имеющихся копий для восстановления помощника.
На этом завершаем разбор. Надеемся, материал поможет подготовить ИИ-приложение к возможным сбоям и сделать восстановление предсказуемым. Спасибо, что дочитали до конца! Буду рад вашим вопросам и комментариям.
ссылка на оригинал статьи https://habr.com/ru/articles/1103018/