Какая страница вашего сайта важнее: /catalog/ или статья в блоге двухлетней давности? Пока страниц пятьдесят, на этот вопрос отвечает интуиция. Когда их пять тысяч — интуиция молчит, а структура ссылок превращается в то, что никто в компании целиком не видел: меню ведёт в каталог, блог ссылается на фильтры, фильтры — друг в друга, и где-то в этом клубке есть страницы, до которых внутренний вес добирается по щепотке.
У этой задачи есть старый числовой ответ — PageRank. Не тот, по которому Google ранжирует весь интернет, а его домашняя версия: посчитать веса только по внутренним ссылкам одного сайта. Я написал инструмент, который делает это от краула до отчёта, и в этой статье разберу, как устроена математика, какие грабли собираются по дороге и что из отчёта реально выжимается.
Сразу для прозрачности: инструмент мой, он платный, есть бесплатная редакция с лимитами. Но статья — про методику: формулы, нормировку и интерпретацию можно воспроизвести и своим скриптом, и я покажу, как.
Задача: измерить «важность», а не угадывать её
Внутренняя перелинковка — странный угол SEO: все с ней работают, почти никто её не измеряет. Типичный цикл: сеошник открывает сайт, видит «плохо связаны разделы», просит разработчика добавить пару ссылок, все довольны. Проблема в том, что решение принимается по трём-пяти страницам, которые случаем попали в поле зрения, а эффект не проверяется ничем.
Графовая постановка честнее. Сайт — это ориентированный граф: страницы — вершины, внутренние ссылки — рёбра. «Важность» страницы в таком графе — это то, сколько ссылочного веса к ней притекает по всем путям. У этой величины есть классическое определение, и оно не требует ничего выдумывать.
Математика: классический PageRank, но по-домашнему
Формула — учебная, та же, что у оригинального PageRank:
W(A) = (1 − d) + d · Σ W(Ti) / C(Ti)
Страница A получает вес от всех страниц Ti, которые на неё ссылаются, — но каждая делит свой вес поровну между всеми своими исходящими внутренними ссылками (их число — C(Ti)). Доля d = 0.85 передаётся дальше, остальное выдается всем понемногу как базовая величина. Итерации повторяются до сходимости.
Две детали превращают абстракцию в рабочий инструмент.
Первая — нормировка. Средний вес по сайту приводится к 1.0, и числа начинают читаться без калькулятора: 1.0 — обычная страница, 3.0 — втрое сильнее средней, 0.2 — почти невесомая. В отчёте рядом лежит «Доля, %» — сколько процентов суммарного веса сайта держит страница.
Вторая — тупики. Страница без исходящих внутренних ссылок (dangling page) в наивной реализации просто теряет вес — он «вытекает» из системы, и числа медленно сползают. Поэтому вес тупиков на каждой итерации возвращается сайту равномерно. Вот ядро реальной реализации из моего инструмента — цикл итераций почти дословно:
for step in range(iterations): dangling = sum(weights[i] for i in range(n) if out_deg[i] == 0) base = (1 - damping) + damping * dangling / n new = [base] * n for j in range(n): s = 0.0 for i in in_idx[j]: s += weights[i] / out_deg[i] new[j] += damping * s delta = sum(abs(new[i] - weights[i]) for i in range(n)) weights = new if delta < tol * n: break
Никаких библиотек линейной алгебры — на сайтах до десятков тысяч страниц этого достаточно: один полный пересчёт на графе из 2000 страниц и ~79 тысяч ссылок занимает порядка полсекунды (условный пример с реального обхода; у вас будет зависеть от плотности графа).
Как это читается на практике — условный пример интернет-магазина на тысячу страниц: главная обычно набирает 8–12 (на неё ссылается каждая страница через логотип), каталоги верхнего уровня — 2–4, карточки товаров — 0.3–0.8 в зависимости от того, из скольких мест на них ссылаются, а страница третьего уровня вложенности, на которую ведёт одна-единственная ссылка из подвала, — 0.1. Никакое из этих чисел не «хорошее» или «плохое» само по себе: плохо — когда карточка, которая должна продавать, весит 0.2, а её соседка по фильтру — 3.0. Диспропорция, а не абсолютное значение, — вот что ищут в отчёте.
Краулер: из HTML в граф
До итераций граф надо собрать. Здесь скучная, но решающая часть — нормализация URL: http://x, https://www.x/ и x/#fragment обязаны схлопываться в одну вершину, иначе в графе появятся близнецы, которые делят вес между собой. Второе решение — откуда брать вершины: только по ссылкам (тогда виден честный сайт глазами краулера) или ещё из sitemap.xml (тогда всплывают сироты — страницы, на которые внутри сайта никто не ссылается).
Третья деталь, без которой веса врут, — меню и футер. Сквозные блоки ссылаются на одни и те же страницы с каждой из тысяч страниц, и если их не отфильтровать, весь вес стечется к навигационным разделам. Решение — считать ссылки только внутри контентной области:
# считать только ссылки внутри контента, не меню и футерpython pageweight.py https://example.com --content-selector "main, .content, article"
Пара рабочих рецептов из документации:
# аккуратный обход большого сайтаpython pageweight.py https://example.com -n 20000 --threads 6 --delay 0.2# найти страницы, на которые никто не ссылается (по sitemap)python pageweight.py https://example.com --sitemap# проверить внешние ссылки на 404 и мёртвые доменыpython pageweight.py https://example.com --check-external
Задержка между запросами — не украшение: параллельный обход без пауз некоторые хостеры встречают блокировкой, и вопрос «почему 403» — это сначала вопрос к политике хоста, а потом уже к краулеру.
Отдельного упоминания стоит анти-ботовая защита. Если сайт отвечает краулеру страницей-вызовом («One moment, please…» с джаваскриптом, который должен вычислить проходную куку), обойти это честным HTTP-запросом нельзя — и не надо: правильный маршрут — открыть сайт в своём браузере, пройти проверку и передать краулеру куки сессии одним параметром. Инструмент при этом распознаёт страницу-вызов по отпечатку и говорит об этом прямо, а не выдаёт её за контент.
Что в отчёте и что с этим делать
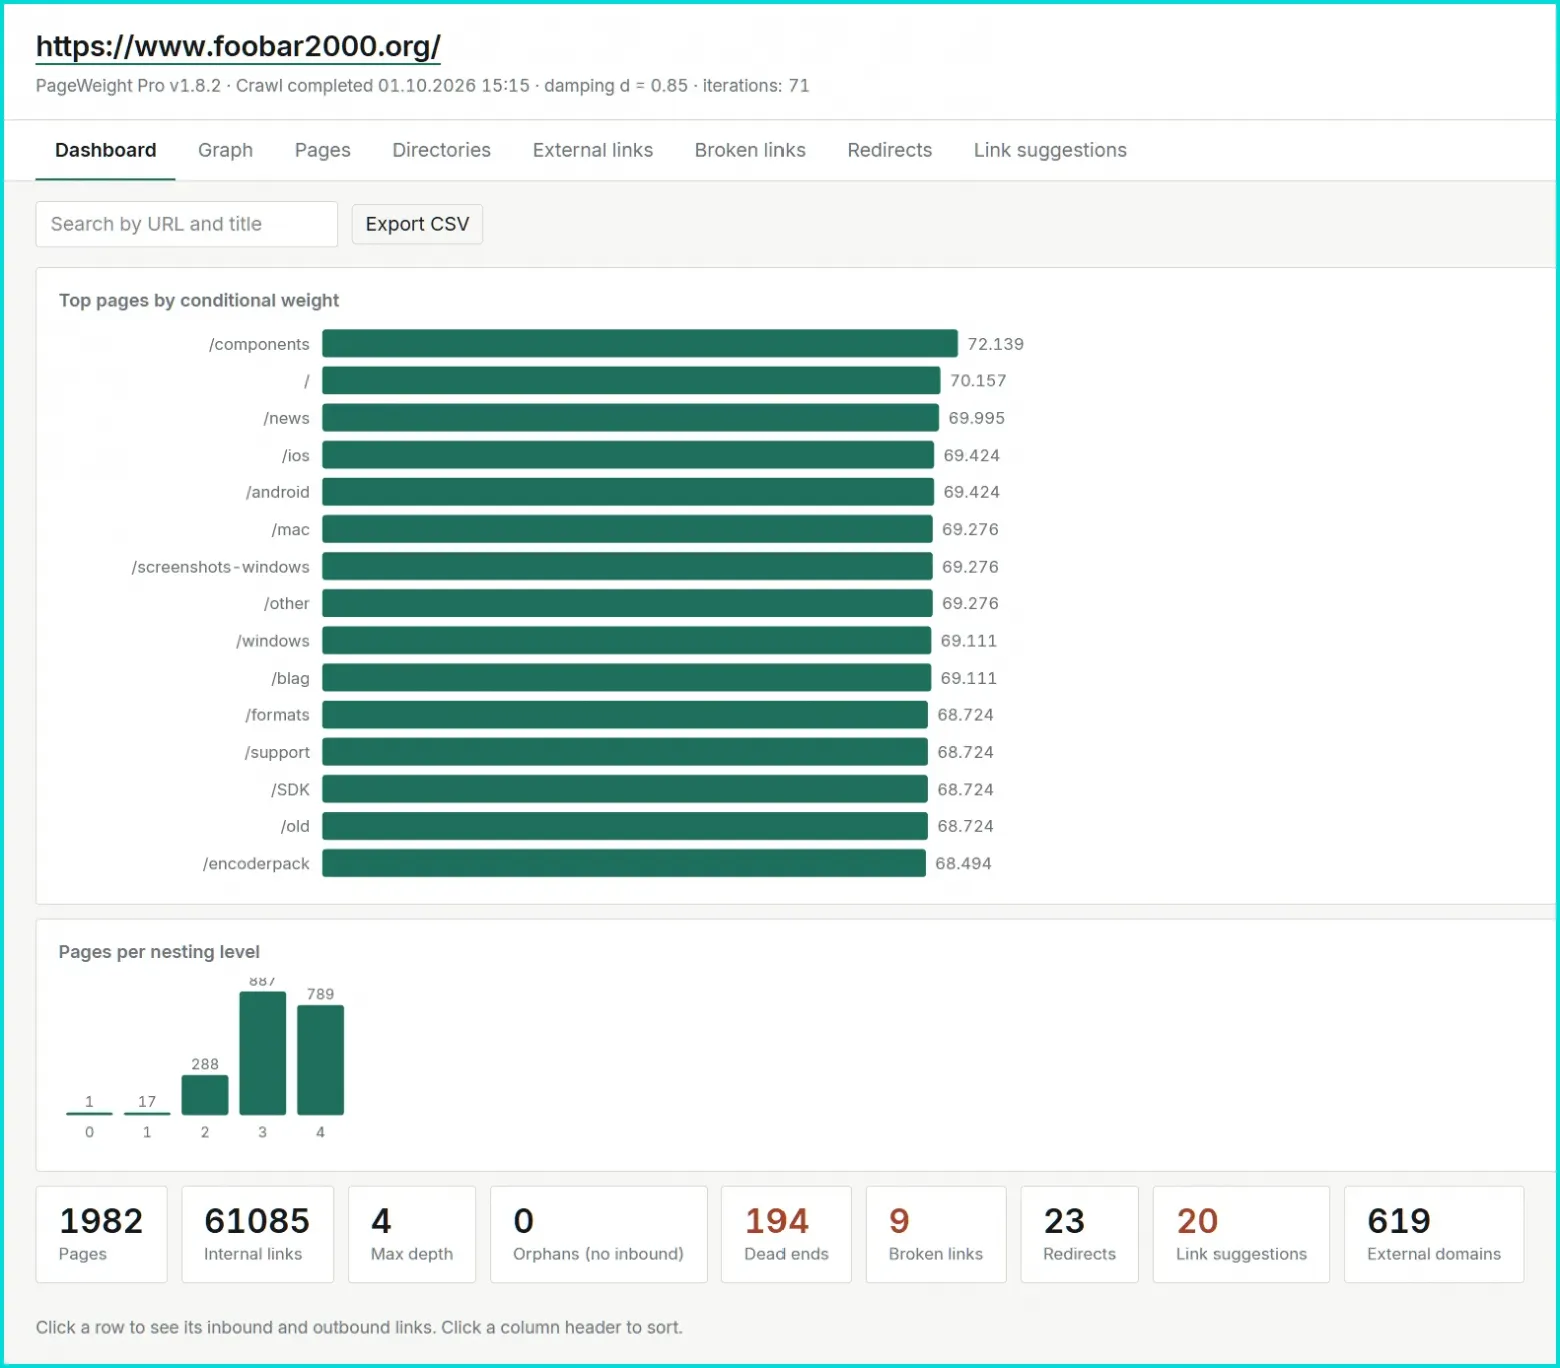
На выходе — интерактивный HTML-отчёт (дашборд с KPI, силовой граф ссылок, таблицы страниц, каталогов, внешних и битых ссылок, перенаправлений) плюс CSV по каждому разрезу и полный graph.json для собственных скриптов.
Читать отчёт обычно начинают с четырёх мест:
-
Сироты (нулевое число входящих ссылок) — страница существует, но веса не получает: либо ссылаться, либо убирать из индекса.
-
Тупики — страница вес собирает, дальше не отдаёт: добавить ссылки на смежные разделы.
-
Уровень «—» — до страницы нельзя добраться ссылками с главной, она найдена только через sitemap.
-
Сортировка по весу против бизнес-приоритетов: коммерческая посадочная на 40-м месте по весу — это не статистика, это план работ по перелинковке.
Ещё два разреза отчёта экономят часы при разборе чужого сайта. Перенаправления показывают цепочки и их итоговые адреса — и вдобавок http://-версии страниц живут в графе отдельными вершинами (если хостер не настроил редирект, вы увидите удвоение веса на близнецах — это диагноз сайту, а не бага подсчёта). Битые ссылки сразу привязаны к донорам: не просто «404 существует», а «на этой странице, этим анкором, вот сколько раз».
Симуляция перелинковки до её внедрения
Самое практичное в подходе: добавление ссылки можно посчитать до того, как трогать сайт. Берём кандидата «донор → акцептор», добавляем ребро в граф, пересчитываем веса, смотрим дельту. В моём инструменте это встроено в отчёт: рекомендации по добавлению и сокращению ссылок, у каждой — ожидаемый эффект.
Две оговорки, без которых это превращается в самообман.
Первая — бюджет пересчётов. Наивный перебор «а что если добавить каждую из сотен ссылок» умножает полсекунды на сотни. Поэтому на каждый кандидат — один пересчёт с базовыми весами (первое приближение: ожидаемый выигрыш ≈ d · W(донор) / (исходящих + 1)), полный подсчёт — только для отобранных пар. Выше порога в 2500 страниц отчёт честно помечает числа как оценку, а не симуляцию.
Вторая — закон сохранения. Суммарный вес сайта фиксирован (это свойство нормировки), перелинковка его не увеличивает — она перераспределяет. Формулировка «поднимем вес сайта» — маркер непонимания: поднимается вес конкретных страниц за счёт других. Инструмент, который рисует только рост и не показывает, у кого вес отнялся, врёт хотя бы умолчанием.
Где LLM, а где математика
Математика отвечает, кто на кого должен ссылаться и сколько это даст. Она не отвечает на два вопроса: уместна ли ссылка по смыслу и каким текстом её оформить. Это естественно отдаётся языковой модели — но с жёсткой рамкой: в модель уходит не граф, а только отобранные пары URL с короткими выдержками текста, и решение модели ограничено «принять пару / отклонить / написать анкор». Структурно она не может придумать цель ссылки — список целей задан входом. Разделение получилось неожиданно удобным: детерминированное ядро воспроизводимо, а нейросеть занимает ровно тот участок, где «правильно» — это суждение, а не вычисление.
Честные ограничения
-
Ссылки берутся из отданного HTML, JavaScript не исполняется. SPA потребует рендеринга — в моём коде это точка замены
requestsна Playwright в одном методе, но из коробки — нет. -
Вес считается только по внутренним ссылкам. Внешние бэклинги не участвуют — это осознанная рамка: инструмент про структуру, которую вы контролируете.
-
Абсолютные веса двух разных обходов несравнимы: меняется число найденных страниц — сдвигается вся шкала. Сравнивать надо долю в процентах и позицию в сортировке.
-
Корреляция веса с позициями не гарантирована и не обещается. Это инструмент расстановки приоритетов: он показывает, где структура противоречит вашим намерениям, а не заменяет остальные факторы ранжирования.
Инструмент
Всё описанное собрано в PageWeight: один файл на Python плюс графический интерфейс, отчёты описанного формата, симуляция перелинковки, LLM-обработка рекомендаций. Бесплатная редакция ограничена обходом (2 потока, 999 страниц, задержка 0 или 0.5 с) и не пишет файлов на диск; платная снимает лимиты и добавляет отчёты в файл.
Страница проекта: pageweight.adviko.com.
Но повторю главное: ценность не в конкретном exe-шнике, а в постановке. Веса страниц по внутренним ссылкам — измеримая величина с пятидесятилетней историей, и она заслуживает места в техпроцессе рядом с позициями и трафиком.
А как вы сейчас решаете, какие страницы сайта усиливать перелинковкой, — на глаз или по числам? Если по числам — интересно, какими.
ссылка на оригинал статьи https://habr.com/ru/articles/1103300/