Вот над чем стоит подумать: баги не редки, редки порядки событий, которые их вызывают. Что я имею в виду?
Начнём с простой истории. Когда я работал в AWS над RDS (Relational Database Service), мы строили управляющий слой сервиса на воркфлоу, разумеется, на SWF (Simple Workflow). Воркфлоу выполняли последовательность шагов, чтобы создать, изменить или удалить инстанс базы данных. Время от времени мы видели нечто невозможное: воркфлоу будто бы выполнял шаги не по порядку.
На самом деле мы наблюдали паузу. Воркер брал шаг и останавливался на неожиданно долгое время. Пока он стоял, он не слал heartbeat, поэтому SWF решал, что воркер умер, и передавал шаг другому. Новый воркер завершал шаг, и воркфлоу шёл дальше. А потом первый воркер просыпался. Насколько он мог судить, времени не прошло, поэтому он продолжал выполнять свой шаг и оставлял после себя хаос.
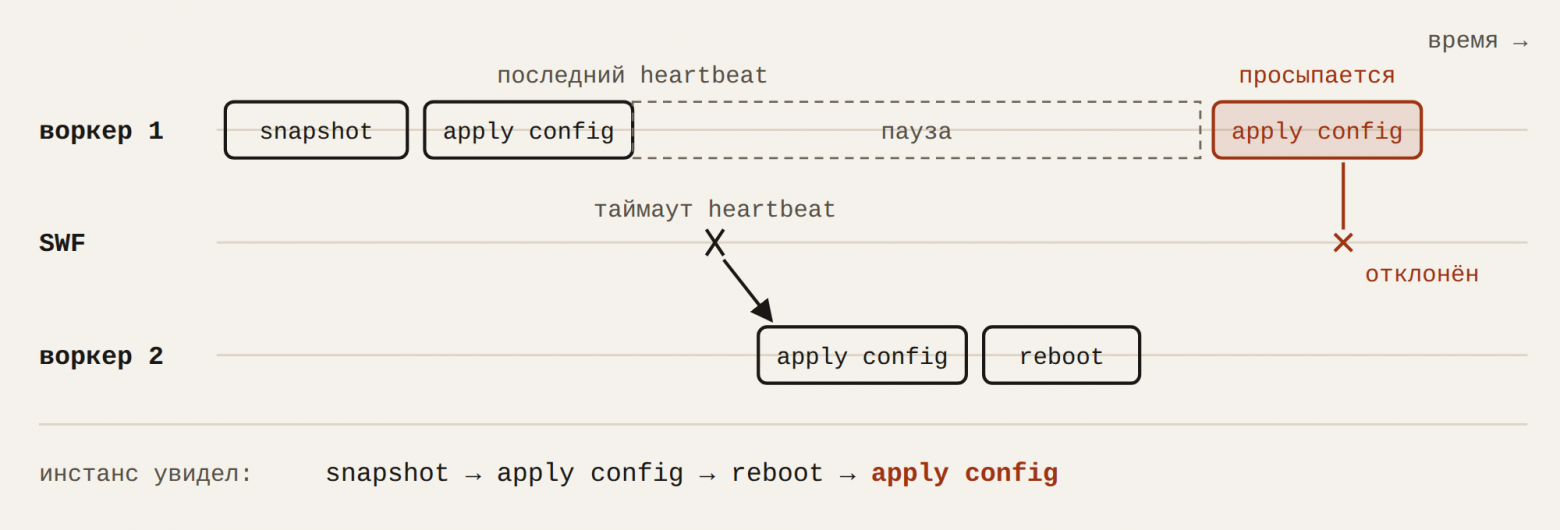
Мы вдруг поняли, что недостаточно тестируем возможные расписания событий. Код воркфлоу был правильным, но расписание, вызвавшее баг, в наших тестах ни разу не встречалось. Редким было расписание, а не баг. Так мы начали добавлять токены идемпотентности к каждому шагу и следить, чтобы любой шаг можно было выполнить несколько раз, ничего не сломав. Работы было много, но система стала гораздо надёжнее.
Зачем эта история?
Я делаю Rewind VM, детерминированную виртуальную машину. Она помогает находить баги в программах главным образом тем, что запускает один и тот же код при множестве разных расписаний. (Я намеренно говорю расписание, а не чередование потоков. Большинство багов на той странице — гонки между процессами либо между процессом и сигналом. Лишь несколько случаются между двумя потоками одной программы.) Одно только перемешивание расписания уже нашло много багов.
Проверяемые программы даже не распределённые системы, как воркфлоу из истории выше, и всё же многие баги зависят от расписания. Никакого безумного набора тестов в духе Jepsen не нужно. Как такое возможно? У всех этих проектов есть тесты, которые проверяют код при каждом изменении. Почему перемешивание расписания находит столько багов, которых все эти тесты так и не нашли?
Баги встречаются часто, редки как раз расписания, которые выполняются в ваших тестах. Простаивающая быстрая машина почти каждый раз прокручивает одну и ту же горстку порядков. Тест проходит, потому что порядок не меняется, и код, возможно, вообще умеет обрабатывать только этот один порядок.
Отступление. Впервые слышите о Rewind? Начните с a flaky build you only catch once и dafuq is a deterministic VM?
Чтобы такие баги сработали, нужны другие расписания или непредвиденно долгие паузы, как в истории с воркфлоу. Баги не редки, но редки расписания, которые их вызывают. Насколько редки?
Самая маленькая гонка, которую я знаю, — это counter++ из двух потоков.
long counter;void increment(void) { counter++;}
increment: mov rax, [counter] ; load add rax, 1 ; add mov [counter], rax ; store ret
Два потока выполняют increment по одному разу. Три шага каждого потока идут по порядку, но сами потоки могут чередоваться. Порядок определяется выбором того, какие 3 из 6 позиций принадлежат потоку A, так что их C(6, 3) = 20.
Эти 20 вариантов можно представить как пути на решётке. Шаг вправо — шаг потока A, шаг вниз — шаг потока B, а каждый путь из левого верхнего угла в правый нижний — один порядок.
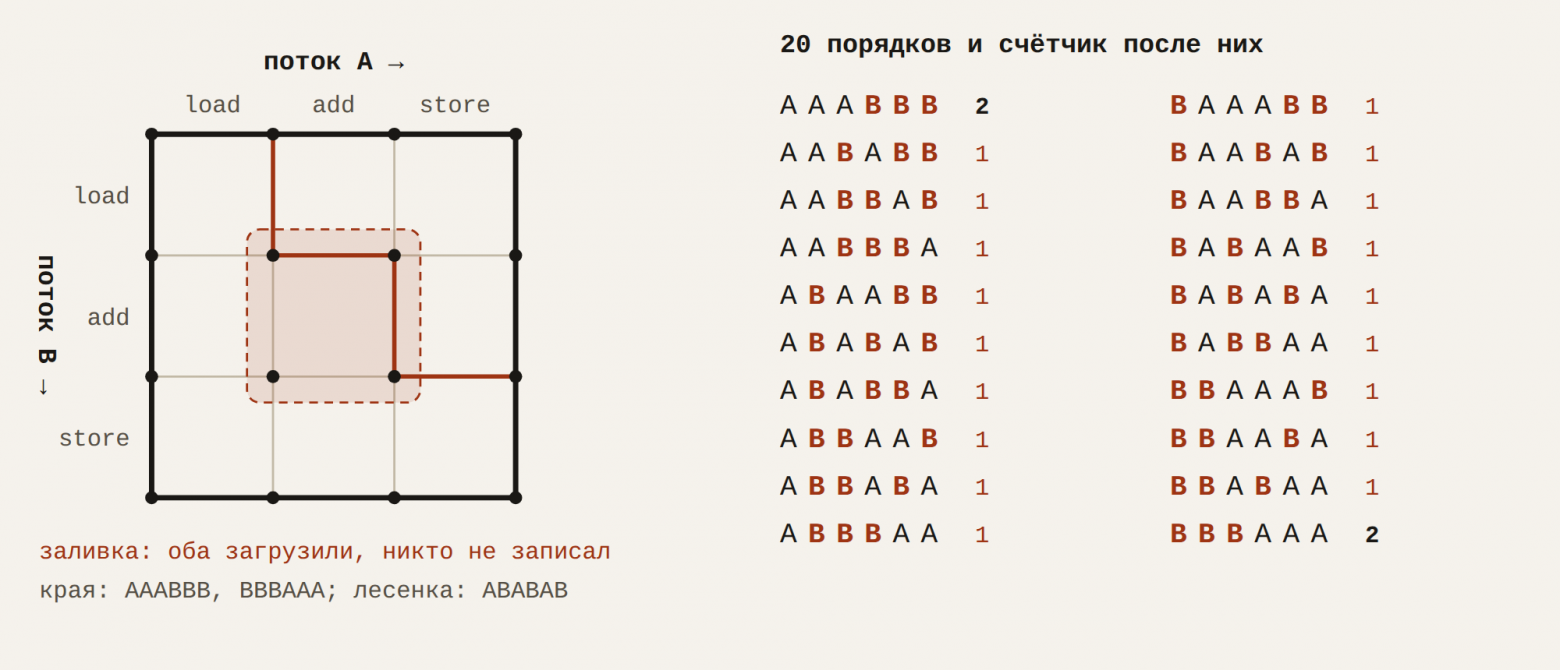
Закрашенный квадрат содержит четыре точки, в которых оба потока загрузили счётчик и ни один его ещё не записал. Любой путь, зашедший в него, заканчивается значением счётчика 1: второй записывающий поток сохраняет устаревшее исходное значение.
Только два пути вдоль краёв дают «правильный результат» 2: A целиком раньше B или B целиком раньше A. Значит, в 18 порядках из 20 обновление теряется. Будь все порядки равновероятны, эта гонка срабатывала бы в 9 запусках из 10.
Как это выглядит на настоящей машине?
Напишем маленькую программу, которая запускает два потока и записывает порядок их шагов. Она немного сложнее простого counter++, потому что должна записывать порядок шагов и при этом сама не вносить новых гонок. Программа использует rewind_point() из Rewind, чтобы дать Rewind VM место для переключения потоков. (Есть и версия с барьером: потоки намеренно сталкиваются, чтобы гонка стала ещё вероятнее.)
race.c
/* * Two threads each add one to a shared counter in three steps: load the * counter, add one, store it back. No lock, so a thread that runs between * the other's load and store writes a stale value over it. * * Each step first takes the next slot of a shared atomic sequence and * writes its thread's letter there, so the program prints the order the * six steps ran in, such as AABABB, and the final counter. * * rewind_point() between the steps gives Rewind VM a place to switch * threads. main() calls it once before the threads start, so the one * failed open it makes outside Rewind happens there; on the host the * points inside the threads are a load and a branch. * * Built with -DSTART_BARRIER, both threads wait on a barrier before the * first step, so they start as close together as the host allows. * * The exit status encodes the outcome so `rewind check` reports it * without reading output: ordering index (0..19) * 2 + (1 if an update * was lost). */#include <pthread.h>#include <stdatomic.h>#include <stdio.h>#include <string.h>#include "rewind.h"enum { THREADS = 2, STEPS = 3, MARKS = THREADS * STEPS };static volatile long counter;static atomic_int next_mark;static char order[MARKS + 1];#ifdef START_BARRIERstatic pthread_barrier_t start;#endif/* Record that thread `who` is taking its next step. */static void mark(char who){order[atomic_fetch_add(&next_mark, 1)] = who;}static void *increment(void *arg){char who = *(const char *)arg;#ifdef START_BARRIERpthread_barrier_wait(&start);#endifmark(who);long seen = counter; /* load */rewind_point();mark(who);seen = seen + 1; /* add */rewind_point();mark(who);counter = seen; /* store */return NULL;}/* The index of `s` among the 20 orderings of AAABBB, in sorted order. */static int ordering_index(const char *s){int index = 0;for (int a = 0; a < 64; a++) {char candidate[MARKS + 1];int as = 0;for (int i = 0; i < MARKS; i++) {candidate[i] = (a >> (MARKS - 1 - i)) & 1 ? 'B' : 'A';as += candidate[i] == 'A';}candidate[MARKS] = '\0';if (as != STEPS) {continue;}if (strcmp(candidate, s) == 0) {return index;}index++;}return -1;}int main(void){static const char names[THREADS] = { 'A', 'B' };pthread_t threads[THREADS];/* Open /dev/rewind, or find it missing, before any thread runs. */rewind_point();#ifdef START_BARRIERpthread_barrier_init(&start, NULL, THREADS);#endiffor (int i = 0; i < THREADS; i++) {pthread_create(&threads[i], NULL, increment, (void *)&names[i]);}for (int i = 0; i < THREADS; i++) {pthread_join(threads[i], NULL);}int lost = counter != THREADS;printf("%s %ld\n", order, counter);return ordering_index(order) * 2 + lost;}
Я запустил каждую по 10 000 раз на своём ноутбуке с Ryzen 7 7840U и 16 простаивающими аппаратными потоками.
$ for i in $(seq 10000); do ./race; done | sort | uniq -c | sort -rn 9985 AAABBB 2 15 BBBAAA 2$ for i in $(seq 10000); do ./race-barrier; done | sort | uniq -c | sort -rn 9957 BBBAAA 2 39 AAABBB 2 2 BBAAAB 1 1 BAAABB 1 1 BAABAB 1
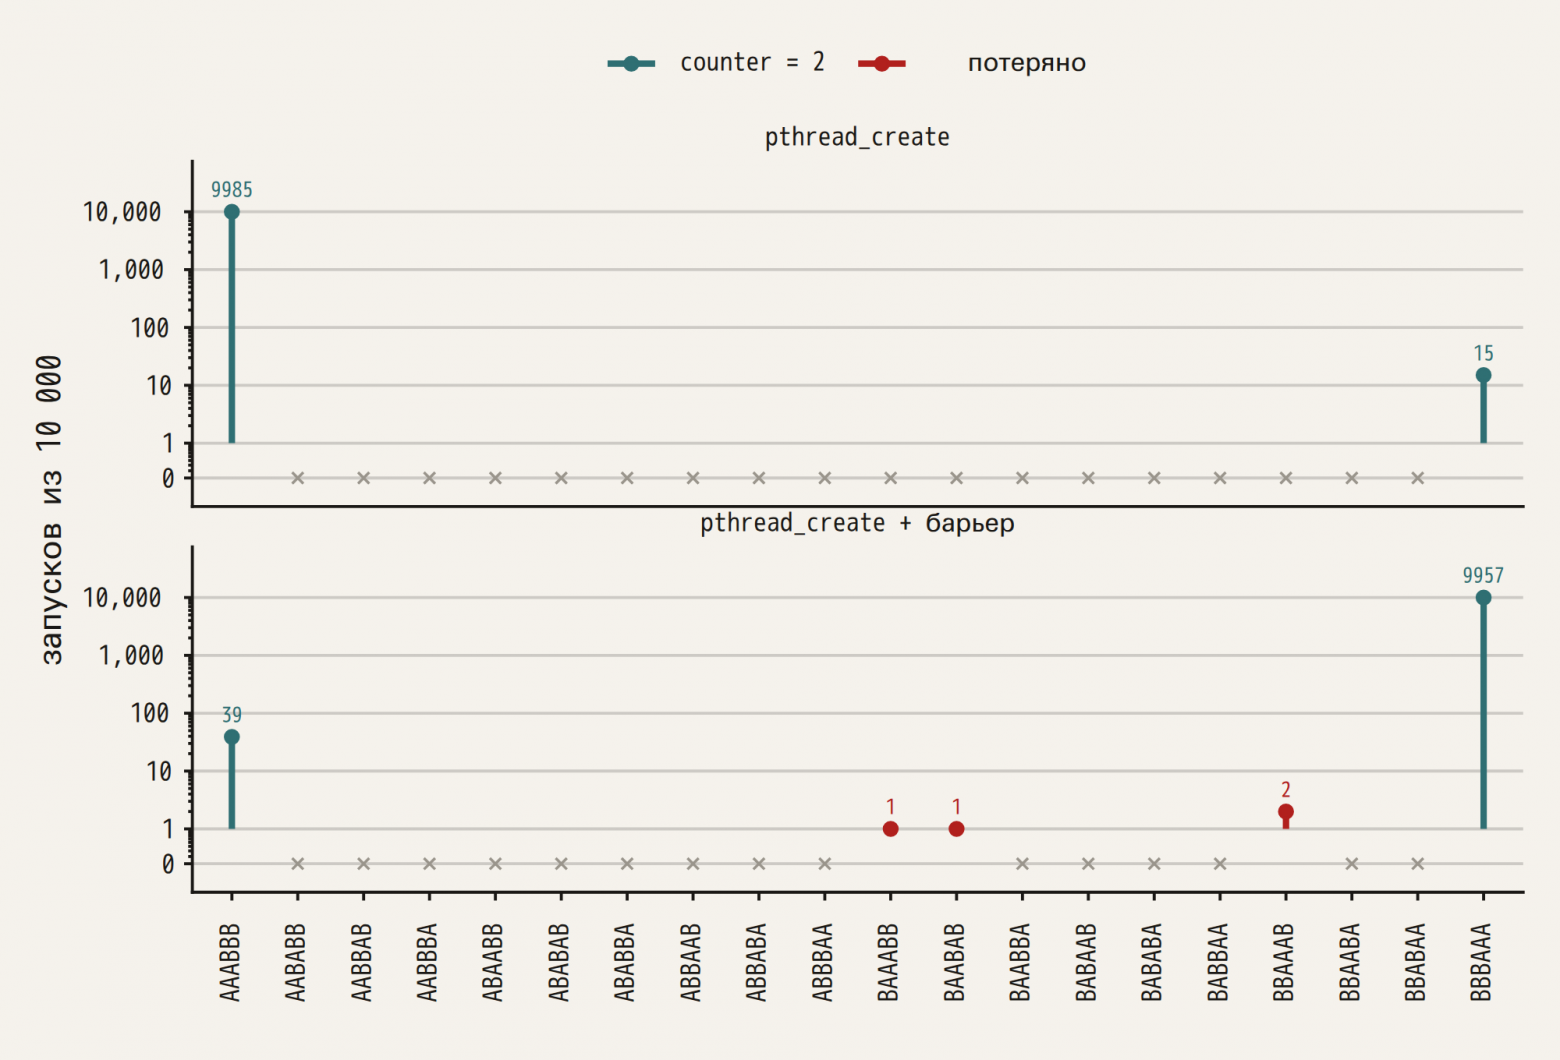
За 20 000 запусков простаивающий ноутбук выполнил 5 порядков из 20 и потерял обновление 4 раза. Любопытно, что барьер, который должен был столкнуть потоки, вместо этого перевернул порядок: 9957 запусков дали BBBAAA.
Загруженная машина ведёт себя немного иначе. Когда stress-ng --cpu 16 занимал все аппаратные потоки, те же два бинарника выполнили 13 и 16 порядков и потеряли обновление в 32 и 66 запусках из 10 000. Это всё ещё меньше 1 запуска из 100.
Rewind запускает гостевую систему на одном виртуальном CPU и переключает потоки только на выходе из неё, например при системном вызове (см. dafuq is a deterministic VM?) или вызове rewind_point из SDK. Так у Rewind появляется возможность изменить расписание.
Теперь запустим тот же бинарник под Rewind и посмотрим, сколько из 20 порядков она сможет достичь.
$ rewind check --epoch 1790985600 --root root --schedules 9999 \ --all --no-narrow -- /bin/race...schedule 9999: exited:0 354 steps run 9b248f72f742b07f1492 of 9999 other schedules ended differently
За 10 000 запусков Rewind достигла 15 порядков из 20 и потеряла обновление в 1371 из них. С барьером она достигла всех 20 порядков и потеряла обновление в 2997 запусках.
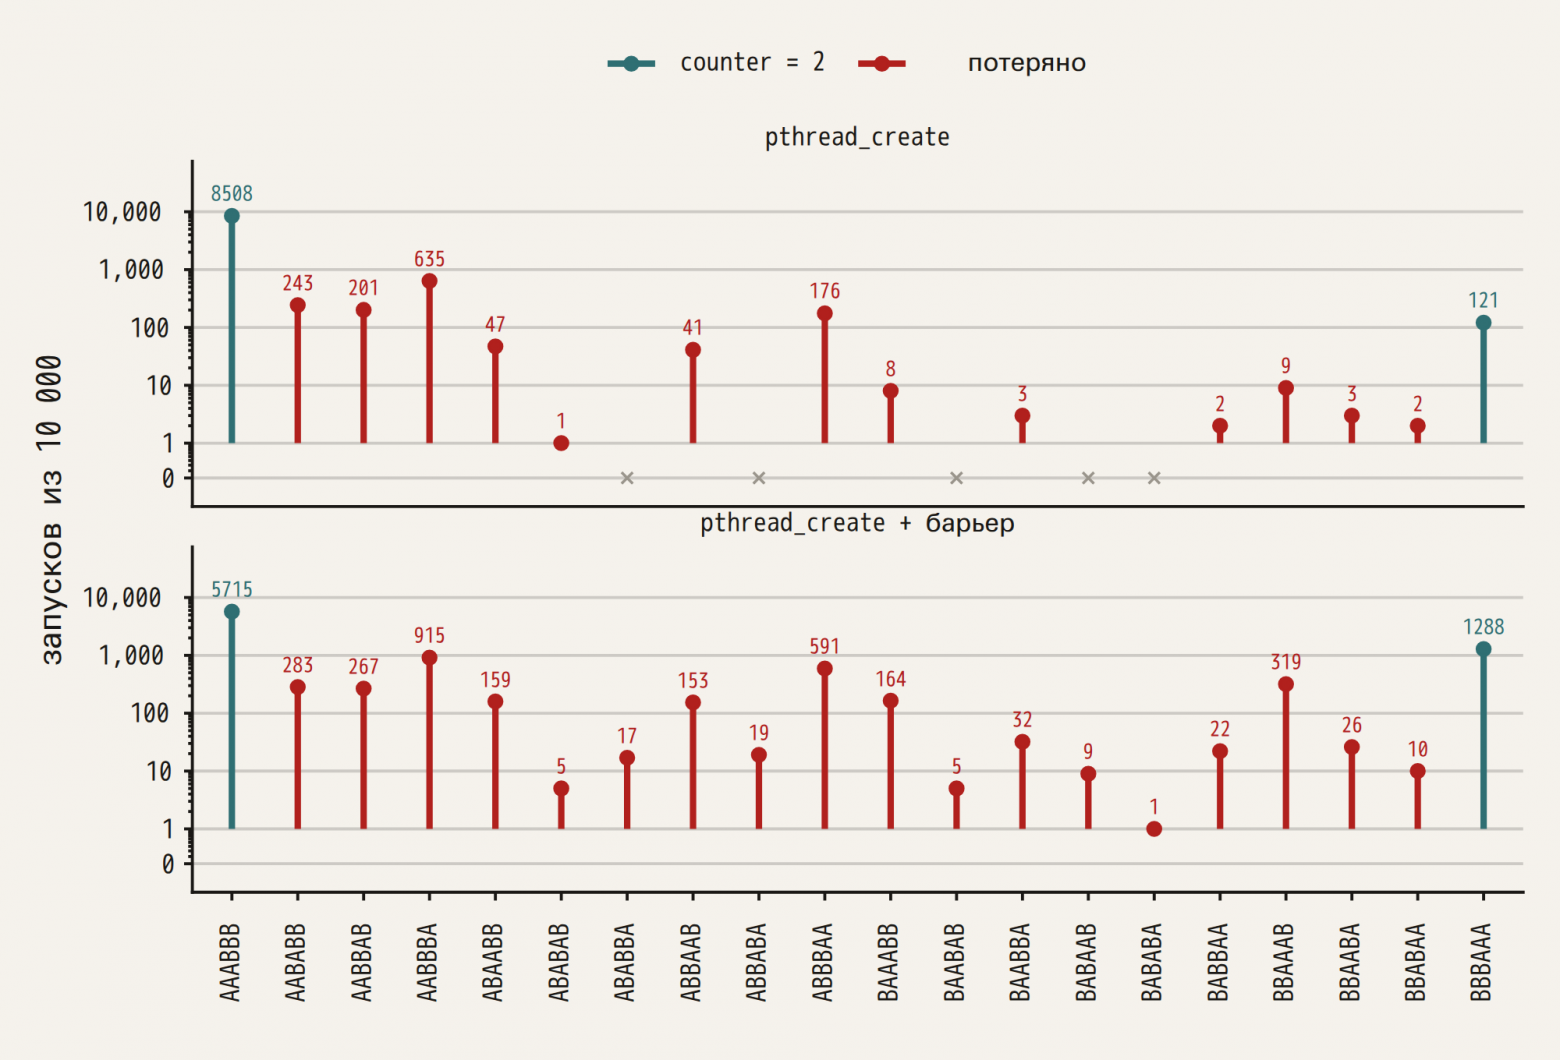
Видно, что возмущения Rewind достигают большего числа порядков, чем хост, и обновление теряется чаще, а это помогает найти баг. Итоги в таблице:
|
Где |
Старт |
Увидено порядков |
Запусков с потерей обновления |
|---|---|---|---|
|
простаивающий ноутбук |
create |
2 из 20 |
0 из 10 000 |
|
простаивающий ноутбук |
барьер |
5 из 20 |
4 из 10 000 |
|
загруженный ноутбук |
create |
13 из 20 |
32 из 10 000 |
|
загруженный ноутбук |
барьер |
16 из 20 |
66 из 10 000 |
|
Rewind |
create |
15 из 20 |
1371 из 10 000 |
|
Rewind |
барьер |
20 из 20 |
2997 из 10 000 |
Однако чередования — не единственный способ вызвать баг. Долгие паузы — это тоже порядки, и они могут быть ещё реже чередований.
Долгая пауза лежит на дальнем краю решётки. Поток A останавливается, а всё остальное успевает сделать сотни шагов, прежде чем A сделает следующий. Такой путь долго идёт вдоль одного края решётки. Короткое возмущение отдаёт другой стороне лишь несколько шагов, поэтому так далеко она заходит редко.
В Rewind есть настройки, которые делают долгие паузы вероятнее. Параметр --stall-max повышает максимальное время остановки, а --stall-min понижает минимальное. С ними можно исследовать ещё более маловероятные расписания и находить баги, проявляющиеся только в экстремальных условиях.
Немного удивительно, что при всей шумихе вокруг тестирования на основе свойств, фаззинга и Jepsen простая детерминированная виртуальная машина, перемешивающая расписание, находит столько багов. Наше железо настолько быстрое, что мы привыкли считать порядок событий всегда одинаковым. Немного случайности в расписании способно выявить баги, прятавшиеся на виду.
Баги не редки, но редки расписания, которые их вызывают.
ссылка на оригинал статьи https://habr.com/ru/articles/1103428/