Если вы запускаете модели вроде Flux или Qwen-Image на домашней видеокарте, вы почти наверняка используете квантованные веса. И почти наверняка встречали совет: «на квантованной модели не берите навороченные сэмплеры, они накапливают ошибку». Мы решили проверить, правда ли это, и получили результат, который оказался неудобен для нас самих.
Коротко:
-
настоящие INT8-ядра ComfyUI добавляют шум, который почти не виден в итоговой картинке;
-
шум этот белый, то есть между шагами не коррелирован, и именно поэтому его усиливают методы высокого порядка;
-
гораздо сильнее влияет выбор сэмплера и CFG;
-
наш собственный Flow-WLS, который мы предлагали в прошлой работе, на малом числе шагов проиграл Euler;
-
лучшими оказались простые методы низкого порядка (второго, а для дистиллированных моделей третьего), и мы сделали их доступными в выпадающем списке ComfyUI.
С чего всё началось
В прошлой работе (Flow-WLS, Zenodo) мы предложили многошаговый сэмплер с регуляризацией: он подгоняет к истории скоростей полином по взвешенным наименьшим квадратам и интегрирует его. Идея была в том, что такое сглаживание подавит высокочастотный шум, вызванный квантованием весов. Это звучало разумно, и мы этого ждали.
Прежде чем писать «подавляет», мы записывали в README гипотезы (сначала шесть, перед дополнительной серией ещё девять: H1-H15) и условия, при которых они считаются подтверждёнными. Это важная привычка: она не даёт подогнать вывод под результат. Часть гипотез не подтвердилась, и они остались в тексте как есть.
Что мерили
-
Модели: Anima (bf16, плюс симуляция FP8/INT8/INT4/NVFP4), Flux3-Klein INT8, Krea 2 INT8 (с ConvRot), Moss-Image INT8.
-
4 промпта, 2-3 seed, 8-24 шага, CFG 1-5.
-
Эталон: решение той же модели на большом числе шагов.
-
Для Flux3 сравнивали два режима одной и той же INT8-модели: Q (реальные INT8-ядра с квантованием активаций) и D (те же веса, распакованные в bf16, без квантования активаций). Разница Q и D чисто показывает ошибку ядер.
Метрики: относительная ошибка латента (общая, по геометрии и по деталям), SSIM, LPIPS, наблюдаемый порядок сходимости, структура ошибки по шагам, парные доверительные интервалы относительно Euler.
Результат 1: квантование безобидно, а шум белый
Ошибка реальных INT8-ядер e = v_Q − v_D оказалась белой по времени: корреляция между соседними шагами −0,001, а накопленная ошибка совпадает с предсказанием для белого шума. Размер: 1,3% нормы скорости при CFG 1 и 5,7% при CFG 4. Рост в 4,36 раза от CFG 1 к CFG 4 понятен: ошибка умножается на guidance, как и любая разность предсказаний.
На итоговый латент это даёт 0,02 или меньше. В пространстве картинок расстояние между сошедшимися решениями Q и D: LPIPS 0,014 при CFG 1 и 0,029 при CFG 4. Глазом это не отличить.
Здесь честная оговорка: мы сравнивали INT8-ядра с теми же весами в bf16. Ошибку самого округления весов относительно неизвестного bf16-оригинала мы не измеряли.
Результат 2: у методов высокого порядка шум усиливается
Раз ошибка белая, её усиление методами можно посчитать. Относительно Euler:
|
Метод |
Усиление белого шума |
|---|---|
|
AB-2 |
1,06 |
|
AB-3 |
1,21 |
|
AB-4 |
1,97 |
AB-4 почти вдвое увеличивает шум, AB-2 почти не меняет. Это совпало с измеренным: AB-4 в наших прогонах был самым чувствительным к INT8. Но его собственная избыточная ошибка (0,5-0,8) в десятки раз больше эффекта от квантования (до 0,02), так что тут квантование вообще не главное.
Результат 3: главное зависит от CFG
На Anima мы прогнали CFG 1, 3 и 5 на 8, 12, 16 и 24 шагах, девять методов. Итог:
-
AB-2 лучше Euler во всех 12 ячейках (на 0,03-0,12 по ошибке латента, доверительные интервалы не включают нуль).
-
DPM++ 2M обгоняет Euler при сильном CFG с 16-24 шагов.
-
При CFG 1 (дистиллированные модели Flux3-Klein и Krea 2) лучше всех AB-3 и динамический выбор.
-
AB-4 и длинные окна Flow-WLS при ≤12 шагах нигде не были лучшим выбором.
То есть утверждение «Euler лучший» из нашего первого эксперимента было верно только для набора методов, в котором не было AB-2. Мы это обнаружили, когда добавили его, и исправили выводы в README. Такие вещи полезно показывать, а не прятать.
Почему так
Мы предположили, а потом измерили: выход сети не гладкая функция шага, а гладкий тренд плюс шум, не коррелированный между шагами. Его относительный размер около 1% нормы при CFG 1, около 4% при CFG 3 и 6-7% при CFG 5. Член CFG s·(v_c − v_u) перегенерируется на каждом шаге (относительное изменение между соседними шагами 0,88-1,12), а условная часть меняется на 0,05-0,13.
Измеряли по энергии разностей: для белого шума нормированная энергия ‖Δᵏv‖²/C(2k,k) не зависит от порядка разности k, для гладкого поля быстро падает. При CFG 3-5 профиль выходит на плато, при CFG 1 нет.
Правила с большими весами такой шум усиливают, и выигрывают они только пока он мал. Это согласуется с результатами по CFG.
Мы проверили и другое: может быть, фильтр истории надо просто подогнать по данным? Подгонка линейного фильтра с постоянными весами (кросс-валидация «оставить один юнит») дала выигрыш не больше 3,4% над лучшим существующим правилом. Значит, нового сэмплера класса Flow-WLS не нужно. Побочный результат: метрика согласованности на одном шаге плохо предсказывает итоговый рейтинг, а накопленная по траектории предсказывает неплохо (Spearman 0,77 в среднем).
Что видно на картинках
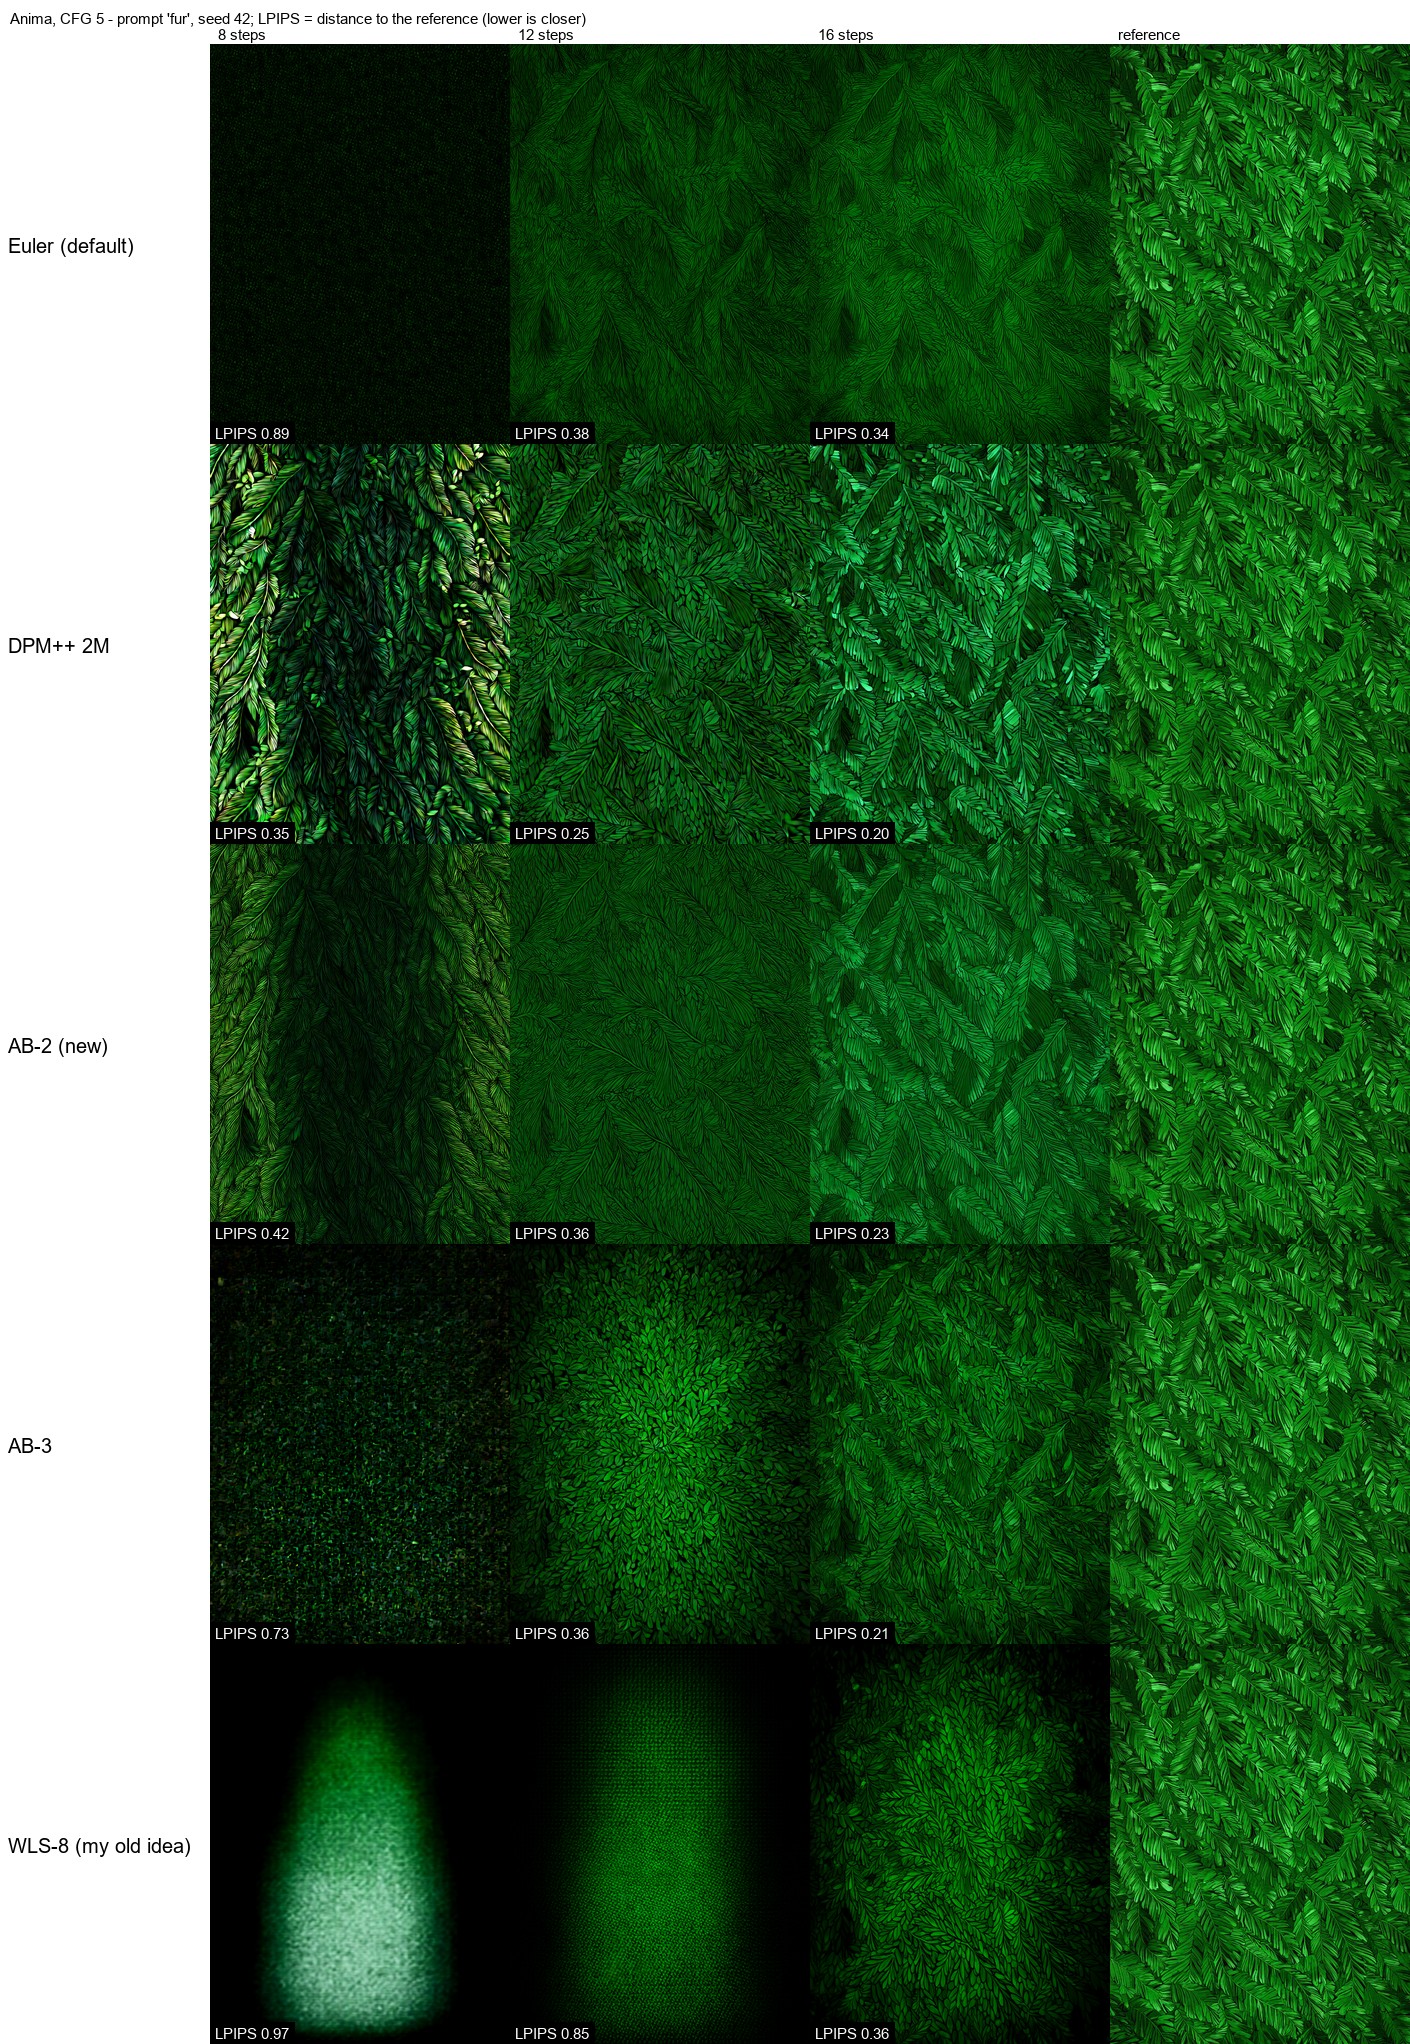
Строки: Euler, DPM++ 2M, AB-2, AB-3, WLS-8. На плитке LPIPS до эталона.
-
Anima, текстурный промпт, 8 шагов. Euler оставляет почти чёрный шум (LPIPS 0,89), AB-3 тоже (0,73), WLS-8 даёт размытое пятно (0,97). DPM++ 2M (0,35) и AB-2 (0,42) дают законченную картинку. На 16 шагах Euler 0,34 против 0,20 (DPM++ 2M), 0,21 (AB-3) и 0,23 (AB-2).
-
Krea 2, 12 шагов. У Euler «пластиковая» кожа (0,34). AB-2 (0,30), DPM++ 2M (0,27) и AB-3 (0,21) возвращают поры и веснушки.
-
Flux3-Klein, 12 шагов. Euler, DPM++ 2M, AB-2 и AB-3 на глаз одинаковы (0,15). Ломается только WLS-8 на 8 шагах. Для этой модели менять Euler незачем.
-
Anima, портрет. Все методы на 8-16 шагах дают другой кадр, чем эталон на 96 шагах; мелкие различия LPIPS глазом не видны, но AB-3 и WLS-8 ломают лицо на 8 шагах.
Как пользоваться
Положите папку в ComfyUI/custom_nodes/ и перезапустите ComfyUI:
git clone https://github.com/YakovSava/flow-wls-research
В обычном списке sampler_name (KSampler, KSamplerSelect) появятся flow_ab2, flow_ab3, flow_ab4. Кроме того, есть узел Flow Easy Sampler с выбором из двух вариантов. Что выбирать:
-
обычная модель, CFG 3 и выше:
flow_ab2, на 16+ шагах такжеdpmpp_2m; -
дистиллированная модель, CFG 1:
flow_ab3; -
меньше 12 шагов: не
flow_ab4и не длинные окна Flow-WLS.
Для интересующихся: AB-k реализован как рекуррентное выражение на сетке сигм без дополнительных вызовов модели:
spec = adams_bashforth_spec(2)x = sample_history(model, x, sigmas, extra_args=extra_args, spec=spec)
Работает с моделями на flow-предсказании (Anima, Flux3, Krea 2, Moss). На SDXL-подобных не проверялось.
Чего мы не доказали
-
LPIPS измеряет расстояние до картинки, полученной за много шагов, а не красоту. Слепого теста на людях нет.
-
4 промпта и 4 модели, на каждой картинке один seed, лучший не выбирался.
-
Для Moss-Image сошедшегося эталона нет (решение меняется с числом шагов), поэтому там надёжны только крупные эффекты. Для Flux3 при CFG 4 эталон сходится на 20-34%.
-
Для Moss и Krea 2 измерен только режим Q; эффект ядер измерен на Flux3.
-
AB-2 и DPM++ 2M мы добавили в часть экспериментов после первых результатов; это помечено в README.
-
AB-2 не новый метод. Вклад работы в измерении и в отрицательном результате по нашей же идее.
Репозиторий с таблицами и сетками: https://github.com/YakovSava/flow-wls-research Препринт на Zenodo: https://doi.org/10.5281/zenodo.23939696
ссылка на оригинал статьи https://habr.com/ru/articles/1103434/