Откройте hh.ru и поищите вакансии со словом «AI-агент». На 28 октября 2026 года их 1 458. LLM упоминают в 1 261 вакансии, RAG в 520, MCP в 245. А теперь поищите «кэширование промптов»: 13 вакансий. Токены упоминают в 19.
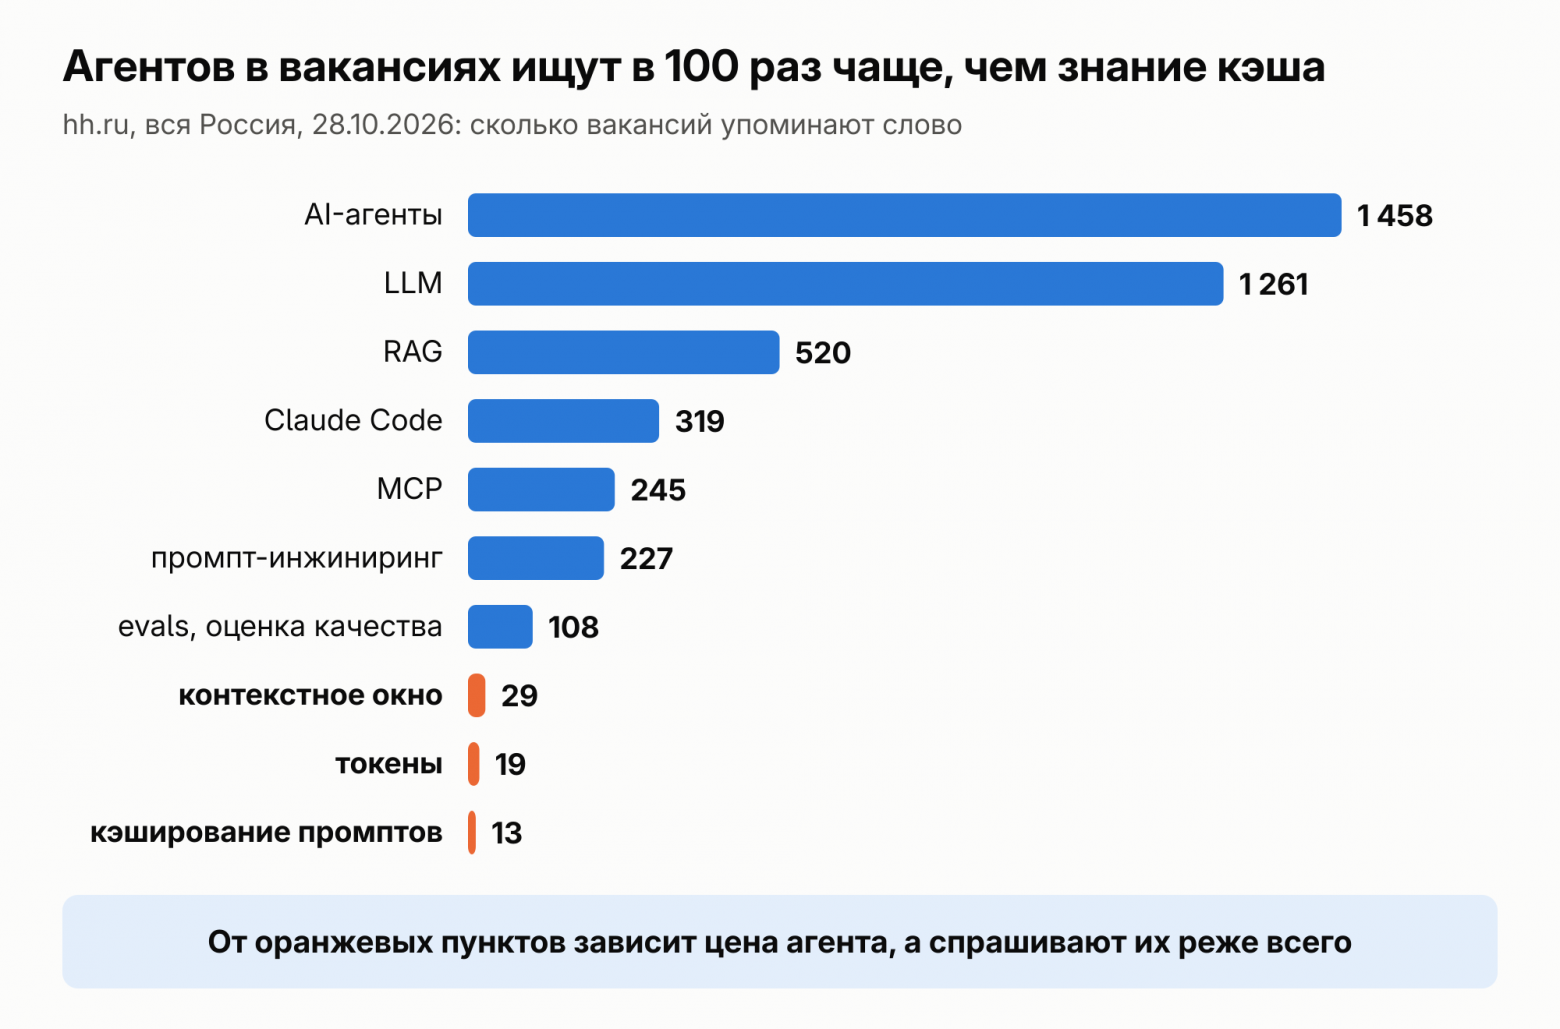
hh.ru, поиск по всей России, 28.10.2026.
Странная картина. Агентов просят строить массово. А о том, сколько агент стоит и почему он работает, почти не спрашивают. Разберём эти слова по одному: что это, зачем и как выглядит внутри. Потом посчитаем токены и деньги на одной задаче агента. С кэшем та же задача обходится в 6,6 раза дешевле, и вы увидите почему. В конце будет чек-лист.
Это первая часть серии. Во второй разберу надёжность: durable execution, транзакции и идемпотентность. В третьей покажу, чем цепочка отличается от агента, и соберу всё в одно приложение на примере агента поддержки.
TL;DR
-
AI-инженер не обучает свою модель. Он строит систему вокруг готовой: подаёт ей нужные данные, даёт инструменты, проверяет результат и следит за ценой.
-
Модель ничего не помнит и ничего не делает сама. На каждом шаге обвязка (harness) заново отправляет ей всё: инструменты, правила и всю историю.
-
Поэтому за 30 шагов агент прочитал 1,63 млн токенов, хотя за раз ему никогда не давали больше 100 тысяч.
-
Кэш читает повторяющееся начало запроса за 5–10% цены. Но только если оно совпало с прошлым запросом до символа. Поэтому неизменное кладите в начало, а новое в конец.
-
Русский текст в токенах Claude примерно в 1,27 раза «дороже» английского.
Что такое AI-инженерия и почему она касается каждого разработчика
Чем это отличается от машинного обучения, хорошо объясняет Чип Хьюен в книге «AI Engineering». ML-инженер сам учит модель: собирает и размечает данные, тренирует, проверяет. AI-инженер берёт готовую модель, которую обучил кто-то другой, например Claude или GPT. Его работа: правильно задать вопрос, дать модели нужные данные и иногда чуть-чуть её дообучить. Для него модель просто внешний сервис, как база данных или платёжный шлюз. Разница одна: отвечает она текстом и иногда ошибается.
Для обычного разработчика это уже не экзотика. В опросе Stack Overflow 2026 года 73% респондентов сказали, что каждый день пишут код с ассистентами и агентами. Среди агентов чаще всего называют Claude Code (66%) и GitHub Copilot (59%). А в опросе 2025 года главной жалобой было «ответы ИИ почти правильные, но не совсем». Так ответили 66%.
Разница между «почти» и «правильно» редко прячется в промпте. Чтобы агент решал задачу и не съедал бюджет, надо понимать четыре вещи. Что модель получает на каждом шаге. Кто на самом деле выполняет действия. Где агент обычно ошибается. И сколько стоит каждый шаг.
Словарь
|
Термин |
Коротко |
|---|---|
|
Токен |
кусок текста; в токенах модель читает, и в них считаются деньги |
|
Контекстное окно |
сколько токенов модель прочитает за один запрос |
|
Системный промпт |
правила для модели, уходят в каждый запрос |
|
Tool use |
модель просит вызвать функцию, ваш код её выполняет |
|
Цепочка и агент |
шаги прописаны в коде или модель выбирает их сама |
|
Агентный цикл |
запрос → вызов инструмента → результат → снова запрос, пока задача не решена |
|
Harness |
весь код вокруг модели: Claude Code, Cursor, ваш сервис |
|
MCP |
стандарт, чтобы подключить инструменты и данные к любому AI-приложению |
|
Скилл |
папка с инструкциями, которую агент читает, только когда она нужна |
|
Субагент |
помощник со своим контекстом, возвращает только итог |
|
Хук |
ваш скрипт на событие обвязки: запретить, спросить человека, дописать контекст, проверить |
|
RAG |
найти нужные документы и положить их в запрос перед ответом |
|
Eval |
набор задач, на котором проверяют, что агент не сломался |
|
Кэш промпта |
повторное начало запроса за 5–10% цены |
Модель и контекст
Токен. Модель читает текст не по буквам и не по словам, а кусками. Эти куски и называются токенами. В токенах считается всё: сколько влезет в запрос, какие лимиты и сколько заплатите. Подробно о них в разделе про токены.
Контекстное окно. Сколько токенов модель прочитает за один раз, вместе со своим ответом. У большинства новых моделей Claude это 1 млн. Забивать окно до отказа не стоит. Каждый токен стоит денег, а чем длиннее контекст, тем хуже ответы. В Anthropic это называют «context rot», «гниение контекста».
Системный промпт. Правила для модели, которые идут перед сообщениями пользователя: кто она, что можно, в каком виде отвечать. В Claude Code сюда попадает и файл CLAUDE.md из репозитория. Системный промпт уходит в модель с каждым запросом. Поэтому за каждую лишнюю строку в нём вы платите много раз.
Как модель действует
Tool use (вызов инструментов). Так модель получает руки. Вы описываете функцию: как называется, что делает, какие у неё параметры. Например, get_weather с параметром location. Сама модель функцию не запускает. Она отвечает: «вызови get_weather для Москвы». Функцию вызывает ваш код и возвращает модели результат. Anthropic называет это контрактом: вы решаете, что модели можно, а она решает, когда.
Цепочка (workflow, agents chain) и агент (AgentsLLM). В цепочке порядок шагов прописан в коде. Например: понять, о чём запрос, и отправить его в нужную ветку. Агент порядок выбирает сам: какие шаги сделать и какие инструменты вызвать. Цепочка предсказуемее и дешевле, агент гибче. Anthropic советует начинать с самого простого. Часто хватает одного хорошо составленного запроса к модели.
Агентный цикл. Повторяется одно и то же: запрос, вызов инструмента, результат, снова запрос. Так продолжается, пока модель не ответит текстом. Этот цикл и делает модель с инструментами агентом. Псевдокод и схема ниже, в разделе про устройство системы.
Harness (обвязка). Весь код вокруг модели. Он собирает запрос, крутит цикл, вызывает инструменты, хранит историю и проверяет действия. Claude Code, Cursor, Agent SDK и ваш сервис на Python это всё обвязки. Одна и та же модель в разных обвязках работает по-разному. Поэтому AI-инженер чаще всего строит именно обвязку. Подробно её части разобраны в статье «Что такое Harness?».
Чем расширяют агента
MCP (Model Context Protocol). Открытый стандарт, чтобы подключать к AI-приложениям внешние системы. Его сравнивают с USB-C. Приложение, например Claude Code, подключается к MCP-серверам. Сервер даёт ему инструменты, данные и готовые шаблоны промптов. Интеграцию с GitHub, базой данных или Jira пишут один раз, и она работает в любом приложении с поддержкой MCP. Стандарт быстро меняется. Я опираюсь на версию от 28 июля 2026 года.
Скилл (Agent Skill). Папка с файлом SKILL.md, иногда ещё со скриптами и справочниками. Сначала модель видит только короткое описание скилла, около 100 токенов. Весь текст, до 5 тысяч токенов, она читает, когда задача подходит под описание. Остальные файлы ничего не стоят, пока их не открыли. А если внутри скрипт, в контекст попадает только то, что он вывел.
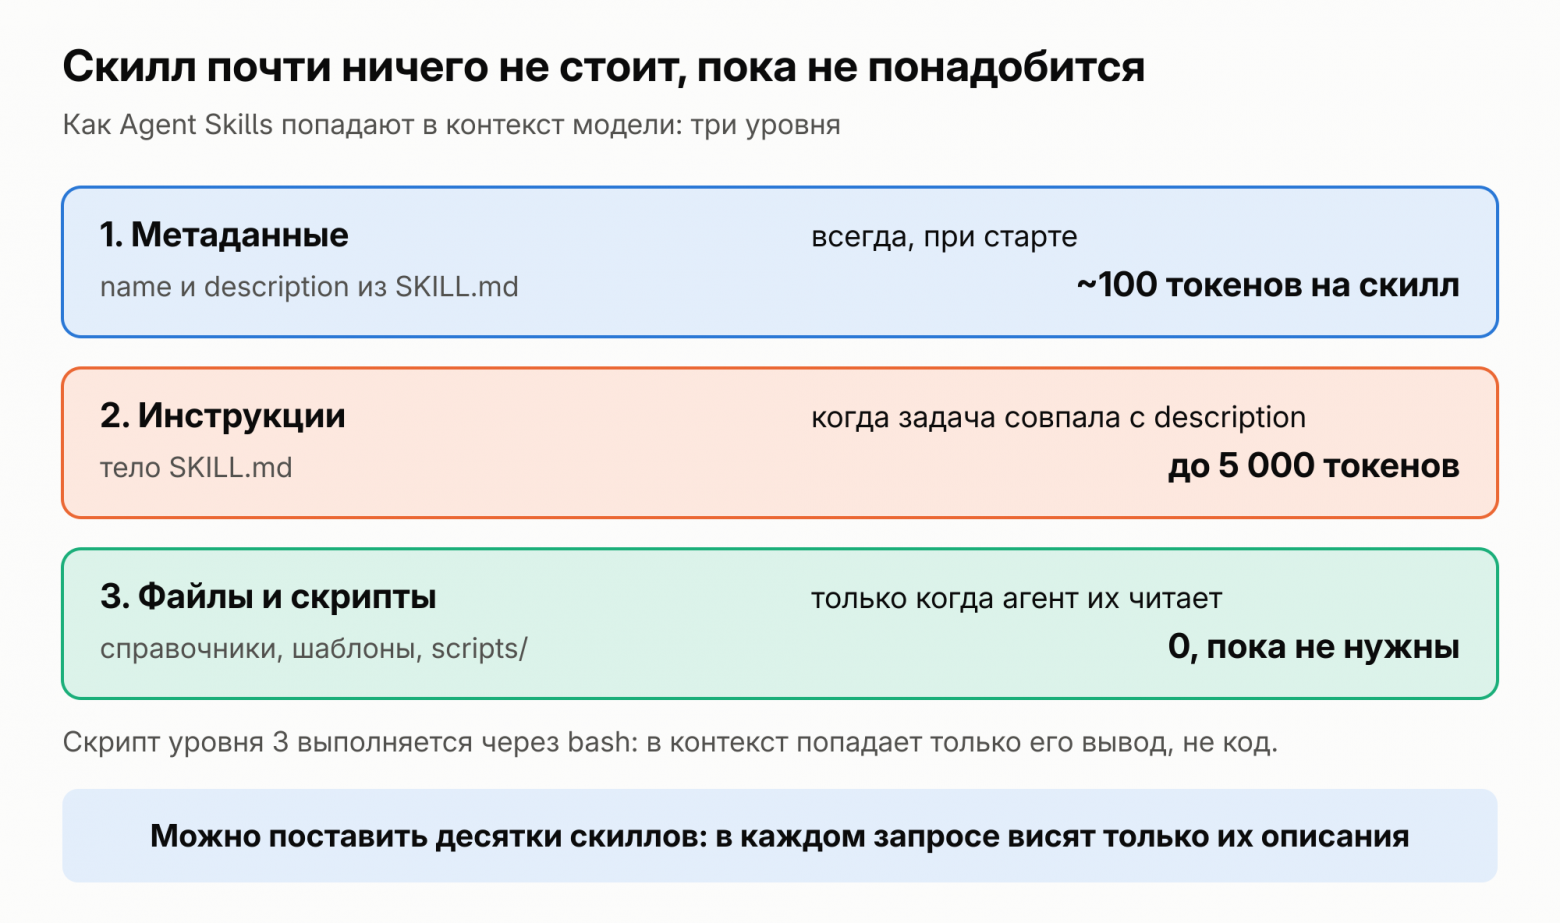
Как скилл попадает в контекст. Цифры из документации Anthropic по Agent Skills.
Субагент. Помощник со своим контекстом и своими инструментами. Главный агент даёт ему задачу и получает обратно только итог. Зачем это нужно: шумная работа, например поиск по коду или чтение логов, не забивает главный контекст. Субагенту можно дать дешёвую модель. Но его запросы считаются в те же лимиты.
Хук. Ваш скрипт, который обвязка запускает сама, когда что-то происходит. Модель тут ни при чём. Поводов много: начало сессии, новый запрос пользователя, момент до вызова инструмента и после, конец ответа, сжатие контекста, запуск субагента.
На вход скрипт получает JSON с подробностями: например, какой инструмент вызывают и с какими параметрами. В ответ он может запретить действие: выйти с кодом 2 или вернуть deny с причиной, и модель её увидит. Может отдать вопрос человеку (ask) или разрешить без лишнего вопроса (allow). Может дописать текст в контекст модели. А может просто сделать своё дело: прогнать линтер после правки файла, записать действие в журнал, прислать уведомление.
Хуки проекта лежат в .claude/settings.json. Обязательные для всей компании кладут в управляемые настройки: их разработчик не отключит. Бывают и хуки, которые сами спрашивают модель, когда нужно суждение. Но обычный хук работает без модели и каждый раз одинаково. В этом его отличие от строки в промпте: инструкцию модель может пропустить, а хук сработает всегда. Отсюда правило: скилл советует, хук гарантирует.
Качество и данные
RAG (retrieval-augmented generation). Перед вызовом модели система ищет нужные куски документов и кладёт их в запрос. Модель отвечает по найденному, а не по памяти. Агентам всё чаще просто дают инструмент поиска, и они ищут сами.
Eval (оценка). Это тесты для агента. Вы собираете задачи, для которых знаете правильный ответ, и гоняете их после каждой смены модели, промпта или инструментов. Обычный тест ждёт точного результата, а модель каждый раз отвечает чуть по-разному. Поэтому проверять агента сложнее. Хьюен считает оценку главной трудностью AI-инженерии.
Кэшу в словаре досталась одна строка в таблице. Судя по вакансиям, о нём спрашивают реже всего, поэтому у него отдельный раздел.
Как устроена система
Модель ничего не помнит между запросами. Всё, что агент «знает» о задаче, обвязка заново собирает и отправляет на каждом шаге. Запрос всегда устроен одинаково: сначала описания инструментов, потом системный промпт, потом вся история разговора.
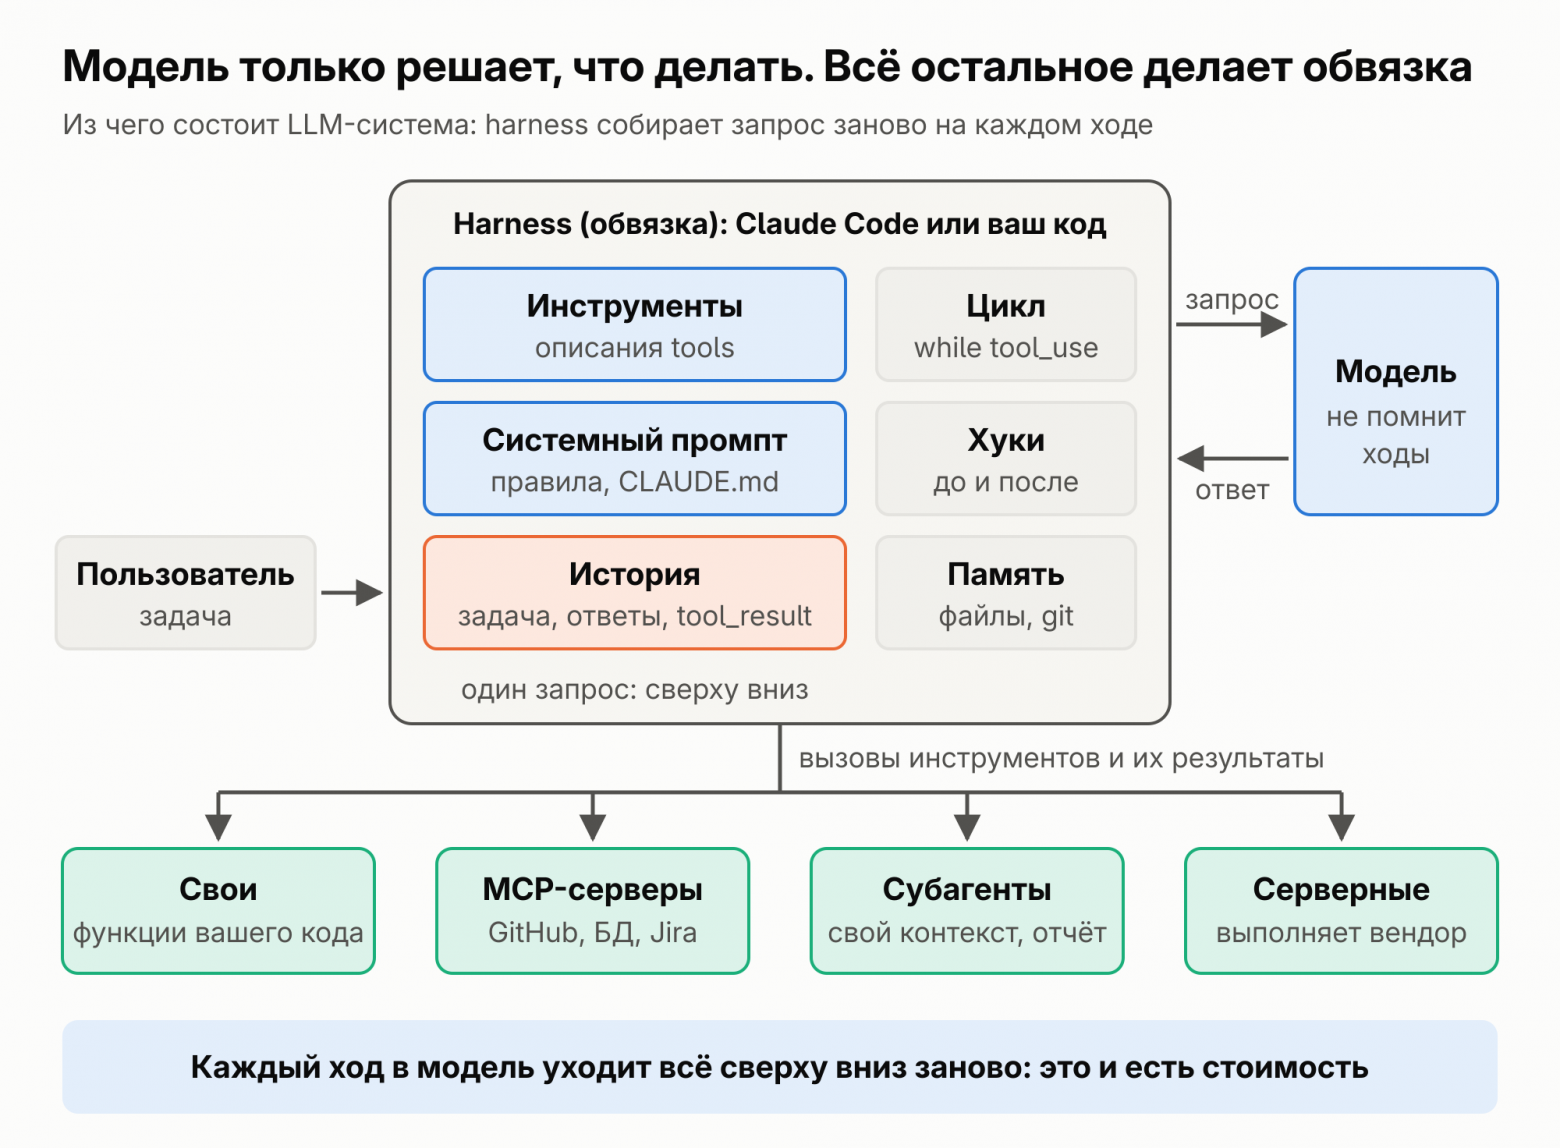
Из чего состоит LLM-система. Модель получает собранный запрос и возвращает текст или просьбу вызвать инструмент.
Сам агентный цикл в документации Anthropic это обычный while. Вот он псевдокодом:
# Псевдокод агентного циклаистория = [задача_пользователя]while True: ответ = модель(инструменты, системный_промпт, история) история.append(ответ) if ответ.stop_reason != "tool_use": break # модель ответила текстом: готово результаты = [выполнить(вызов) for вызов in ответ.вызовы] история.append(результаты) # блоки tool_result
Поле stop_reason объясняет, почему модель остановилась. Если там tool_use, модель хочет вызвать инструмент, и цикл идёт дальше. Любое другое значение, например end_turn или max_tokens, значит: модель закончила или упёрлась в лимит. Тогда цикл заканчивается.
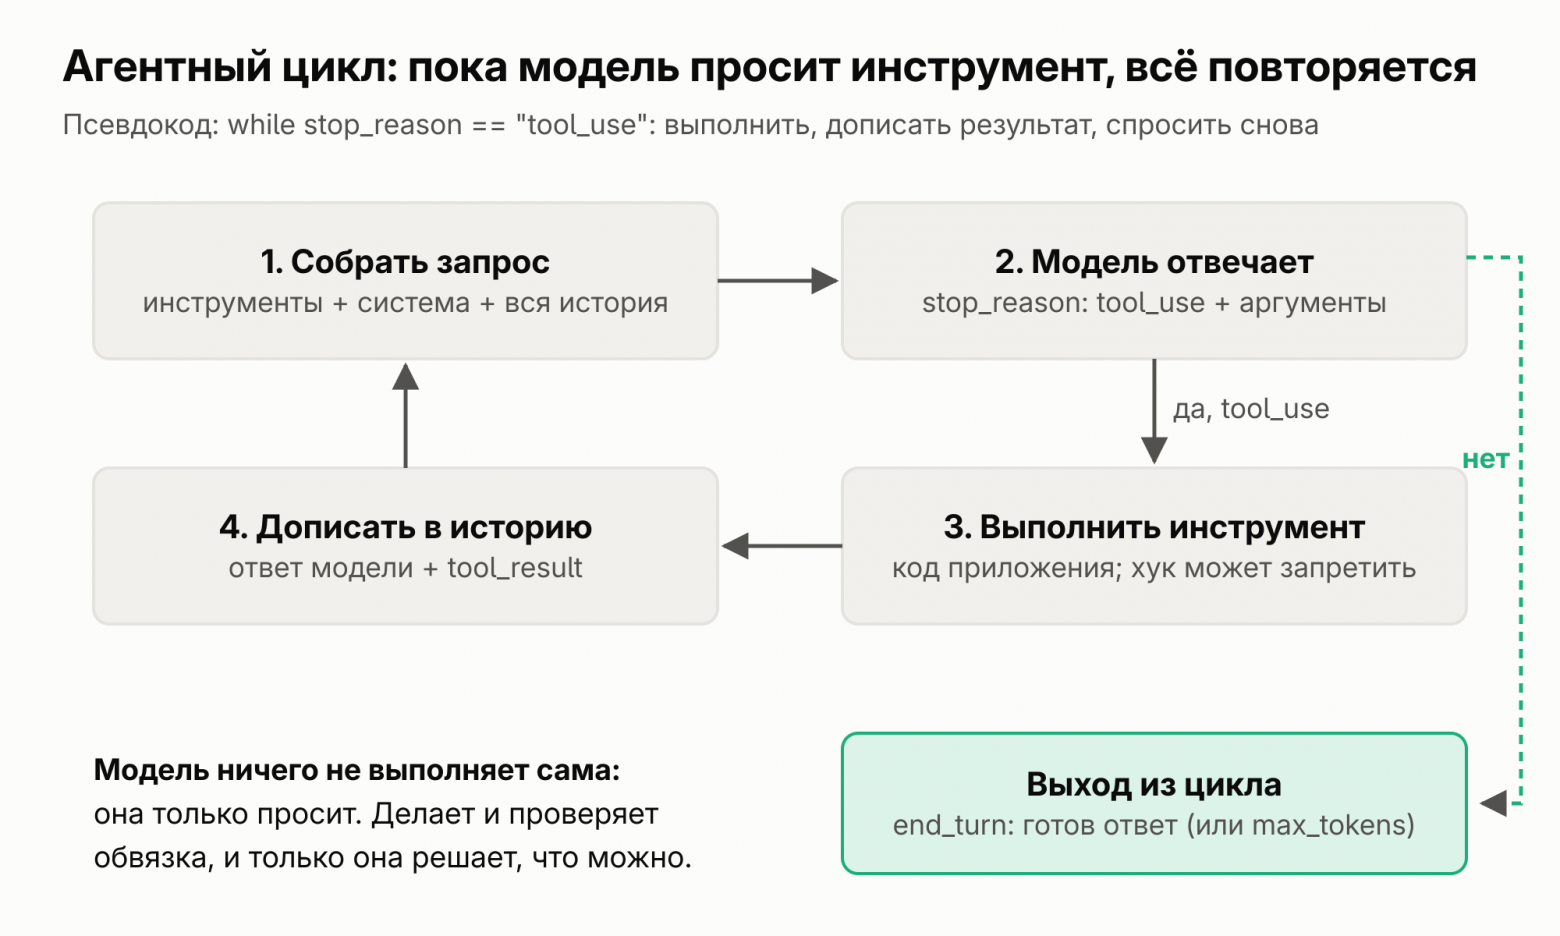
Шаг 3 выполняет код приложения. Именно здесь хук может запретить действие.
Сам цикл короткий. Почти вся работа идёт вокруг него:
-
инструменты: ваши собственные, подключённые через MCP, и серверные, которые выполняет сам вендор, например поиск в интернете или запуск кода;
-
субагенты: берут часть работы и возвращают короткий отчёт;
-
хуки: проверяют действия до и после;
-
память: хранится не в модели, а в файлах и в git.
Зачем нужна память, Anthropic объясняет в статье про долгие агенты. Каждая новая сессия начинается с чистого листа. Поэтому агент оставляет следующей сессии файл с прогрессом, список задач со статусами и историю коммитов.
Как это выглядит на практике, видно по обычной настройке Claude Code. В моём личном репозитории хук перед каждым вызовом Bash, Write и Edit записывает рискованные действия в журнал. Другой хук при каждом запросе подсказывает, какая модель подойдёт для задачи. Есть три субагента: дешёвый только для чтения, средний и сильный. И больше десятка скиллов, которые загружаются, только когда нужны. Всё это простые файлы настроек. Но именно они решают, что попадёт к модели и что агенту можно делать.
Частая ловушка: агент уверенно говорит «готово», а сделано полдела. В той же статье Anthropic описывает два типичных сбоя. Агент пытается сделать всё за один заход. Или объявляет, что закончил, слишком рано. Уговоры в промпте тут помогают слабо. Помогает обвязка: список требований со статусами и способ проверить результат. Например, прогнать тесты или открыть приложение в браузере.
Как считаются токены
За LLM платят токенами, причём токены на входе и на выходе стоят по-разному. На 28 октября 2026 года у Claude Sonnet 5.5 миллион входных токенов стоит $2, а миллион выходных $10. Выход в 5 раз дороже. Описания инструментов тоже идут во вход. В примере из документации один инструмент с короткой схемой и вопрос пользователя вместе занимают 403 токена.
Модель ничего не помнит, поэтому на каждом шаге ей заново отправляют всю историю. Посчитаем на условном примере:
-
в начале каждого запроса 12 тысяч токенов: описания инструментов и системный промпт;
-
первое сообщение пользователя занимает 200 токенов;
-
на каждом шаге модель отвечает на 400 токенов, а инструмент возвращает ещё 2 500;
-
всего 30 шагов на Sonnet 5.5.
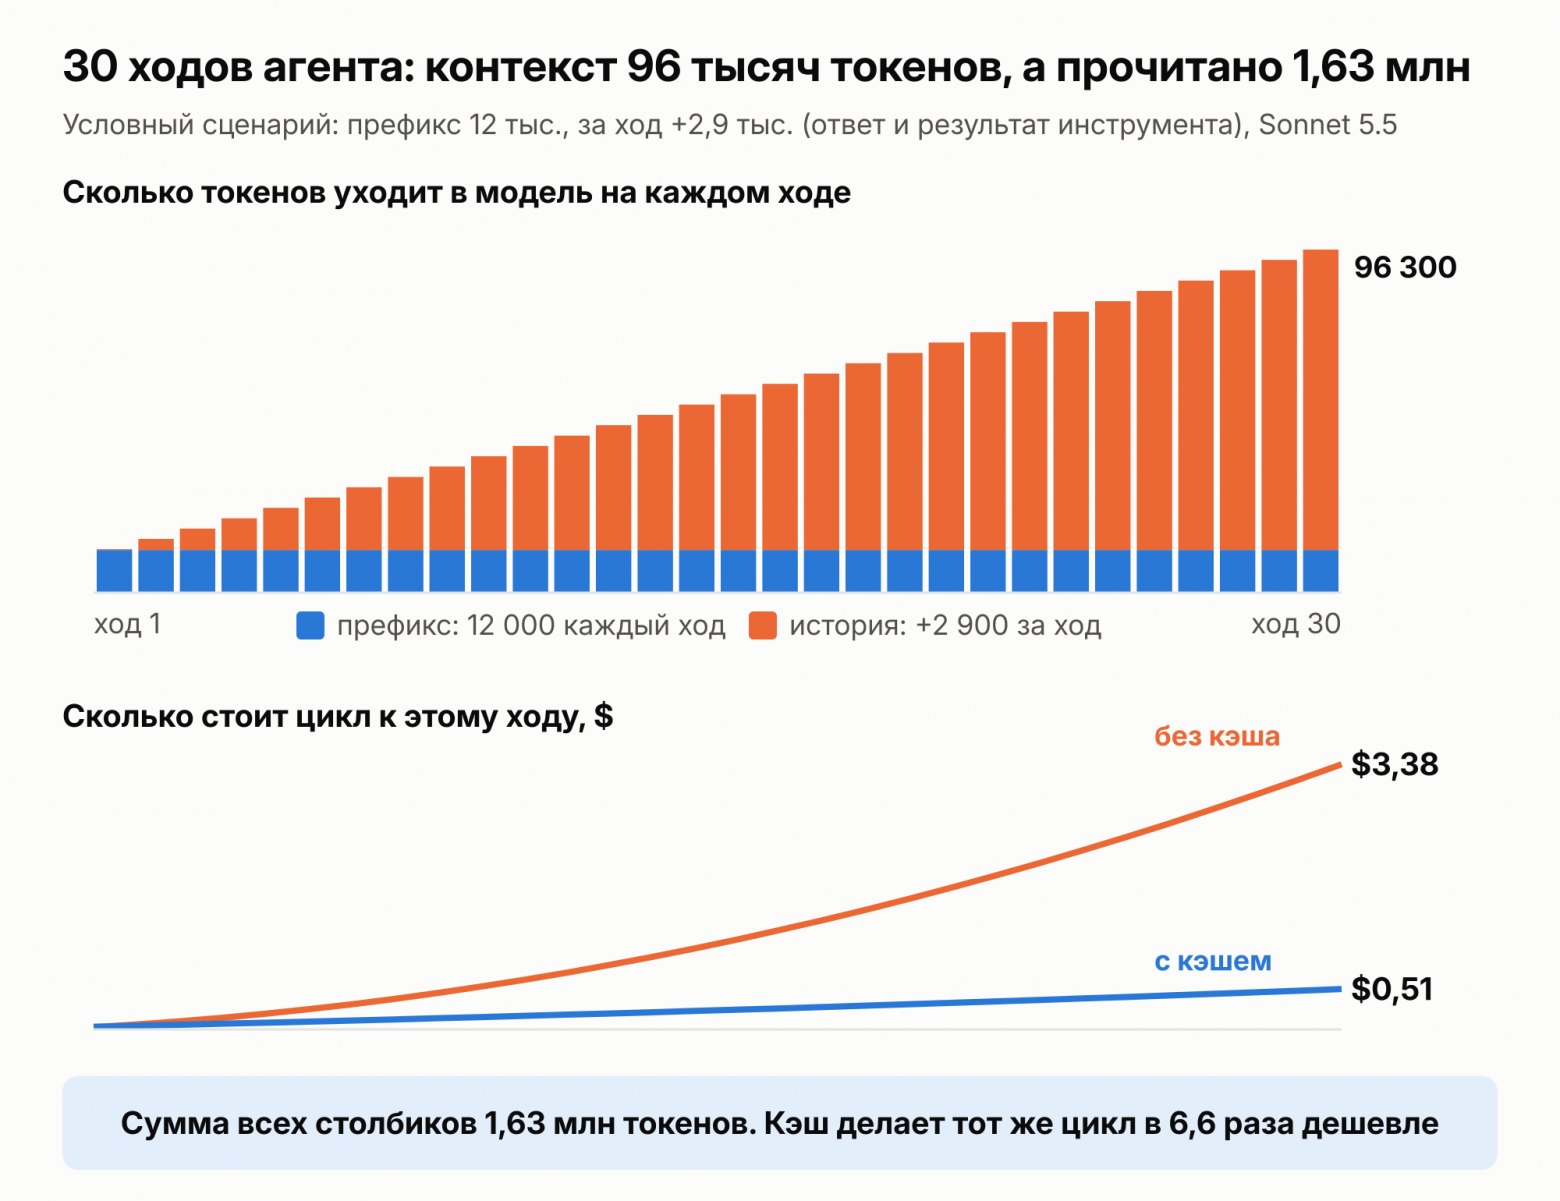
Условный сценарий. Цены Sonnet 5.5 на 28.10.2026.
На последнем шаге запрос весит 96 300 токенов. Это меньше десятой части окна. Но за все 30 шагов модель прочитала 1,63 млн токенов, в 17 раз больше. Каждый шаг заново оплачивает всё, что было до него, и сумма растёт быстрее, чем кажется. Без кэша такая задача обойдётся в $3,38. Ответы модели за все шаги вместе занимают всего 12 тысяч токенов. Почти все деньги уходят на вход.
Отдельный вопрос, сколько токенов занимает русский текст. Разные языки режутся на токены по-разному. В исследовании Петрова и соавторов (NeurIPS 2023) один и тот же текст на разных языках занимал до 15 раз больше токенов. Для русского и английского я сделал свой небольшой замер. Взял три пары одинаковых текстов: документацию, прозу и код с комментариями. Около 1 000 символов на язык, токены Claude.
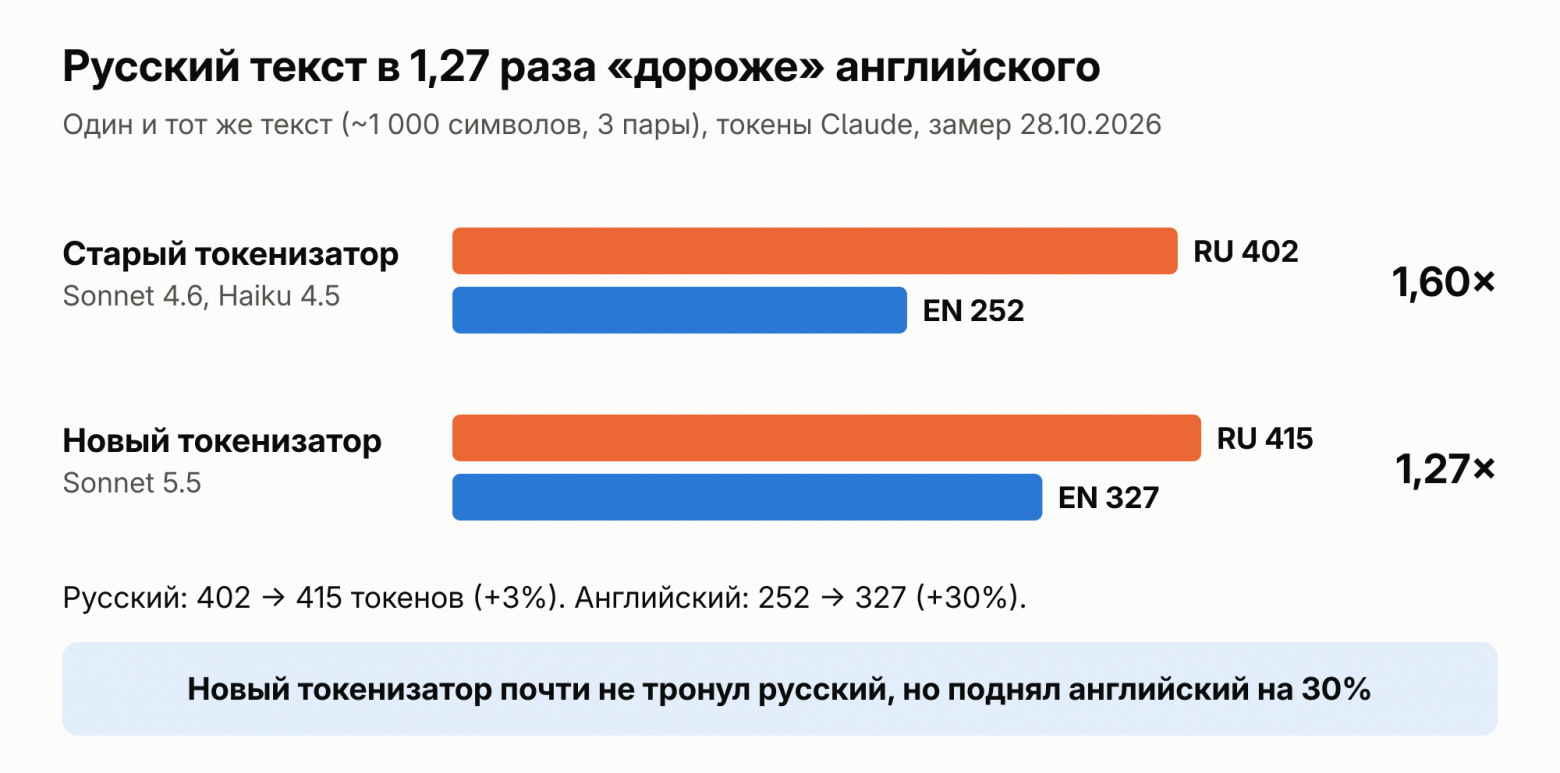
Замер 28.10.2026, скрипт calc/claude_cli_ru_en.py. Выборка маленькая, это ориентир, а не исследование.
На старых моделях (Sonnet 4.6, Haiku 4.5) русский текст занял в 1,6 раза больше токенов, чем английский. На новой Sonnet 5.5 разница всего в 1,27 раза.
Интересно, за счёт чего. Русский почти не изменился: было 402 токена, стало 415. А английский вырос с 252 до 327, на 30%. Это совпадает с документацией Anthropic: начиная с Opus 4.7 модели режут текст по-новому и дают примерно на 30% больше токенов на тот же текст.
Вывод простой: считайте токены той моделью, которой будете пользоваться. Для этого у Anthropic есть бесплатный эндпоинт count_tokens. Правда, он даёт оценку и не учитывает кэш.
Как работает кэш промпта
Вернёмся к 1,63 млн токенов. Почти всё, что модель читает на шаге 30, она уже читала на шаге 29: те же инструменты, тот же системный промпт, та же история. Новый только кусок в конце. Кэш позволяет не обрабатывать повторяющееся начало заново.
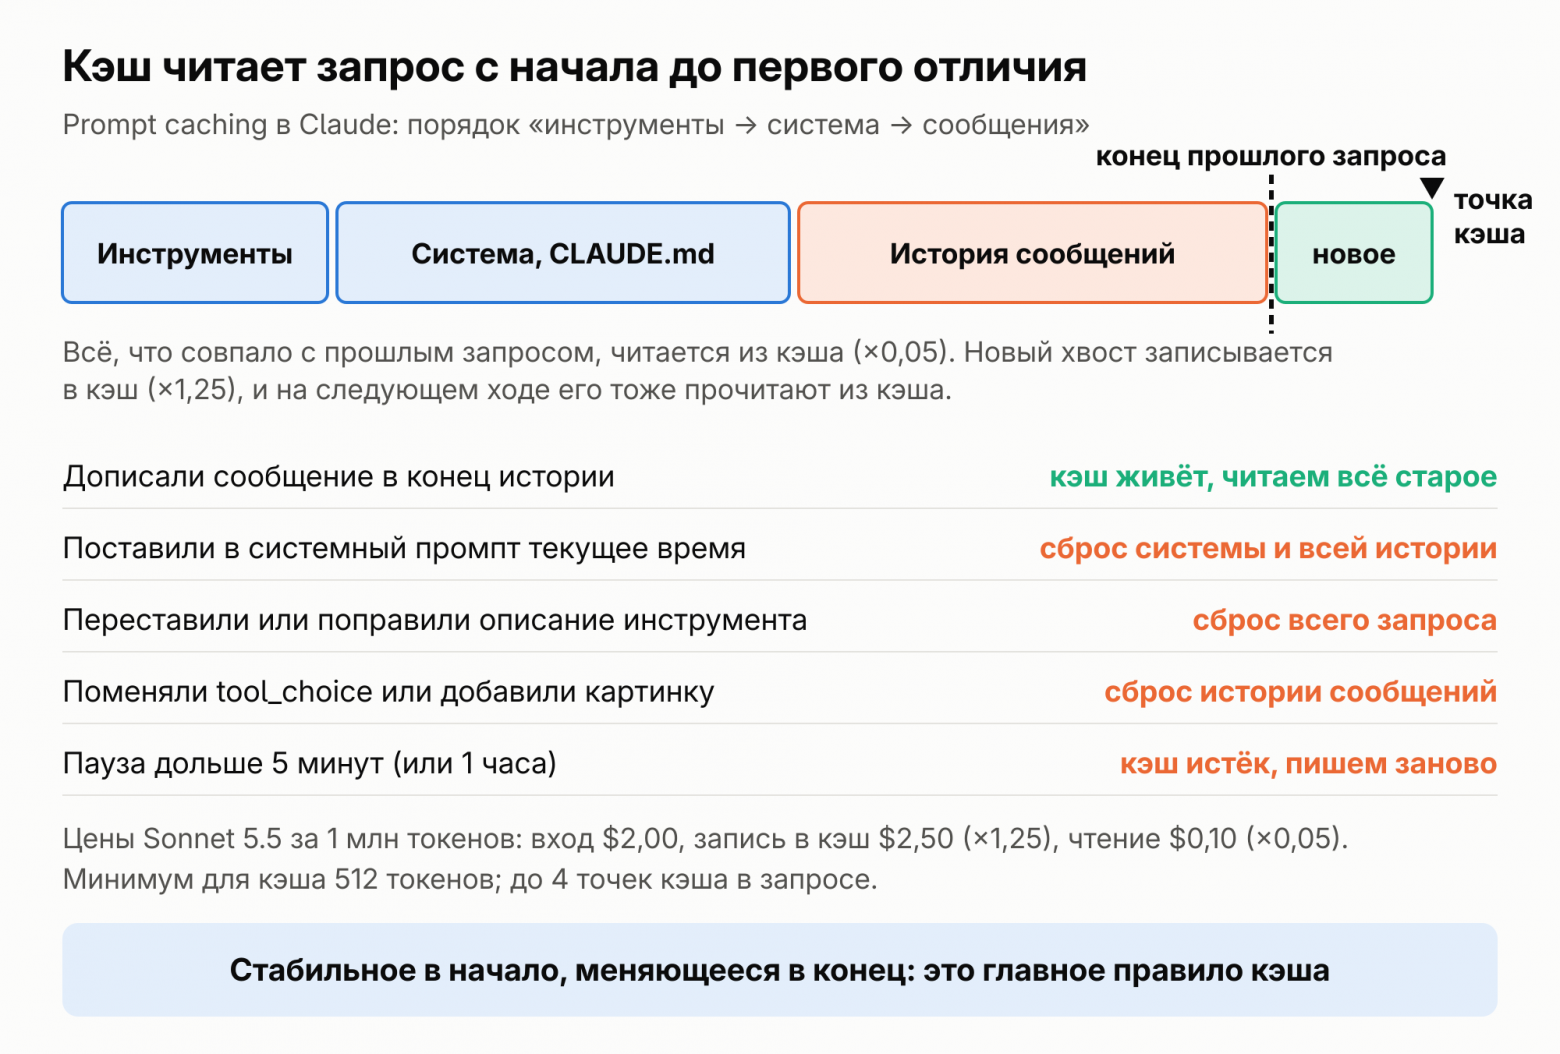
Порядок блоков и то, что сбрасывает кэш, по документации Anthropic на 28.10.2026.
Как это работает. Запрос всегда читается в одном порядке: инструменты, системный промпт, сообщения. Вы ставите в запросе отметку, до какого места кэшировать. Таких отметок может быть до четырёх. Всё до отметки сохраняется. Следующий запрос попадёт в кэш, только если его начало совпадает с сохранённым полностью, до символа и до картинки. Кэш живёт 5 минут, и каждое попадание бесплатно продлевает срок. За доплату его можно хранить час. Короткие запросы не кэшируются: у новых моделей Claude нужно хотя бы 512 токенов. Ошибки при этом не будет, кэш просто не включится.
В нашем примере с кэшем каждый шаг читает старое по $0,10 за миллион и записывает в кэш только новый кусок. Итог $0,51 вместо $3,38, в 6,6 раза дешевле. Запросы те же самые, меняется только то, как их обрабатывает сервер. Когда окупается платная запись в кэш, подробно посчитано в статье «Сколько на самом деле стоит запрос к LLM». У пятиминутного кэша Anthropic уже со второго запроса с тем же началом.
Сломать кэш проще, чем кажется. Любое отличие в начале запроса обнуляет всё, что после него:
-
поменяли описание инструмента: сбросится весь запрос;
-
включили поиск в интернете или вставили в системный промпт текущее время: сбросятся системный промпт и история;
-
сменили
tool_choiceили добавили картинку: сбросится история.
Отсюда одно правило: неизменное кладите в начало, новое в конец. В начале запроса не должно быть дат, случайных ID и перестановок инструментов.
Чек-лист: десять практик для первого агента
-
Начинайте с одного запроса к модели. Цепочка лучше агента, пока шаги задачи можно прописать в коде.
-
Неизменное кладите в начало запроса, новое в конец. В системном промпте не должно быть времени, случайных ID и других меняющихся данных.
-
Не меняйте набор и порядок инструментов посреди сессии.
-
Смотрите в
usageкаждого ответа. Еслиcache_read_input_tokensпочти всегда ноль, кэш у вас не работает. -
Считайте токены той моделью, которой будете пользоваться. У разных моделей токены разные, разница доходит до 30%.
-
Держите историю короткой. Шумную работу вроде поиска и логов отдавайте субагентам, а состояние храните в файлах, а не в переписке.
-
Длинные инструкции выносите в скиллы, а не в системный промпт. Тогда в каждом запросе будет висеть только их короткое описание.
-
То, что должно выполняться всегда, делайте хуком, а не строкой в промпте.
-
Дайте агенту способ проверить себя: тесты, сборку, браузер. Иначе он скажет «готово» слишком рано.
-
Подключайте MCP-серверы и скиллы только из тех источников, которым доверяете, и давайте агенту только нужные права. Документация Anthropic сравнивает чужой скилл с чужой программой, которую вы ставите себе.
Серия «AI-инженерия для тех, кто вкатывается»
Это цикл из трёх статей. Ссылки на остальные части появятся здесь, когда они выйдут.
-
«AI-инженерия для тех, кто вкатывается: агенты, MCP, токены и кэш с цифрами» (вы читаете её сейчас)
-
«Надёжность AI-агентов для тех, кто вкатывается: ретраи, идемпотентность, саги и durable execution» (в работе)
-
«Агентная система для тех, кто вкатывается: цепочка или агент и всё вместе на примере агента поддержки» (в работе)
ссылка на оригинал статьи https://habr.com/ru/articles/1103562/